概要:公平性、説明可能性、採用判断
AI面接プラットフォームの精度と公平性は、候補者の評価に使用するルーブリックの質を超えることはありません。先進的な採用チームは、AIが候補者を採点すべきかどうかだけでなく、そのスコアがどのように構造化され、説明され、正当化されるかを問いかけています。
評価基準(ルーブリック)は、2人の評価者が同じ回答を異なる点数で採点するのを防ぐものです。基準が曖昧な場合、各評価者が自分の判断でその隙間を埋めてしまい、その隙間から一貫性のなさ、ひいてはバイアスのリスクが入り込みます。
このガイドでは、現代のチームが公平で透明性が高く、正当化できるAI面接のルーブリックを、測定可能なベンチマークと実際のプラットフォーム事例を用いてどのように設計するかを解説します。
主なポイント
- ルーブリックの質は、AIモデルそのものよりも重要です。
- 定義が不十分なルーブリックは、採点の一貫性のなさとバイアスを招きます。
- コンピテンシーに基づく重み付きルーブリックは、公平性を大幅に高めます。
- 説明可能な採点は、信頼と監査可能性にとって不可欠です。
- 適切に設計されたAIルーブリックは、場当たり的な人的採点よりも正当化しやすいです。
Q: 面接のルーブリックは、なぜAIモデルよりも重要なのですか?
AIモデルは単独でバイアスをなくすわけではありません。AIモデルは与えられた構造をそのまま増幅します。
ルーブリックがない場合:
- 評価者によってスコアが大きくばらつく
- 採用マネージャーがAIの出力を信用しない
- 主観的な解釈を通じてバイアスが入り込む
- 採用判断を法的に正当化するのが難しくなる
構造化されたルーブリック がある場合:
- すべての候補者が同じ基準で評価される
- スコアは説明可能で監査可能である
- 採用チームでは導入率と信頼感が高まる
選抜に関する文献の最大規模の再分析では、その差を次のように示しています(Sackett et al., 2022):
- 非構造化面接:職務パフォーマンスとの相関 0.19
- 構造化面接:0.42
Q: 従来の面接評価基準にはどのような問題がありますか?
従来のルーブリックの多くは、存在するから失敗するのではなく、精度と整合性を欠いているから失敗します。
曖昧な採点基準
「優れたコミュニケーション能力」や「カルチャーフィットが良い」といった言葉は評価者ごとに解釈が異なり、採点のばらつきを50%以上増加させます。
一貫性のない重み付け
面接官ごとに重視するシグナルが異なると、ランキングが不安定になり、評価が分かれます。
職務成果へのつながりがない
多くの評価基準は実際のパフォーマンス指標に対応付けられておらず、予測価値が低下します。
透明性の欠如
採用マネージャーが候補者がなぜ高く評価されたのかを確認できないと、システムへの信頼はすぐに失われます。
Q: AI面接の評価基準を公平かつ正当化できるものにする要因は何か?
高品質なAI面接の評価基準には、5つの核となる要素が共通しています。
コンピテンシーに基づく構造
各質問は、次のような測定可能な職務コンピテンシーに直接対応します:
- 問題解決
- コミュニケーション
- 職務固有のスキル
- 意思決定
これだけで評価のばらつきを30–40%削減します。
明確な採点定義
各スコア範囲には、明確な行動アンカーが含まれています。
例:
- 5: 具体的な例を伴う、明確で構造化された推論
- 3: 深さは限定的だが、適切な回答
- 1: 曖昧または的外れな回答
重み付けされたカテゴリ
すべてのコンピテンシーが同じように重要というわけではありません。高パフォーマンスのチームは、役割への影響に応じてカテゴリを重み付けし、予測精度を15–25%向上させています。
候補者間での一貫した適用
AIはすべての候補者に同じルーブリックを適用するため、疲労や気分の変化、面接官による評価のぶれを排除します。
説明可能な出力
現代のルーブリックは、以下を説明するサマリーを生成します:
- どのコンピテンシーがスコアに影響したか
- 候補者がどこで優れ、どこで苦戦したか
- ベンチマークプロファイルとどのように比較されるか
Q: 優れたAI面接ルーブリックは実際にはどのようなものですか?
以下は、多くの高パフォーマンスチームが使用している、シンプルで正当性を説明できるルーブリック構造です。
| コンピテンシー | 重み | 説明 |
|---|---|---|
| 問題解決 | 30% | 論理的推論と明確さ |
| コミュニケーション | 25% | 構造、明確さ、表現力 |
| 職務スキル | 25% | 職務固有の知識と実行 |
| 意思決定 | 20% | 判断力と優先順位付け |
このような重み付けされたコンピテンシー基準のルーブリックを使用するチームは、次のように報告しています:
- スコアリングの一貫性が40–60%向上
- より迅速なショートリスト作成
- レビュアー間の意見の相違の減少
Q: AI面接プラットフォームはルーブリックをどのように異なる形で扱っていますか?
すべてのプラットフォームが評価基準を第一級のシステムとして扱っているわけではありません。
Flowmingo
HireVue
- エンタープライズ向けの評価基準
- 強力な分析ダッシュボード
- 1,300件以上の妥当性検証研究を公開(FlowmingoとHireVueの比較)
TestGorilla
- 強力なスキルベースの評価基準
- 技術評価に最適
Q: Flowmingoはあなたの評価基準をどのように適用しますか?
Flowmingoでは、あなたの基準がそのまま評価基準になります:
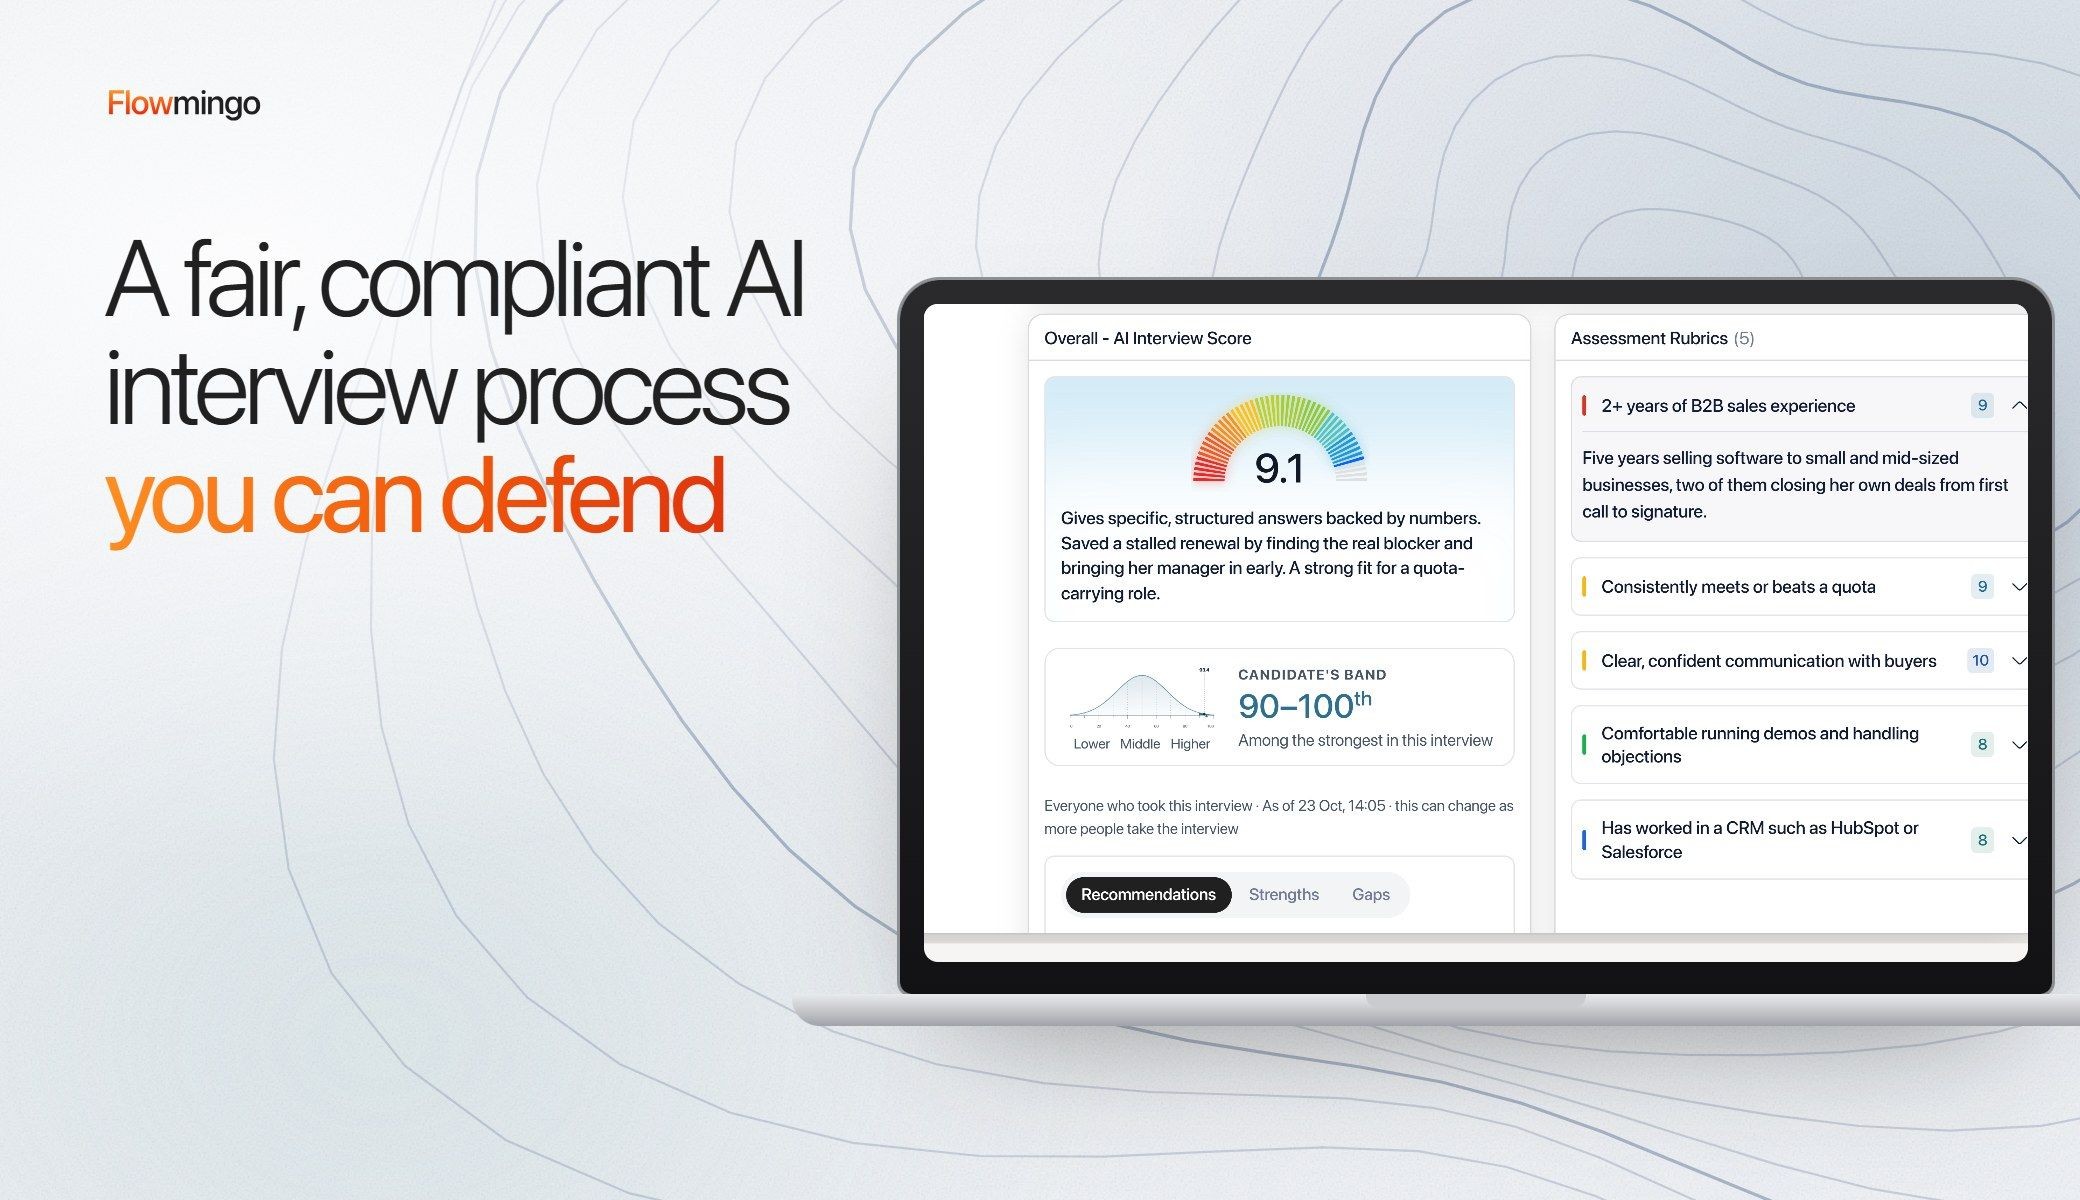
- 各評価基準とその重要度を、Good to HaveからMust Haveまで設定できます。
- 各基準は0–10で評価され、理由が文章で示されます。
- 各レポートには強み、ギャップ、推奨事項が記載されます。
よくある質問
より優れた評価基準は本当にバイアスを減らすのでしょうか?
はい。構造化された評価基準は、評価者が解釈しなければならない範囲を狭めます。そして、その解釈こそがバイアスを入り込ませる余地です。その削減幅については、当社では測定していません。
AI面接の評価基準は法的に正当化できるのでしょうか?
透明で一貫性があり、職務に沿っている場合、AIの評価基準は場当たり的な人による採点よりもより正当化しやすいものです。
評価基準は職種やクライアントごとにカスタマイズできますか?
はい。主要なプラットフォームでは、職種、部門、クライアント案件ごとに異なるルーブリックを設定できます。
ルーブリックはどのくらいの頻度で更新すべきですか?
可能であれば実績に基づくキャリブレーションを併用しながら、四半期ごとに見直すのがベストプラクティスです。
ルーブリックの構造は候補者体験に影響しますか?
はい。明確で構造化された質問は完了率を10–15%向上させ、候補者の混乱を減らします。
結論と次のステップ
公平な採用はAI単独ではなく、よく設計された評価構造から生まれます。
説明責任を果たせる採用には、コンピテンシーに基づき、重み付けされ、説明可能で、一貫して適用されるルーブリックが必要です。AI面接プラットフォームはすべての候補者に同じ方法でルーブリックを適用するため、ルーブリックの品質が結果の品質を決めます。
まずルーブリックを作成しましょう。そうすれば、すべての応募者が同じ基準で評価されます。
自信を持って示せるルーブリックを設計する準備はできましたか?ぜひFlowmingoを使ってみてください — 無料で始められます。