អ្នកសម្ភាសន៍ 3 នាក់ បេក្ខជនជម្រើសចុងក្រោយ 1 នាក់ លទ្ធផលវិនិច្ឆ័យ 3 ។ បើគ្មាន តារាងពិន្ទុសម្ភាសន៍ ទេ សំឡេងខ្លាំងបំផុតក្នុងការពិភាក្សាបូកសរុបរបស់អ្នកជាអ្នកជ្រើសរើសបេក្ខជន។
គ្មានទម្រង់វាយតម្លៃបេក្ខជនណាមួយដែលអាចត្រឡប់ទៅមើលវិញបានទេ។ ដូច្នេះគ្មាននរណាម្នាក់អាចពន្យល់អំពីការផ្តល់ការងារនេះដល់ CEO របស់អ្នក ឬដល់ បេក្ខជនដែលត្រូវបានបដិសេធហើយសួរដេញដោល បានឡើយ។
បើគ្មានទម្រង់រួមគ្នាទេ មនុស្សរវល់ៗតែងតែពឹងផ្អែកលើអារម្មណ៍វិញ។
ហើយការសម្រេចចិត្តតាមអារម្មណ៍គឺខ្សោយជាងអ្វីដែលយើងមានអារម្មណ៍ ដូចដែលសៀវភៅ Noise របស់ Kahneman និងអ្នកនិពន្ធរួមបានបង្ហាញ។
ឧបមាថាអ្នកដឹងតែថាបេក្ខជនម្នាក់សម្ភាសន៍បានល្អជាងបេក្ខជនម្នាក់ទៀត។ ឱកាសដែលពួកគេពិតជាជាអ្នកដែលគួរជ្រើសរើសជាងគឺមានតែ 56% ដល់ 61% ប៉ុណ្ណោះ ដែលល្អជាងការបោះកាក់បន្តិចបន្តួចប៉ុណ្ណោះ។
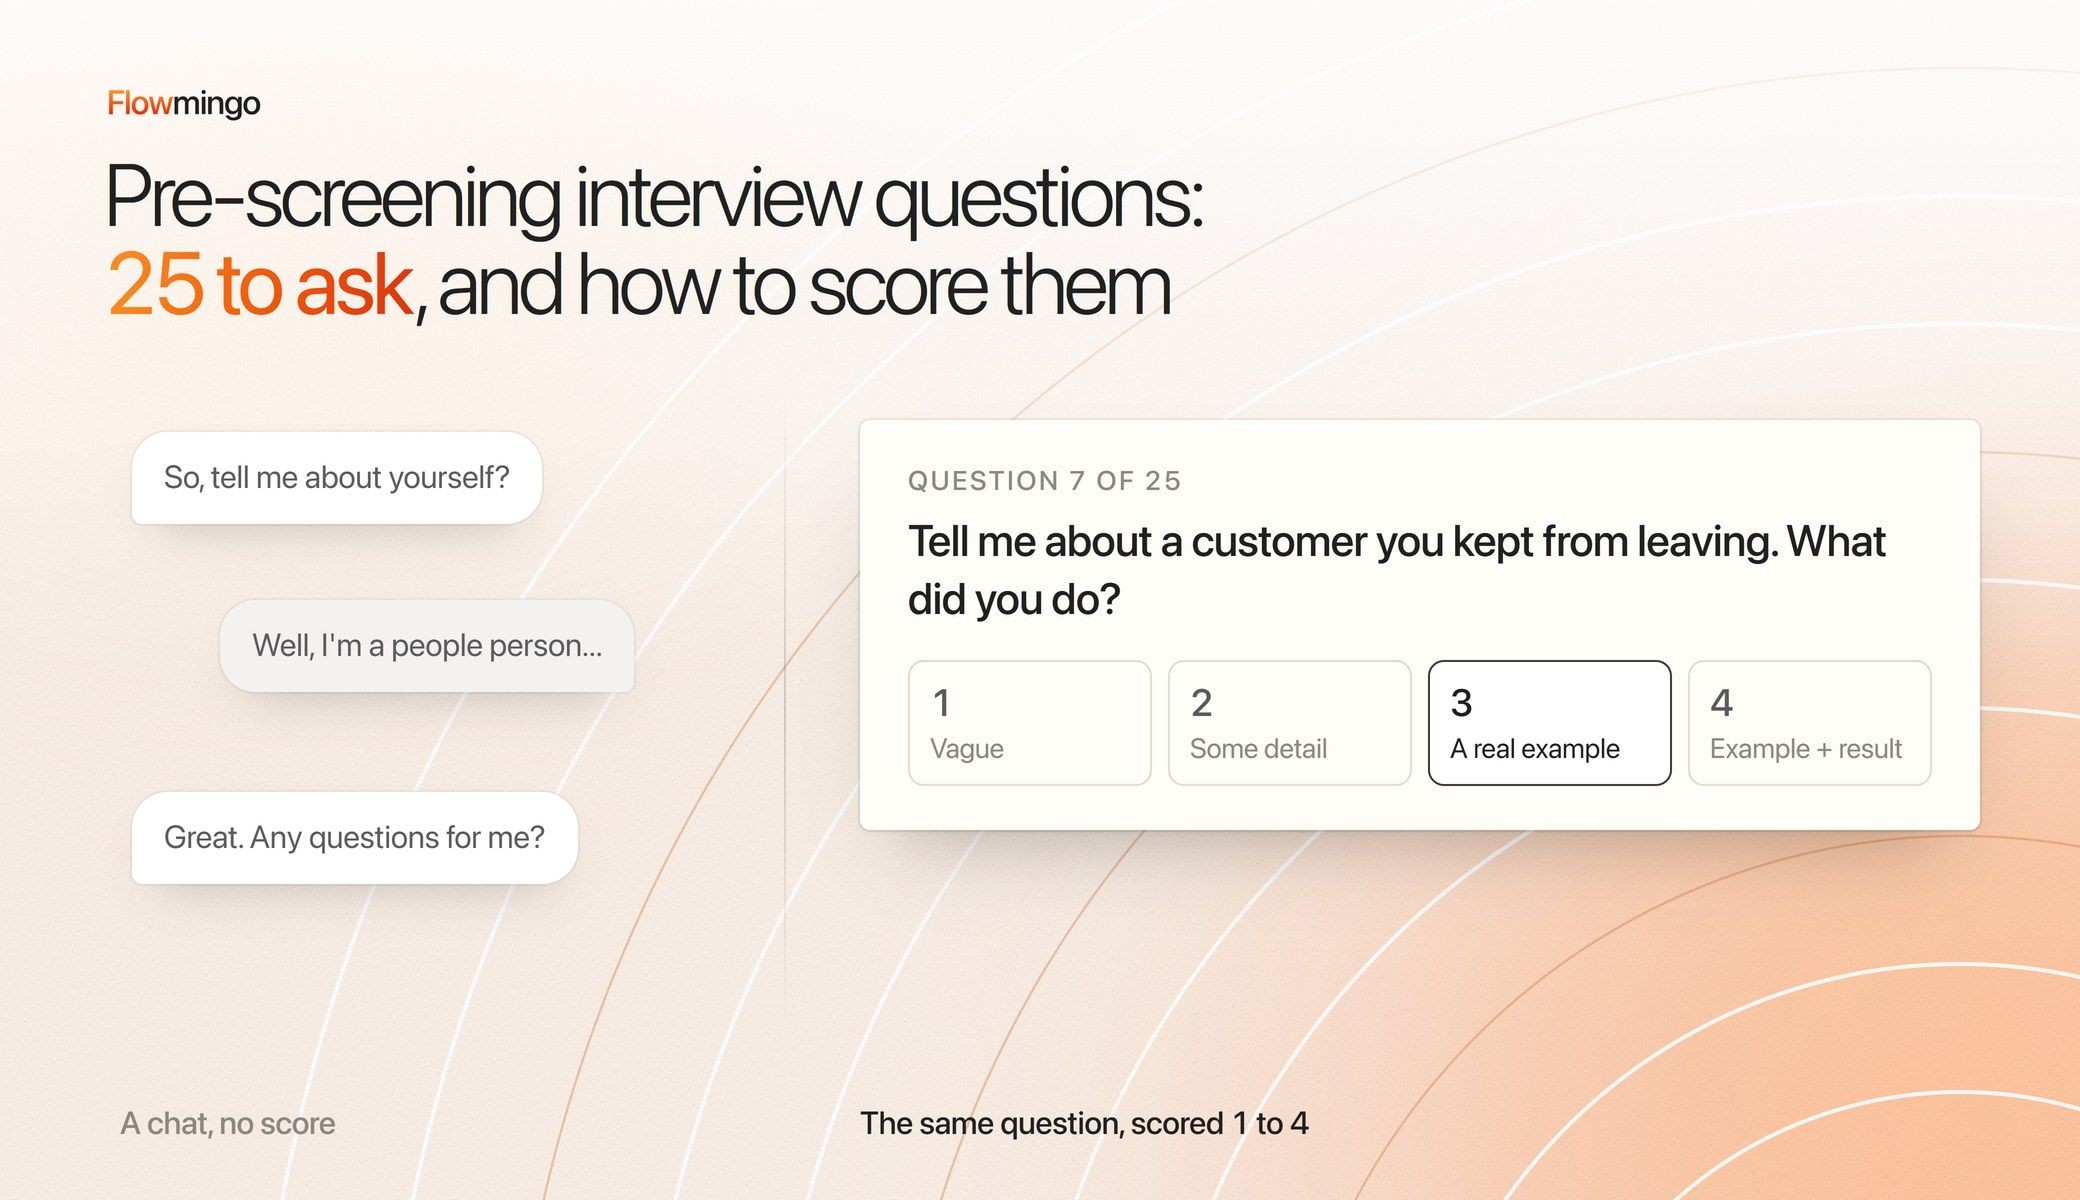
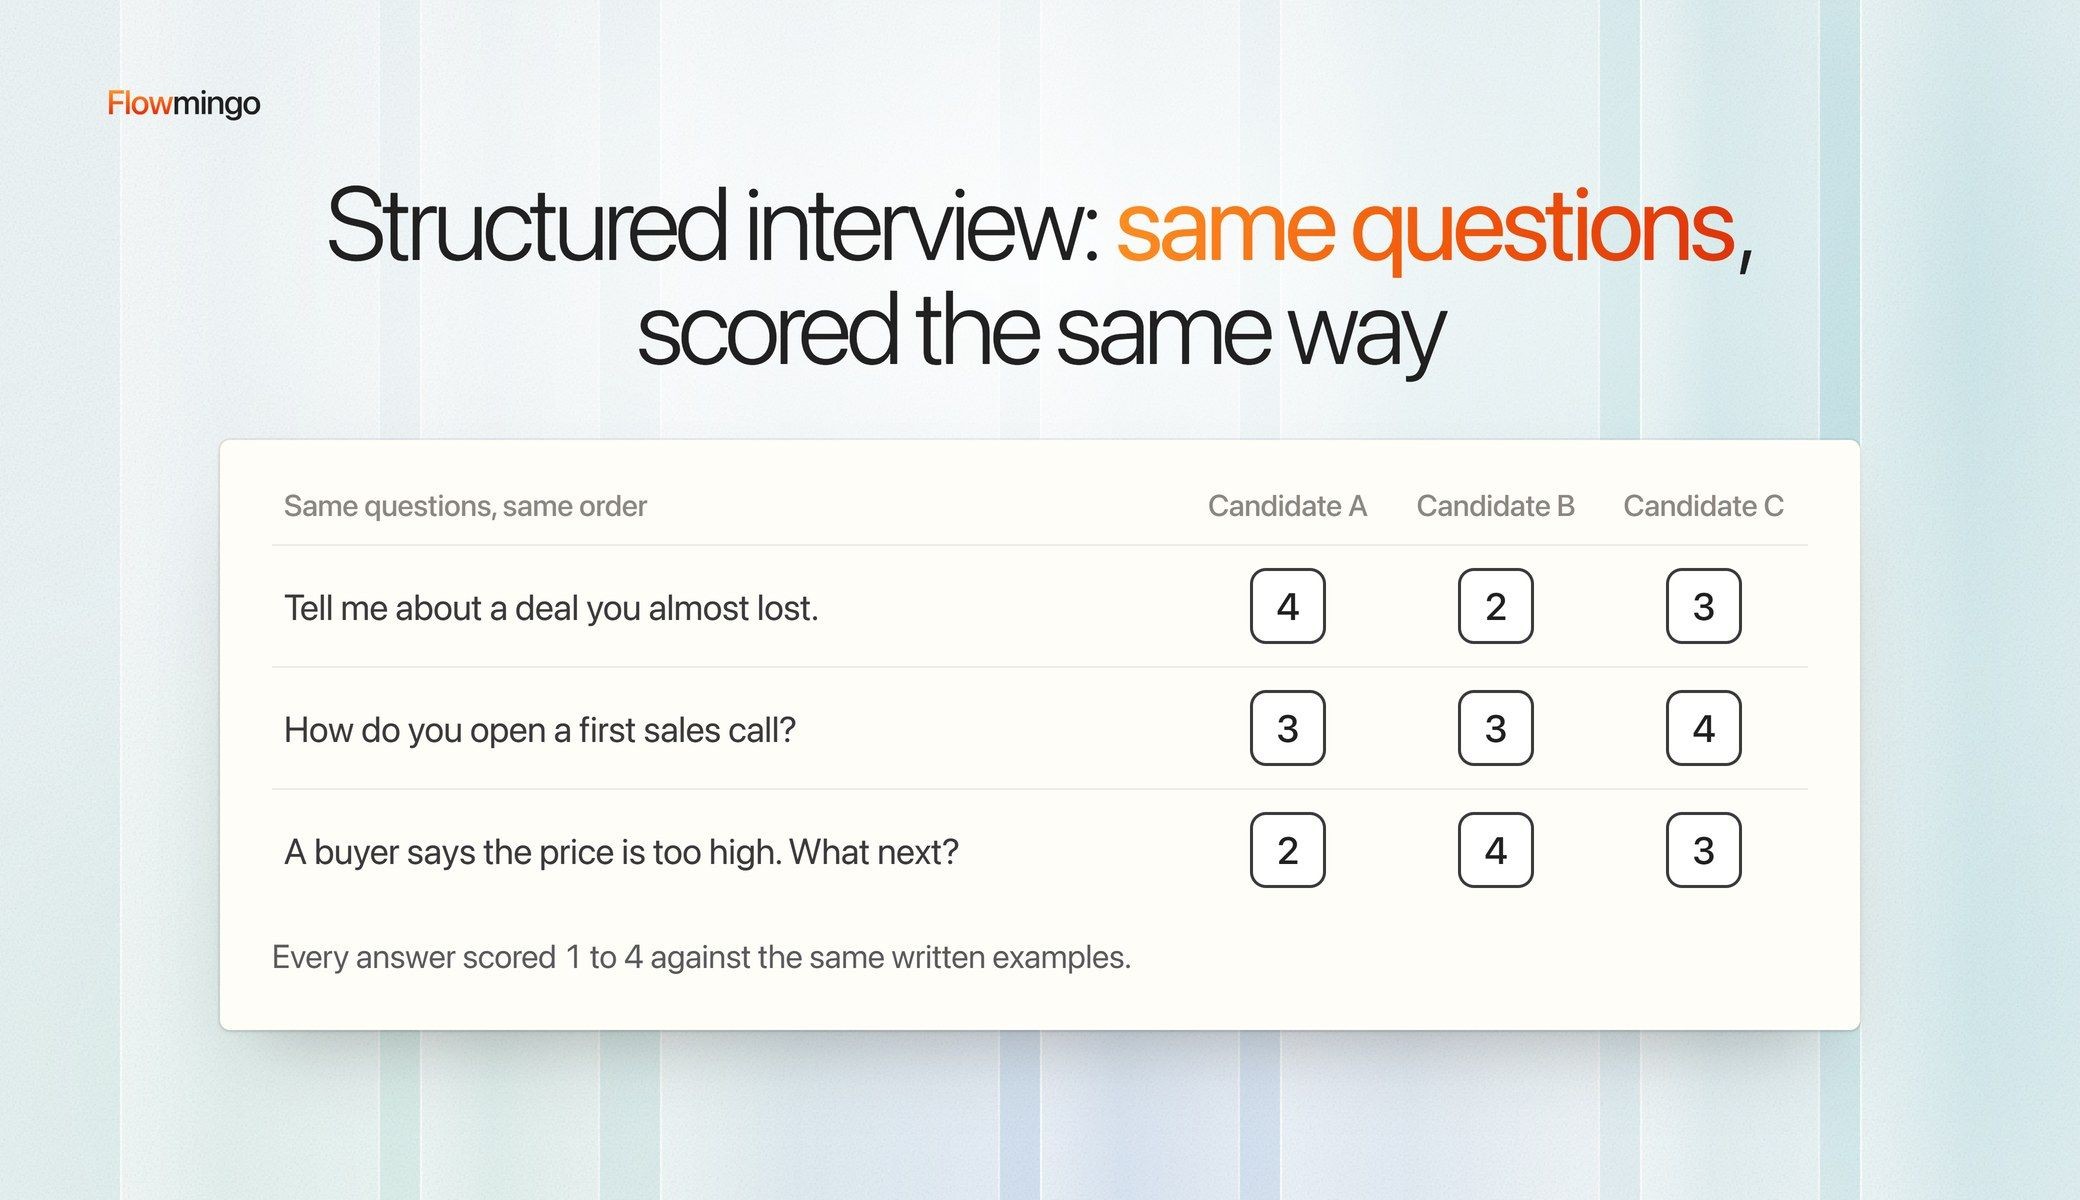
តារាងពិន្ទុដោះស្រាយបញ្ហានេះបានក្នុង 3 ជំហាន។ អ្នកសម្ភាសន៍ម្នាក់ៗដាក់ពិន្ទុលើជំនាញដូចគ្នា 4 ទៅ 6 ដោយផ្អែកលើឧទាហរណ៍ជាលាយលក្ខណ៍អក្សរ ដោយឯករាជ្យ មុនការពិភាក្សាបូកសរុប។ បន្ទាប់មក ពិន្ទុសរុបជាអ្នកសម្រេច លុះត្រាតែជំនាញដែលចាំបាច់មួយមិនជាប់។
ចំណុចសំខាន់ៗ
- តើតារាងពិន្ទុពិតជានាំទៅរកការជ្រើសរើសបុគ្គលិកបានល្អជាងមែនទេ? បាទ/ចាស ប្រសិនបើអ្នកសម្ភាសន៍ម្នាក់ៗដាក់ពិន្ទុលើជំនាញដូចគ្នាដោយផ្អែកលើឧទាហរណ៍ជាលាយលក្ខណ៍អក្សរ។ ការសម្ភាសន៍ដែលធ្វើតាមរបៀបនេះបានព្យាករណ៍ពីសមិទ្ធផលការងារបានប្រសើរជាងប្រហែលពីរដង បើធៀបនឹងការសម្ភាសន៍បែបសេរី នៅក្នុងការវាយតម្លៃឆ្នាំ 2022។
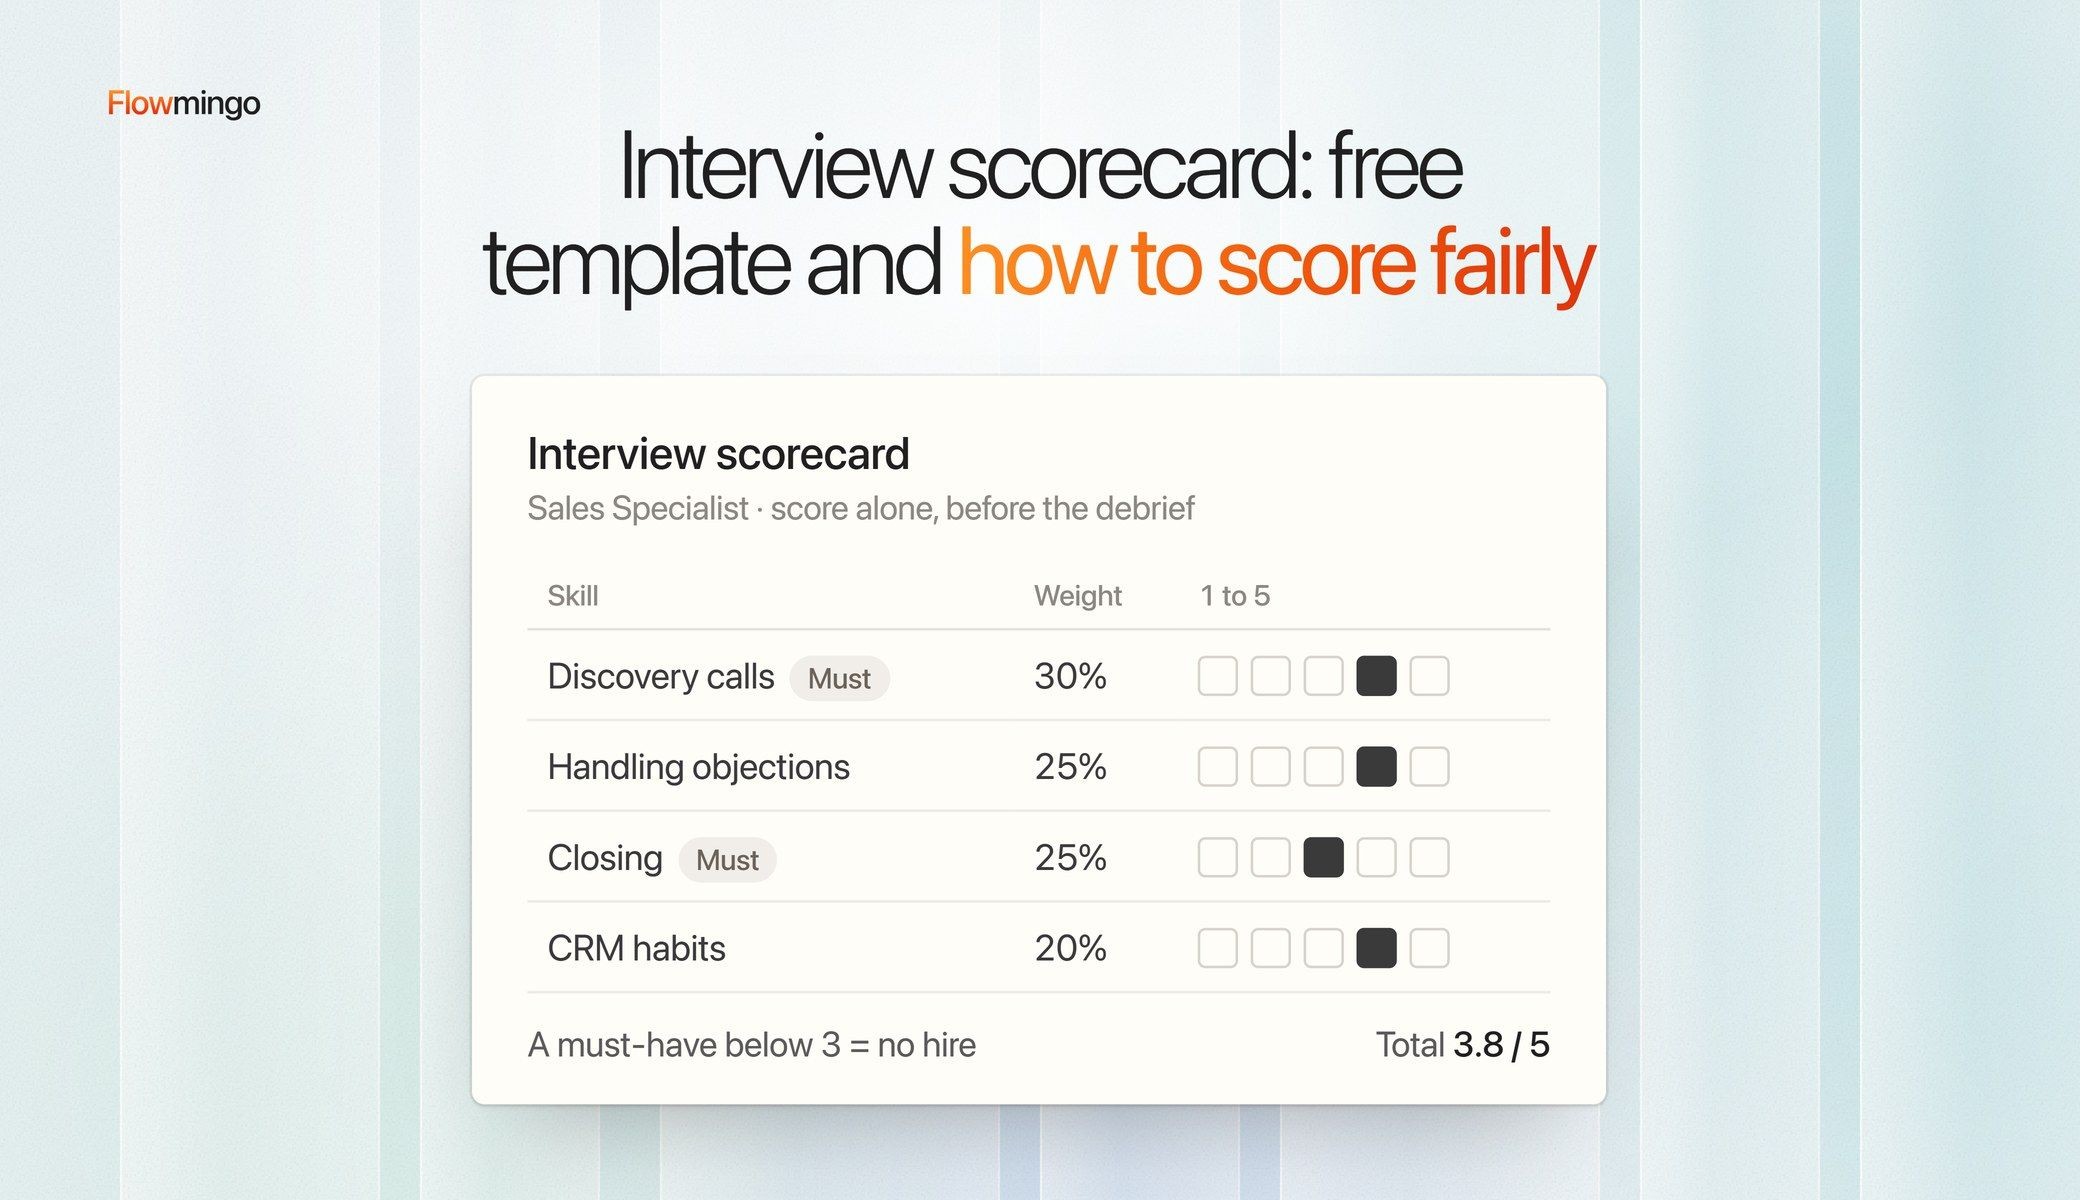
- តើគួរដាក់ពិន្ទុលើជំនាញប៉ុន្មាន? 4 ទៅ 6 ដោយនីមួយៗប្រើមាត្រដ្ឋាន 1 ដល់ 5 ជាមួយចម្លើយឧទាហរណ៍ជាលាយលក្ខណ៍អក្សរសម្រាប់កម្រិតនីមួយៗ។ ជំនាញចាំបាច់ណាមួយក្រោម 3 មានន័យថាមិនជ្រើសរើស។
- តើខ្ញុំជ្រើសរើសរវាងបេក្ខជនជម្រើសចុងក្រោយ 2 នាក់ដែលស្មើពិន្ទុគ្នាដោយរបៀបណា? ពិនិត្យជំនាញចាំបាច់ជាមុនសិន បន្ទាប់មកពិភាក្សាបូកសរុបលើភស្តុតាងចំពោះករណីបែកគ្នា 2 ទល់នឹង 5។ កុំបោះឆ្នោតឡើងវិញតាមអារម្មណ៍៖ រូបមន្តថេរមួយបានយកឈ្នះការវិនិច្ឆ័យរបស់អ្នកជំនាញនៅក្នុងការវាយតម្លៃឆ្នាំ 2013។
- តើខ្ញុំត្រូវការអ្នកសម្ភាសន៍ប៉ុន្មាននាក់? រហូតដល់ 4 នាក់ ដោយម្នាក់ៗដាក់ពិន្ទុដោយឯករាជ្យ។ នៅក្នុងទិន្នន័យផ្ទាល់របស់ Google ការសម្ភាសន៍នីមួយៗបន្ទាប់ពីលើកទី 4 បានបន្ថែមភាពត្រឹមត្រូវតិចជាង 1%។
- តើខ្ញុំអាចទុកចិត្តពិន្ទុ AI បានទេ? ប្រើវាជាធាតុបញ្ចូល 1 ហើយអានហេតុផលរបស់វា។ នៅក្នុងការសិក្សាឆ្នាំ 2023 អ្នកវាយតម្លៃ AI មួយបានតាមដានអ្នកវាយតម្លៃមនុស្សដែលបានទទួលការបង្ហាត់បង្រៀនយ៉ាងជិតស្និទ្ធ លើសំណួរដែលធ្លាប់ស្គាល់ និងបានធ្វើបានយ៉ាងខ្សោយ លើសំណួរថ្មីៗ។
1. តើតារាងពិន្ទុសម្ភាសន៍ពិតជាជួយខ្ញុំជ្រើសរើសបុគ្គលិកបានល្អជាងមែនទេ?
បាទ/ចាស នៅពេលដែលអ្នកសម្ភាសន៍គ្រប់រូបផ្តល់ពិន្ទុលើជំនាញដូចគ្នាដោយផ្អែកលើឧទាហរណ៍ជាលាយលក្ខណ៍អក្សរ។ ការសម្ភាសន៍តាមរចនាសម្ព័ន្ធ ដែលអ្នកសួរ និងផ្តល់ពិន្ទុដល់អ្នកគ្រប់គ្នាតាមវិធីដូចគ្នា បានព្យាករណ៍ពីការអនុវត្តការងារនៅ 0.42 ដែលច្រើនជាងពីរដងនៃ 0.19 របស់ការសម្ភាសន៍គ្មានរចនាសម្ព័ន្ធ។
តួលេខទាំងនោះមកពី ការវិភាគឡើងវិញជាមូលដ្ឋានឆ្នាំ 2022 របស់ Sackett និងសហការី លើការស្រាវជ្រាវអំពីការជួលជាច្រើនទសវត្សរ៍។
តួលេខទាំងនេះជាទំនាក់ទំនងគ្នា ចាប់ពី 0 (គ្មានទំនាក់ទំនងនឹងការអនុវត្តការងារនៅពេលក្រោយ) ដល់ 1 (ទំនាក់ទំនងដ៏ល្អឥតខ្ចោះ)។ ដូច្នេះ 0.19 មិនមានន័យថាការសម្ភាសន៍គ្មានរចនាសម្ព័ន្ធជ្រើសរើសបានត្រឹមត្រូវ 20% នៃពេលវេលានោះទេ។ វាមានន័យថាទំនាក់ទំនងរបស់វាទៅនឹងការអនុវត្តនៅពេលក្រោយគឺខ្សោយ។
តារាងខាងក្រោមចាត់ចំណាត់ថ្នាក់វិធីសាស្ត្រទូទៅ 6 ប្រភេទ។ ការធ្វើតេស្តចំណេះដឹងការងារនៅ 0.40 និង biodata ដែលមានកូនសោ គឺជាកម្រងសំណួរផ្ទៃខាងក្រោយដែលមានការផ្តល់ពិន្ទុ នៅ 0.38 ជាប់ខាងក្រោយយ៉ាងជិត។
ការធ្វើតេស្តគំរូការងារតាមពីក្រោយនៅ 0.33 និងការធ្វើតេស្តសមត្ថភាពយល់ដឹងនៅ 0.31។ ការសម្ភាសន៍គ្មានរចនាសម្ព័ន្ធ ដែលជាការសន្ទនាសេរីដែលភាគច្រើនយើងធំធាត់ជាមួយ គឺនៅចុងក្រោយ។
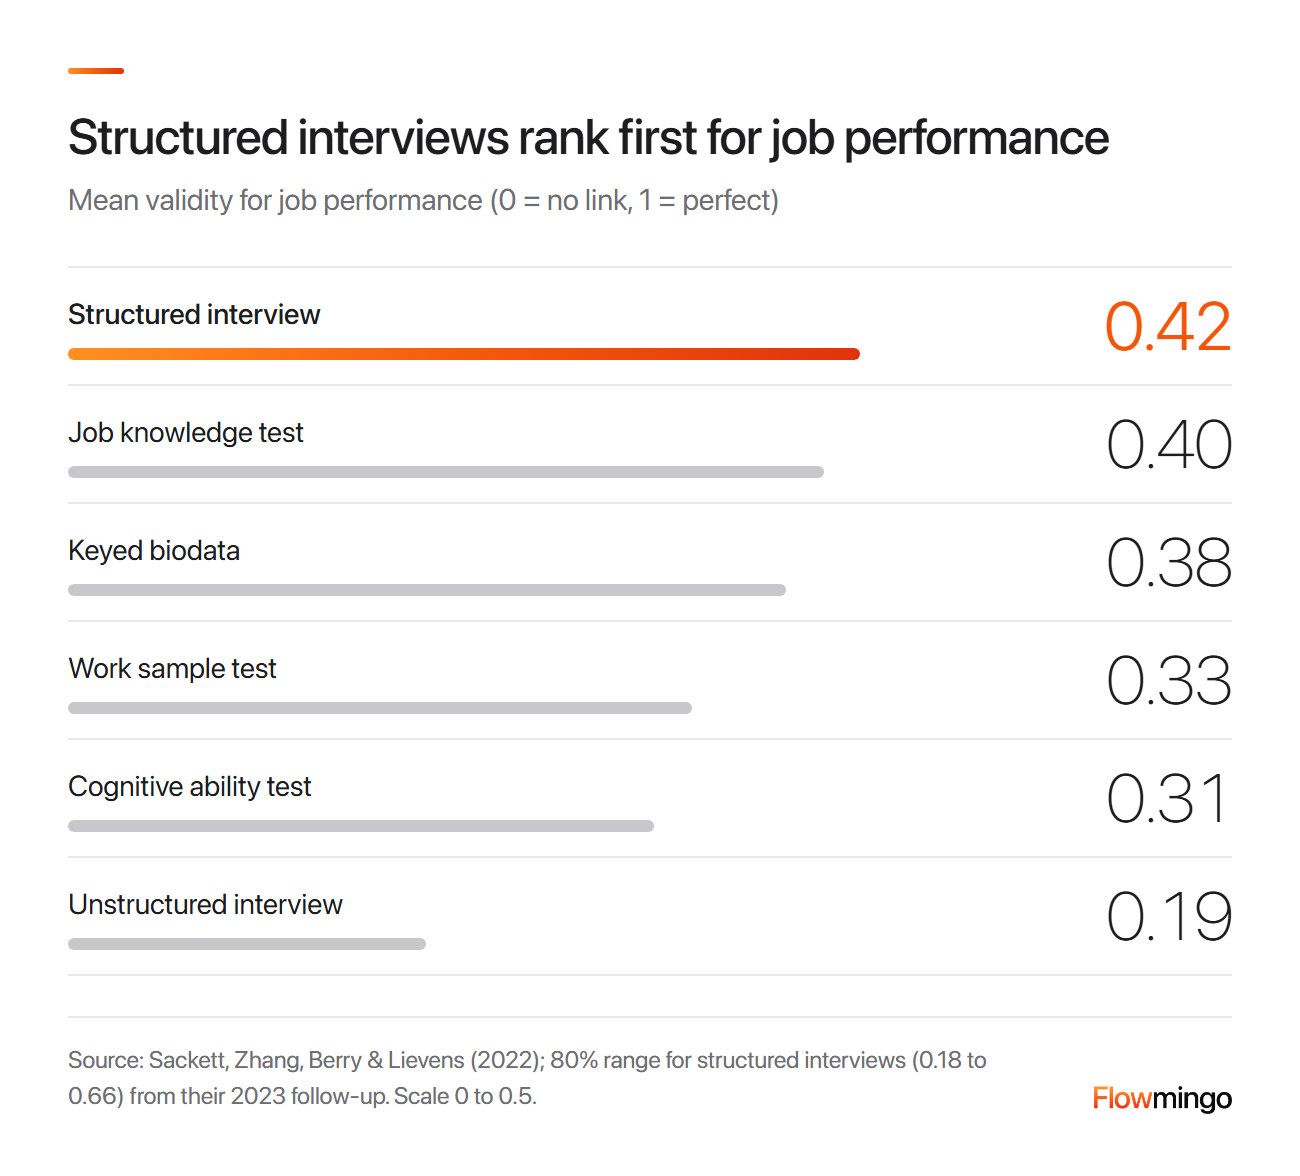
វិធីសាស្ត្រជួលដែលចាត់ចំណាត់ថ្នាក់តាមទំនាក់ទំនងទៅនឹងការអនុវត្តការងារ៖ ការសម្ភាសន៍តាមរចនាសម្ព័ន្ធដឹកនាំនៅ 0.42 ការសម្ភាសន៍គ្មានរចនាសម្ព័ន្ធនៅចុងក្រោយនៅ 0.19 (ការវិភាគឡើងវិញជាមូលដ្ឋានរបស់ Sackett et al.)។
ប៉ុន្តែ 0.42 គឺជាមធ្យមភាគ។ ការតាមដានរបស់អ្នកនិពន្ធ បង្ហាញថាការសម្ភាសន៍តាមរចនាសម្ព័ន្ធភាគច្រើនស្ថិតនៅចន្លោះ 0.18 ដែលមិនល្អជាងការសន្ទនាសេរី និង 0.66 ដែលល្អជាងអ្វីៗទាំងអស់នៅក្នុងតារាង។
ការរចនាគឺជា 1 ក្នុងចំណោមហេតុផល 3 ដែលអ្នកនិពន្ធផ្តល់សម្រាប់ភាពខុសគ្នានោះ។ នេះមានន័យថារូបមន្តវិនិច្ឆ័យសម្រាប់ការសម្ភាសន៍ដែលមានជំនាញមិនច្បាស់លាស់ មានហានិភ័យនឹងធ្លាក់ជិតបាត។ ទាំងនេះជាមធ្យមភាគឆ្លងកាត់និយោជកជាច្រើន មិនមែនជាការសន្យាអំពីការជួលបន្ទាប់របស់អ្នកទេ។
2. តើគំរូរូបមន្តវិនិច្ឆ័យសម្រាប់ការសម្ភាសន៍របស់ខ្ញុំគួរមានអ្វីខ្លះ?
គំរូរូបមន្តវិនិច្ឆ័យសម្រាប់ការសម្ភាសន៍ ឬទម្រង់វាយតម្លៃបេក្ខជន រួមមានជំនាញ 5 ចំណុច ចំណុចយោងជាលាយលក្ខណ៍អក្សរ ប្រអប់ភស្តុតាង និងកម្រិតអប្បបរមាដែលចាំបាច់ ទាំងអស់នៅលើ 1 ទំព័រ។ វាបញ្ចប់ដោយចំណាប់អារម្មណ៍រួម និងការណែនាំ។
ចំណុចយោងធ្វើឱ្យពិន្ទុ 4 របស់អ្នកសម្ភាសន៍ម្នាក់មានអត្ថន័យដូចគ្នានឹងពិន្ទុរបស់អ្នកផ្សេងទៀត ហើយប្រអប់ភស្តុតាងឆ្លើយតបនឹងសំណួរ "ហេតុអ្វី" នៅពេល CEO របស់អ្នកសួរ។
កម្រិតអប្បបរមារារាំងពិន្ទុសរុបខ្លាំងមិនឱ្យបិទបាំងជំនាញចាំបាច់ខ្សោយ។ ចំណាប់អារម្មណ៍រួមត្រូវបំពេញនៅចុងក្រោយ ព្រោះអារម្មណ៍ស្មានដែលសរសេរមុននឹងប៉ះពាល់ដល់ពិន្ទុជំនាញទាំងអស់ដែលមកក្រោយវា។
នេះជាទម្រង់នោះសម្រាប់ប្រធានផ្នែកជំនួយអតិថិជន ដែលមានជំនាញចាំបាច់ 2។ ជំនាញទាំង 5 នីមួយៗពិន្ទុពី 1 ដល់ 5 ដូច្នេះពិន្ទុសរុបគឺក្នុងចំណោម 25។
សួរសំណួរអំពីអតីតឥរិយាបថ 2 សម្រាប់ជំនាញនីមួយៗ ព្រោះឧទាហរណ៍ពិតពីអតីតកាលផ្តល់ឱ្យអ្នកនូវអ្វីដែលជាក់ស្តែងដើម្បីប្រៀបធៀបនឹងកម្រិតយោង។ ឧទាហរណ៍៖ "សូមប្រាប់ខ្ញុំអំពីលើកចុងក្រោយដែលអតិថិជនមិនពេញចិត្តបានផ្ទេរបញ្ហាមកអ្នក។"
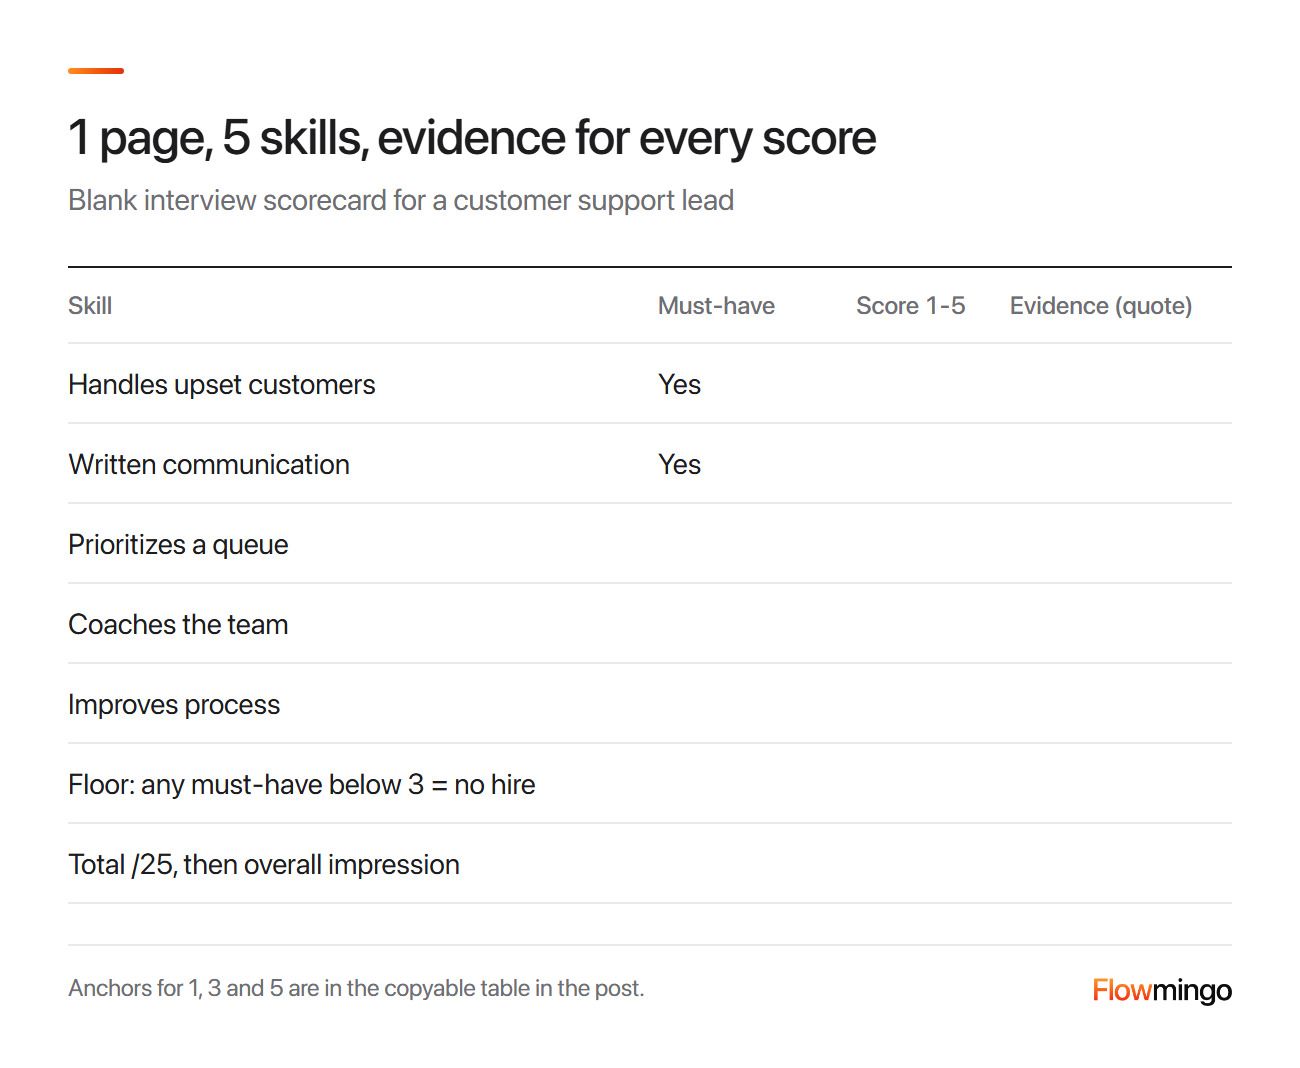
គំរូពិន្ទុសម្ភាសន៍ទទេសម្រាប់ប្រធានផ្នែកជំនួយអតិថិជន៖ ជំនាញ 5 ជំនាញចាំបាច់ 2 ពិន្ទុពី 1 ដល់ 5 និងសម្រង់ភស្តុតាងមួយសម្រាប់ជំនាញនីមួយៗ។
ចម្លងតារាងនេះ បន្ទាប់មកបញ្ចូលជំនាញ និងកម្រិតយោងរបស់អ្នកជំនួសវិញ។
| ជំនាញ | កម្រិតយោងសម្រាប់ 1 / 3 / 5 | ពិន្ទុ 1-5 | ភស្តុតាង (សម្រង់) |
|---|---|---|---|
| ក្បាលទំព័រ | បេក្ខជន តួនាទី អ្នកសម្ភាសន៍ កាលបរិច្ឆេទ | ||
| ដោះស្រាយអតិថិជនមិនពេញចិត្ត (ចាំបាច់) | ស្តីបន្ទោសអតិថិជន / អនុវត្តគោលការណ៍ / ដោះស្រាយមូលហេតុ | ||
| ការទំនាក់ទំនងជាលាយលក្ខណ៍អក្សរ (ចាំបាច់) | មិនច្បាស់ / ច្បាស់តែវែង / ខ្លី និងច្បាស់ | ||
| កំណត់អាទិភាពជួរការងារ | គ្មានវិធីសាស្ត្រ / តាមភាពបន្ទាន់ / តាមផលប៉ះពាល់ | ||
| បណ្តុះបណ្តាលក្រុម | គ្មានឧទាហរណ៍ / ផ្តល់ដំបូន្មាន / កំណត់ផែនការ | ||
| កែលម្អដំណើរការ | គ្មានឧទាហរណ៍ / ស្នើដំណោះស្រាយ / អនុវត្តដំណោះស្រាយ | ||
| កម្រិតអប្បបរមាជំនាញចាំបាច់ | ជំនាញចាំបាច់ណាមួយក្រោម 3 មានន័យថាមិនជួល | ||
| មិនដាក់ពិន្ទុ | អារម្មណ៍ដែលអានពីមុខ សំឡេង ឬការវាយអក្សរ; ការបញ្ចេញសំឡេង ឬល្បឿន លុះត្រាតែការងារត្រូវការវា; "ការសមស្របវប្បធម៌" | ||
| សរុប | ផលបូកពិន្ទុ 5 ក្នុងចំណោម 25 | ||
| ចំណាប់អារម្មណ៍រួម | 1 ដល់ 5 បំពេញនៅចុងក្រោយ | ||
| ការណែនាំ | ជួលខ្លាំង / ជួល / មិនជួល / មិនជួលខ្លាំង; ការកែសម្រេចត្រូវការហេតុផលជាលាយលក្ខណ៍អក្សរ |
2.1 តើខ្ញុំគួរសម្រេចចិត្តអ្វីមុនពេលបង្កើតវា?
កំណត់ភាពជោគជ័យក្នុងតួនាទីជាមុន បន្ទាប់មកជ្រើសរើសជំនាញដែលនាំឱ្យសម្រេចវា។ បង្កកគំរូពិន្ទុសម្ភាសន៍មុនពេល CV ដំបូងមកដល់។
លំដាប់នោះមកពី Who ដោយ Geoff Smart និង Randy Street។ សរសេរបន្ទាត់បេសកកម្ម 1 បន្ទាត់ បន្ទាប់មកលទ្ធផល 3 ដល់ 8 តម្រៀបតាមសារៈសំខាន់ បន្ទាប់មកជំនាញ 4 ដល់ 6។ លទ្ធផលគឺជាលទ្ធផលដែលអាចវាស់វែងបាន ដូចជាការបង្កើនចំណូលពី 25 លានដុល្លារទៅ 50 លានដុល្លារនៅឆ្នាំទី 3 មិនមែនជាសកម្មភាពទេ។
ការបង្កកមានសារៈសំខាន់ ព្រោះមនុស្សអាចបត់បែនលក្ខណៈវិនិច្ឆ័យដោយមិនដឹងខ្លួន។ នៅក្នុងការសិក្សាមូលដ្ឋានរបស់ Uhlmann និង Cohen (2005) អ្នកចូលរួមបានវិនិច្ឆ័យបេក្ខជនពីរនាក់ ម្នាក់ឆ្លាតវៃផ្នែកវិថី និងម្នាក់ទៀតមានការអប់រំខ្ពស់ សម្រាប់តំណែងជាប្រធាននគរបាល។
ចំណុចខ្លាំងណាមួយដែលបុរសនោះមាន ពួកគេសម្រេចថាការងារត្រូវការវាច្រើនជាង ហើយស្ត្រីនោះមិនទទួលបានការលើកកម្ពស់បែបនោះទេ។ ការប្តេជ្ញាចិត្តលើលក្ខណៈវិនិច្ឆ័យមុនពេលមើលបេក្ខជនបានលុបបំបាត់ភាពលំអៀងនោះ។ ដូច្នេះគំរូពិន្ទុដែលសរសេរក្រោយពេលអ្នកជួបបេក្ខជនអាចបត់បែនដោយស្ងាត់ៗទៅរកអ្នកដែលអ្នកចូលចិត្តរួចហើយ។
2.2 តើភាពស៊ីគ្នាផ្នែកវប្បធម៌គួរមាននៅលើសន្លឹកពិន្ទុឬ?
មិនគួរទេបើសរសេរដូចនេះ ព្រោះគ្មាននរណាម្នាក់អាចឲ្យពិន្ទុវាដូចគ្នាពីរដងបានទេ។ សូមបំប្លែងវាទៅជាអាកប្បកិរិយាដែលអាចសង្កេតបាន 1 ឬ 2 យ៉ាង ដូចជា "សុំមតិកែលម្អលើការងាររបស់ខ្លួនឯង"។
សូមនិយាយថាក្រុមរបស់អ្នកឱ្យតម្លៃភាពស្មោះត្រង់៖ ជំនួសមកវិញ សូមឲ្យពិន្ទុលើ "បានផ្ដល់ឧទាហរណ៍ជាក់លាក់អំពីការរាយការណ៍កំហុសដោយបានឆាប់រហ័ស"។
3. តើខ្ញុំគួរដាក់ទម្ងន់លើពិន្ទុសម្ភាសន៍យ៉ាងដូចម្តេច ដើម្បីឲ្យជំនាញចាំបាច់ទទួលបានឥទ្ធិពលខ្លាំងបំផុត?
ដាក់ទម្ងន់ស្មើគ្នាដល់ជំនាញមួយៗ ហើយបន្ថែមកំរិតអប្បបរមាសម្រាប់ជំនាញចាំបាច់ ឬកែទម្ងន់ជាមុនសិនមុនការសម្ភាសន៍លើកដំបូង។ ទម្ងន់ស្មើគ្នាច្រើនតែធ្វើការព្យាករណ៍ករណីថ្មីបានល្អដូចទម្ងន់ដែលតម្រូវតាមទិន្នន័យអតីតកាលដែរ។
ចំណុចទីពីរនោះមកពីអ្នកចិត្តវិទូ Robyn Dawes ដូចដែល Kahneman សង្ខេបក្នុង Thinking, Fast and Slow។
ទម្ងន់ដែលតម្រូវតាមបុគ្គលិកដែលអ្នកបានជួលពីមុនក៏រៀនពីឧប្បត្តិហេតុចៃដន្យរបស់ក្រុមនោះដែរ។ ឧបមាថាបុគ្គលិកផ្នែកជំនួយការដ៏ល្អបំផុត 3 នាក់របស់អ្នកសុទ្ធតែចៃដន្យជាអ្នកណែនាំដ៏ពូកែ៖ ទម្ងន់ដែលតម្រូវតាមនឹងលើកទឹកចិត្តការណែនាំនៅក្នុងបេក្ខជនគ្រប់រូបនាពេលអនាគត។
ទម្ងន់ស្មើគ្នាមិនអាចដេញតាមឧប្បត្តិហេតុចៃដន្យបែបនោះបានទេ ហេតុនេះហើយបានជាវាច្រើនតែព្យាករណ៍បេក្ខជនថ្មីបានល្អដូចគ្នា។ សូមរក្សាជំនាញឲ្យឯករាជ្យពីគ្នាផងដែរ ដូចដែល Kahneman ណែនាំ៖ កុំរាយទាំង "ការទំនាក់ទំនង" និង "ជំនាញបង្ហាញ" ព្រោះរួមគ្នាវារាប់រឿងដូចគ្នាពីរដង។
ជំនាញចាំបាច់ទទួលបានឥទ្ធិពលពីកំរិតអប្បបរមា មិនមែនពីទម្ងន់ធំជាងនោះទេ។ ឧបមាថា "ដោះស្រាយអតិថិជនដែលខឹង" ទទួលបានពិន្ទុ 2 ហើយជំនាញផ្សេងទៀតទាំងអស់ទទួលបានពិន្ទុ 5។
ពិន្ទុសរុប 22 ក្នុងចំណោម 25 មើលទៅល្អណាស់ ប៉ុន្តែកំរិតអប្បបរមានៅតែនិយាយថាមិនជួល។ នោះជាអ្វីដែលអ្នកចង់បានសម្រាប់ជំនាញដែលការងារមិនអាចខ្វះបាន។
ប្រសិនបើអ្នកដាក់ទម្ងន់ពិតមែន សូមសរសេរវានៅលើសន្លឹកពិន្ទុសម្ភាសន៍តាំងពីដំបូង ហើយអនុវត្តវាចំពោះគ្រប់គ្នា។ នោះបិទផ្លូវងាយបំផុតក្នុងការបង្វែរពិន្ទុសរុប៖ ការផ្លាស់ប្ដូរទម្ងន់បន្ទាប់ពីអ្នកបានជួបនរណាម្នាក់ដែលអ្នកចូលចិត្ត។
របៀបដែល Flowmingo ជួយ
របាយការណ៍សម្ភាសន៍ AI របស់ Flowmingo ប្រើទម្ងន់ថេរ៖ លក្ខណៈវិនិច្ឆ័យ Must Have រាប់ 4 ដងនៃ Good to Have ក្នុងពិន្ទុសរុប។ លក្ខណៈវិនិច្ឆ័យនីមួយៗរក្សាពិន្ទុ 0 ដល់ 10 ដោយឡែក ដូច្នេះអ្នកនៅតែអាចអនុវត្តកំរិតអប្បបរមាសម្រាប់ជំនាញចាំបាច់ដោយខ្លួនឯងបាន។
4. តើខ្ញុំធ្វើឲ្យពិន្ទុ 3 មានអត្ថន័យដូចគ្នាចំពោះអ្នកសម្ភាសន៍គ្រប់រូបដោយរបៀបណា?
សរសេរអ្វីដែលចម្លើយពិន្ទុ 1, 3 និង 5 មានសម្រាប់ជំនាញនីមួយៗ មុនការសម្ភាសន៍លើកដំបូង។ មាត្រដ្ឋានវាយតម្លៃដែលភ្ជាប់នឹងអាកប្បកិរិយានេះ ធ្វើឲ្យពិន្ទុរបស់អ្នកសម្ភាសន៍ 2 នាក់អាចប្រៀបធៀបគ្នាបាន។
"ភ្ជាប់នឹងអាកប្បកិរិយា" គ្រាន់តែមានន័យថាពិន្ទុនីមួយៗភ្ជាប់ទៅនឹងអ្វីដែលបេក្ខជនបានធ្វើ មិនមែនទៅនឹងអារម្មណ៍ដូចជា "ល្អបង្គួរ" នោះទេ។ បើគ្មានចំណុចយោងទេ ពិន្ទុ 3 លើសន្លឹកពិន្ទុសម្ភាសន៍ដូចគ្នា មានន័យថា "មិនអី" ចំពោះអ្នកសម្ភាសន៍ម្នាក់ និង "ខ្សោយ" ចំពោះអ្នកម្នាក់ទៀត។
ការសម្ភាសន៍ដែលមានចំណុចយោងក៏បង្ហាញទំនាក់ទំនងមធ្យមខ្លាំងជាងជាមួយលទ្ធផលការងារនៅពេលក្រោយផងដែរ។ ការពិនិត្យឡើងវិញជាមូលដ្ឋានរបស់ Taylor និង Small លើការសិក្សាអំពីការសម្ភាសន៍បែបអាកប្បកិរិយាកន្លងមកចំនួន 19 បានរកឃើញទំនាក់ទំនង 0.35 ជាមួយមាត្រដ្ឋានដែលមានចំណុចយោង ធៀបនឹង 0.26 ដោយគ្មានចំណុចយោង។ ការសិក្សាទាំងនោះក៏ខុសគ្នាក្នុងវិធីផ្សេងទៀតដែរ ដូច្នេះការប្រៀបធៀបនេះមិនញែកឥទ្ធិពលនៃការបន្ថែមចំណុចយោងដាច់ដោយឡែកបានទេ។
នេះជាមាត្រដ្ឋានវាយតម្លៃការសម្ភាសន៍សម្រាប់ជំនាញចាំបាច់ "ដោះស្រាយអតិថិជនខឹង"។
| ពិន្ទុ | អ្វីដែលចម្លើយមាន |
|---|---|
| 1 | បន្ទោសអតិថិជន; គ្មានសកម្មភាពផ្ទាល់ខ្លួន និងគ្មានលទ្ធផល |
| 3 | ឧទាហរណ៍ពិត៖ ធ្វើឲ្យអតិថិជនស្ងប់ចិត្ត និងអនុវត្តតាមគោលការណ៍ ប៉ុន្តែមិនដែលពិនិត្យលទ្ធផល |
| 5 | ឧទាហរណ៍ពិត៖ រកឃើញមូលហេតុ ដោះស្រាយ តាមដាន និងចែករំលែកដំណោះស្រាយ |
ការឡើងពិន្ទុនីមួយៗ គឺជាអ្វីដែលអ្នកអាចស្ដាប់ឮនៅក្នុងចម្លើយ។ នោះហើយជាមូលហេតុដែលអ្នកស្ដាប់ 2 នាក់អាចឈានដល់លេខដូចគ្នា។
បើអ្នកមិនទាន់អាចសរសេរចំណុចយោងបានទេ សូមខ្ចីកម្រិត 5 នៅក្នុង ការណែនាំការសម្ភាសន៍បែបរចនាសម្ព័ន្ធ ពី OPM ដែលជាភ្នាក់ងារធនធានមនុស្សសហព័ន្ធរបស់សហរដ្ឋអាមេរិក។ កម្រិតនីមួយៗផ្អែកលើថាតើស្ថានភាពពិបាកប៉ុណ្ណា និងថាតើបុគ្គលនោះត្រូវការការណែនាំប៉ុន្មាន។
- 1, ដឹងខ្លួន៖ ស្ថានភាពសាមញ្ញបំផុត ជាមួយការណែនាំយ៉ាងជិតស្និទ្ធ និងទូលំទូលាយ។
- 2, មូលដ្ឋាន៖ ស្ថានភាពពិបាកបន្តិច ជាមួយការណែនាំញឹកញាប់។
- 3, កម្រិតកណ្ដាល៖ ស្ថានភាពពិបាក ជាមួយការណែនាំម្ដងម្កាល។
- 4, កម្រិតខ្ពស់៖ ស្ថានភាពពិបាកគួរសម ជាមួយការណែនាំតិចតួច ឬគ្មាន។
- 5, អ្នកជំនាញ៖ ស្ថានភាពពិបាកខ្លាំង ដែលបុគ្គលនោះផ្ដល់ដំបូន្មានដល់អ្នកដទៃ។
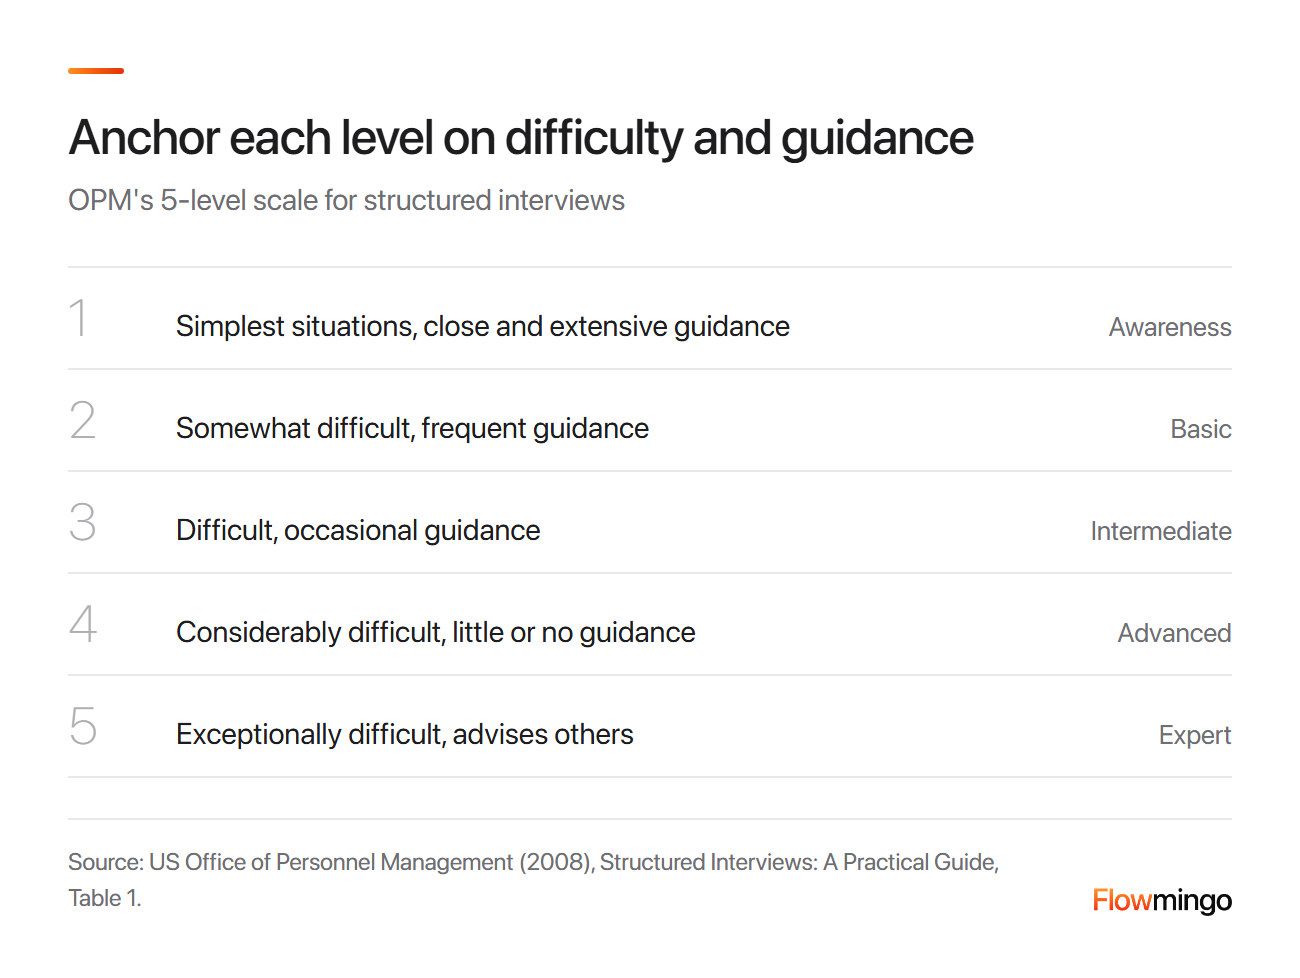
កម្រិតវាយតម្លៃ 5 របស់ OPM សម្រាប់ការសម្ភាសន៍បែបរចនាសម្ព័ន្ធ៖ ពី ដឹងខ្លួន (ស្ថានភាពសាមញ្ញបំផុត ការណែនាំជិតស្និទ្ធ) ដល់ អ្នកជំនាញ (ស្ថានភាពពិបាកខ្លាំង ផ្ដល់ដំបូន្មានដល់អ្នកដទៃ)។
5. តើខ្ញុំជ្រើសរើសរវាងបេក្ខជនជម្រើសចុងក្រោយ 2 នាក់ដ៏ខ្លាំង នៅពេលអ្នកសម្ភាសន៍របស់ខ្ញុំមិនយល់ស្របគ្នាដោយរបៀបណា?
ឲ្យពិន្ទុសរុបនៃកាតពិន្ទុសម្ភាសន៍ជាអ្នកសម្រេច លើកលែងតែករណីពីរ៖ ជំនាញចាំបាច់ដែលទទួលបានពិន្ទុក្រោម 3 ឬការបែកគ្នារវាង 2 និង 5 ដែលអ្នកត្រូវពិភាក្សាដោយផ្អែកលើភស្តុតាង។ កុំបោះឆ្នោតឡើងវិញតាមអារម្មណ៍។
នេះជាពេលវេលាដែលកាតពិន្ទុត្រូវបានបង្កើតឡើងសម្រាប់ ហើយក៏ជាពេលវេលាដែលគេចង់បោះបង់វាចោលខ្លាំងបំផុតដែរ។ នេះជាឧទាហរណ៍បង្ហាញ មិនមែនទិន្នន័យពីអតិថិជនទេ៖ បេក្ខជនចុងក្រោយ 3 នាក់សម្រាប់តួនាទីអ្នកដឹកនាំផ្នែកគាំទ្រ ដោយក្រឡានីមួយៗជាមធ្យមភាគពីអ្នកសម្ភាសន៍ 3 នាក់។
| ជំនាញ | A | B | C |
|---|---|---|---|
| ដោះស្រាយអតិថិជនដែលមិនពេញចិត្ត (ចាំបាច់) | 4 | 2 | 4 |
| ការទំនាក់ទំនងជាលាយលក្ខណ៍អក្សរ (ចាំបាច់) | 4 | 4 | 3 |
| ការរៀបចំលំដាប់អាទិភាពក្នុងជួរ | 3 | 4 | 3 |
| ការបង្វឹកក្រុម | 3 | 4 | 4 (ពិន្ទុ 2, 5, 5) |
| ការកែលម្អដំណើរការ | 4 | 4 | 3 |
| សរុប ក្នុងចំណោម 25 | 18 | 18 | 17 |
| ការសម្រេចចិត្ត | ជួល | មិនជួល៖ ធ្លាក់កម្រិតអប្បបរមា | ពិភាក្សាការបែកគ្នា |
អានកាតពិន្ទុសម្ភាសន៍មួយជួរម្តង។ A និង B ស្មើគ្នានៅ 18 ក្នុងចំណោម 25។ ប៉ុន្តែ B ទទួលបាន 2 លើជំនាញចាំបាច់ ដូច្នេះវាធ្លាក់កម្រិតអប្បបរមា ហើយ B មិនត្រូវជួលទេ។
C ទទួលបានសរុប 17 ប៉ុន្តែមធ្យមភាគ 4 របស់ C លើ "ការបង្វឹកក្រុម" បាំងការបែកគ្នាមួយ៖ អ្នកសម្ភាសន៍ 1 នាក់ឲ្យ 2 ហើយ 2 នាក់ទៀតឲ្យ 5។ គម្លាតនោះក្លាយជារបៀបវារៈតែមួយគត់នៃការពិភាក្សា។
ក្នុងការអនុវត្ត សូមសុំឲ្យភាគីនីមួយៗអានសម្រង់ភស្តុតាងរបស់ពួកគេ។ ឧបមាថាអ្នកឲ្យពិន្ទុទាបបានឮអំពីសមាជិកក្រុមម្នាក់ដែលបានលាលែង ហើយអ្នកផ្សេងទៀតបានឮអំពីផែនការបង្វឹកដែលទទួលបានជោគជ័យ។ ការពិភាក្សាសម្រេចថារឿងណាជារឿងធម្មតាជាងសម្រាប់ C ហើយអ្នកណាដែលខកខានភស្តុតាងត្រូវកែប្រែពិន្ទុជាលាយលក្ខណ៍អក្សរ។
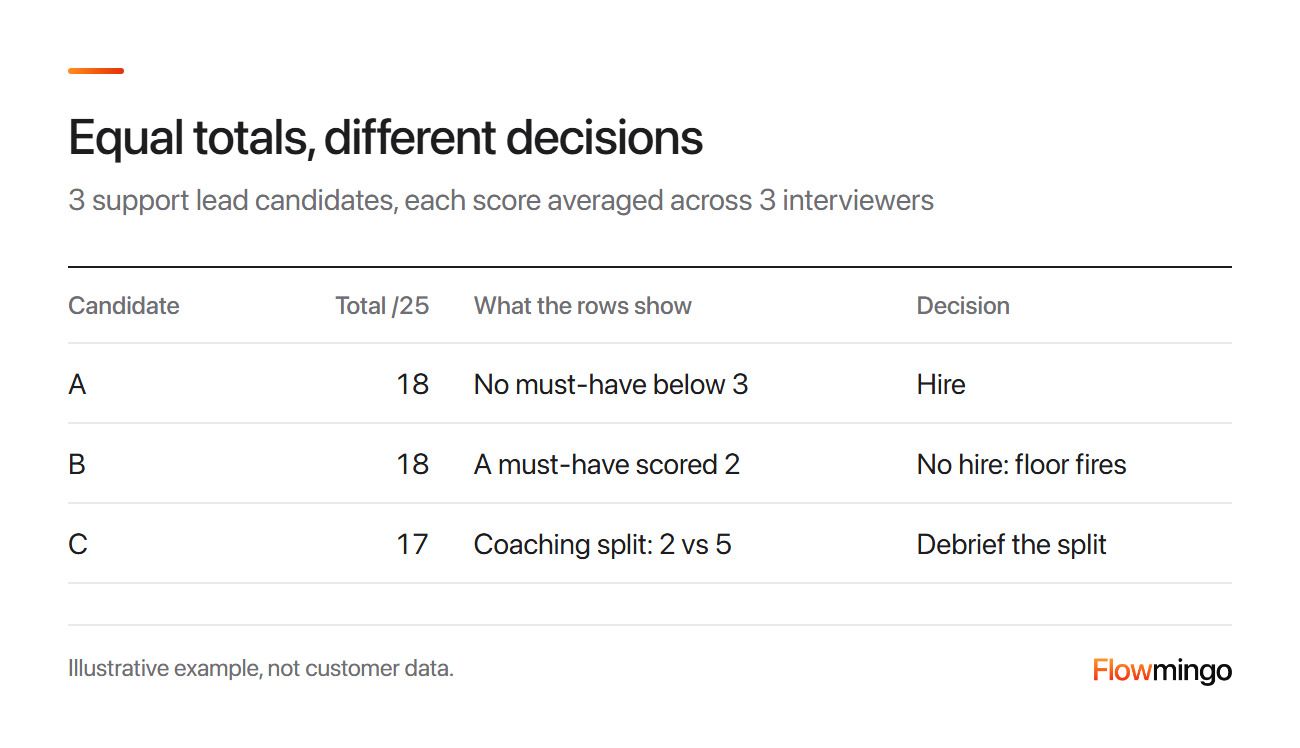
កាតពិន្ទុសម្ភាសន៍ដែលបានបំពេញ ជាឧទាហរណ៍៖ A និង B ស្មើគ្នានៅ 18 ក្នុងចំណោម 25, B ខកខានជំនាញចាំបាច់ ហើយ C មានការបែកគ្នាលើការបង្វឹកដែលត្រូវពិភាក្សា។
នៅពេលពិន្ទុជ្រើសរើសបេក្ខជនចុងក្រោយបានហើយ សូមសរសេរលក្ខខណ្ឌចូលក្នុងការផ្តល់ជូនមុនពេលអ្នកផ្ញើវា៖ គំរូលិខិតផ្តល់ជូនការងារ របស់យើងបង្ហាញកន្លែងដែលការត្រួតពិនិត្យនីមួយៗត្រូវដាក់។
5.1 ចុះបើអារម្មណ៍ខ្ញុំនិយាយមួយយ៉ាង ហើយពិន្ទុនិយាយមួយយ៉ាងវិញ?
សូមធ្វើតាមពិន្ទុ លុះត្រាតែអ្នកអាចសរសេរភស្តុតាងដែលពួកគេខកខានបាន។ នៅក្នុងការវិភាគបរិមាណជាមូលដ្ឋានឆ្នាំ 2013 របស់ Kuncel និងសហការី រូបមន្តមួយដែលអនុវត្តដូចគ្នាចំពោះមនុស្សគ្រប់រូបបានព្យាករណ៍ពីការអនុវត្តការងារនៅ 0.44 ធៀបនឹង 0.28 សម្រាប់ការវិនិច្ឆ័យរួម។ អ្នកនិពន្ធហៅវាថាជាការកែលម្អក្នុងការព្យាករណ៍ច្រើនជាង 50% សូម្បីតែធៀបនឹងអ្នកជំនាញដែលដឹងពីការងារក៏ដោយ។
ការវិនិច្ឆ័យរួមមានន័យថាមនុស្សថ្លឹងថ្លែងការពិតដូចគ្នានៅក្នុងក្បាលរបស់ពួកគេ រួមទាំងការប្រជុំដើម្បីឯកភាពគ្នា។ ដូច្នេះការពិភាក្សាបំពេញចន្លោះភស្តុតាង ហើយមិនបោះឆ្នោតឡើងវិញទេ។
5.2 តើខ្ញុំគួរប្រៀបធៀបបេក្ខជនជាប់ជម្រើសចុងក្រោយជាមួយគ្នាដោយផ្ទាល់ដែរឬទេ?
បាទ/ចាស តាមចម្លើយម្តងមួយៗ។ ការណែនាំរបស់ Bohnet នៅ HBR គឺត្រូវប្រៀបធៀបចម្លើយទាំងអស់ចំពោះសំណួរទី 1 រួចសំណួរទី 2 ដើម្បីឱ្យអ្នកវាយតម្លៃចម្លើយនីមួយៗធៀបនឹងចម្លើយផ្សេងទៀត។
នៅក្នុងការសិក្សានៅមន្ទីរពិសោធន៍ ជាមូលដ្ឋានក្នុងឆ្នាំ 2016 អ្នកដែលត្រូវបានបង្ហាញបេក្ខជនម្នាក់ម្តងៗ មានទំនោរទៅរកភេទដែលការយល់ឃើញបែបទូទៅ (stereotype) នៃភារកិច្ចនោះគាំទ្រ។ លទ្ធផលការងារកន្លងមកស្ទើរតែមិនមានឥទ្ធិពលអ្វី។ ពេលបង្ហាញ 2 នាក់ជាមួយគ្នាផ្ទាល់ ពួកគេជ្រើសរើសអ្នកដែលមានលទ្ធផលខ្ពស់ជាង 54% និងអ្នកដែលមានលទ្ធផលទាបជាង 8%។
ការសិក្សានេះប្រើពិន្ទុភារកិច្ចកន្លងមក មិនមែនការសម្ភាសន៍ទេ ដូច្នេះគួរចាត់ទុកវាជាតម្រុយដ៏រឹងមាំ ជាជាងភស្តុតាង។
6. តើខ្ញុំអាចបញ្ឈប់ការឱ្យអ្នកសម្ភាសន៍ដែលនិយាយខ្លាំងបំផុតឈ្នះក្នុងការពិភាក្សាបន្ទាប់ពីសម្ភាសន៍ដោយរបៀបណា?
ត្រូវឱ្យអ្នកសម្ភាសន៍គ្រប់រូបដាក់សន្លឹកពិន្ទុសម្ភាសន៍របស់ពួកគេ មុនពេលនរណាម្នាក់និយាយ រួចបើកការពិភាក្សាដោយបង្ហាញពិន្ទុទាំងនោះ។
ស្មានថាមនុស្សជាន់ខ្ពស់ម្នាក់បើកការពិភាក្សាដោយនិយាយថា "ខ្ញុំចូលចិត្តនាងណាស់" ហើយបន្ទប់ទាំងមូលចាប់ផ្តើមផ្អៀងទៅរកទស្សនៈនោះ។ ពិន្ទុដែលសរសេរដោយឯករាជ្យការពារអ្នករាល់គ្នាពីការទាញទៅរកទស្សនៈនោះ ហើយនេះជាមូលហេតុដែល Noise កំណត់ការផ្តល់ពិន្ទុដោយឯករាជ្យជាច្បាប់នៃការជ្រើសរើសបុគ្គលិក។
ក្នុងការអនុវត្ត ប្រមូលពិន្ទុក្នុងសន្លឹករួម ឬក្នុងប្រព័ន្ធតាមដានបេក្ខជនរបស់អ្នក រួចបង្ហាញពិន្ទុទាំងអស់ក្នុងពេលតែមួយ។
ក្រុមសម្ភាសន៍ ដែលអ្នករាល់គ្នាមើលការសម្ភាសន៍តែមួយដូចគ្នា ហាក់ដូចជាដំណោះស្រាយ។ នៅក្នុងការវិភាគសំយោគ (meta-analysis) ជាមូលដ្ឋានឆ្នាំ 2013 របស់ Huffcutt និងសហការី អ្នកវាយតម្លៃក្នុងក្រុមមានការយល់ស្របគ្នានៅ 0.74 ធៀបនឹង 0.44 សម្រាប់ការសម្ភាសន៍ដាច់ដោយឡែក នៅលើមាត្រដ្ឋានពី 0 ដល់ 1។
តួលេខនោះធ្វើឱ្យក្រុមសម្ភាសន៍មើលទៅល្អជាងការពិត។ សមាជិកក្រុមទាំងអស់ផ្តល់ពិន្ទុលើការអនុវត្តតែមួយក្នុងថ្ងៃតែមួយ ដូច្នេះប្រសិនបើបេក្ខជនមានព្រឹកដ៏ល្អឬអាក្រក់មិនធម្មតា ពួកគេទាំងអស់ឃើញវា។
ដូចដែល Iris Bohnet បាននិយាយនៅក្នុងការនិយាយនៅ Google ថា "ទំហំគំរូនៃការសម្ភាសន៍ជាក្រុមគឺសំខាន់គ្រាន់តែមួយ"។ ការសម្ភាសន៍ដាច់ដោយឡែក ដែលនីមួយៗផ្តល់ពិន្ទុដោយឯករាជ្យ ផ្តល់ឱ្យអ្នកនូវការមើលឃើញឯករាជ្យកាន់តែច្រើន។
6.1 តើអ្នកសម្ភាសន៍ប៉ុន្មាននាក់គួរផ្តល់ពិន្ទុដល់បេក្ខជនម្នាក់ៗ?
រហូតដល់ 4 ក្នុងការសម្ភាសន៍ដាច់ដោយឡែកពីគ្នា។ នៅក្នុងទិន្នន័យផ្ទៃក្នុងរបស់ Google ដែលមិនមែនជាការសិក្សាដែលបានពិនិត្យដោយអ្នកជំនាញ ការសម្ភាសន៍ 4 ដង បានព្យាករណ៍ការសម្រេចចិត្តជួលដោយទំនុកចិត្ត 86%។ ការសម្ភាសន៍បន្ថែមមួយៗបានបន្ថែមតិចជាង 1%។
ការសម្ភាសន៍បន្ថែមបានបន្ថែមតិចតួចចំពោះការព្យាករណ៍ការសម្រេចចិត្តជួលរបស់ Google ផ្ទាល់។ សូមប្រើវាជាការរំលឹកដើម្បីបង្ហាញហេតុផលសម្រាប់វគ្គសម្ភាសន៍នីមួយៗ មិនមែនជាចំនួនអតិបរមាជាសកល ឬជាសក្ខីភាពអំពីការអនុវត្តការងារនៅពេលក្រោយនោះទេ។
7. តើខ្ញុំធ្វើដូចម្តេចដើម្បីឱ្យអ្នកសម្ភាសន៍ដែលរវល់ពិតជាបំពេញតារាងពិន្ទុសម្ភាសន៍?
ធ្វើឱ្យការផ្តល់ពិន្ទុក្លាយជាផ្នែកមួយនៃការសម្ភាសន៍។ ផ្តល់ពិន្ទុសម្រាប់ជំនាញនីមួយៗភ្លាមៗបន្ទាប់ពីសំណួររបស់វា សរសេរសម្រង់ 1 បន្ទាត់ជាសក្ខីភាព ហើយផ្តល់ការចំណាប់អារម្មណ៍រួមជាចុងក្រោយ។
គ្មាននរណាម្នាក់ចង់បំពេញទម្រង់បែបបទមួយទៀតបន្ទាប់ពីថ្ងៃសម្ភាសន៍ទាំងមូលនោះទេ។ នេះហេតុអ្វីបានជាការផ្តល់ពិន្ទុកើតឡើងនៅក្នុងការសម្ភាសន៍ មិនមែនជាកិច្ចការផ្ទះសម្រាប់យប់នេះទេ។
Kahneman បានបង្កើតវិធីសាស្ត្រនេះសម្រាប់កងទ័ពអ៊ីស្រាអែលក្នុងឆ្នាំ 1955 បន្ទាប់ពីការសម្ភាសន៍បែបសេរីបានបង្ហាញថាស្ទើរតែគ្មានប្រយោជន៍ក្នុងការព្យាករណ៍ភាពជោគជ័យ។ អ្នកសម្ភាសន៍បានផ្តល់ពិន្ទុលើចរិតលក្ខណៈ 6 យ៉ាងតាមមាត្រដ្ឋានពី 1 ដល់ 5 ដោយបញ្ចប់មួយៗមុនពេលចាប់ផ្តើមបន្ទាប់ ដូច្នេះការចំណាប់អារម្មណ៍ដំបូងមិនអាចប៉ះពាល់ដល់អ្វីដែលនៅសល់បានទេ។
មានតែពេលនោះទេដែលពួកគេបិទភ្នែក ហើយផ្តល់ការវាយតម្លៃរួម ហើយពិន្ទុសរុបបានព្យាករណ៍បានត្រឹមត្រូវជាងមុនច្រើន។ ដំបូន្មានរបស់គាត់៖ ជួលអ្នកដែលមានពិន្ទុសរុបខ្ពស់បំផុត "ទោះបីជាមាននរណាម្នាក់ផ្សេងទៀតដែលអ្នកចូលចិត្តជាងក៏ដោយ"។
ពេលវេលាក៏សំខាន់ដែរ។ នៅក្នុងការសិក្សាវាល អ្នកសម្ភាសន៍ 166 នាក់បានរាយការណ៍ថាតើពួកគេសម្រេចចិត្តនៅពេលណា។ មានតែ 4.9% នៃការសម្រេចចិត្តប៉ុណ្ណោះកើតឡើងក្នុងនាទីដំបូង ប៉ុន្តែ 22.5% កើតឡើងបន្ទាប់ពីការសម្ភាសន៍បានបញ្ចប់។
ការសម្រេចចិត្តដែលធ្វើឡើងបន្ទាប់ពីបេក្ខជនចាកចេញពឹងផ្អែកលើការចងចាំ ដូច្នេះត្រូវផ្តល់ពិន្ទុពេលកំពុងសម្ភាសន៍។
សម្រាប់ប្រធានផ្នែកគាំទ្ររបស់យើង វាមើលទៅដូចនេះ៖
- សួរសំណួរ 2 អំពីជួរងារ បន្ទាប់មកផ្តល់ពិន្ទុ "ការរៀបចំអាទិភាពជួរងារ" មុនពេលបន្តទៅមុខ។
- សរសេរសម្រង់ 1 ជាសក្ខីភាព ដូចជា "ខ្ញុំតម្រៀបកំហុសតាមចំនួនអតិថិជនដែលវាប៉ះពាល់។"
- រក្សាលំដាប់ជំនាញដូចគ្នាសម្រាប់បេក្ខជនម្នាក់ៗ។
សក្ខីភាពជាលាយលក្ខណ៍អក្សរគឺកម្រមាននៅក្នុងទិន្នន័យរបស់យើង។
ទិន្នន័យ Flowmingo · បេក្ខជនដែលបានសម្ភាសន៍ដោយ AI ចំនួន 86,638 នាក់ · ក្រុមហ៊ុន 2,574 · ខែកក្កដា 2025 ដល់ ខែកញ្ញា 2026
- 0.3% នៃបេក្ខជនដែលបានសម្ភាសន៍ដោយ AI ទទួលបានមតិយោបល់ជាលាយលក្ខណ៍អក្សរពីក្រុមជ្រើសរើស (258 ក្នុងចំណោម 86,638)។
ក្រុមហ៊ុនអាចរក្សាកំណត់ចំណាំនៅកន្លែងផ្សេង។ នៅក្នុង Flowmingo របាយការណ៍ AI ជាធម្មតាគឺជាការវាយតម្លៃជាលាយលក្ខណ៍អក្សរតែមួយគត់ដែលមានក្នុងឯកសារ។
ហេតុផលជាលាយលក្ខណ៍អក្សរគឺជាអ្វីដែលគេលោតរំលងមុនគេនៅថ្ងៃដែលមមាញឹក។ នេះហើយជាមូលហេតុដែលទម្រង់ស្នើសុំតែ 1 សម្រង់សម្ដីក្នុងមួយជំនាញ។
8. តើខ្ញុំអាចទុកចិត្តពិន្ទុ AI លើតារាងពិន្ទុសម្ភាសន៍របស់ខ្ញុំបានទេ?
សូមប្រើវាជា 1 ធាតុបញ្ចូលដែលមនុស្សម្នាក់ពិនិត្យ ហើយអានហេតុផលរបស់វាជាមុនសិន។ ការវាយតម្លៃដោយ AI អាចធ្លាក់ចុះយ៉ាងខ្លាំងលើសំណួរដែលវាមិនធ្លាប់បានបណ្តុះបណ្តាល។
យើងមានផលប្រយោជន៍ពាក់ព័ន្ធនឹងចម្លើយនេះ ដូច្នេះភស្តុតាងខាងក្រោមរួមបញ្ចូលទាំងផ្នែកដែលមិនលើកតម្កើង AI។
នៅក្នុងការសិក្សាមូលដ្ឋានឆ្នាំ 2023 អ្នកវាយតម្លៃដែលបានបណ្តុះបណ្តាល 2 នាក់បានវាយតម្លៃចម្លើយរបស់អ្នកស្នើ 7,017 នាក់លើមាត្រដ្ឋានចង្អុលបង្ហាញពី 1 ដល់ 5។ ម៉ូដែលដែលបានបណ្តុះបណ្តាលលើសំណួរដូចគ្នាបានផ្គូផ្គងពិន្ទុរបស់ពួកគេយ៉ាងជិតស្និទ្ធ គឺ 0.75 លើមាត្រដ្ឋាន 0 ដល់ 1។ លើទម្រង់សំណួរដែលវាមិនធ្លាប់ឃើញ វាបានធ្លាក់ដល់ 0.30 ដែលជាការផ្គូផ្គងខ្សោយ។
នេះមានន័យថាពិន្ទុ AI ល្អត្រឹមតែតាមគុណភាពនៃរូបមន្តវាយតម្លៃជាក់លាក់តាមសំណួររបស់វាប៉ុណ្ណោះ ដូច្នេះសូមអានហេតុផលរបស់វាមុនពេលអ្នកទុកចិត្តលេខនោះ។ សូមកត់សម្គាល់ផងដែរថា 3 នាក់ក្នុងចំណោមអ្នកនិពន្ធ 5 នាក់នៃការសិក្សានោះបានធ្វើការនៅក្រុមហ៊ុនផ្តល់សេវាសម្ភាសន៍ AI គឺ Modern Hire។
របៀបដែល Flowmingo ជួយ
AI Interviewer របស់ Flowmingo វាយតម្លៃតាមលក្ខណៈវិនិច្ឆ័យដែលអ្នកអនុម័ត។ AI ព្រាងសំណួរ និងលក្ខណៈវិនិច្ឆ័យពីការពិពណ៌នាការងាររបស់អ្នក ហើយអ្នកកែទាំងពីរ។ អ្នកផ្ញើការសម្ភាសន៍ទៅបេក្ខជនម្នាក់ៗឱ្យធ្វើតាមពេលវេលារបស់ពួកគេផ្ទាល់។
អ្នកទទួលបានមកវិញនូវការថតសំឡេង វិចារណាអក្សរ និងលក្ខណៈវិនិច្ឆ័យនីមួយៗដែលបានវាយតម្លៃពី 0 ដល់ 10 ជាមួយការរៀបរាប់ជាលាយលក្ខណ៍អក្សរ។ អ្នកគឺជាអ្នកធ្វើការសម្រេចចិត្តជ្រើសរើស។
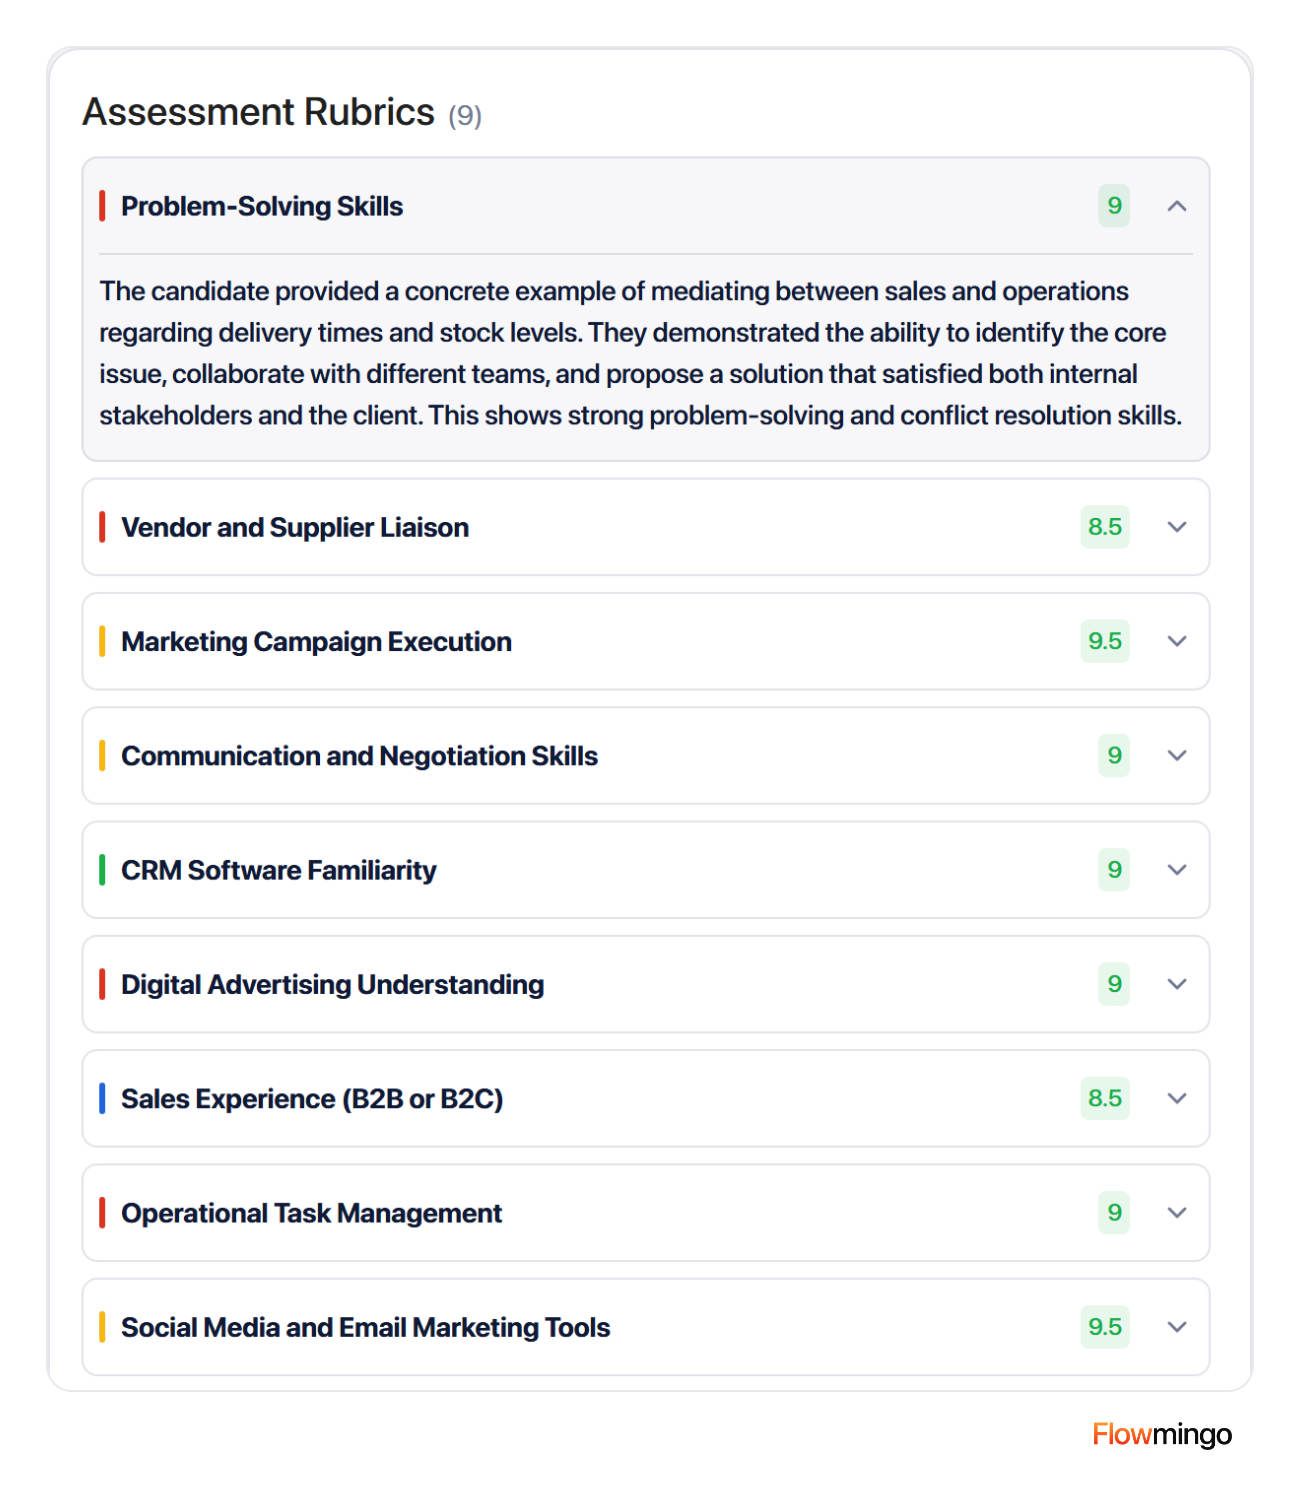
របាយការណ៍គំរូសាធារណៈរបស់ Flowmingo៖ ពិន្ទុពី 0 ដល់ 10 និងហេតុផលក្នុងមួយលក្ខណៈវិនិច្ឆ័យ ដូច្នេះសូមកំណត់កម្រិតអប្បបរមាណាមួយដែលចាំបាច់លើមាត្រដ្ឋាននោះ។
នៅក្នុងទិន្នន័យរបស់យើង CV និងការសម្ភាសន៍ក៏មិនយល់ស្របគ្នាអំពីអ្នកណាល្អជាងគេដែរ។
ទិន្នន័យ Flowmingo · បេក្ខជន 34,114 នាក់ · ក្រុមហ៊ុន 379 · ខែកក្កដា 2025 ដល់ ខែកញ្ញា 2026
- 19.2% នៃគម្រោង 532 ដែលមានពិន្ទុសម្ភាសន៍កំពូលច្បាស់លាស់ 1 ក៏បានផ្តល់ពិន្ទុ CV កំពូលដល់បេក្ខជននោះដែរ។
- 54.9% នៃបេក្ខជន 3,684 នាក់ដែលទទួលបានពិន្ទុ 8 ឬច្រើនជាងនេះក្នុងការសម្ភាសន៍ (2,022) នឹងត្រូវបានកាត់ចោលដោយបញ្ជីខ្លី CV កំពូល 20%។
ទាំងពីរគឺជាពិន្ទុ AI របស់ Flowmingo មិនមែនជាលទ្ធផលការងារទេ ហើយអ្នកសម្ភាសន៍គឺជាក្រុមដែលបានជ្រើសរើសរួច។ ទិន្នន័យបង្ហាញថាចំណាត់ថ្នាក់ទាំង 2 ខុសគ្នា មិនមែនថាមួយណាត្រឹមត្រូវទេ។
និយាយឲ្យសាមញ្ញ ក្នុងចំណោមគម្រោងទាំងនោះប្រហែល 4 ក្នុងចំណោម 5 នាក់ អ្នកដែលទទួលបានពិន្ទុខ្ពស់បំផុតក្នុងសម្ភាសន៍មិនមែនជាអ្នកដែលទទួលបានពិន្ទុ CV ខ្ពស់បំផុតដែរនោះទេ។ ដូច្នេះ ចូរឲ្យពិន្ទុសម្ភាសន៍ដោយឡែក ជាជាងបន្តយកពិន្ទុ CV មកប្រើបន្ត។
9. តើសន្លឹកពិន្ទុរបស់ខ្ញុំនឹងការពារខ្ញុំបានទេ ប្រសិនបើបេក្ខជនដែលត្រូវបានបដិសេធមកតវ៉ា?
វាជួយបាន ប្រសិនបើវាវាយតម្លៃលើភស្តុតាងដែលពាក់ព័ន្ធនឹងការងារ ហើយអ្នករក្សាទុកវា។ តាមការអានដែលសមហេតុផល ច្បាប់សហព័ន្ធអាមេរិកមានន័យថារក្សាសន្លឹកពិន្ទុយ៉ាងតិច 1 ឆ្នាំ ហើយច្បាប់រដ្ឋកាលីហ្វ័រញ៉ា 4 ឆ្នាំ។
ការតវ៉ាអាចមកដល់ច្រើនខែក្រោយមក នៅពេលដែលគ្មាននរណាចងចាំការសម្ភាសន៍នោះទេ។ សន្លឹកពិន្ទុសម្ភាសន៍ដែលមានសម្តីដកស្រង់មួយសម្រាប់ជំនាញនីមួយៗ បង្ហាញពីអ្វីដែលអ្នកបានវាយតម្លៃ និងហេតុអ្វី។
ច្បាប់អាមេរិកមិនបានឈ្មោះថាសន្លឹកពិន្ទុដោយផ្ទាល់ទេ ប៉ុន្តែវាគ្របដណ្តប់លើ "កំណត់ត្រាផ្សេងទៀតដែលទាក់ទងនឹងការជួល"។ នៅពេលដែលមាននរណាម្នាក់ដាក់ពាក្យបណ្តឹងរើសអើង អ្នកត្រូវរក្សាកំណត់ត្រាពាក់ព័ន្ធទាំងអស់រហូតដល់ករណីបញ្ចប់។ នេះរួមបញ្ចូលកំណត់ត្រារបស់បេក្ខជនផ្សេងទៀតសម្រាប់ការងារដូចគ្នា ដូច្នេះការតវ៉ាមួយបង្កកសំណុំទាំងមូល។
ច្បាប់ទាំងនេះជាធរមានគិតត្រឹមខែកញ្ញា ឆ្នាំ 2026។ នេះជាសេចក្តីសង្ខេប មិនមែនជាដំបូន្មានផ្នែកច្បាប់ទេ។
| ច្បាប់ | ទីកន្លែង | អត្ថន័យសម្រាប់សន្លឹកពិន្ទុរបស់អ្នក |
|---|---|---|
| 29 CFR 1602.14 | អាមេរិក | រក្សាកំណត់ត្រាជួល 1 ឆ្នាំ យូរជាងនេះបន្ទាប់ពីមានការតវ៉ា |
| 2 CCR 11013(c) | កាលីហ្វ័រញ៉ា | រក្សាកំណត់ត្រា 4 ឆ្នាំ រួមទាំងទិន្នន័យសម្រេចចិត្តដោយស្វ័យប្រវត្តិ |
| ការណែនាំ ICO | ចក្រភពអង់គ្លេស | បេក្ខជនអាចស្នើសុំកំណត់ត្រាសម្ភាសន៍; បង្ហាញច្បាប់បំបែកស្មើណាមួយ |
| TAFEP | សិង្ហបុរី | ប្រើទម្រង់វាយតម្លៃ និងរក្សាកំណត់ត្រាយ៉ាងតិច 1 ឆ្នាំ |
| 29 CFR 1630.11 (ADA) | អាមេរិក | ប្រសិនបើពិការភាពប៉ះពាល់ដល់ការនិយាយ ចូរវាយតម្លៃជំនាញ មិនមែនការនិយាយទេ លុះត្រាតែការនិយាយជាអ្វីដែលការងារត្រូវការ |
| AI Act, មាត្រា 5(1)(f) | សហភាពអឺរ៉ុប ចាប់ពី 2 កុម្ភៈ 2025 | ហាម AI សន្និដ្ឋានអារម្មណ៍របស់បេក្ខជនពីមុខ ឥរិយាបថ ឬការវាយចុច |
| AI Act, ឧបសម្ព័ន្ធ III និងមាត្រា 26 | សហភាពអឺរ៉ុប ចាប់ពី 2 ធ្នូ 2027 | ហានិភ័យខ្ពស់៖ ការត្រួតពិនិត្យដោយមនុស្ស រក្សាកំណត់ត្រា 6+ ខែ ជូនដំណឹងដល់បេក្ខជន |
| ច្បាប់មូលដ្ឋាន 144 | ទីក្រុងញូវយ៉ក | ពិន្ទុ AI ដែលប្រើតែឯង មានទម្ងន់លើសអ្វីៗទាំងអស់ ឬប្រើដើម្បីផ្តួលមនុស្ស៖ សវនកម្មប្រចាំឆ្នាំសម្រាប់ភាពលំអៀង និងការជូនដំណឹង |
| ច្បាប់សម្ភាសន៍វីដេអូ AI | រដ្ឋអิลลินอยส์ | ជូនដំណឹង ពន្យល់ និងទទួលការយល់ព្រមជាមុន; លុបវីដេអូក្នុងរយៈពេល 30 ថ្ងៃបន្ទាប់ពីមានសំណើ |
នោះហើយជាមូលហេតុដែលគំរូមានជួរ "មិនវាយតម្លៃ"។ សហភាពអឺរ៉ុបហាម AI ដែលអានអារម្មណ៍របស់បេក្ខជនពីមុខ ឥរិយាបថ ឬការវាយចុច ហើយច្បាប់ពិការភាពអាមេរិក (ADA) ការពារបេក្ខជនដែលពិការភាពប៉ះពាល់ដល់ការនិយាយ។ នៅចក្រភពអង់គ្លេស បេក្ខជនអាចស្នើសុំកំណត់ត្រារបស់អ្នក ដូច្នេះចូរសរសេរបន្ទាត់ភស្តុតាងនីមួយៗដូចជាពួកគេនឹងអានវា។
ដើម្បីធ្វើសវនកម្មដោយខ្លួនឯង ចូរប្រៀបធៀបអត្រាឆ្លងកាត់តាមក្រុមជាមួយវិធាន 4/5 ក្នុង គោលការណ៍ណែនាំស្តង់ដារ។ ឧបមាថា 30% នៃក្រុមមួយឆ្លងកាត់ ហើយ 50% នៃក្រុមមួយទៀត៖ 30 ចែកនឹង 50 ស្មើ 0.6 ទាបជាង 0.8 ដូច្នេះចូរពិនិត្យឲ្យជិត។
មតិយោបល់របស់ក្រសួងយុត្តិធម៌ ខែមិថុនា 2026 និង បទបញ្ជា OPM ខែកក្កដា 2026 បង្វែរទីភ្នាក់ងារសហព័ន្ធចេញពីគោលការណ៍ណែនាំស្តង់ដារ។ ប៉ុន្តែវានៅតែមាននៅក្នុងបទប្បញ្ញត្តិសហព័ន្ធ ដូច្នេះចូរចាត់ទុកការត្រួតពិនិត្យនេះជាទម្លាប់ដែលមិនចំណាយច្រើន មិនមែនជាខ្សែបន្ទាត់ច្បាប់ទេ។
10. តើខ្ញុំអនុវត្តសន្លឹកពិន្ទុសម្ភាសន៍ជាមួយក្រុមរបស់ខ្ញុំក្នុងសប្តាហ៍នេះយ៉ាងដូចម្តេច?
សាងសង់វាតាមលំដាប់នេះ ហើយផ្លាស់ប្តូរវាតែរវាងតួនាទីនីមួយៗ។ កំណែដំបូងមិនចាំបាច់ល្អឥតខ្ចោះទេ ប៉ុន្តែវាត្រូវតែដូចគ្នាសម្រាប់បេក្ខជនគ្រប់រូប។
- សរសេរបន្ទាត់បេសកកម្ម 1 បន្ទាត់ និងលទ្ធផលចំណាត់ថ្នាក់ពី 3 ដល់ 8។
- បំប្លែងពួកវាទៅជាជំនាញ 5 ហើយសម្គាល់ជំនាញដែលចាំបាច់ត្រូវមាន។
- សរសេរសំណួរអំពីឥរិយាបថកន្លងមក 2 សំណួរ និងចំណុចយោងសម្រាប់ពិន្ទុ 1, 3 និង 5 ក្នុងមួយជំនាញ។
- ឲ្យអ្នកសម្ភាសន៍រហូតដល់ 4 នាក់ផ្តល់ពិន្ទុដោយខ្លួនឯង ហើយដាក់ស្នើមុនពេលពិភាក្សាបូកសរុប។
- ឲ្យពិន្ទុសរុបជាអ្នកសម្រេច ប៉ុន្តែជំនាញចាំបាច់ណាដែលទាបជាង 3 មានន័យថាមិនជួល។ សរសេរការកែសម្រួលពិន្ទុទាំងអស់ចុះ។
ក្នុងការអនុវត្ត ចាប់ផ្តើមជាមួយតួនាទីបើកទទួល 1 តួនាទី ដើម្បីឲ្យក្រុមរបស់អ្នករៀនទម្លាប់លើការងារពិតប្រាកដ។ មុនការសម្ភាសន៍លើកដំបូង ឲ្យអ្នកទាំងអស់គ្នាផ្តល់ពិន្ទុលើចម្លើយគំរូតែមួយ ហើយប្រៀបធៀបគ្នា។
ប្រសិនបើពិន្ទុ 2 ខុសគ្នាលើសពី 1 ពិន្ទុ សរសេរចំណុចយោងឡើងវិញ រហូតដល់ពួកគេយល់ស្របគ្នា។ អ្នកវាយតម្លៃដែលបានហ្វឹកហាត់ក្នុងការសិក្សាផ្នែកទី 8 បានប្រើគម្លាត 1 ពិន្ទុដូចគ្នានេះ ដើម្បីហៅការប្រជុំ។
រំពឹងថានឹងមានការប្រឆាំងខ្លះ។ អ្នកសម្ភាសន៍ក្នុងជួរកងទ័ពរបស់ Kahneman ក៏បានប្រឆាំងនឹងការគ្រាន់តែកត់ត្រាចម្លើយដែរ ហើយដំណោះស្រាយរបស់គាត់គឺការវាយតម្លៃដោយបិទភ្នែក ដែលផ្តល់កន្លែងដល់ការវិនិច្ឆ័យរបស់ពួកគេនៅលើទម្រង់។ បន្ទាត់ចំណាប់អារម្មណ៍រួមរបស់អ្នកធ្វើដូចនោះសម្រាប់ក្រុមរបស់អ្នក។
តើ Flowmingo ជួយដោយរបៀបណា
ដើម្បីផ្ញើការសម្ភាសន៍ដែលមានរចនាសម្ព័ន្ធទៅឲ្យអ្នកដាក់ពាក្យសុំគ្រប់រូបធ្វើតាមពេលវេលាផ្ទាល់ខ្លួន ដោយថតសំឡេង និងផ្តល់ពិន្ទុតាមសន្លឹកពិន្ទុសម្ភាសន៍ 1 សន្លឹក សូមសាកល្បង Flowmingo។
11. ប្រភព
តួលេខខាងក្រៅទាំងអស់ខាងលើមានប្រភពពីបញ្ជីខាងក្រោម តាមលំដាប់នៃការលេចឡើង។ តួលេខផ្ទាល់របស់ Flowmingo មាននៅក្នុងប្រអប់ទិន្នន័យ ចាប់ពី កក្កដា 2025 ដល់ កញ្ញា 2026។
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.