3 entrevistadors, 1 finalista, 3 veredictes. Sense una rúbrica d'entrevista, la veu més forta del teu debriefing tria el candidat.
No hi ha cap formulari d'avaluació de candidats al qual tornar. Així ningú no pot explicar l'oferta al teu CEO, ni a un candidat rebutjat que ho pregunta.
Sense un formulari compartit, la gent ocupada es deixa portar per la intuïció.
I els judicis intuïtius són més febles del que semblen, com demostra Noise de Kahneman i els seus coautors.
Suposem que només saps que 1 candidat va fer una millor entrevista que un altre. La probabilitat que realment sigui la millor contractació és només del 56% al 61%, tot just una mica millor que llançar una moneda.
Una rúbrica ho soluciona en 3 passos. Cada entrevistador puntua les mateixes 4 a 6 competències segons exemples escrits, sol, abans del debriefing. Després decideix la puntuació total, tret que falli un mínim obligatori.
Conclusions clau
- Una rúbrica porta realment a millors contractacions? Sí, si cada entrevistador puntua les mateixes competències segons exemples escrits. Les entrevistes fetes així van predir l'acompliment laboral aproximadament el doble de bé que les de format lliure en una revisió del 2022.
- Quantes competències ha de puntuar? 4 a 6, cadascuna en una escala de l'1 al 5 amb un exemple de resposta escrit per a cada nivell. Qualsevol mínim obligatori per sota de 3 significa no contractar.
- Com trio entre 2 finalistes empatats? Comprova primer els mínims obligatoris i després analitza en el debriefing qualsevol divisió de 2 contra 5 a partir de l'evidència. No tornis a votar per intuïció: una fórmula fixa va superar el judici expert en una revisió del 2013.
- Quants entrevistadors necessito? Fins a 4, cadascun puntuant sol. Segons les dades del mateix Google, cada entrevista després de la quarta va afegir menys de l'1% de precisió.
- Puc confiar en la puntuació de la IA? Utilitza-la com 1 dada més i llegeix-ne els motius. En un estudi del 2023, un avaluador d'IA va seguir de prop els avaluadors humans entrenats en preguntes conegudes i ho va fer malament en les noves.
1. Una rúbrica d'entrevista m'ajuda realment a triar millors contractacions?
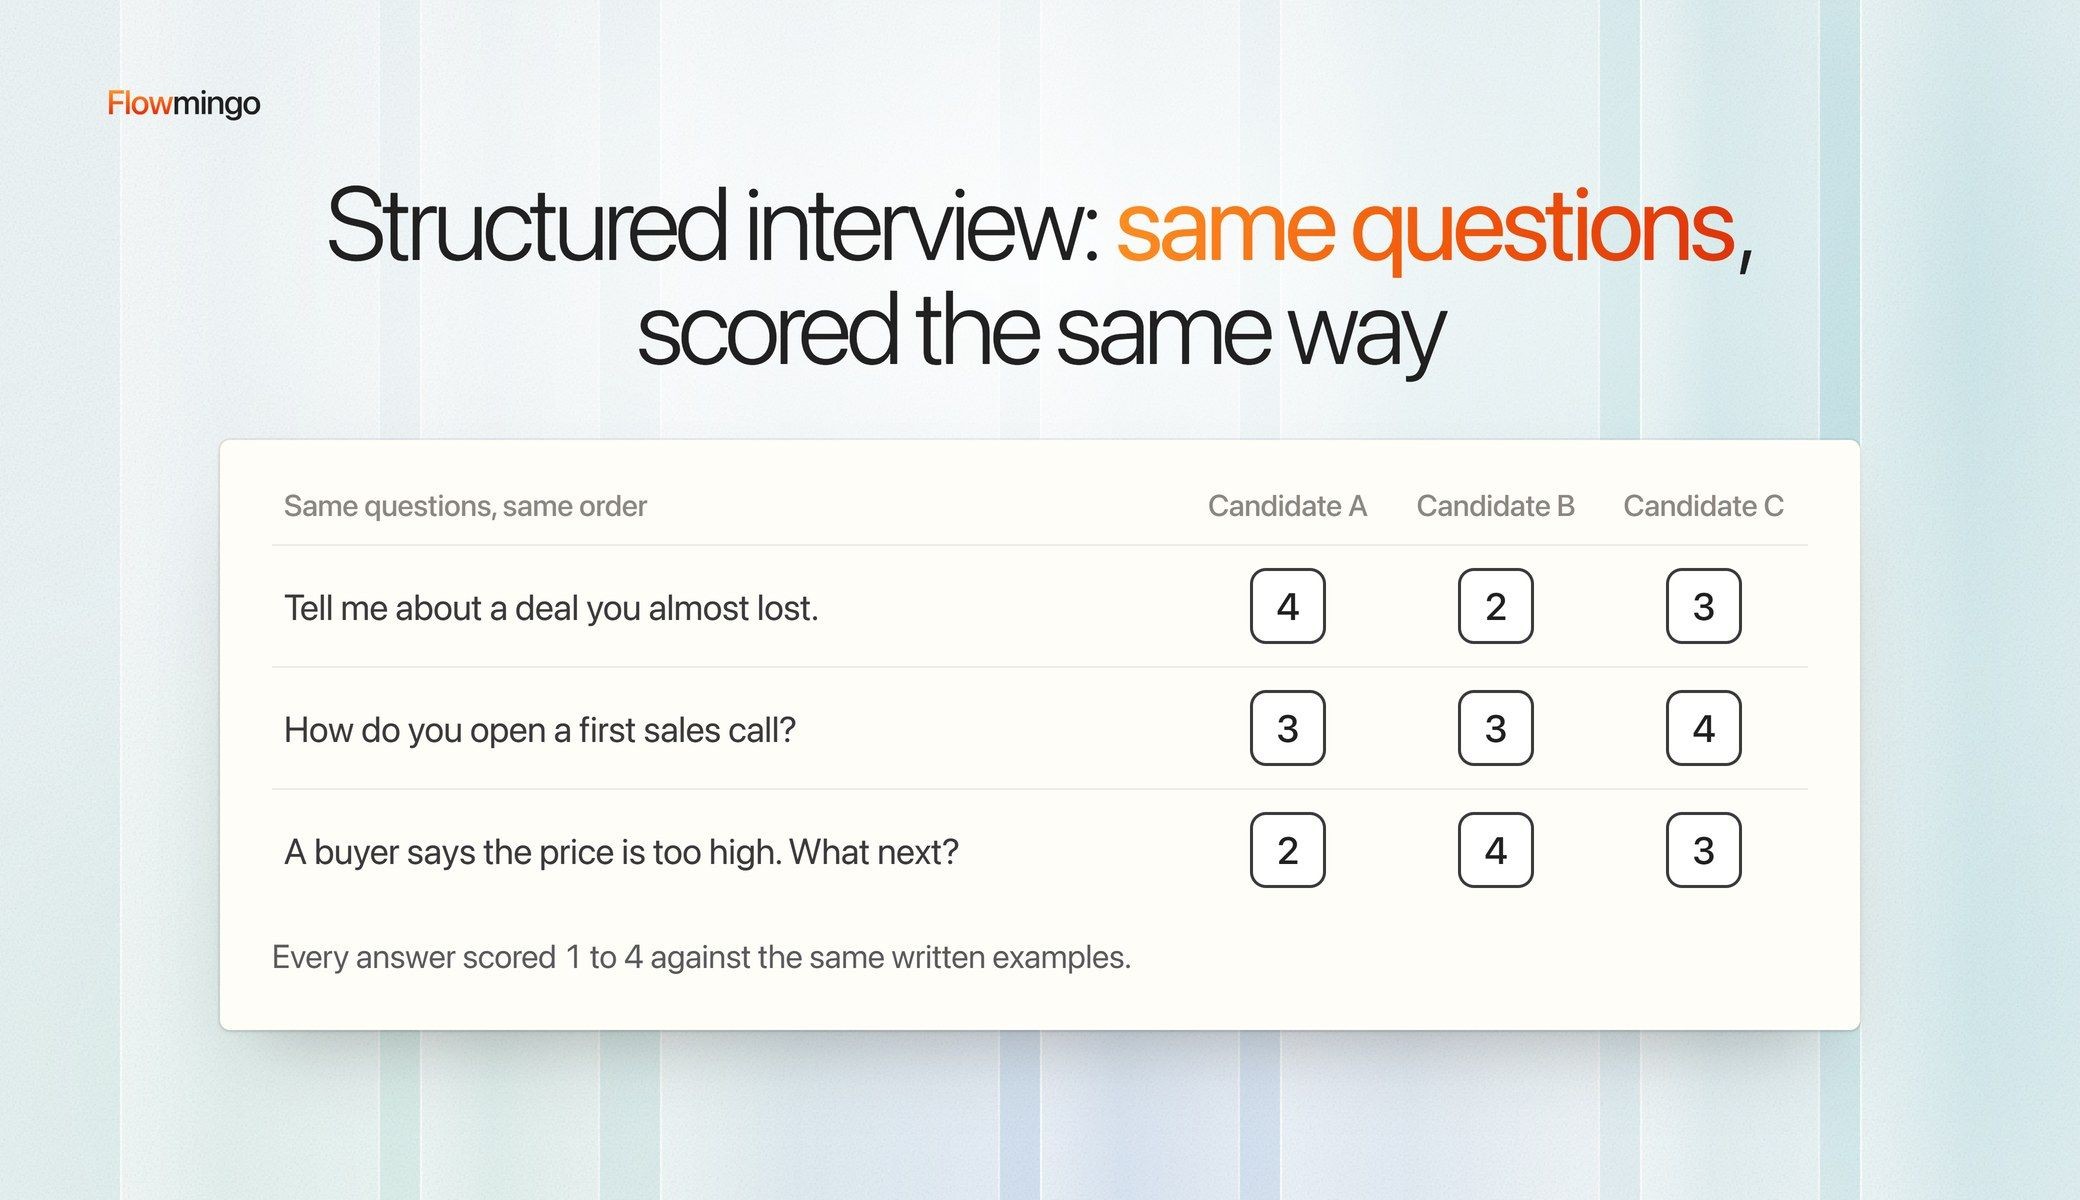
Sí, quan cada entrevistador puntua les mateixes competències segons exemples escrits. Les entrevistes estructurades, en què preguntes i puntues tothom de la mateixa manera, van predir el rendiment laboral amb un 0,42, més del doble que el 0,19 de les no estructurades.
Aquestes xifres provenen del reanàlisi fonamental de Sackett i col·legues del 2022 sobre dècades de recerca en selecció de personal.
Els números són correlacions, de 0 (cap vincle amb el rendiment laboral posterior) a 1 (un vincle perfecte). Per tant, 0,19 no vol dir que les entrevistes no estructurades encertin el 20% de les vegades. Vol dir que el seu vincle amb el rendiment posterior és feble.
El gràfic següent classifica 6 mètodes comuns. Els tests de coneixements del lloc, amb 0,40, i les biodades codificades, un qüestionari de antecedents puntuat, amb 0,38, queden just darrere.
Els segueixen les proves de mostra de treball, amb 0,33, i els tests d'aptitud cognitiva, amb 0,31. Les entrevistes no estructurades, la xerrada lliure amb què la majoria hem crescut, queden en últim lloc.
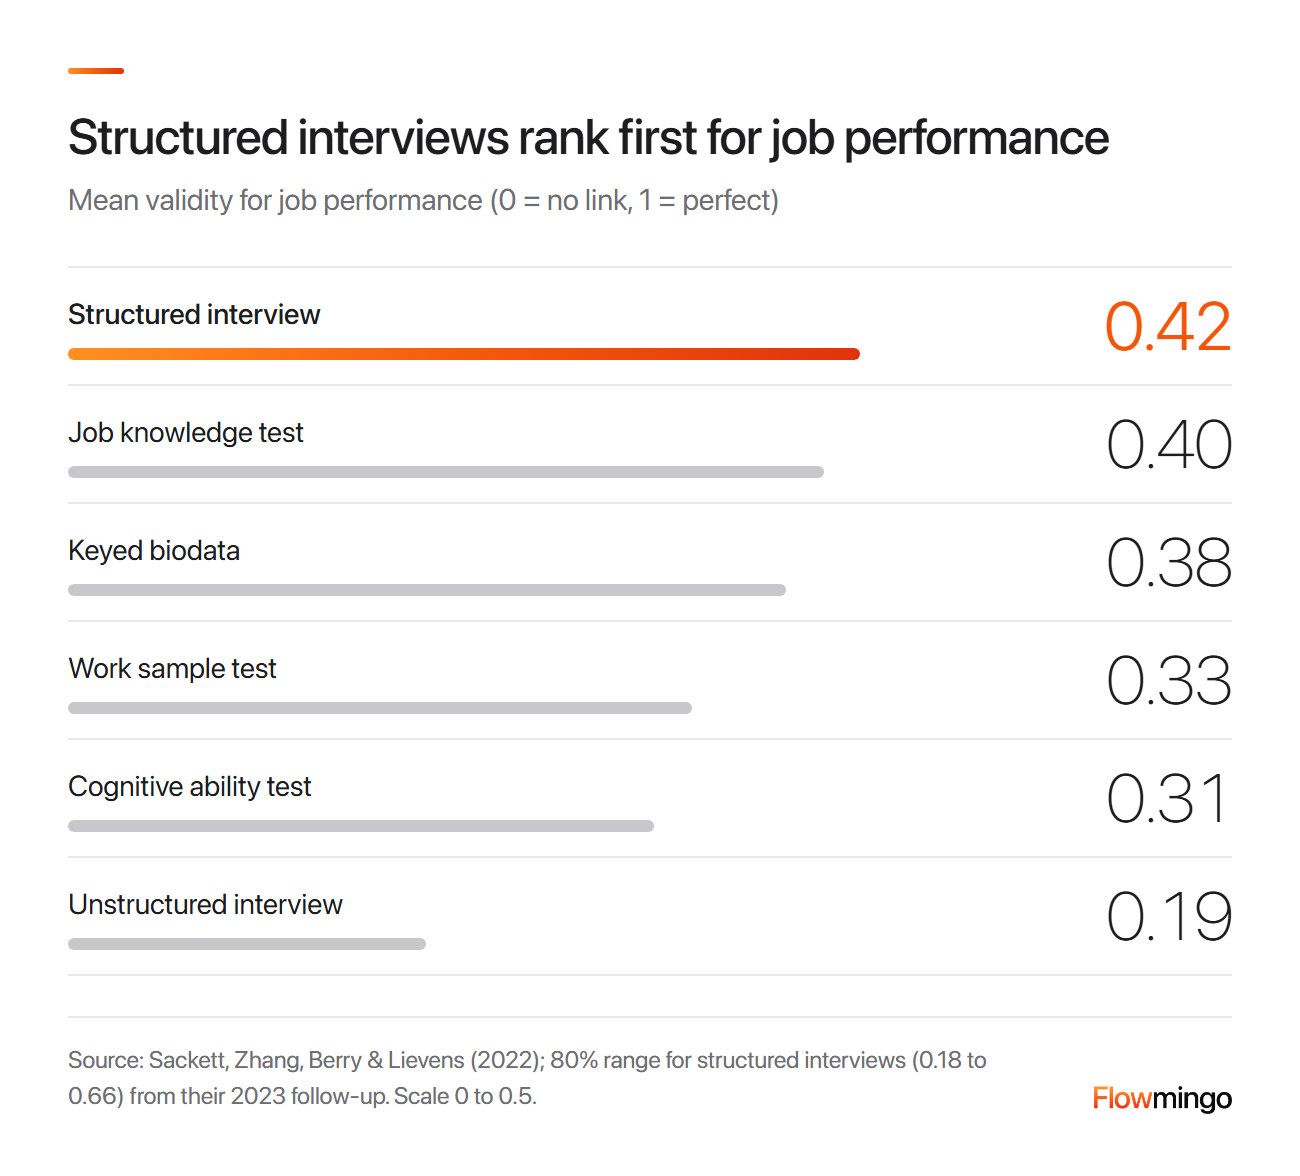
Mètodes de selecció classificats pel vincle amb el rendiment laboral: les entrevistes estructurades lideren amb 0,42, les entrevistes no estructurades queden enrere amb 0,19 (reanàlisi fonamental de Sackett et al.).
Però 0,42 és una mitjana. El seguiment dels autors situa la majoria d'entrevistes estructurades entre 0,18, no millor que una xerrada lliure, i 0,66, millor que qualsevol cosa del gràfic.
El disseny és 1 de les 3 raons que els autors donen per a aquesta dispersió. Això vol dir que una rúbrica d'entrevista amb competències vagues corre el risc d'acabar a prop de la part baixa. Són mitjanes de molts empleadors, no una promesa sobre la teva propera contractació.
2. Què ha d'incloure la meva plantilla de rúbrica d'entrevista?
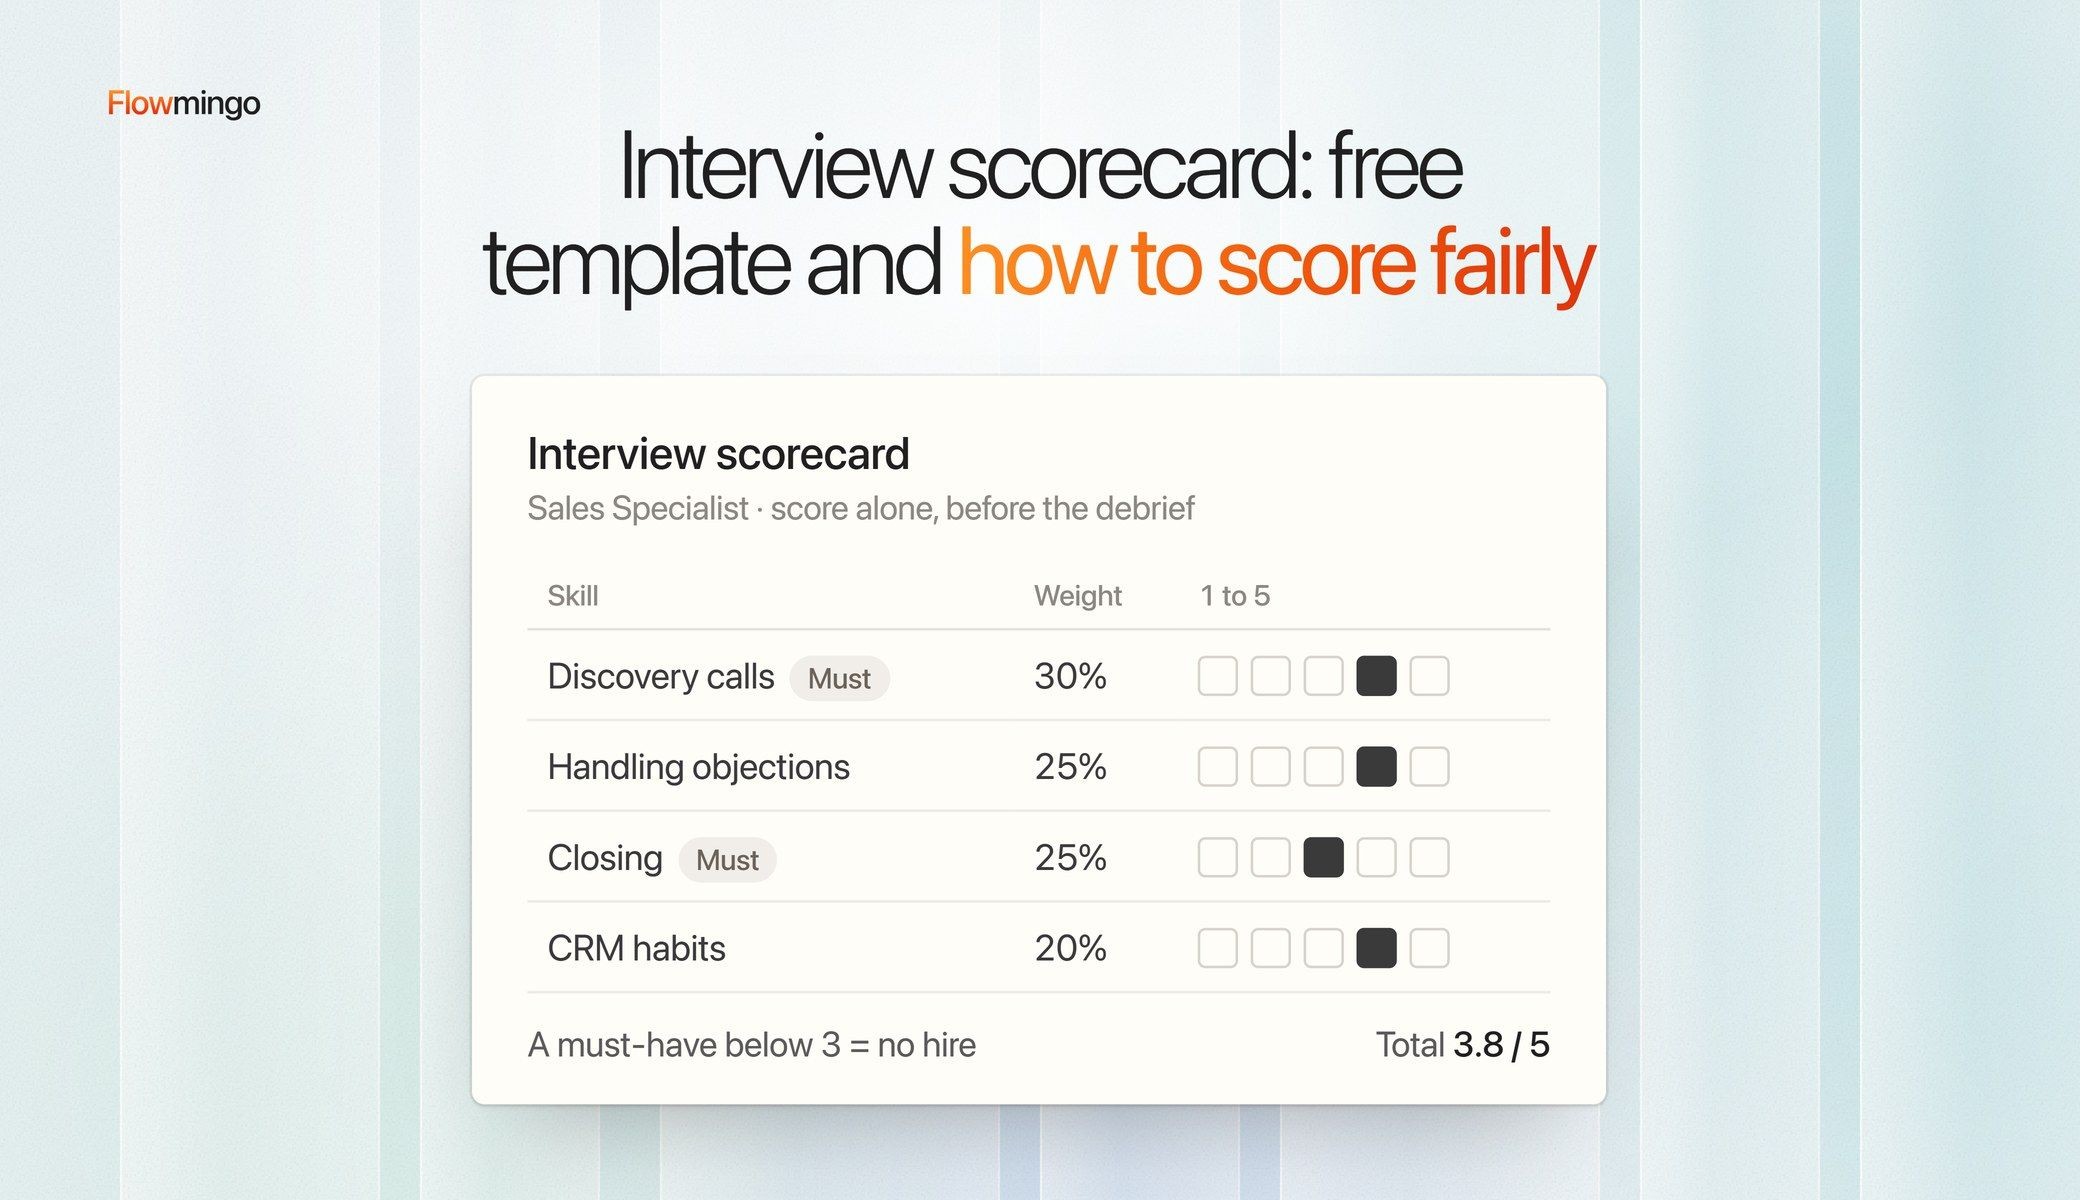
Una plantilla de rúbrica d'entrevista, o formulari d'avaluació de candidats, inclou 5 competències, anchors escrits, una casella d'evidència i un llindar de requisits imprescindibles, tot en 1 pàgina. Acaba amb una impressió general i una recomanació.
Els anchors fan que el 4 d'un entrevistador signifiqui el mateix que el d'un altre, i la casella d'evidència respon al "per què" quan el teu CEO ho pregunta.
El llindar impedeix que una puntuació total forta amagui un requisit imprescindible feble. La impressió general va al final, perquè una intuïció escrita primer condiciona cada puntuació d'habilitat posterior.
Aquí teniu aquest formulari per a un responsable d'atenció al client, amb 2 requisits imprescindibles. Cadascuna de les 5 habilitats es puntua de l'1 al 5, així que el total és sobre 25.
Feu 2 preguntes sobre conducta passada per habilitat, perquè un exemple passat real us dona quelcom concret amb què contrastar els ancoratges. Per exemple: «Explica'm l'última vegada que un client enfadat va escalar el cas fins a tu».
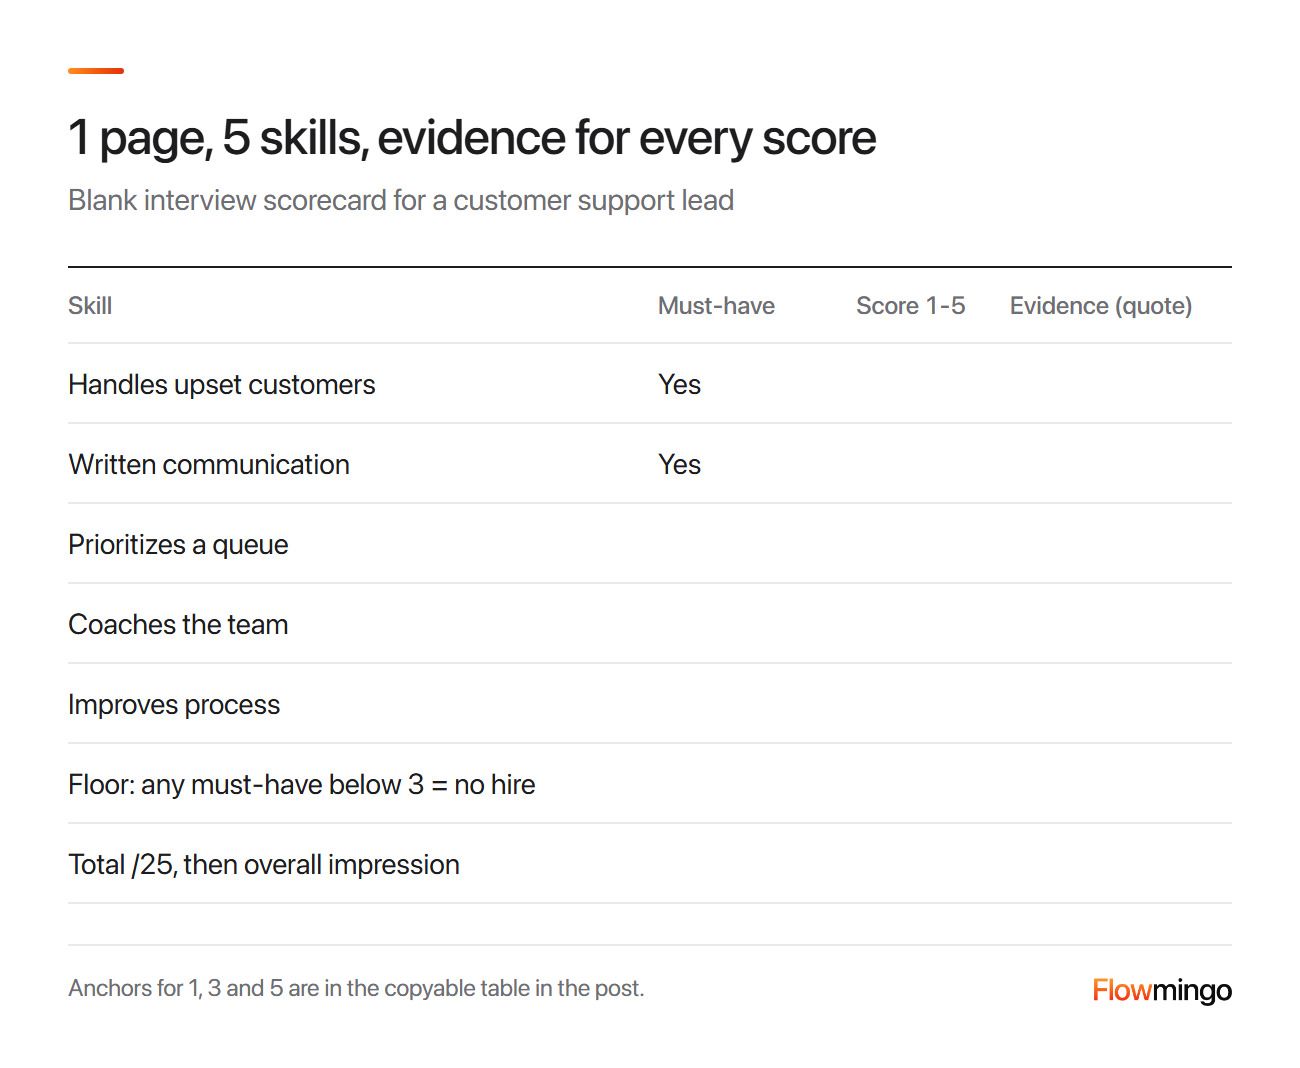
Plantilla en blanc de fitxa d'entrevista per a un responsable d'atenció al client: 5 habilitats, 2 requisits imprescindibles, una puntuació de l'1 al 5 i una cita de proves per a cadascuna.
Copieu la taula i després substituïu-hi les vostres pròpies habilitats i ancoratges.
| Habilitat | Ancoratges per a 1 / 3 / 5 | Puntuació 1-5 | Proves (cita) |
|---|---|---|---|
| Capçalera | Candidat, lloc, entrevistador, data | ||
| Gestiona clients enfadats (imprescindible) | Culpa el client / aplica la política / arregla la causa | ||
| Comunicació escrita (imprescindible) | Poc clara / clara però llarga / curta i clara | ||
| Prioritza una cua | Sense mètode / per urgència / per impacte | ||
| Entrena l'equip | Sense exemple / dona consells / estableix un pla | ||
| Millora processos | Sense exemple / suggereix una solució / implementa una solució | ||
| Llindar de requisits imprescindibles | Qualsevol requisit imprescindible per sota de 3 significa no contractar | ||
| No puntuat | Emocions llegides de la cara, la veu o l'escriptura; accent o ritme tret que el lloc ho requereixi; «encaix cultural» | ||
| Total | Suma de les 5 puntuacions, sobre 25 | ||
| Impressió general | De l'1 al 5, emplenada al final | ||
| Recomanació | Contractació forta / contractar / no contractar / no contractar de cap manera; una excepció necessita un motiu escrit |
2.1 Què he de decidir abans de construir-la?
Definiu primer l'èxit en el lloc i després trieu les habilitats que el fan possible. Congeleu la fitxa d'entrevista abans que arribi el primer CV.
Aquest ordre prové de Who, de Geoff Smart i Randy Street. Escriviu 1 línia de missió, després de 3 a 8 resultats ordenats per importància i, finalment, de 4 a 6 habilitats. Un resultat és una xifra mesurable, com fer créixer els ingressos de 25 milions de dòlars a 50 milions dòlars d'aquí al tercer any, no una activitat.
Congelar importa perquè la gent flexibilitza els criteris sense adonar-se'n. En els estudis fonamentals d'Uhlmann i Cohen (2005), els participants van jutjar un aspirant espavilat de carrer i un altre amb molta formació per al càrrec de cap de policia.
Tant si l'home tenia una fortalesa com l'altra, van decidir que el lloc la necessitava més, i la dona no va rebre cap impuls semblant. Comprometre's amb els criteris abans de veure els candidats va eliminar aquest biaix. Per tant, una fitxa escrita després de conèixer els candidats pot inclinar-se silenciosament cap al que ja us agrada.
2.2 Cal incloure l'encaix cultural a la graella d'avaluació?
No tal com està escrit, perquè ningú no el pot puntuar de la mateixa manera dues vegades. Converteix-lo en 1 o 2 comportaments observables, com ara "demana feedback sobre la seva pròpia feina".
Digues que el teu equip valora la franquesa: puntua més aviat "va donar un exemple concret d'haver assenyalat un error a temps".
3. Com pondero les puntuacions de les entrevistes perquè els requisits imprescindibles comptin més?
Dona el mateix pes a cada competència i afegeix un llindar per als imprescindibles, o fixa els pesos abans de la primera entrevista. Els pesos iguals sovint prediuen casos nous tan bé com els pesos ajustats a dades passades.
Aquest segon punt prové del psicòleg Robyn Dawes, tal com el resumeix Kahneman a Thinking, Fast and Slow.
Els pesos ajustats a les teves contractacions passades també aprenen els atzaros d'aquell grup. Suposa que les teves 3 millors contractacions de suport van ser totes, casualment, bones mentores: un pes ajustat afavoriria el mentoratge en tots els candidats futurs.
Els pesos iguals no poden perseguir un atzar com aquest, per això sovint prediuen els candidats nous igual de bé. Mantén també les competències independents, com aconsella Kahneman: no llistis alhora "comunicació" i "habilitats de presentació", perquè juntes compten el mateix dues vegades.
Un imprescindible treu la seva força del llindar, no d'un pes més gran. Suposa que "Gestiona clients emprenyats" puntua 2 i la resta de competències puntuen 5.
El total de 22 sobre 25 sembla fantàstic, però el llindar encara diu que no es contracta. Això és el que vols per a una competència sense la qual la feina no es pot fer.
Si poses pesos, escriu-los a la graella d'avaluació de l'entrevista des del principi i aplica'ls a tothom. Això tanca la manera més fàcil de torçar un total: canviar els pesos després de conèixer algú que t'agrada.
Com ajuda Flowmingo
L'informe d'entrevista amb IA de Flowmingo utilitza pesos fixos: un criteri Must Have compta 4 vegades més que un Good to Have en la puntuació global. Cada criteri manté la seva pròpia puntuació de 0 a 10, així que encara pots aplicar tu mateix un llindar per als imprescindibles.
4. Com puc aconseguir que un 3 signifiqui el mateix per a tots els entrevistadors?
Abans de la primera entrevista, escriu què conté una resposta d'1, de 3 i de 5 per a cada competència. Aquesta escala de valoració amb ancoratges conductuals fa que les puntuacions de 2 entrevistadors siguin comparables.
"Amb ancoratges conductuals" vol dir simplement que cada puntuació es vincula al que va fer el candidat, no a una sensació com "força bé". Sense ancoratges, un 3 a la mateixa fitxa de valoració significa "correcte" per a un entrevistador i "fluix" per a un altre.
Les entrevistes amb ancoratges també mostren una relació mitjana més forta amb el rendiment posterior. La revisió fonamental de Taylor i Small de 19 estudis sobre entrevistes de comportament passat va trobar una relació de .35 amb escales ancorades, enfront de .26 sense. Els estudis també diferien en altres aspectes, així que aquesta comparació no aïlla l'efecte d'afegir ancoratges.
Aquí tens l'escala de valoració de l'entrevista per a la competència imprescindible "Gestiona clients emprenyats".
| Puntuació | Què conté la resposta |
|---|---|
| 1 | Culpa el client; cap acció pròpia i cap resultat |
| 3 | Un exemple real: calma el client i aplica la política, però no comprova mai el resultat |
| 5 | Un exemple real: troba la causa, la resol, fa seguiment i comparteix la solució |
Cada graó cap amunt és una cosa que es pot sentir a la resposta. Per això 2 persones que l'escoltin poden arribar al mateix número.
Si encara no pots escriure ancoratges, agafa prestat els 5 nivells de la guia d'entrevista estructurada de l'OPM, l'agència de recursos humans federal dels EUA. Cadascun depèn de com de difícil era la situació i de quanta orientació va necessitar la persona.
- 1, Consciència: les situacions més simples, amb una orientació propera i àmplia.
- 2, Bàsic: situacions força difícils, amb orientació freqüent.
- 3, Intermedi: situacions difícils, amb orientació ocasional.
- 4, Avançat: situacions considerablement difícils, amb poca orientació o cap.
- 5, Expert: situacions excepcionalment difícils, en què la persona aconsella els altres.
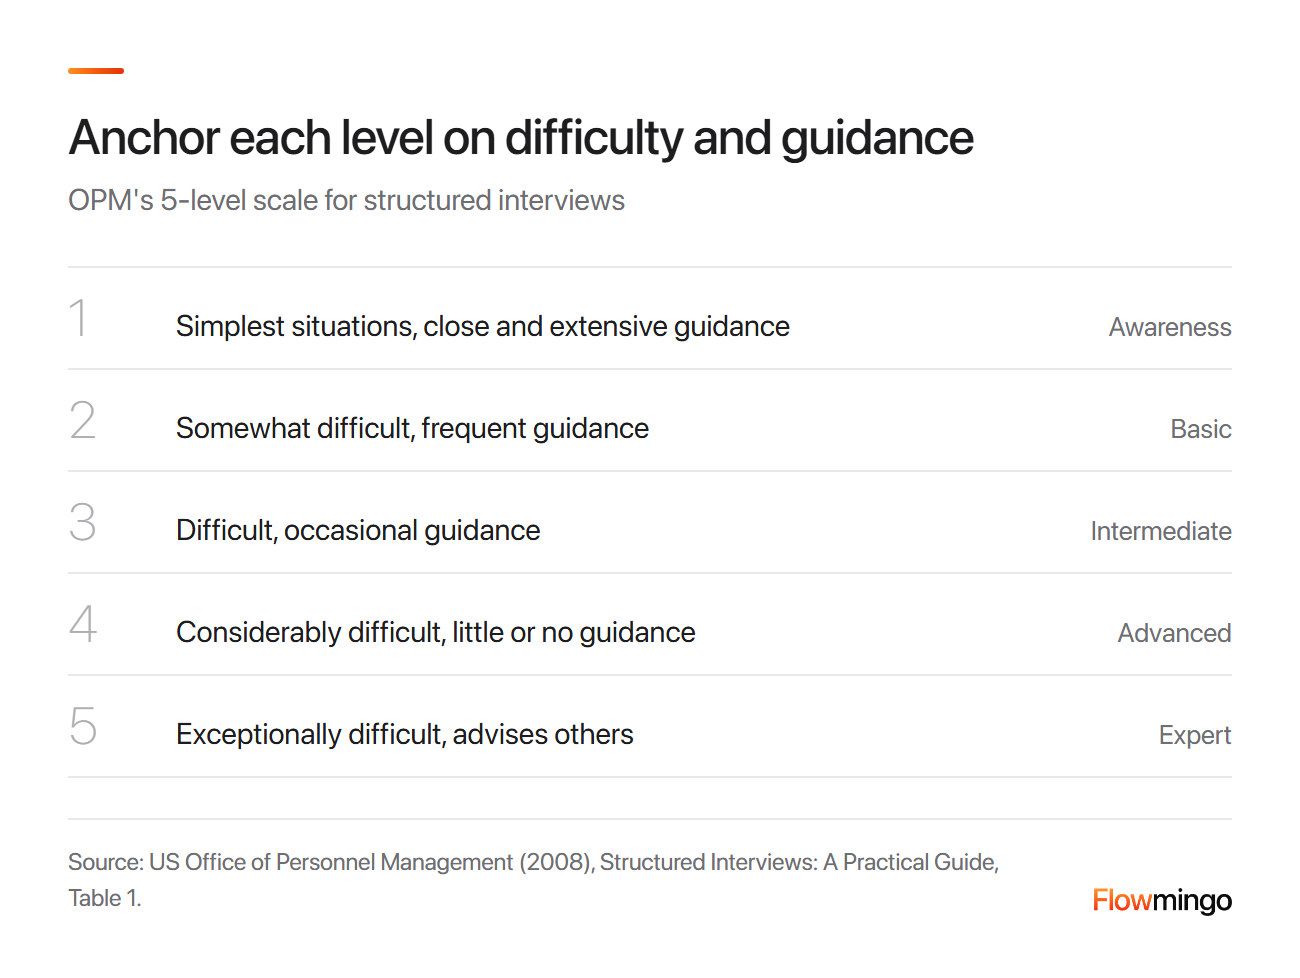
Els 5 nivells de valoració de l'OPM per a entrevistes estructurades: de Consciència (situacions més simples, orientació propera) a Expert (situacions excepcionalment difícils, aconsella els altres).
5. Com trio entre 2 finalistes forts quan els meus entrevistadors no es posen d'acord?
Que decideixi el total de la graella d'avaluació de l'entrevista, amb 2 excepcions: un requisit imprescindible per sota de 3, o una divisió de 2 contra 5, que es debat amb proves. No torneu a votar per sensació.
Aquest és el moment per al qual existeixen les graelles d'avaluació, i el moment en què és més temptador abandonar-les. Aquí teniu un exemple il·lustratiu, no són dades de clients: 3 finalistes per a líder de suport, cada cel·la és la mitjana de 3 entrevistadors.
| Competència | A | B | C |
|---|---|---|---|
| Gestiona clients enfadats (imprescindible) | 4 | 2 | 4 |
| Comunicació escrita (imprescindible) | 4 | 4 | 3 |
| Prioritza una cua | 3 | 4 | 3 |
| Fa coaching a l'equip | 3 | 4 | 4 (puntuacions 2, 5, 5) |
| Millora processos | 4 | 4 | 3 |
| Total, sobre 25 | 18 | 18 | 17 |
| Decisió | Contractar | No contractar: s'activa el mínim | Debat sobre la divisió |
Llegeix la graella d'avaluació de l'entrevista fila per fila. A i B empaten a 18 sobre 25. Però B va puntuar 2 en un requisit imprescindible, així que s'activa el mínim i B queda com a no contractar.
C suma 17, però la seva mitjana de 4 en "Fa coaching a l'equip" amaga una divisió: 1 entrevistador li va donar 2, i els altres 2 li van donar 5. Aquesta diferència es converteix en l'únic punt de l'ordre del dia del debat.
A la pràctica, demana a cada part que llegeixi les seves cites de proves. Digues que el qui va puntuar baix va sentir a parlar d'un membre de l'equip que va plegar, i els altres van sentir a parlar d'un pla de coaching que va funcionar. El debat decideix quina història és més típica de C, i qualsevol que hagi passat per alt proves canvia la puntuació per escrit.
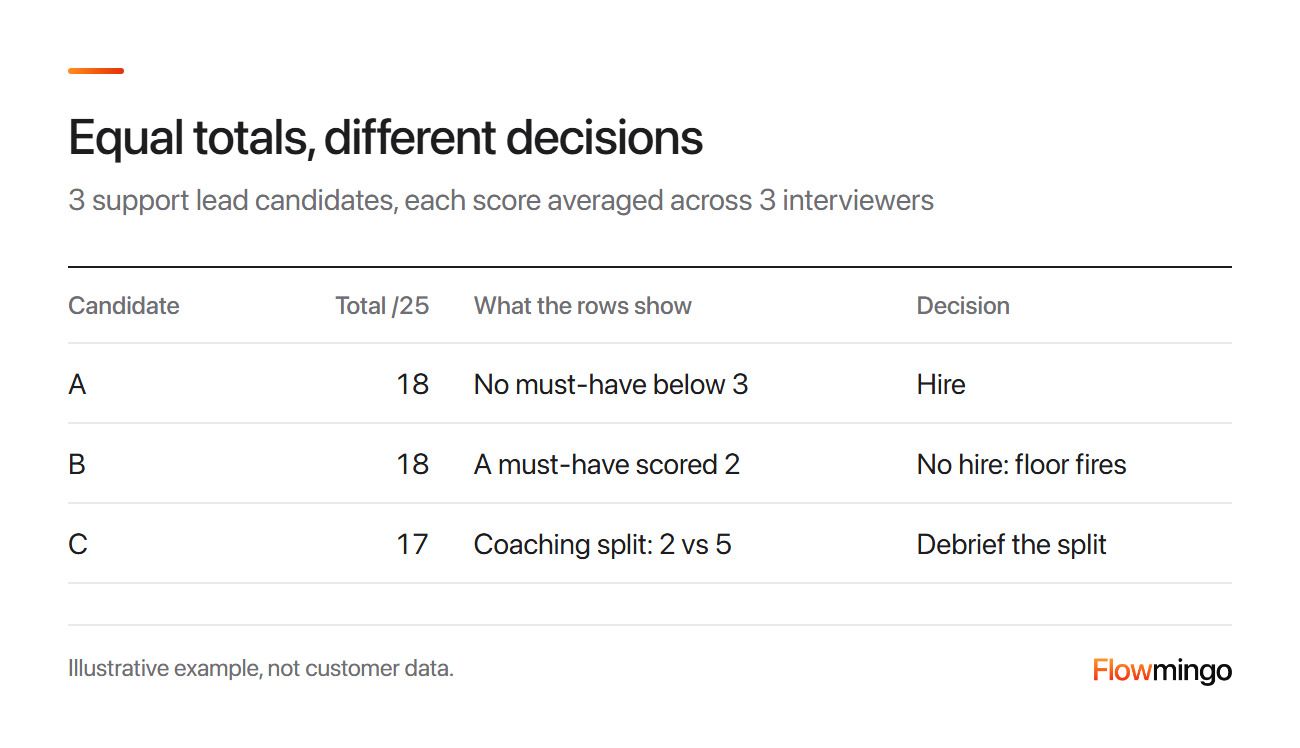
Graella d'avaluació de l'entrevista emplenada, il·lustrativa: A i B empaten a 18 sobre 25, B incompleix un requisit imprescindible, i C té una divisió en el coaching per debatre.
Un cop les puntuacions trien un finalista, escriu les condicions a l'oferta abans d'enviar-la: la nostra plantilla de carta d'oferta de feina mostra on va cada comprovació.
5.1 I si la meva intuïció diu una cosa i les puntuacions en diuen una altra?
Fes cas de les puntuacions tret que puguis escriure les proves que s'han passat per alt. En la metaanàlisi fonamental del 2013 de Kuncel i els seus col·legues, una fórmula aplicada de la mateixa manera a tothom predeia el rendiment laboral amb un 0,44, davant del 0,28 del judici holístic. Els autors ho qualifiquen d'una millora en la predicció de més del 50%, fins i tot en comparació amb experts que coneixien la feina.
El judici holístic significa que les persones ponderen els mateixos fets al cap, incloses les reunions de consens. Per tant, el debat omple els buits de proves i no torna a votar.
5.2 Cal comparar els finalistes un al costat de l'altre?
Sí, resposta per resposta. El consell de Bohnet a HBR és comparar totes les respostes a la pregunta 1, després a la pregunta 2, de manera que jutges cada resposta en relació amb les altres.
En un estudi de laboratori fonamental del 2016, les persones a qui es mostrava 1 candidat alhora es decantaven pel gènere que afavoria l'estereotip de la tasca. El rendiment anterior gairebé no comptava. Amb 2 candidats un al costat de l'altre, triaven el de rendiment més alt el 54% de les vegades i el més baix el 8%.
L'estudi va fer servir puntuacions de tasques anteriors, no entrevistes, així que cal tractar-lo com una pista sòlida més que com una prova.
6. Com evito que l'entrevistador que parla més fort domini el debrief?
Fes que cada entrevistador enviï la seva fitxa de valoració de l'entrevista abans que ningú parli, i després obre el debrief amb les puntuacions.
Imagina't que una persona sènior comença dient "m'ha encantat" i la sala comença a decantar-se cap a aquesta visió. Les puntuacions escrites en solitari protegeixen tothom d'aquesta influència, i per això Noise converteix la puntuació independent en una regla de contractació.
A la pràctica, recull les puntuacions en un full compartit o al teu sistema de seguiment de candidats, i revela-les totes alhora.
Un panell, on tothom presencia la mateixa entrevista, sembla una solució. A la meta-anàlisi fonamental de Huffcutt i els seus col·legues del 2013, els avaluadors del panell coincidien en 0,74, davant de 0,44 en entrevistes separades, en una escala de 0 a 1.
Aquesta xifra afavoreix els panells. Els membres del panell puntuen tots el mateix rendiment el mateix dia, així que si el candidat va tenir un matí inusualment bo o dolent, tots ho veuen.
Com va dir Iris Bohnet en una xerrada a Google, "la mida de la mostra d'una entrevista de panell és bàsicament u". Les entrevistes separades, cadascuna puntuada en solitari, et donen més mirades independents.
6.1 Quants entrevistadors haurien de puntuar cada candidat?
Fins a 4, en entrevistes separades. En les dades internes de Google, que no són un estudi revisat per parells, 4 entrevistes van predir la decisió de contractació amb un 86% de confiança. Cada entrevista addicional va afegir menys d'1%.
Les entrevistes addicionals van aportar poc a l'hora de predir la pròpia decisió de contractació de Google. Fes servir això com a argument per justificar cada ronda, no com un màxim universal ni com a evidència sobre el rendiment laboral posterior.
7. Com aconsegueixo que els entrevistadors enfeinats omplin realment la fitxa d'avaluació de l'entrevista?
Fes que l'avaluació formi part de l'entrevista. Puntua cada competència just després de les seves preguntes, escriu una citació d'una línia com a evidència i deixa la impressió general per al final.
Ningú no vol un altre formulari després d'un dia d'entrevistes. Per això l'avaluació es fa dins de l'entrevista, no com a deures per a aquesta nit.
Kahneman va dissenyar aquest mètode per a l'exèrcit israelià el 1955, després que les entrevistes de format lliure es demostressin gairebé inútil a l'hora de predir l'èxit. Els entrevistadors puntuaven 6 trets en una escala de l'1 al 5, acabant-ne un abans de començar el següent, perquè una primera impressió no pogués condicionar la resta.
Només llavors tancaven els ulls i donaven una valoració global, i el total va predir molt més encertadament que abans. El seu consell: contracta el total més alt, "encara que n'hi hagi un altre que t'agradi més".
El moment també importa. En un estudi de camp, 166 entrevistadors van informar de quan es formaven la seva opinió. Només el 4,9% de les decisions es van prendre en el primer minut, però el 22,5% van arribar després que hagués acabat l'entrevista.
Una decisió presa després que el candidat marxi es basa en la memòria, així que puntua sobre la marxa.
Per al nostre responsable de suport, això es tradueix en això:
- Fes les 2 preguntes sobre la cua i després puntua "Prioritza una cua" abans de continuar.
- Escriu 1 citació com a evidència, com ara "Ordeno els errors segons quants clients afecten".
- Mantén el mateix ordre de competències per a cada candidat.
L'evidència escrita és rara a les nostres dades.
Dades de Flowmingo · 86.638 candidats entrevistats per IA · 2.574 empreses · Jul 2025 a Set 2026
- El 0,3% dels candidats entrevistats per IA va rebre un comentari escrit de l'equip de selecció (258 de 86.638).
Els equips poden guardar notes en altres llocs; dins de Flowmingo, l'informe de la IA sol ser l'única avaluació escrita arxivada.
Una raó escrita és el primer que es deixa de banda en un dia atrafegat. Per això el formulari només demana 1 cita textual per competència.
8. Puc confiar en una puntuació d'IA a la meva fitxa d'entrevista?
Utilitza-la com 1 dada que revisa una persona, i llegeix primer les seves raons. La puntuació d'IA pot caure en picat en preguntes per a les quals no va ser entrenada.
Aquesta resposta ens afecta directament, així que les proves de sota inclouen la part que no afavoreix la IA.
En un estudi fonamental del 2023, 2 avaluadors entrenats van puntuar 7.017 respostes de candidats en una escala ancorada de l'1 al 5. Un model entrenat amb les mateixes preguntes va igualar de prop les seves puntuacions, amb un 0,75 en una escala de 0 a 1. En formats de pregunta que no havia vist mai, va baixar a 0,30, una coincidència feble.
Això vol dir que una puntuació d'IA només val tant com la seva rúbrica específica per pregunta, així que llegeix-ne les raons abans de confiar en el número. Tingues en compte també que 3 dels 5 autors d'aquest estudi treballaven al proveïdor d'entrevistes amb IA Modern Hire.
Com ajuda Flowmingo
L'AI Interviewer de Flowmingo puntua segons criteris que tu aproves. La IA redacta les preguntes i els criteris a partir de la teva descripció del lloc, i tu edites tots dos. Envies a cada candidat l'entrevista perquè la faci quan vulgui.
Rebràs l'enregistrament, la transcripció i cada criteri puntuat de 0 a 10 amb una justificació escrita. La decisió de contractació la prens tu.
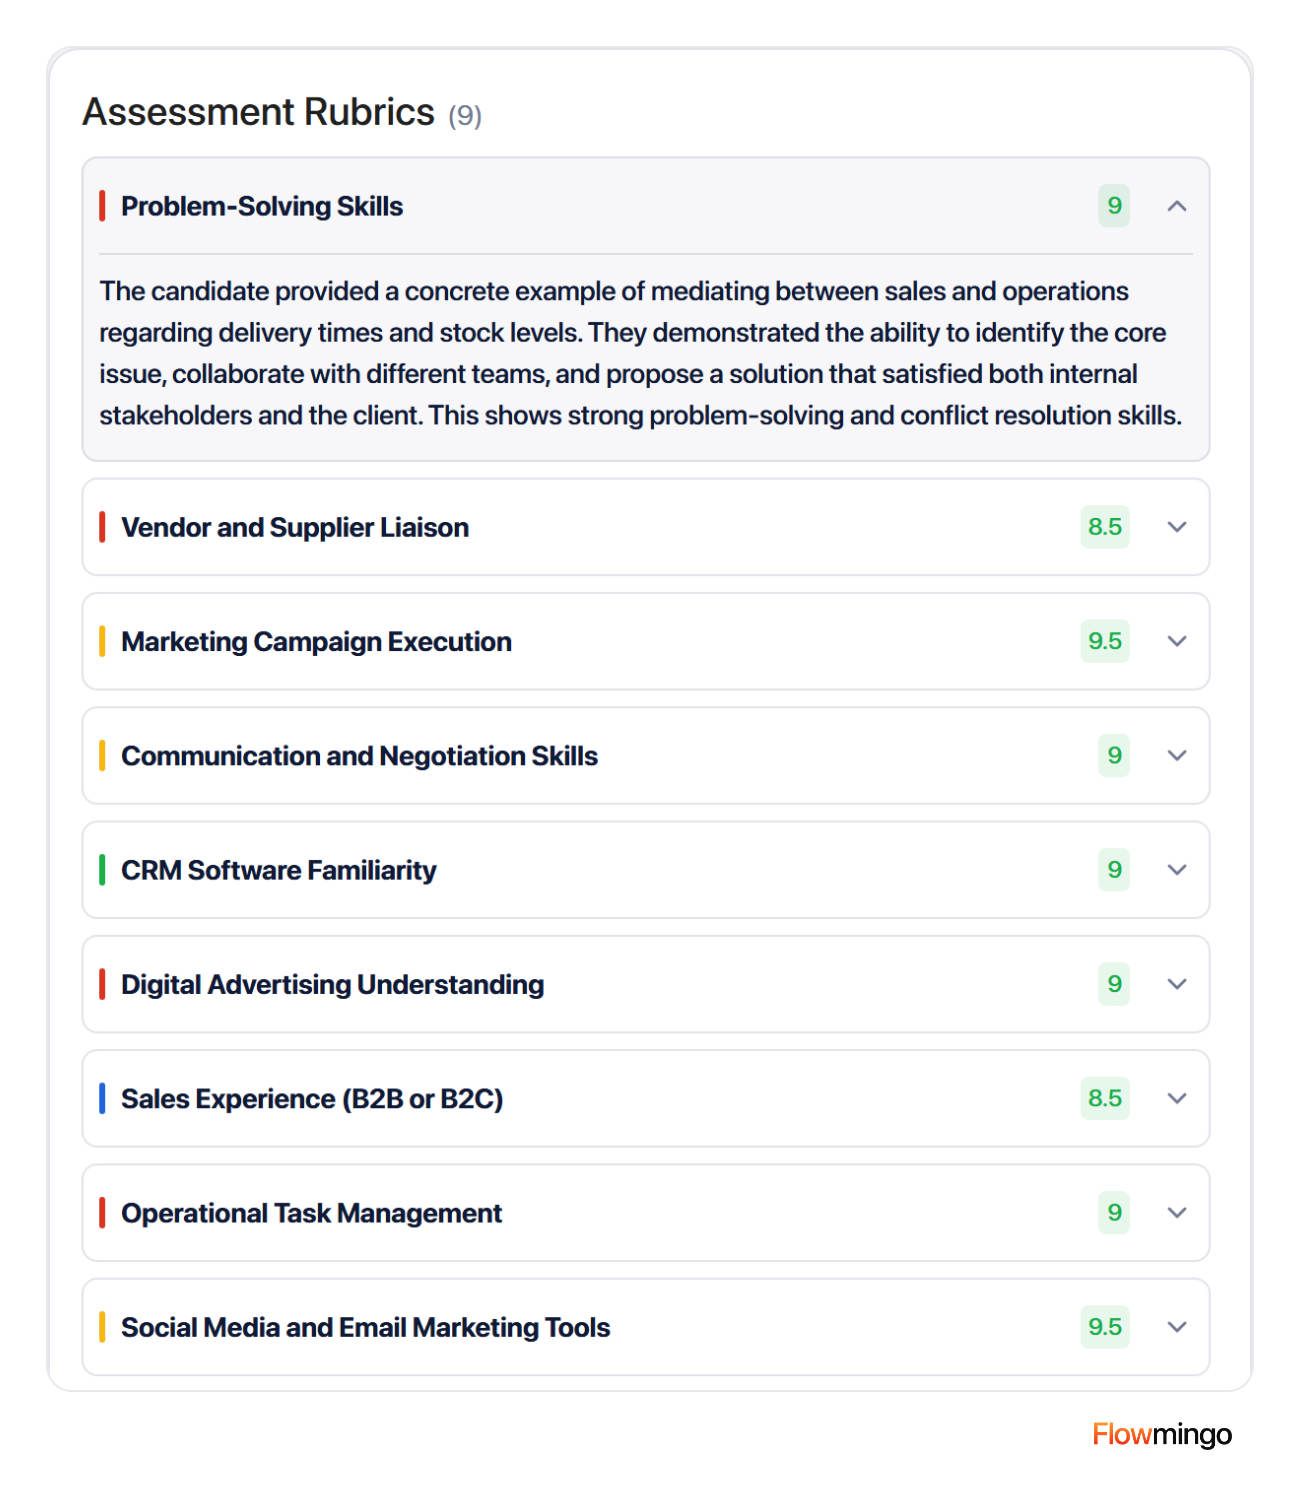
Informe d'exemple públic de Flowmingo: una puntuació de 0 a 10 i una raó per criteri, perquè fixis qualsevol llindar indispensable en aquesta escala.
A les nostres dades, el CV i l'entrevista també discrepen sobre qui és el millor.
Dades de Flowmingo · 34.114 candidats · 379 empreses · Jul 2025 a Set 2026
- El 19,2% de 532 projectes amb 1 puntuació d'entrevista clarament superior també van donar a aquest candidat la puntuació de CV més alta.
- El 54,9% dels 3.684 candidats que van obtenir 8 o més a l'entrevista (2.022) haurien quedat fora amb una preselecció pel 20% de CV més alt.
Totes dues són puntuacions d'IA de Flowmingo, no rendiment laboral, i els entrevistats són un grup seleccionat. Les dades mostren que els 2 rànquings difereixen, no quin és el correcte.
En termes senzills, en uns 4 de cada 5 d'aquests projectes, la persona amb la millor puntuació a l'entrevista no era també la que tenia la millor puntuació del CV. Per tant, puntua l'entrevista per si mateixa, en lloc de deixar que la puntuació del CV s'hi arrossegui.
9. Em protegiran les meves fitxes de valoració si un candidat rebutjat es queixa?
Ajuden, si puntuen evidències relacionades amb la feina i les conserves. Segons una lectura raonable, les normes federals dels EUA obliguen a conservar les fitxes de valoració com a mínim 1 any, i les normes de Califòrnia, 4 anys.
Una queixa pot arribar mesos després, quan ningú no recorda l'entrevista. Una fitxa de valoració d'entrevista amb una citació per competència mostra què vas avaluar i per què.
La norma dels EUA no esmenta les fitxes de valoració, però cobreix "altres registres relacionats amb la contractació". Un cop algú presenta una denúncia per discriminació, has de conservar tots els registres rellevants fins que el cas es tanqui. Això inclou els registres d'altres candidats per a la mateixa feina, de manera que 1 denúncia congela tot el conjunt.
Aquestes normes estan vigents a data de setembre de 2026. Això és un resum, no assessorament jurídic.
| Norma | On | Què significa per a la teva fitxa de valoració |
|---|---|---|
| 29 CFR 1602.14 | EUA | Conserva els registres de contractació 1 any, més temps després d'una denúncia |
| 2 CCR 11013(c) | Califòrnia | Conserva els registres 4 anys, incloses les dades de decisions automatitzades |
| Guia de l'ICO | Regne Unit | Els candidats poden demanar les notes de l'entrevista; fes pública qualsevol regla de desempat |
| TAFEP | Singapur | Utilitza un formulari d'avaluació i conserva els registres com a mínim 1 any |
| 29 CFR 1630.11 (ADA) | EUA | Si una discapacitat afecta la parla, puntua la competència, no la parla, tret que parlar sigui el que exigeix la feina |
| Llei d'IA, article 5(1)(f) | UE, des del 2 de febrer de 2025 | Cap IA que inferesqui les emocions dels candidats a partir de cares, postura o pulsacions de teclat |
| Llei d'IA, annex III i article 26 | UE, a partir del 2 de desembre de 2027 | Alt risc: supervisió humana, registres conservats 6+ mesos, candidats informats |
| Local Law 144 | Ciutat de Nova York | Una puntuació d'IA usada sola, ponderada per damunt de tot o usada per anul·lar persones: auditoria anual de biaix i notificació |
| AI Video Interview Act | Illinois | Primer notificació, explicació i consentiment; suprimeix els vídeos dins dels 30 dies d'una sol·licitud |
Per això la plantilla té una fila "No puntuat". La UE prohibeix la IA que llegeix les emocions dels candidats a partir de cares, postura o pulsacions de teclat, i la llei de discapacitat dels EUA (ADA) protegeix els candidats la discapacitat dels quals afecta la parla. Al Regne Unit, els candidats poden demanar les teves notes, així que escriu cada línia d'evidència com si l'anessin a llegir.
Per fer una autoaditoria, compara les taxes d'aprovació per grup amb la regla pràctica dels 4/5 de les Uniform Guidelines. Per exemple, si el 30% d'un grup aprova i el 50% d'un altre: 30 dividit per 50 és 0,6, per sota de 0,8, així que cal mirar-ho més de prop.
Un dictamen del Departament de Justícia del juny de 2026 i una norma de l'OPM del juliol de 2026 allunyen les agències federals de les Guidelines. Tanmateix, aquestes continuen en la normativa federal, així que tracta la comprovació com un hàbit barat, no com una línia legal.
10. Com implanto una fitxa de valoració d'entrevista amb el meu equip aquesta setmana?
Construeix-la en aquest ordre, i canvia-la només entre llocs de feina. Una primera versió no cal que sigui perfecta, però ha de ser la mateixa per a cada candidat.
- Escriu 1 línia de missió i de 3 a 8 resultats ordenats.
- Converteix-los en 5 competències i marca les imprescindibles.
- Escriu 2 preguntes sobre comportament passat i àncores per a 1, 3 i 5 de cada competència.
- Fes que fins a 4 entrevistadors puntuïn per separat i enviïn la puntuació abans del debrief.
- Deixa que decideixi el total, però qualsevol imprescindible per sota de 3 significa no contractar. Anota cada excepció.
A la pràctica, comença amb 1 lloc obert, perquè l'equip aprengui l'hàbit amb un cas real. Abans de la primera entrevista, fes que tothom puntuï la mateixa resposta d'exemple i compareu-les.
Si 2 puntuacions difereixen en més d'1 punt, reescriu l'àncora fins que coincideixin. Els avaluadors entrenats de l'estudi de la secció 8 van fer servir la mateixa diferència d'1 punt per convocar una reunió.
Espera una mica de resistència. Els entrevistadors de l'exèrcit de Kahneman també es van resistir a limitar-se a registrar respostes, i la seva solució va ser la valoració amb els ulls tancats, que va donar un lloc al formulari per al seu judici. La teva línia d'impressió general fa això mateix per al teu equip.
Com ajuda Flowmingo
Per enviar a cada candidat una entrevista estructurada per fer al seu ritme, enregistrada i puntuada segons 1 rúbrica d'entrevista, prova Flowmingo.
11. Fonts
Totes les xifres externes anteriors provenen de les fonts següents, per ordre d'aparició. Les xifres pròpies de Flowmingo es troben als quadres de dades, del juliol de 2025 al setembre de 2026.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.