3 مُقابِلون، مرشح نهائي واحد، 3 آراء. بدون بطاقة تقييم المقابلات، يختار الصوت الأعلى في جلسة التقييم المرشح المُعين.
لا يوجد نموذج تقييم مرشح يمكن الرجوع إليه. لذا لا يمكن لأحد أن يشرح العرض لرئيسك التنفيذي، أو لـمرشح مرفوض يسأل.
بدون نموذج مشترك، يعتمد المشغولون على الحدس.
والأحكام الحدسية أضعف مما تبدو عليه، كما يبين الضوضاء لكانيمان والمؤلفين المشاركين معه.
لنفترض أن كل ما تعرفه هو أن مرشحًا واحدًا أجرى مقابلة أفضل من الآخر. فرصة كونه فعلًا المرشح الأفضل للوظيفة تتراوح فقط بين 56% و61%، أي أفضل قليلًا من رمي عملة معدنية.
تعالج بطاقة التقييم هذا في 3 خطوات. يقوم كل مُقابِل بتقييم المهارات الأربع إلى الست نفسها مقابل أمثلة مكتوبة، منفردًا، قبل جلسة التقييم. ثم يقرر المجموع النهائي، إلا إذا كان شرط أساسي غير محقق.
الخلاصات الرئيسية
- هل تؤدي بطاقة التقييم فعلًا إلى توظيف أفضل؟ نعم، إذا قيّم كل مُقابِل المهارات نفسها مقابل أمثلة مكتوبة. المقابلات التي تُدار بهذه الطريقة توقعت الأداء الوظيفي بنحو ضعف المقابلات الحرة في مراجعة عام 2022.
- كم عدد المهارات التي يجب أن تُقيّم؟ من 4 إلى 6، كل مهارة على مقياس من 1 إلى 5 مع مثال إجابة مكتوب لكل مستوى. أي شرط أساسي أقل من 3 يعني عدم التعيين.
- كيف أختار بين مرشحين نهائيين متعادلين؟ افحص الشروط الأساسية أولًا، ثم ناقش أي انقسام 2 مقابل 5 بالأدلة. لا تُجرِ تصويتًا جديدًا بناءً على الحدس: فالصيغة الثابتة تفوقت على حكم الخبراء في مراجعة عام 2013.
- كم عدد المُقابِلين أحتاج؟ حتى 4، كل واحد يقيّم منفردًا. في بيانات Google نفسها، كل مقابلة بعد المقابلة الرابعة أضافت أقل من 1% دقة.
- هل يمكنني الوثوق بدرجة الذكاء الاصطناعي؟ استخدمها كمدخل واحد واقرأ أسبابها. في دراسة عام 2023، طابق مُقيّم ذكاء اصطناعي تقييمات مُقيّمين بشريين مدرّبين عن قرب في الأسئلة المألوفة، وكان أداؤه ضعيفًا في الأسئلة الجديدة.
1. هل تساعد بطاقة تقييم المقابلات فعلًا في اختيار مرشحين أفضل؟
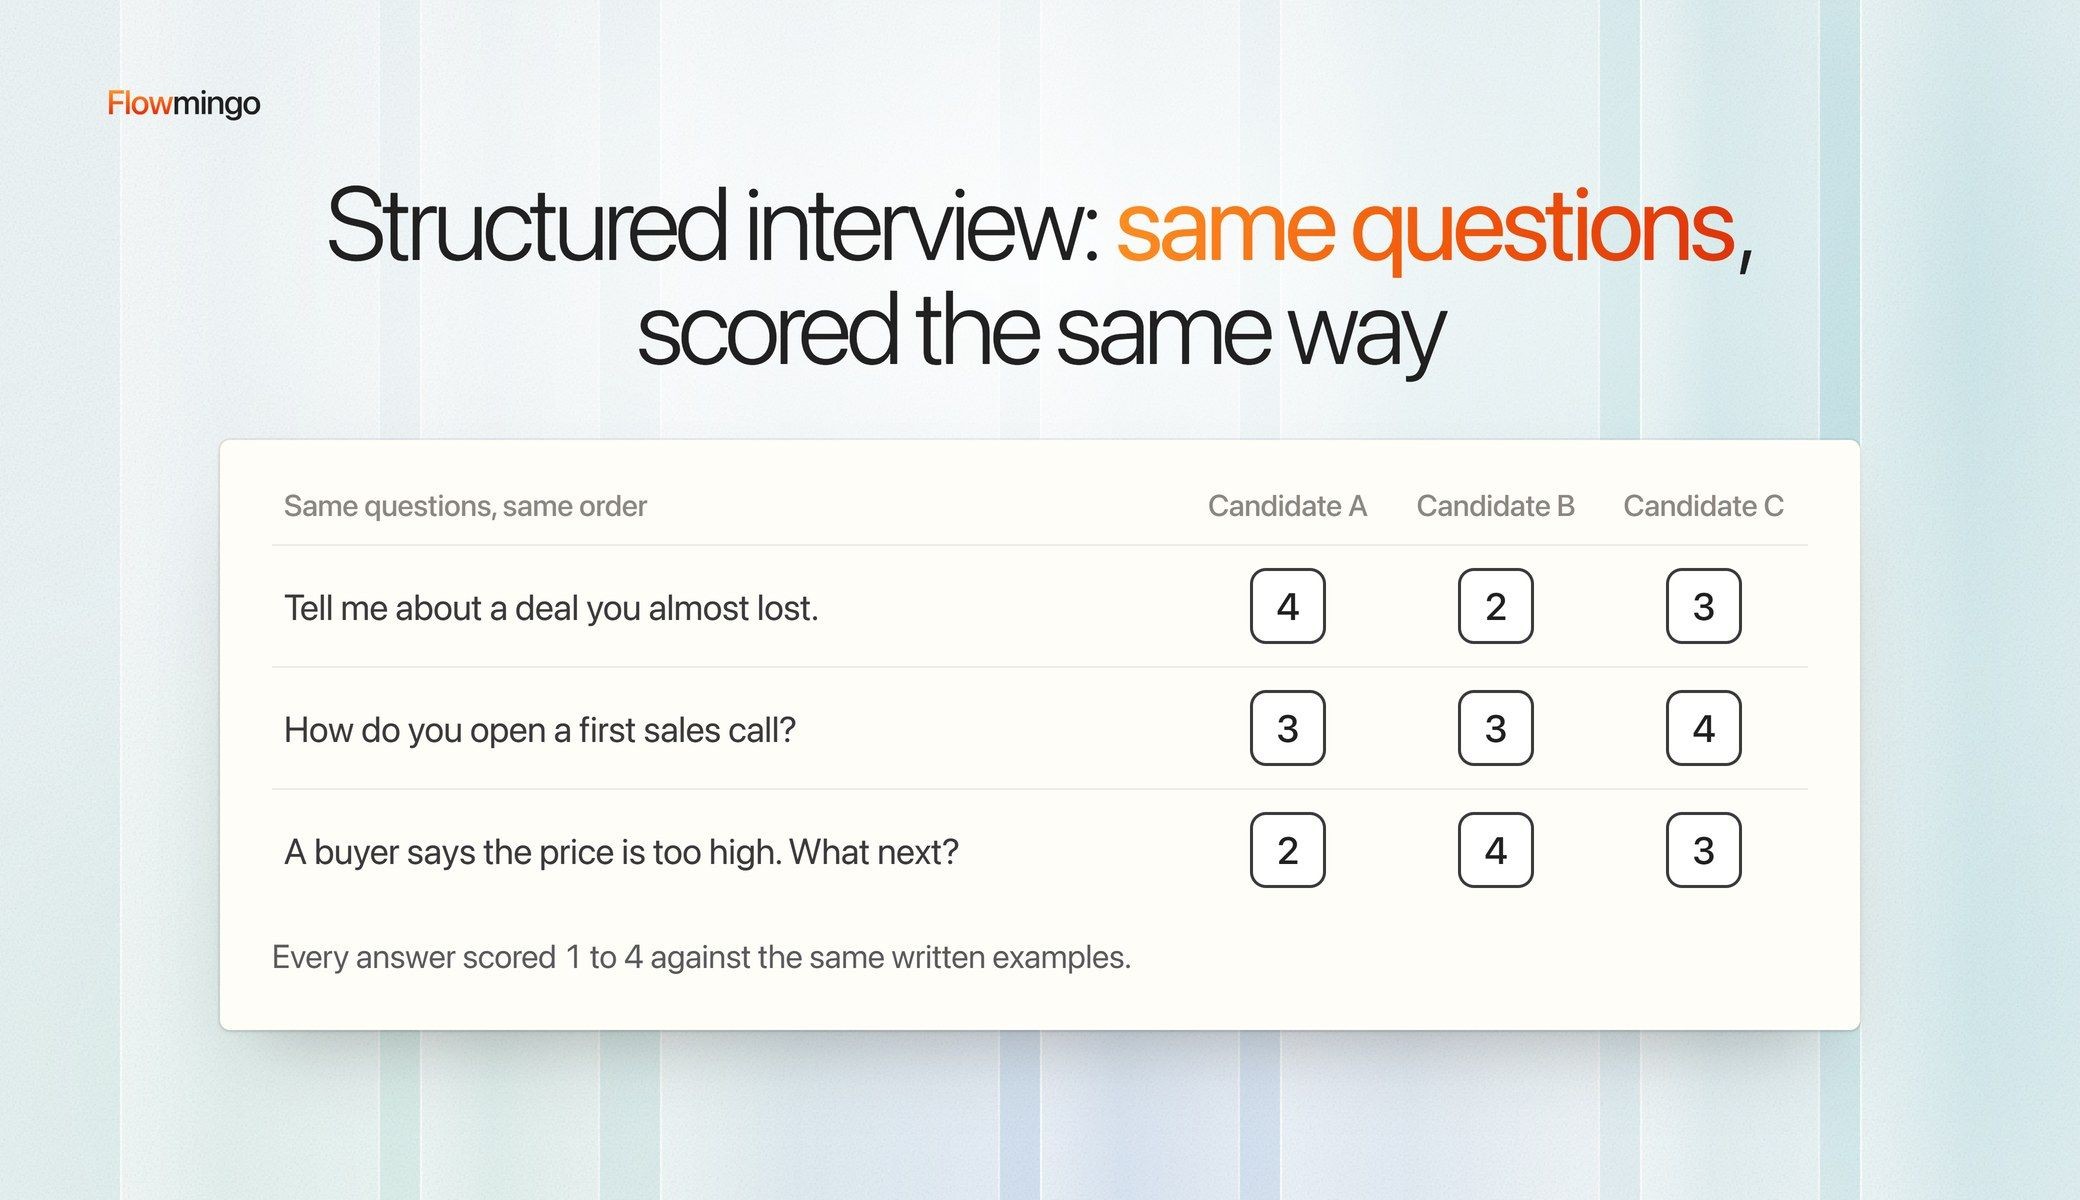
نعم، عندما يقيّم كل مقابِل نفس المهارات وفق أمثلة مكتوبة. المقابلات المنظمة، حيث تطرح الأسئلة وتقيّم الجميع بالطريقة نفسها، توقّعت الأداء الوظيفي عند 0.42، أي أكثر من ضعف 0.19 للمقابلات غير المنظمة.
تأتي هذه الأرقام من إعادة التحليل التأسيسية التي أجراها ساكيت وزملاؤه عام 2022 لعقود من أبحاث التوظيف.
الأرقام هي معاملات ارتباط، تتراوح من 0 (لا يوجد ارتباط بالأداء الوظيفي اللاحق) إلى 1 (ارتباط مثالي). لذا فإن 0.19 لا يعني أن المقابلات غير المنظمة تصيب في 20% من المرات. بل يعني أن ارتباطها بالأداء اللاحق ضعيف.
الرسم البياني أدناه يرتّب 6 أساليب شائعة. يأتي خلفها مباشرةً اختبارات المعرفة الوظيفية عند 0.40 وبيانات السيرة الذاتية المرمّزة، وهي استبيان خلفية مُقيَّم، عند 0.38.
تليها اختبارات نماذج العمل عند 0.33 واختبارات القدرة المعرفية عند 0.31. أما المقابلات غير المنظمة، وهي المحادثة الحرة التي نشأ معظمنا عليها، فتأتي في المرتبة الأخيرة.
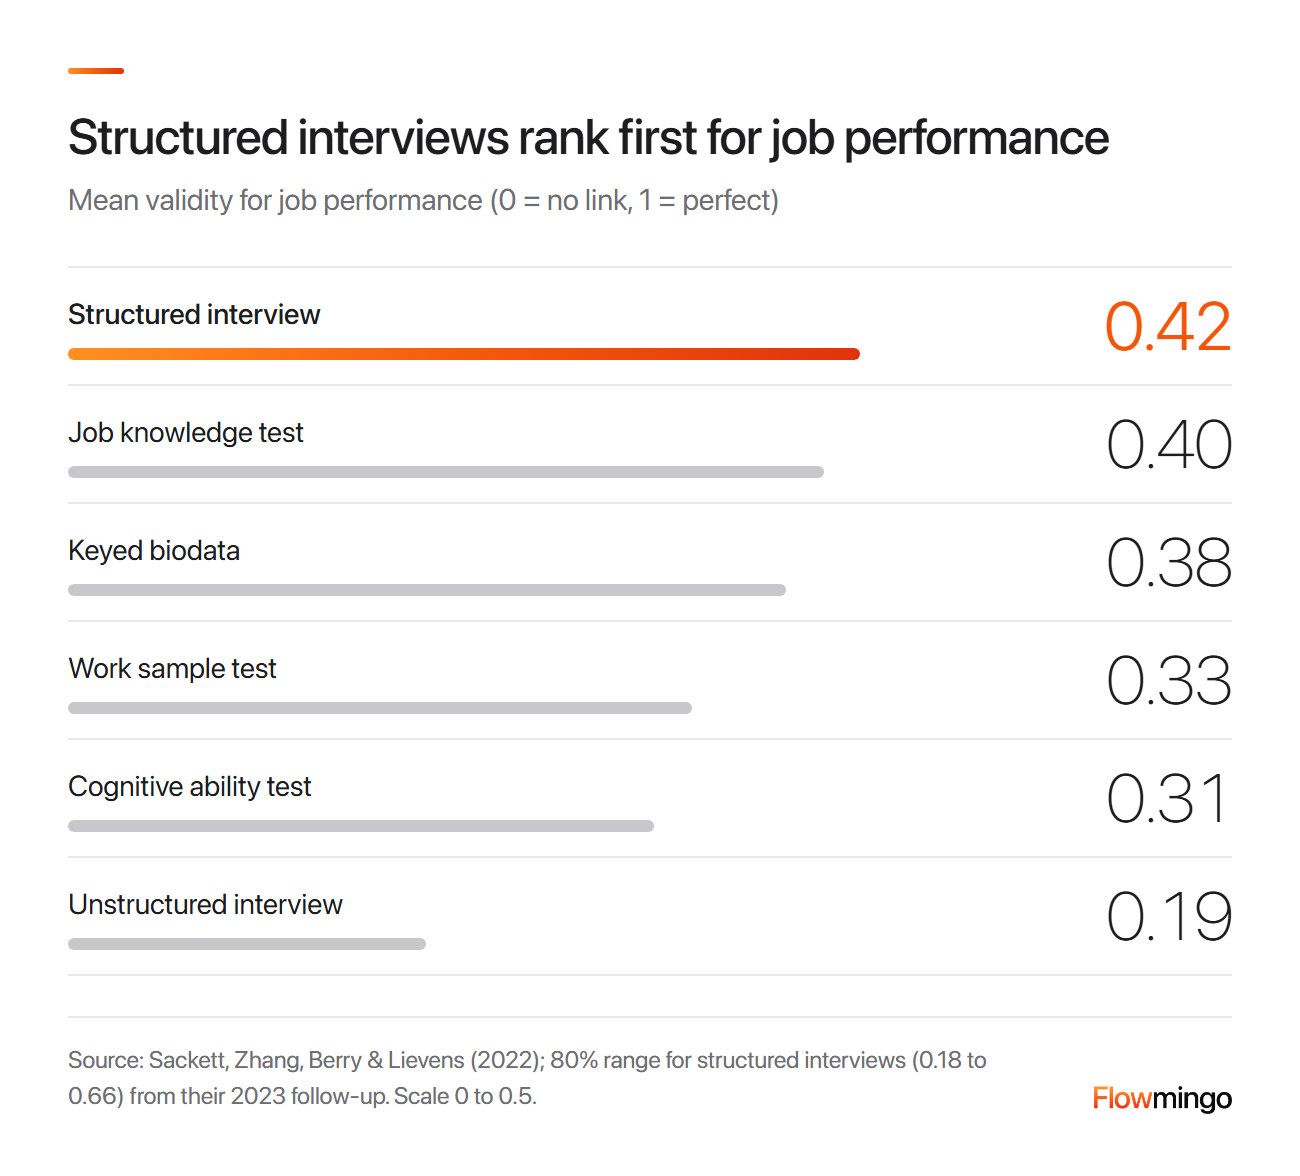
أساليب التوظيف مرتبة حسب ارتباطها بالأداء الوظيفي: المقابلات المنظمة تتصدر عند 0.42، بينما تأتي المقابلات غير المنظمة في المؤخرة عند 0.19 (إعادة التحليل التأسيسية لساكيت وزملائه).
لكن 0.42 هو متوسط. المتابعة اللاحقة للمؤلفين تضع معظم المقابلات المنظمة بين 0.18، وهو ليس أفضل من محادثة حرة، و0.66، وهو أفضل من أي أسلوب في الرسم البياني.
التصميم هو 1 من 3 أسباب يذكرها المؤلفون لهذا التباين. هذا يعني أن بطاقة تقييم مقابلة بمهارات غامضة تخاطر بالهبوط إلى المرتبة الأخيرة تقريبًا. هذه متوسطات عبر العديد من أصحاب العمل، وليست وعدًا بشأن تعيينك القادم.
2. ماذا يجب أن تتضمن قائمة تقييم المقابلة الخاصة بي؟
تتضمن قائمة تقييم المقابلة، أو نموذج تقييم المرشح، 5 مهارات ومعايير مكتوبة وحقل أدلة وحدًّا أدنى أساسيًا، كل ذلك في صفحة واحدة. وتنتهي بانطباع عام وتوصية.
المعايير تجعل درجة 4 التي يمنحها أحد المقابِلين تعني الشيء نفسه الذي تعنيه عند مقابِل آخر، وحقل الأدلة يجيب عن «لماذا» عندما يسأل الرئيس التنفيذي.
الحد الأدنى يمنع مجموعًا مرتفعًا من إخفاء متطلب أساسي ضعيف. الانطباع العام يُسجَّل أخيرًا، لأن الشعور البديهي الذي يُكتب أولًا يلوّن كل درجة مهارة بعده.
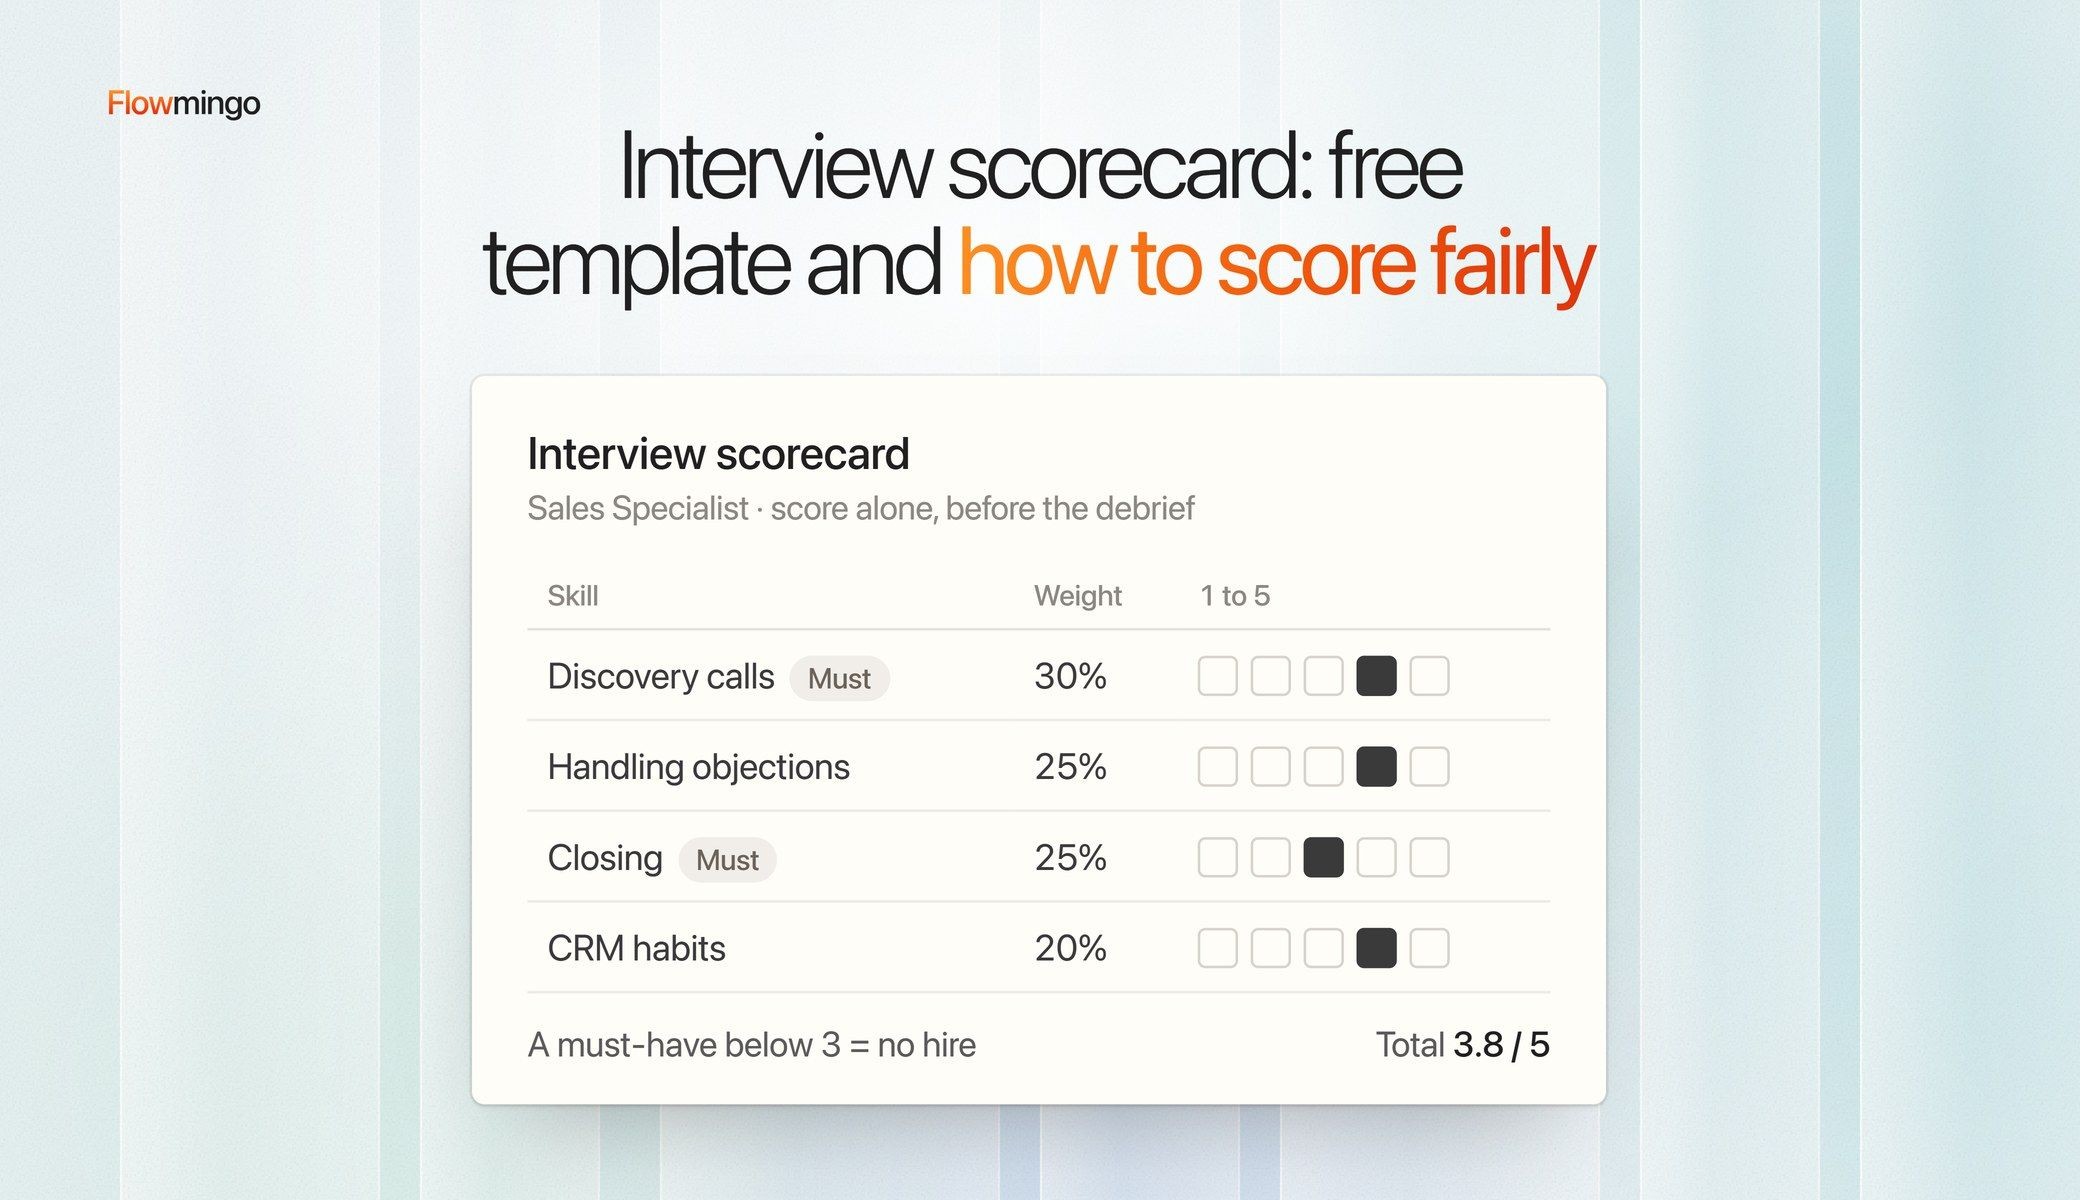
إليك هذا النموذج لقائد دعم العملاء، مع متطلبين أساسيين. كل مهارة من المهارات الخمس تُسجَّل من 1 إلى 5، لذا يكون المجموع من 25.
اطرح سؤالين عن السلوك السابق لكل مهارة، لأن مثالًا حقيقيًا من الماضي يمنحك شيئًا ملموسًا تقيسه على المراسي. على سبيل المثال: «أخبرني عن آخر مرة صعّد فيها عميل منزعج الأمر إليك».
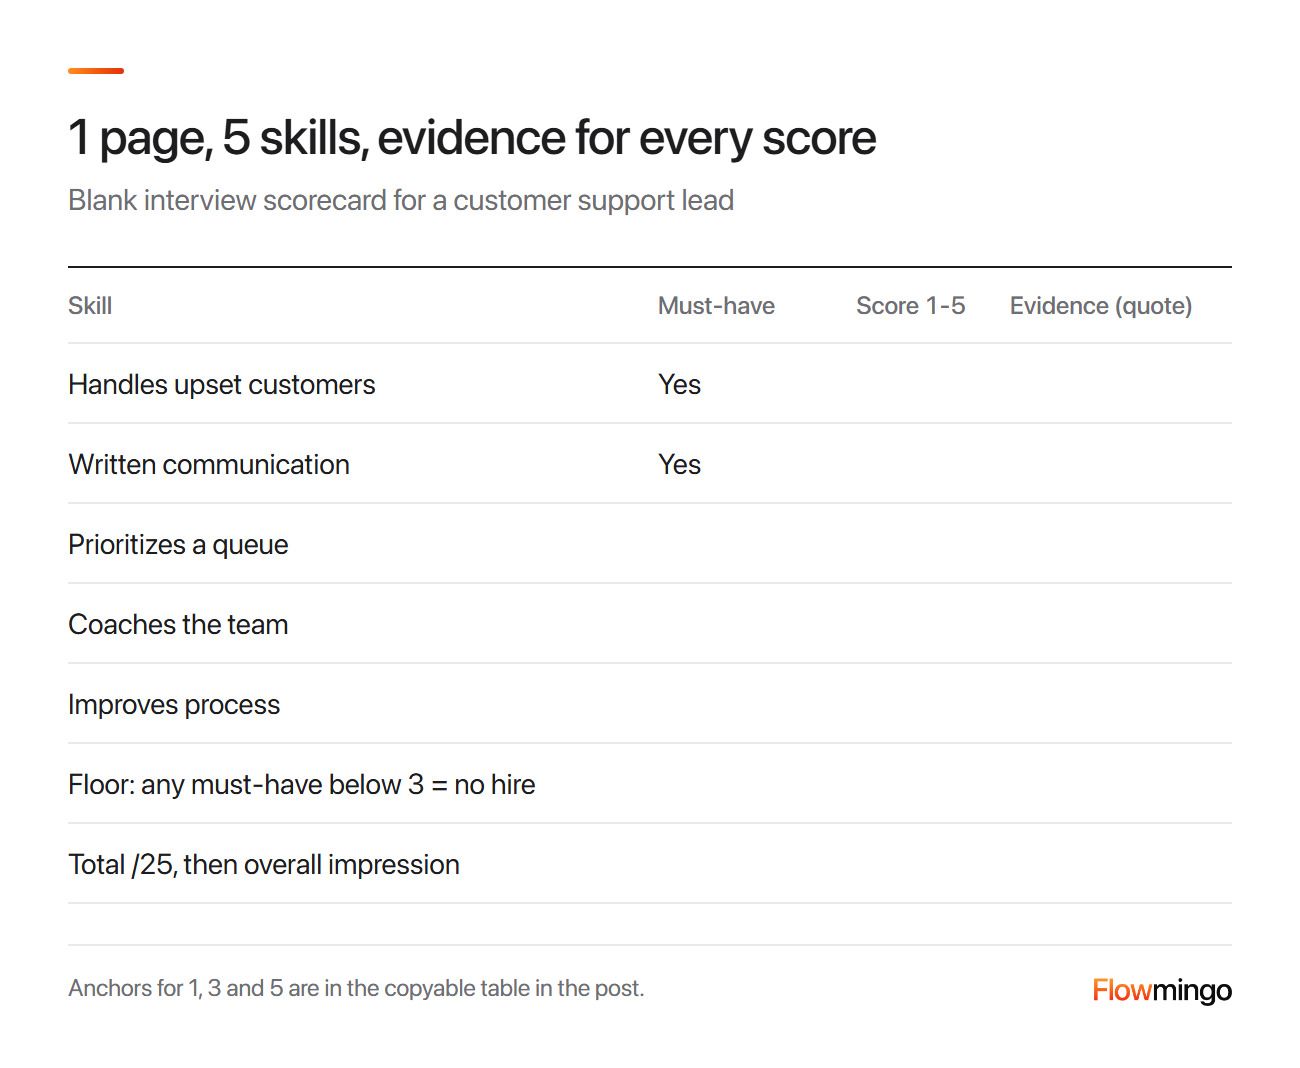
قالب بطاقة تقييم مقابلة فارغ لقائد دعم العملاء: 5 مهارات، ومتطلبان أساسيان، ودرجة من 1 إلى 5، واقتباس دليل لكل مهارة.
انسخ الجدول، ثم ضع مهاراتك ومراسيك الخاصة.
| المهارة | المراسي للدرجات 1 / 3 / 5 | الدرجة 1-5 | الدليل (اقتباس) |
|---|---|---|---|
| الترويسة | المرشح، الدور، المقابل، التاريخ | ||
| التعامل مع العملاء الغاضبين (متطلب أساسي) | يلوم العميل / يطبق السياسة / يعالج السبب | ||
| التواصل الكتابي (متطلب أساسي) | غير واضح / واضح لكن طويل / قصير وواضح | ||
| ترتيب أولويات قائمة الانتظار | لا توجد طريقة / حسب الاستعجال / حسب الأثر | ||
| تدريب الفريق | لا يوجد مثال / يقدم نصائح / يضع خطة | ||
| تحسين العملية | لا يوجد مثال / يقترح إصلاحًا / ينفذ إصلاحًا | ||
| الحد الأدنى للمتطلبات الأساسية | أي متطلب أساسي أقل من 3 يعني عدم التوظيف | ||
| غير مُقيَّم | المشاعر المُستنتجة من الوجه أو الصوت أو الكتابة؛ اللهجة أو الإيقاع ما لم تكن الوظيفة تتطلبها؛ «ملاءمة الثقافة» | ||
| المجموع | مجموع الدرجات الخمس، من 25 | ||
| الانطباع العام | من 1 إلى 5، يُملأ أخيرًا | ||
| التوصية | توظيف قوي / توظيف / عدم توظيف / عدم توظيف قوي؛ أي تجاوز يتطلب سببًا مكتوبًا |
ما الذي يجب أن أقرره قبل بنائه؟
عرّف النجاح في الدور أولًا، ثم اختر المهارات التي تحققه. ثبّت بطاقة تقييم المقابلة قبل وصول أول سيرة ذاتية.
هذا الترتيب مأخوذ من Who، من تأليف جيف سمارت وراندي ستريت. اكتب سطرًا واحدًا للمهمة، ثم من 3 إلى 8 نتائج مرتبة حسب الأهمية، ثم من 4 إلى 6 مهارات. النتيجة هي حصيلة قابلة للقياس، مثل نمو الإيرادات من 25 مليون دولار إلى 50 مليون دولار بحلول السنة الثالثة، وليست نشاطًا.
التثبيت مهم لأن الناس يلوون المعايير دون أن يلاحظوا ذلك. في الدراسات الأساسية التي أجراها أولمان وكوهين (2005)، قيّم المشاركون مرشحًا بخبرة الشارع وآخر متعلمًا تعليمًا عاليًا لمنصب رئيس الشرطة.
أيًا كانت الميزة التي يمتلكها الرجل، فقد قرروا أن الوظيفة تحتاج إليها أكثر، ولم تحصل المرأة على أي دفعة مماثلة. الالتزام بالمعايير قبل رؤية المرشحين أزال ذلك التحيز. لذلك فإن بطاقة التقييم التي تُكتب بعد مقابلة المرشحين يمكن أن تنحاز بهدوء نحو الشخص الذي يروق لك بالفعل.
2.2 هل يجب أن يكون التوافق الثقافي على بطاقة التقييم؟
ليس كما هو مكتوب، لأنه لا يمكن لأحد أن يقيّمه بالطريقة نفسها مرتين. حوّله إلى سلوك واحد أو سلوكين قابلين للملاحظة، مثل «يطلب التغذية الراجعة حول عمله الخاص».
لنفترض أن فريقك يقدّر الصراحة: قيّم بدلاً من ذلك «قدّم مثالاً محدداً على الإشارة المبكرة إلى خطأ ما».
3. كيف أوزّن درجات المقابلات بحيث تحظى المتطلبات الأساسية بالوزن الأكبر؟
امنح كل مهارة وزناً متساوياً وأضف حداً أدنى للمتطلبات الأساسية، أو حدّد الأوزان قبل المقابلة الأولى. فالأوزان المتساوية غالباً ما تتنبأ بالحالات الجديدة بنفس كفاءة الأوزان الملائمة للبيانات السابقة.
تأتي هذه النقطة الثانية من عالم النفس روبين داوز، كما يلخصها كانيمان في التفكير السريع والبطيء.
كما أن الأوزان المضبوطة وفق موظفيك السابقين تتعلّم أيضاً مصادفات تلك المجموعة. لنقل إن أفضل 3 موظفين لديك في الدعم كانوا جميعاً مدربين أقوياء بالصدفة: فإن الوزن المضبوط سيفضّل التدريب في كل مرشح مستقبلي.
لا يمكن للأوزان المتساوية أن تتبع مصادفة من هذا القبيل، ولهذا السبب غالباً ما تتنبأ بالمرشحين الجدد بنفس الجودة. أبقِ المهارات مستقلة أيضاً، كما ينصح كانيمان: لا تذكر «التواصل» و«مهارات العرض» معاً، لأنهما معاً يحسبان الشيء نفسه مرتين.
الشرط الإلزامي يستمد قوته من الحد الأدنى، لا من وزن أكبر. لنقل إن «يتعامل مع العملاء الغاضبين» يحصل على 2 وكل مهارة أخرى تحصل على 5.
يبدو مجموع 22 من 25 رائعاً، ومع ذلك لا يزال الحد الأدنى يقول: لا توظيف. وهذا ما تريده لمهارة لا يمكن للوظيفة الاستغناء عنها.
إذا قمت بتوزين الأوزان، فاكتبها في بطاقة تقييم المقابلة مسبقاً وطبقها على الجميع. وهذا يغلق أسهل طريقة للتلاعب بالمجموع: تغيير الأوزان بعد مقابلة شخص يعجبك.
كيف يساعدك Flowmingo
يستخدم تقرير مقابلات Flowmingo الذي يعمل بالذكاء الاصطناعي أوزاناً ثابتة: معيار «متطلب أساسي» يُحتسب 4 مرات مقابل معيار «مستحسن» في الدرجة الإجمالية. يحتفظ كل معيار بدرجته الخاصة من 0 إلى 10، لذا يمكنك أن تطبق الحد الأدنى للمتطلبات الأساسية بنفسك.
4. كيف أجعل الدرجة 3 تعني الشيء نفسه لدى كل مقابِل؟
اكتب ما تحتويه إجابة كل من الدرجة 1 و3 و5 لكل مهارة، قبل المقابلة الأولى. مقياس التقييم المرتبط بالسلوك هذا يجعل درجات مُقيّمَين قابلتين للمقارنة.
"المرتبط بالسلوك" يعني فقط أن كل درجة ترتبط بما فعله المرشح، وليس بشعور مثل "جيد جدًا". بدون مراسٍ، تعني الدرجة 3 في نفس بطاقة تقييم المقابلة "جيد" لدى مُقيّم و"ضعيف" لدى آخر.
أظهرت المراجعة التأسيسية التي أجراها تايلور وسول لـ 19 دراسةً عن مقابلات السلوك الماضي وجود ارتباط بقيمة .35 مع المقاييس المرتبطة بالسلوك، مقابل .26 بدونها. وقد اختلفت الدراسات أيضًا في جوانب أخرى، لذلك لا تعزل هذه المقارنة تأثير إضافة المراسي.
إليك مقياس تقييم المقابلة للمهارة الأساسية "التعامل مع العملاء الغاضبين".
| الدرجة | ما تحتويه الإجابة |
|---|---|
| 1 | يلوم العميل؛ لا يتخذ أي إجراء بنفسه ولا توجد نتيجة |
| 3 | مثال واقعي: يهدئ العميل ويطبق السياسة، لكنه لا يتحقق من النتيجة أبدًا |
| 5 | مثال واقعي: يجد السبب، ويصلحه، ويتابع، ويشارك الإصلاح |
كل درجة أعلى هي شيء يمكنك سماعه في الإجابة. لهذا السبب يمكن لمستمعَين الوصول إلى الرقم نفسه.
إذا لم تتمكن بعد من كتابة المراسي، فاستعير المستويات الخمسة في دليل المقابلة المنظمة من OPM، وكالة الموارد البشرية الفيدرالية الأمريكية. يعتمد كل مستوى على مدى صعوبة الموقف ومقدار الإرشاد الذي احتاجه الشخص.
- 1، الوعي: أبسط المواقف، مع إرشاد وثيق ومكثف.
- 2، الأساسي: مواقف صعبة إلى حد ما، مع إرشاد متكرر.
- 3، المتوسط: مواقف صعبة، مع إرشاد عرضي.
- 4، المتقدم: مواقف صعبة إلى حد كبير، مع إرشاد قليل أو معدوم.
- 5، الخبير: مواقف صعبة استثنائيًا، حيث ينصح الشخص الآخرين.
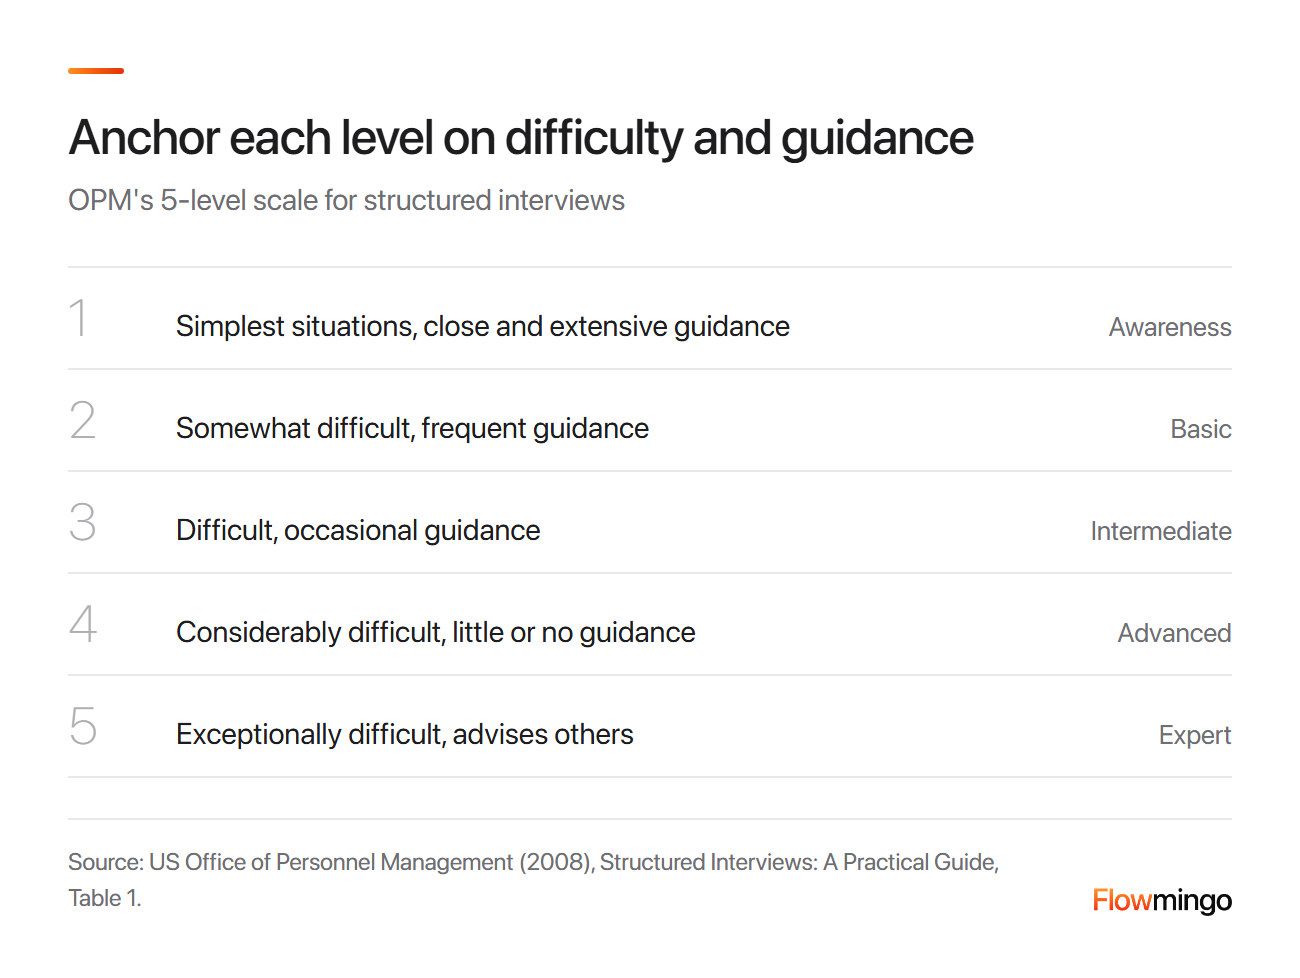
مستويات OPM الخمسة للتقييم في المقابلات المنظمة: من الوعي (أبسط المواقف، إرشاد وثيق) إلى الخبير (مواقف صعبة استثنائيًا، ينصح الآخرين).
5. كيف أختار بين 2 من المرشحين النهائيين الأقوياء عندما يختلف المقابِلون؟
دع إجمالي بطاقة تقييم المقابلة يقرر، مع استثناءين: مهارة أساسية أقل من 3، أو انقسام 2 مقابل 5، فتناقشون الأدلة. لا تعيدوا التصويت بناءً على الشعور.
هذه هي اللحظة التي وُجدت من أجلها بطاقات التقييم، وهي اللحظة التي يكون فيها إهمالها أكثر إغراءً. إليك مثال توضيحي، وليس بيانات عملاء: 3 مرشحين نهائيين لدور قائد دعم، وكل خلية هي متوسط تقييمات 3 مقابِلين.
| المهارة | A | B | C |
|---|---|---|---|
| يتعامل مع العملاء الغاضبين (شرط أساسي) | 4 | 2 | 4 |
| التواصل الكتابي (شرط أساسي) | 4 | 4 | 3 |
| ترتيب أولويات قائمة الانتظار | 3 | 4 | 3 |
| يدرّب الفريق | 3 | 4 | 4 (الدرجات: 2، 5، 5) |
| يحسّن العمليات | 4 | 4 | 3 |
| الإجمالي، من 25 | 18 | 18 | 17 |
| القرار | توظيف | لا توظيف: يُفعَّل الحد الأدنى | مناقشة الانقسام |
اقرأ بطاقة تقييم المقابلة صفًا صفًا. يتعادل A وB عند 18 من 25. لكن B حصل على 2 في مهارة أساسية، لذا يُفعَّل الحد الأدنى ويصبح B غير مقبول للتوظيف.
مجموع C هو 17، لكن متوسط C البالغ 4 في "يدرّب الفريق" يخفي انقسامًا: مقابِل واحد أعطى 2، والمقابِلان الآخران أعطيا 5. تصبح هذه الفجوة البند الوحيد في جدول أعمال النقاش.
عمليًا، اطلب من كل طرف أن يقرأ اقتباسات الأدلة التي بحوزته. لنفترض أن مُقيم الدرجة المنخفضة سمع عن عضو فريق استقال، بينما سمع الآخرون عن خطة تدريب نجحت. يقرر النقاش أي القصتين أكثر تمثيلًا لـ C، ومن فاته دليل يعدّل درجته كتابيًا.
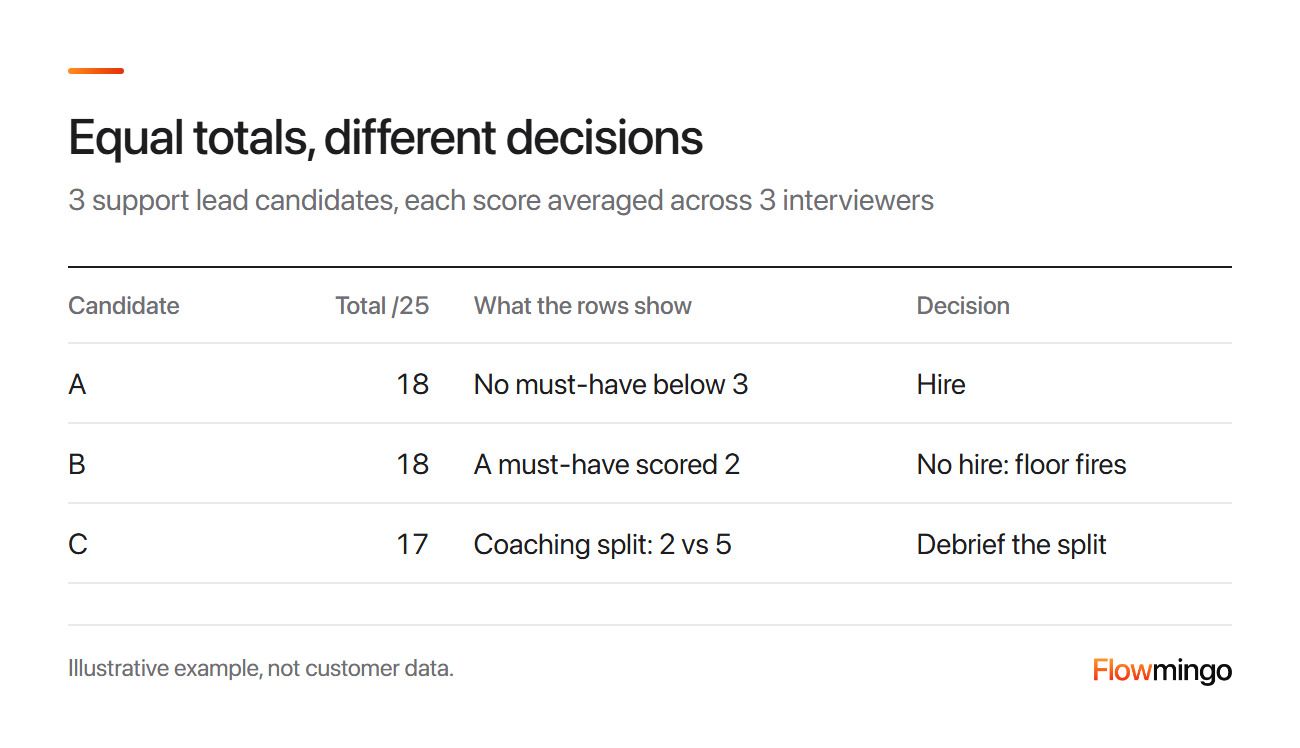
بطاقة تقييم مقابلة مُعبأة، مثال توضيحي: A وB متعادلان عند 18 من 25، وB يفوته شرط أساسي، وC لديه انقسام في تدريب الفريق يجب مناقشته.
بمجرد أن تختار الدرجات مرشحًا نهائيًا، اكتب الشروط في العرض قبل إرساله: قالب خطاب عرض العمل يوضح أين يُدرَج كل بند من هذه الشروط.
5.1 ماذا لو كان حدسي يقول شيئًا والدرجات تقول شيئًا آخر؟
اتبع الدرجات إلا إذا كنت تستطيع كتابة الأدلة التي فاتتها. في التحليل البعدي التأسيسي الذي أجراه كونسل وزملاؤه عام 2013، توقّع معادلة طُبّقت بالطريقة نفسها على الجميع الأداء الوظيفي بمقدار 0.44، مقابل 0.28 للحكم الكلي. يصف المؤلفون ذلك بأنه تحسّن في التنبؤ يتجاوز 50%، حتى مقارنةً بخبراء عرفوا الوظيفة.
الحكم الكلي يعني أن الأشخاص يزنون الحقائق نفسها في أذهانهم، بما في ذلك اجتماعات الإجماع. لذا يملأ النقاش فجوات الأدلة، ولا يعيد التصويت.
5.2 هل ينبغي أن أقارن المرشحين النهائيين جنبًا إلى جنب؟
نعم، إجابة بإجابة. نصيحة بونيت في نصيحة HBR هي مقارنة جميع الإجابات على السؤال الأول، ثم السؤال الثاني، بحيث تحكم على كل إجابة مقارنةً بالآخرين.
في دراسة معملية أساسية عام 2016، مال الأشخاص الذين شاهدوا مرشحًا واحدًا في كل مرة نحو الجنس الذي يفضّله القالب النمطي للمهمة. الأداء السابق لم يكن له أهمية تذكر. وعند عرض اثنين جنبًا إلى جنب، اختاروا الأعلى أداءً في 54% من الحالات والأدنى في 8%.
استخدمت الدراسة درجات المهام السابقة، وليس المقابلات، لذا تعامل معها كإشارة قوية وليس كدليل قاطع.
6. كيف أوقف المقابِل الأكثر صخبًا من السيطرة على جلسة الاستخلاص؟
اطلب من كل مقابِل تسليم بطاقة تقييم المقابلة الخاصة به قبل أن يتحدث أي شخص، ثم افتتح جلسة الاستخلاص بالدرجات.
لنفترض أن شخصًا كبيرًا يفتتح النقاش بعبارة «لقد أعجبت بها»، ويبدأ الجميع بالميل نحو هذا الرأي. الدرجات التي تُكتب بشكل مستقل تحمي الجميع من هذا التأثير، ولهذا جعل كتاب Noise التقييم المستقل قاعدةً في التوظيف.
عمليًا، اجمع الدرجات في جدول مشترك أو في نظام تتبّع المتقدمين (ATS)، واكشف عنها جميعًا في وقت واحد.
قد تبدو المقابلة الجماعية، حيث يشاهد الجميع المقابلة نفسها، وكأنها الحل. في التحليل التلوي الأساسي الذي أجراه هافكوت وزملاؤه عام 2013، بلغ اتفاق المقيّمين في المقابلات الجماعية 0.74 مقابل 0.44 للمقابلات المنفصلة، على مقياس من 0 إلى 1.
هذا الرقم يجعل المقابلات الجماعية تبدو أفضل مما هي عليه. إذ يقيّم جميع أعضاء اللجنة الأداء نفسه في اليوم نفسه، لذا إذا كان أداء المرشح جيدًا أو سيئًا بشكل غير معتاد في ذلك اليوم، يراه الجميع.
كما قالت إيريس بونيت في محاضرة في جوجل: «حجم العينة في المقابلة الجماعية هو واحد في الأساس». أما المقابلات المنفصلة، التي تُقيَّم كلٌّ منها على حدة، فتمنحك نظرات أكثر استقلالية.
6.1 كم عدد المقابِلين الذين ينبغي أن يقيّموا كل مرشح؟
حتى 4 مقابلات منفصلة. في البيانات الداخلية لجوجل، وهي ليست دراسة محكّمة، توقّعت 4 مقابلات قرار التوظيف بثقة 86%. كل مقابلة إضافية أضافت أقل من 1%.
المقابلات الإضافية أضافت القليل إلى التنبؤ بقرار التوظيف لدى جوجل نفسها. استخدم ذلك كحافز لتبرير كل جولة، وليس كحدّ أقصى عام أو دليل على الأداء الوظيفي اللاحق.
7. كيف أجعل المقابلين المشغولين يملؤون بطاقة تقييم المقابلة فعليًا؟
اجعل التقييم جزءًا من المقابلة. قيّم كل مهارة مباشرة بعد أسئلتها، واكتب اقتباسًا من سطر واحد كدليل، واعطِ الانطباع العام أخيرًا.
لا أحد يريد نموذجًا آخر بعد يوم من المقابلات. لهذا السبب يتم التقييم داخل المقابلة، وليس كواجب منزلي لليلة.
طوّر كانيمان هذه الطريقة للجيش الإسرائيلي في عام 1955، بعد أن أثبتت المقابلات الحرة أنها شبه عديمة الفائدة في التنبؤ بالنجاح. قيّم المقابلون 6 سمات على مقياس من 1 إلى 5، وأنهوا كل سمة قبل الشروع في التالية، حتى لا يلوّن الانطباع الأول بقية التقييم.
عندها فقط أغمضوا أعينهم وأعطوا تقييمًا عامًا، وتنبأ المجموع بدقة أكبر بكثير من السابق. نصيحته: عيّن صاحب أعلى مجموع، "حتى لو كان هناك شخص آخر تحبه أكثر".
التوقيت مهم أيضًا. في دراسة ميدانية، أبلغ 166 مقابلاً عن الوقت الذي حسمت فيه قراراتهم. جاءت 4.9% فقط من القرارات في الدقيقة الأولى، بينما جاءت 22.5% بعد انتهاء المقابلة.
القرار الذي يُتخذ بعد مغادرة المرشح يعتمد على الذاكرة، لذا قيّم أثناء المقابلة.
بالنسبة لقائد فريق الدعم لدينا، يبدو ذلك كما يلي:
- اطرح سؤالي قائمة الانتظار، ثم قيّم "تحديد أولويات قائمة الانتظار" قبل الانتقال إلى ما يلي.
- اكتب اقتباسًا واحدًا كدليل، مثل "أفرز الأخطاء البرمجية حسب عدد العملاء المتأثرين بها."
- حافظ على ترتيب المهارات نفسه لكل مرشح.
الأدلة المكتوبة نادرة في بياناتنا.
بيانات Flowmingo · 86,638 مرشحًا خاضوا مقابلات AI · 2,574 شركة · يوليو 2025 إلى سبتمبر 2026
- 0.3% من المرشحين الذين خاضوا مقابلات AI حصلوا على تعليق مكتوب من فريق التوظيف (258 من 86,638).
قد تحتفظ الفرق بملاحظاتها في مكان آخر؛ داخل Flowmingo، يكون تقرير AI عادةً التقييم المكتوب الوحيد في الملف.
السبب المكتوب هو أول ما يُحذف في يوم مزدحم. لهذا يطلب النموذج اقتباسًا واحدًا فقط لكل مهارة.
8. هل يمكنني الوثوق بدرجة الذكاء الاصطناعي في بطاقة تقييم المقابلة؟
استخدمها كمدخل واحد يراجعه شخص، واقرأ أسبابها أولًا. يمكن أن ينخفض تقييم الذكاء الاصطناعي بشكل حاد على الأسئلة التي لم يُدرَّب عليها.
لنا مصلحة في هذه الإجابة، لذا يتضمن الدليل أدناه الجزء الذي لا يخدم الذكاء الاصطناعي.
في دراسة أساسية لعام 2023 study، قيّم مُقيِّمان مدرَّبان 7,017 إجابة من المتقدمين على مقياس مثبّت من 1 إلى 5. طابق نموذج مدرَّب على الأسئلة نفسها درجاتهما عن قرب، عند 0.75 على مقياس من 0 إلى 1. أما على صيغ أسئلة لم يرها من قبل، فانخفض إلى 0.30، وهي مطابقة ضعيفة.
هذا يعني أن درجة الذكاء الاصطناعي لا تكون جيدة إلا بقدر معيار التقييم الخاص بكل سؤال، لذا اقرأ أسبابها قبل أن تثق بالرقم. لاحظ أيضًا أن 3 من مؤلفي تلك الدراسة الخمسة عملوا في شركة Modern Hire، المورّدة لمقابلات الذكاء الاصطناعي.
كيف يساعدك Flowmingo
مقابلة Flowmingo بالذكاء الاصطناعي تُقيّم وفق معايير توافق عليها. يصوغ الذكاء الاصطناعي الأسئلة والمعايير من وصف الوظيفة، ويمكنك تعديل الاثنين. ترسل لكل متقدم المقابلة لإجرائها في وقته الخاص.
تستلم التسجيل والنص الحرفي وكل معيار مُقيَّمًا من 0 إلى 10 مع تبرير مكتوب. أنت من يتخذ قرار التوظيف.
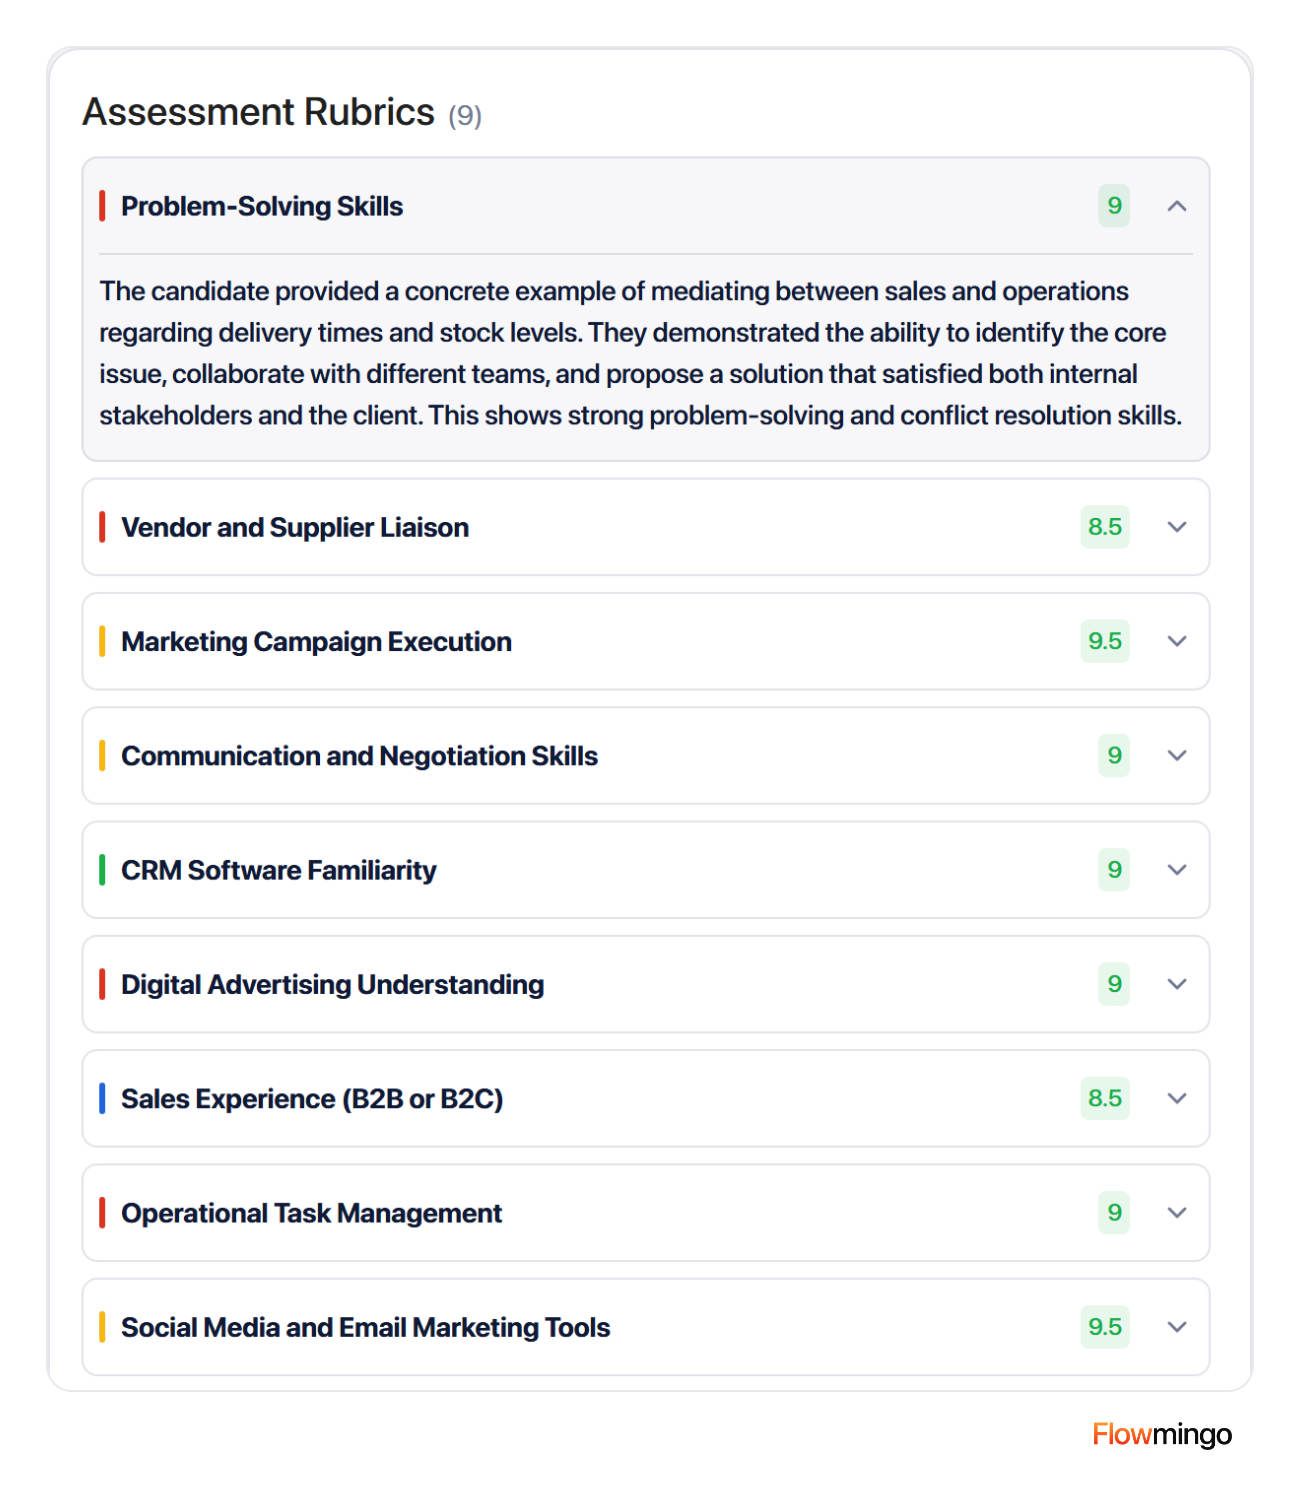
تقرير Flowmingo العام النموذجي: درجة من 0 إلى 10 وسبب لكل معيار، لذا حدّد أي حد أدنى إلزامي على هذا المقياس.
في بياناتنا، تختلف السيرة الذاتية والمقابلة أيضًا حول من هو الأفضل.
بيانات Flowmingo · 34,114 مرشحًا · 379 شركة · من يوليو 2025 إلى سبتمبر 2026
- 19.2% من 532 مشروعًا كانت فيها درجة مقابلة عليا واضحة لمرشح واحد، أعطت ذلك المرشح أيضًا أعلى درجة في السيرة الذاتية.
- 54.9% من المرشحين البالغ عددهم 3,684 الذين حصلوا على 8 أو أكثر في المقابلة (2,022) كان سيُستبعدون بقائمة السيرة الذاتية المختصرة لأفضل 20%.
كلتاهما درجتان من درجات Flowmingo بالذكاء الاصطناعي، وليستا أداءً وظيفيًا، والمقابلون مجموعة مختارة. تُظهر البيانات أن الترتيبين يختلفان، ولا تُظهر أيُّهما أصحّ.
بعبارة واضحة، في حوالي 4 من كل 5 من تلك المشاريع، لم يكن صاحب أعلى درجة في المقابلة هو صاحب أعلى درجة في السيرة الذاتية أيضًا. لذا قيّم المقابلة على حدة، بدلًا من أن تنتقل درجة السيرة الذاتية إلى تقييمها.
9. هل تحميني بطاقات التقييم إذا اشتكى مرشح مرفوض؟
إنها تساعد إذا كانت تقيّم أدلة مرتبطة بالوظيفة واحتفظت بها. وفق قراءة معقولة، تعني القواعد الفيدرالية الأمريكية الاحتفاظ ببطاقات التقييم لمدة سنة واحدة على الأقل، وقواعد كاليفورنيا 4 سنوات.
قد تصل الشكوى بعد أشهر، عندما لا يتذكر أحد المقابلة. تُظهر بطاقة تقييم المقابلة التي تتضمن اقتباسًا لكل مهارة ما قيّمته ولماذا.
لا تسمّي القاعدة الأمريكية بطاقات التقييم، لكنها تغطي «السجلات الأخرى المتعلقة بالتوظيف». بمجرد تقديم شخص شكوى تمييز، تحتفظ بكل سجل ذي صلة حتى تنتهي القضية. ويشمل ذلك سجلات المرشحين الآخرين للوظيفة نفسها، لذا فإن شكوى واحدة تجمّد المجموعة بأكملها.
هذه القواعد سارية كما هي في سبتمبر 2026. هذا ملخص، وليس نصيحة قانونية.
| القاعدة | المكان | ما يعنيه ذلك لبطاقة التقييم |
|---|---|---|
| 29 CFR 1602.14 | الولايات المتحدة | احتفظ بسجلات التوظيف لمدة سنة واحدة، وأطول بعد تقديم شكوى |
| 2 CCR 11013(c) | كاليفورنيا | احتفظ بالسجلات لمدة 4 سنوات، بما في ذلك بيانات القرار الآلي |
| إرشادات ICO | المملكة المتحدة | يمكن للمرشحين طلب ملاحظات المقابلة؛ يجب الإفصاح عن أي قاعدة لكسر التعادل |
| TAFEP | سنغافورة | استخدم نموذج تقييم واحتفظ بالسجلات لمدة سنة واحدة على الأقل |
| 29 CFR 1630.11 (ADA) | الولايات المتحدة | إذا كانت الإعاقة تؤثر على النطق، قيّم المهارة لا النطق، ما لم يكن التحدث هو ما تتطلبه الوظيفة |
| قانون الذكاء الاصطناعي، المادة 5(1)(f) | الاتحاد الأوروبي، منذ 2 فبراير 2025 | لا ذكاء اصطناعي يستنتج مشاعر المرشحين من الوجوه أو الوضعية أو ضغطات المفاتيح |
| قانون الذكاء الاصطناعي، الملحق الثالث والمادة 26 | الاتحاد الأوروبي، من 2 ديسمبر 2027 | عالية المخاطر: إشراف بشري، سجلات محفوظة 6 أشهر أو أكثر، إبلاغ المرشحين |
| القانون المحلي 144 | مدينة نيويورك | نتيجة ذكاء اصطناعي تُستخدم وحدها، أو بوزن فوق كل شيء آخر، أو لتجاوز قرارات البشر: تدقيق سنوي للتحيز وإشعار |
| قانون مقابلات الفيديو بالذكاء الاصطناعي | إلينوي | إشعار وشرح وموافقة مسبقة؛ احذف مقاطع الفيديو خلال 30 يومًا من الطلب |
لهذا السبب يحتوي القالب على صف «غير مُقيَّم». يحظر الاتحاد الأوروبي الذكاء الاصطناعي الذي يقرأ مشاعر المرشحين من الوجوه أو الوضعية أو ضغطات المفاتيح، ويحمي قانون الإعاقة الأمريكي (ADA) المرشحين الذين تؤثر إعاقتهم على النطق. في المملكة المتحدة، يمكن للمرشحين طلب ملاحظاتك، لذا اكتب كل سطر أدلة كما لو أنهم سيقرؤونه.
للتدقيق الذاتي، قارن معدلات النجاح حسب المجموعة بقاعدة 4/5 التقريبية الواردة في المبادئ التوجيهية الموحدة. لنفترض أن 30% من مجموعة واحدة نجحت و50% من أخرى: 30 مقسومة على 50 يساوي 0.6، أي أقل من 0.8، لذا افحص الأمر عن كثب.
رأي وزارة العدل الصادر في يونيو 2026 وقاعدة OPM الصادرة في يوليو 2026 يُبعدان الوكالات الفيدرالية عن المبادئ التوجيهية. لكنها ما زالت موجودة في اللوائح الفيدرالية، لذا تعامل مع هذا الفحص كعادة سهلة، لا كحد قانوني.
10. كيف أبدأ تطبيق بطاقة تقييم المقابلة مع فريقي هذا الأسبوع؟
ابنِها بهذا الترتيب، وغيّرها فقط بين الأدوار. لا تحتاج النسخة الأولى إلى أن تكون مثالية، لكن يجب أن تكون نفسها لكل مرشح.
- اكتب سطر مهمة واحدًا و3 إلى 8 نتائج مرتبة.
- حوّلها إلى 5 مهارات وحدد المتطلبات الإلزامية.
- اكتب سؤالين عن السلوك السابق ومعايير مرجعية للدرجات 1 و3 و5 لكل مهارة.
- اجعل حتى 4 من المقابلين يقيّمون وحدهم ويقدّمون نتائجهم قبل جلسة الاستخلاص.
- دع المجموع يحسم القرار، لكن أي متطلب إلزامي أقل من 3 يعني عدم التوظيف. دوّن كل تجاوز.
عمليًا، ابدأ بوظيفة شاغرة واحدة، حتى يتعلم فريقك العادة على شيء حقيقي. قبل المقابلة الأولى، اطلب من الجميع تقييم نفس الإجابة النموذجية ومقارنة النتائج.
إذا كانت درجتان تتباعدان بأكثر من نقطة واحدة، أعد كتابة المعيار المرجعي حتى تتفقا. استخدم المقيمون المدربون في دراسة القسم 8 نفس الفجوة البالغة نقطة واحدة لعقد اجتماع.
توقع بعض المقاومة. قاوم مقابلو الجيش لدى كانيمان مجرد تسجيل الإجابات أيضًا، وكان حله هو التقييم بإغلاق العينين، الذي أعطى حكمهم مكانًا في الاستمارة. سطر الانطباع العام لديك يفعل ذلك لفريقك.
كيف يساعد Flowmingo
لإرسال مقابلة منظمة إلى كل متقدم ليقوم بها في وقته الخاص، مسجلة ومقيّمة وفق بطاقة تقييم مقابلة واحدة، جرّب Flowmingo.
11. المصادر
كل رقم خارجي مذكور أعلاه مصدره المصادر أدناه، بترتيب الظهور. وأرقام Flowmingo الخاصة موجودة في مربعات البيانات، من يوليو 2025 إلى سبتمبر 2026.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.