面接官3人、最終候補者1人、判定3通り。面接スコアカードがなければ、振り返り会で最も声の大きい人の意見が採用者を決めてしまう。
立ち返るべき候補者評価フォームがない。そのため、CEOにオファーを説明することも、尋ねてくる不採用候補者に説明することも誰にもできない。
共有のフォームがなければ、忙しい人は直感に頼ってしまう。
そして直感による判断は、本人が感じるより弱い。カーネマンと共著者によるNoiseが示すとおりだ。
たとえば、ある候補者が別の候補者より面接の出来が良かった、ということだけを知っているとする。その候補者が本当に採用すべき人である確率は56%〜61%にすぎず、コイン投げとほとんど変わらない。
スコアカードはこれを3つの手順で解決する。各面接官は、振り返り会の前に、同じ4〜6個のスキルを、書かれた例と照らして単独で採点する。そして、必須条件が不合格でない限り、合計点で決める。
主なポイント
- スコアカードは本当に採用の質を高めるのか? はい、各面接官が同じスキルを書かれた例と照らして採点する場合です。この方法で行われた面接は、2022年のレビューで、自由形式の面接よりも職務成績を約2倍よく予測しました。
- 採点するスキルはいくつにすべきか? 4〜6個で、それぞれ1〜5段階、各段階には記述された回答例を付けます。必須条件が3未満なら不採用です。
- 同点の最終候補者2人のどちらを選ぶか? まず必須条件を確認し、その後、2対5に割れた評価は根拠に基づいて振り返ります。感覚で再投票しないこと。2013年のレビューでは、固定した計算式が専門家の判断を上回りました。
- 面接官は何人必要か? 最大4人で、それぞれ単独で採点します。Google自身のデータでは、4回目以降の面接は精度を1%未満しか高めませんでした。
- AIスコアは信頼できるか? 1つの入力として使い、その理由を読みます。2023年の研究では、AI評価者は、馴染みのある質問では訓練を受けた人間の評価者とよく一致しましたが、新しい質問では一致度が低かった。
1. 面接スコアカードは本当に、より良い人材を選ぶのに役立つのか?
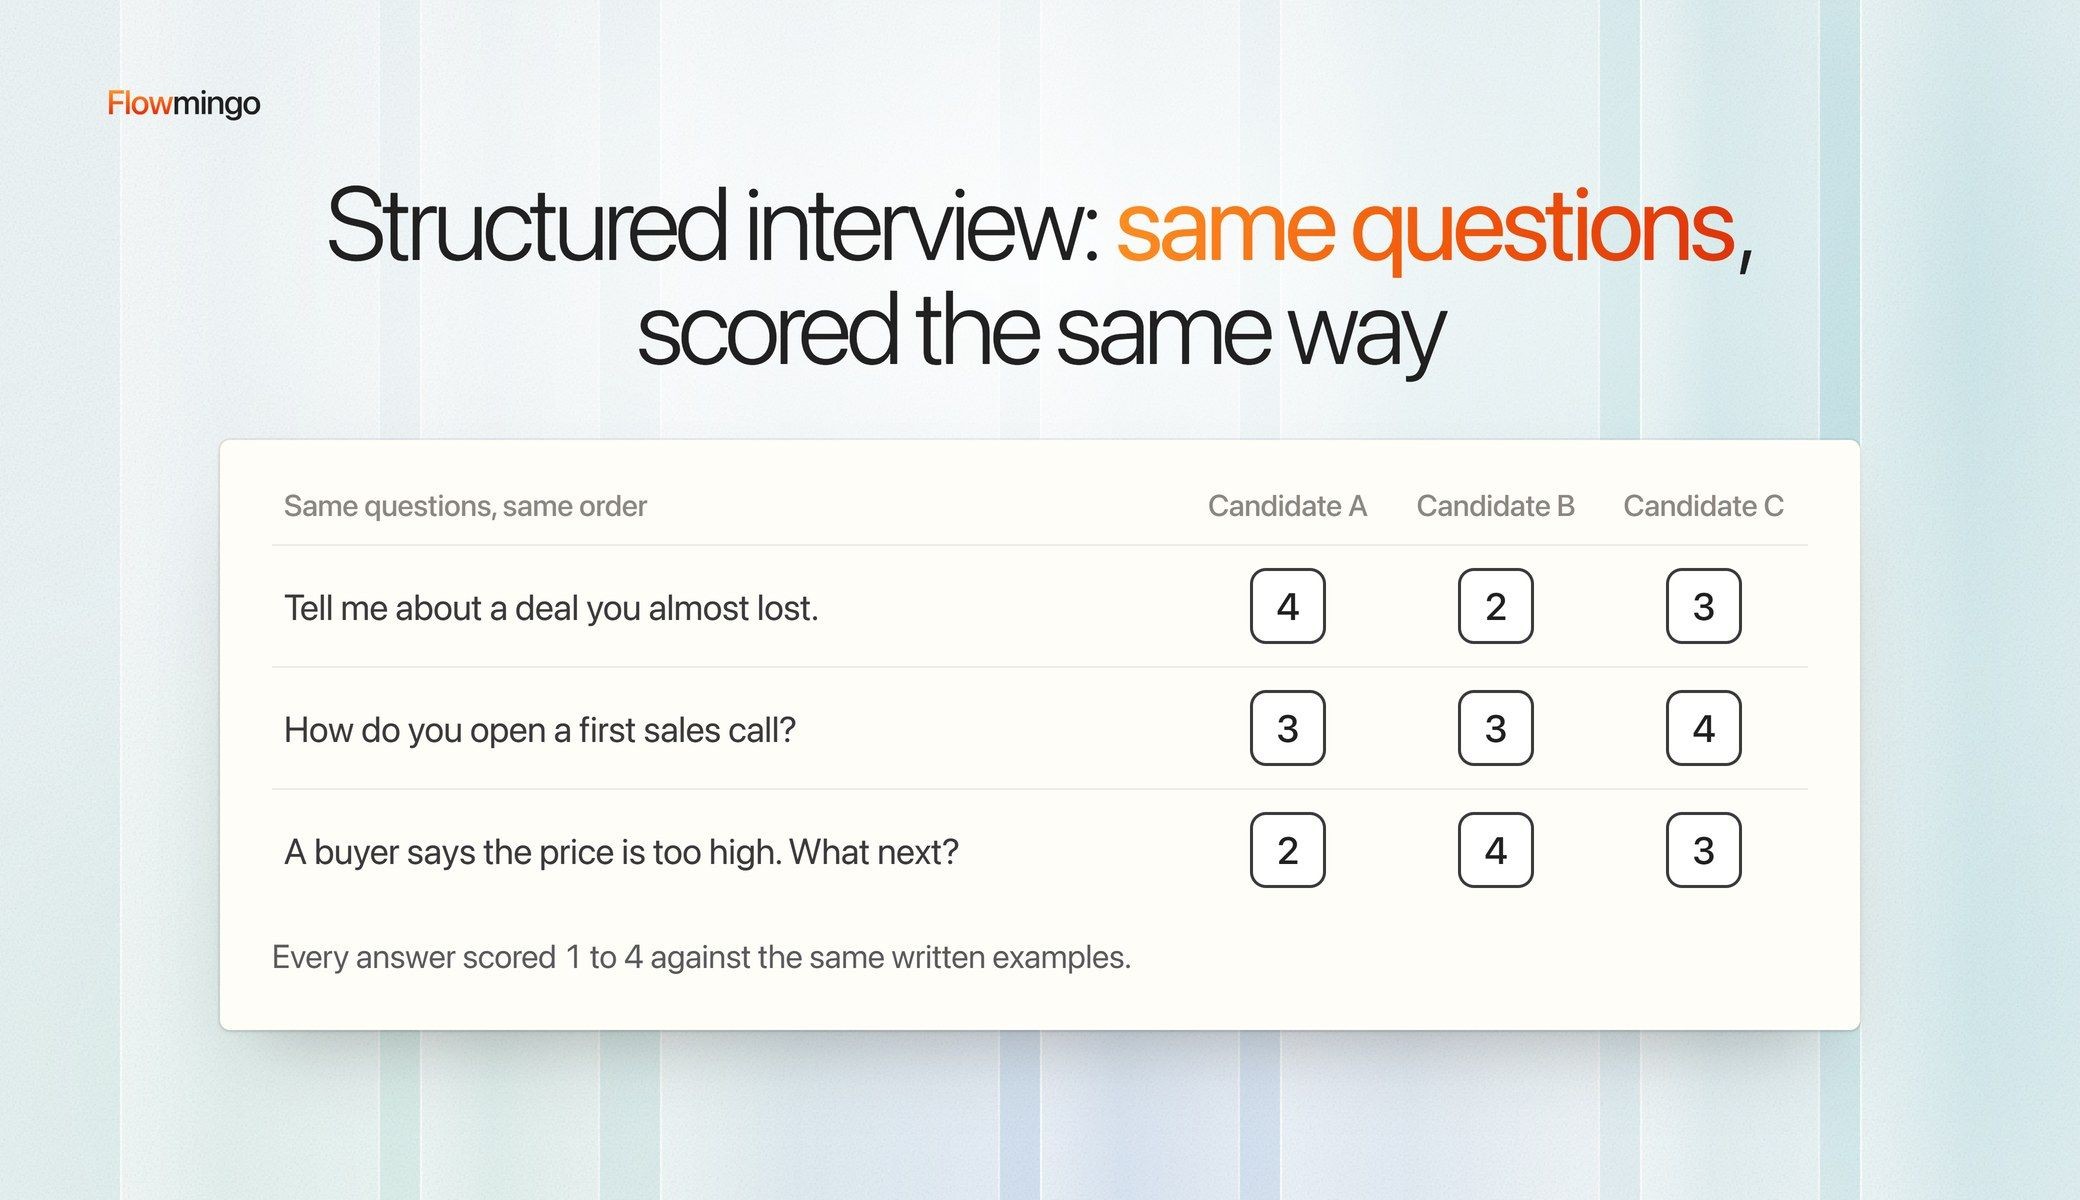
はい、すべての面接官が同じスキルを書かれた評価基準例に照らして採点する場合です。構造化面接では、全員に同じ質問をし同じ方法で評価しますが、職務パフォーマンスの予測値は0.42で、非構造化面接の0.19の2倍以上でした。
これらの数値は、数十年にわたる採用研究を対象としたSackettらによる2022年の基礎的再分析に基づくものです。
これらの数値は相関係数で、0(その後の職務パフォーマンスとの関連なし)から1(完全な関連)までの範囲です。したがって0.19は、非構造化面接が20%の確率で正しく採用できるという意味ではありません。その後のパフォーマンスとの関連が弱いという意味です。
下の図は、一般的な6つの手法を順位付けしたものです。職務知識テストが0.40、採点式の経歴質問票であるキー付きバイオデータが0.38で、僅差で続きます。
続いてワークサンプルテストが0.33、認知能力テストが0.31です。多くの人が当たり前のように行ってきた自由形式の会話である非構造化面接が最下位です。
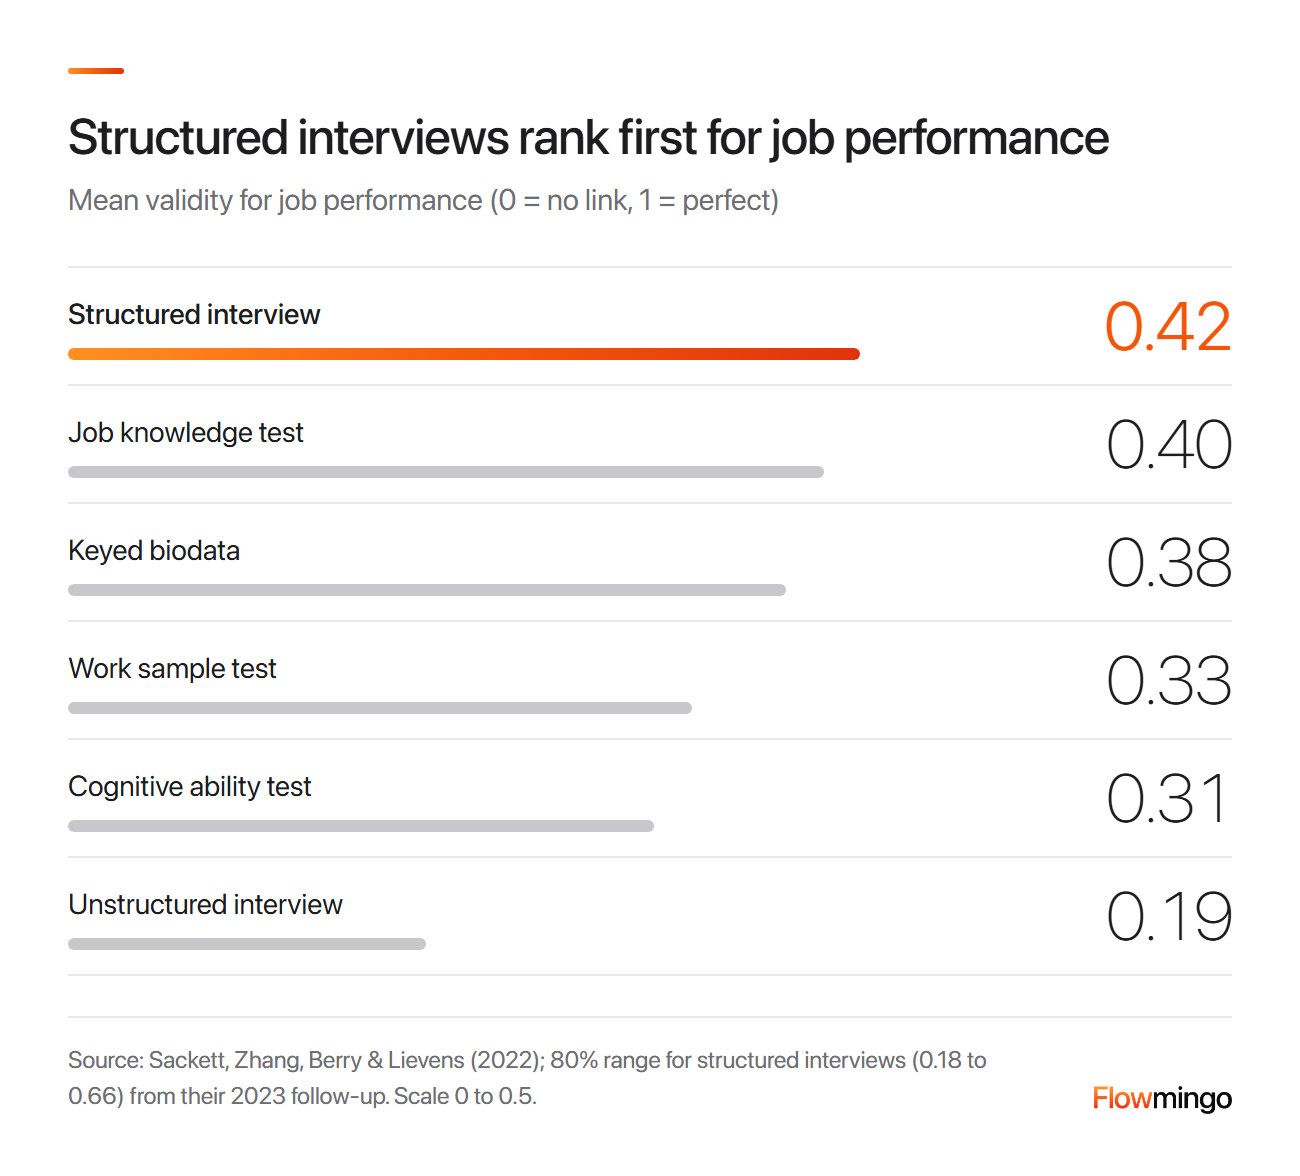
職務パフォーマンスとの関連で順位付けした採用手法:構造化面接が0.42で首位、非構造化面接が0.19で最下位(Sackettらによる基礎的再分析)。
しかし0.42は平均値です。著者らの追研究では、ほとんどの構造化面接を、0.18(自由形式の会話と変わらない)から0.66(図のどの手法よりも優れる)の間に位置づけています。
設計は、著者らがこのばらつきの理由として挙げる3つのうちの1つです。つまり、スキルが曖昧な面接スコアカードは、最下位付近に落ちるリスクがあります。これらは多くの雇用主における平均値であり、次の採用を約束するものではありません。
2. 面接スコアカードのテンプレートには何を含めるべきですか?
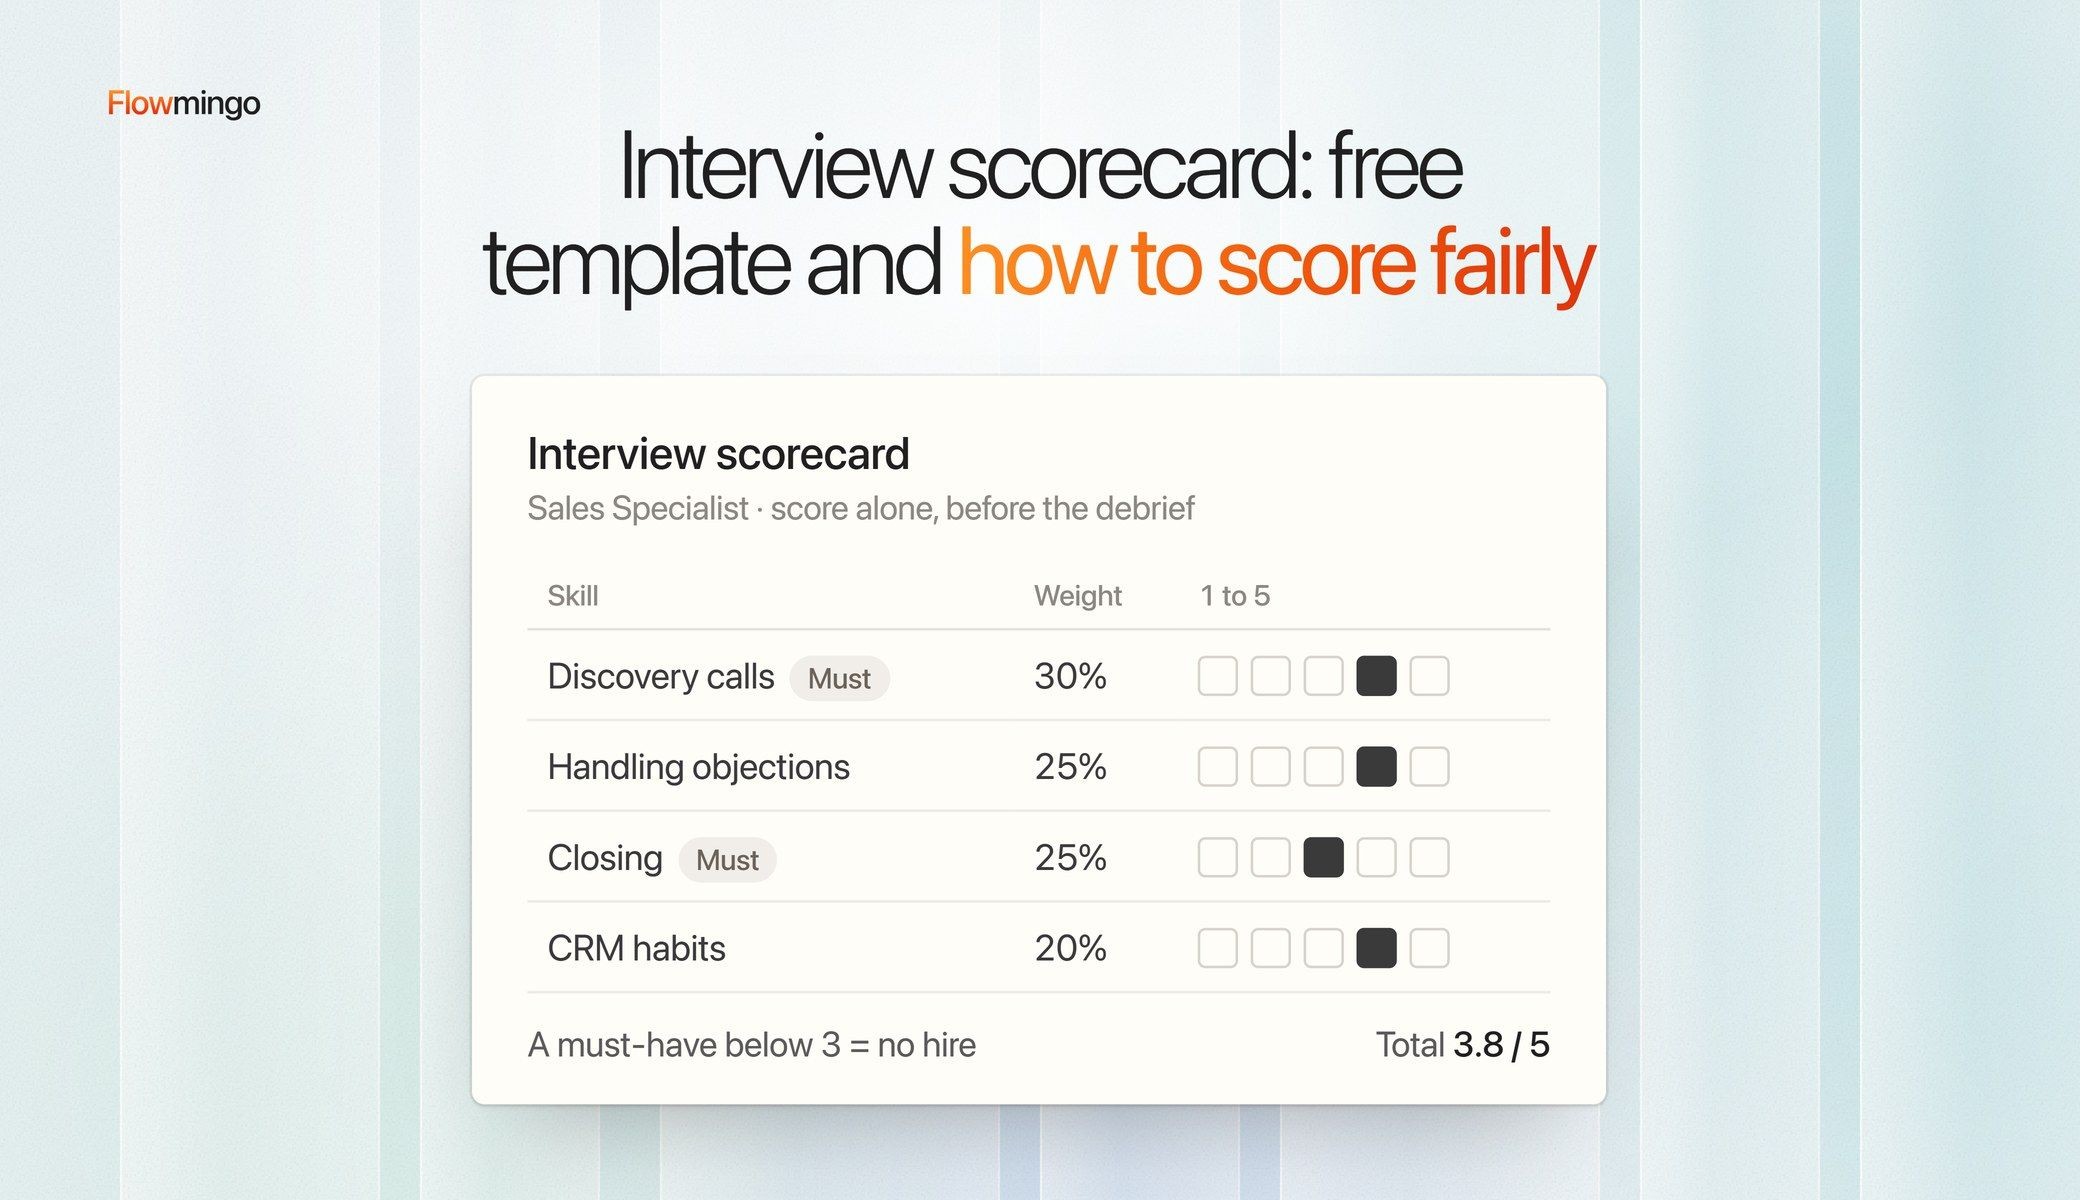
面接スコアカードのテンプレート、つまり候補者評価フォームには、5つのスキル、文章で示された評価アンカー、エビデンス欄、必須要件の最低ラインが含まれ、すべて1ページに収まります。最後に総合的な印象と推薦を記します。
アンカーによって、ある面接官の4が別の面接官の4と同じ意味になり、エビデンス欄は、CEOから「なぜ」と尋ねられたときの答えになります。
下限があることで、合計点が高くても必須項目の弱さを覆い隠すことはできません。総合印象は最後に入力します。直感を先に書いてしまうと、その後のすべてのスキル評価がそれに引きずられるからです。
顧客サポートリード向けのそのフォームがこちらです。必須項目は2つ。5つのスキルをそれぞれ1〜5で採点するので、合計は25点満点です。
スキルごとに過去の行動を問う質問を2つ用意しましょう。実際の過去の例があれば、アンカーと照らし合わせる具体的な材料になります。たとえば「怒っている顧客からエスカレーションを受けた直近の事例を教えてください」といった質問です。
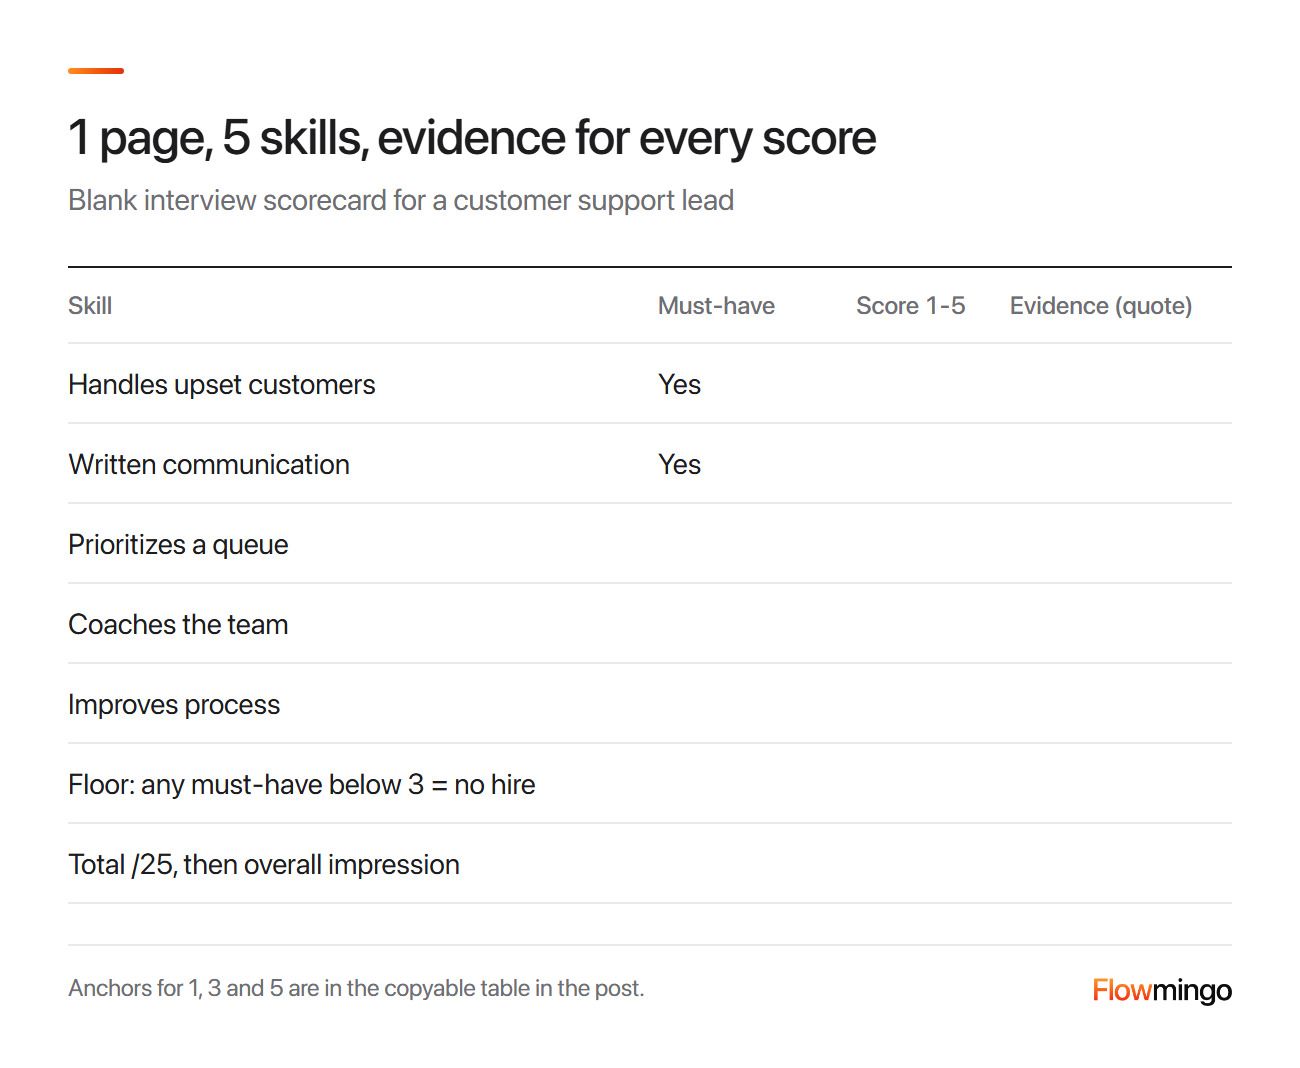
顧客サポートリード向けの空の面接スコアカードテンプレート。5つのスキル、2つの必須項目、1〜5のスコア、それぞれの根拠となる引用を記入します。
表をコピーして、自分のスキルとアンカーに差し替えてください。
| スキル | 1 / 3 / 5 のアンカー | スコア 1〜5 | 根拠(引用) |
|---|---|---|---|
| ヘッダー | 候補者、職種、面接官、日付 | ||
| 怒った顧客への対応(必須) | 顧客のせいにする / 規定を適用する / 原因を解決する | ||
| 文章コミュニケーション(必須) | 不明瞭 / 明確だが長い / 短く明確 | ||
| キューの優先順位付け | 方法がない / 緊急度で判断する / 影響度で判断する | ||
| チームの指導 | 事例なし / 助言を与える / 計画を立てる | ||
| プロセスの改善 | 事例なし / 改善案を出す / 改善を実行する | ||
| 必須項目の下限 | 必須項目が1つでも3未満なら不採用 | ||
| 評価しない項目 | 表情・声・タイピングから読み取る感情、アクセントや話す速さ(職務に必要な場合を除く)、「カルチャーフィット」 | ||
| 合計 | 5つのスコアの合計、25点満点 | ||
| 総合印象 | 1〜5、最後に記入 | ||
| 推薦 | 強く採用 / 採用 / 不採用 / 強く不採用。覆す場合は理由を記載 |
2.1 作成前に何を決めておくべきですか?
まず職種における成功を定義し、それを実現するスキルを選びます。最初の履歴書が届く前に面接スコアカードを確定させましょう。
この順序は、ジェフ・スマートとランディ・ストリートによるWhoに基づいています。ミッションを1行書き、次に重要度順に3〜8つの成果、そして4〜6つのスキルを書きます。成果とは測定可能な結果のことで、たとえば3年目までに売上を$25 millionから$50 millionへ伸ばすといったものであり、活動ではありません。
基準を固定することが重要なのは、人は気づかないうちに基準を曲げてしまうからです。基礎的な研究であるUhlmann and Cohen (2005)では、参加者が警察署長職に対して、現場感覚に優れた応募者と高学歴の応募者を評価しました。
男性がどちらの強みを持っていても、その仕事にはそちらの強みの方が必要だと判断され、女性にはそのような後押しはありませんでした。応募者を見る前に基準を確定しておくことで、このバイアスは取り除かれました。つまり、候補者に会ってから書いたスコアカードは、すでに気に入っている人物の方へ静かに傾いてしまうのです。
2.2 カルチャーフィットはスコアカードに入れるべきでしょうか?
そのままの形ではいけません。誰も同じように2回採点できないからです。1つか2つの観察可能な行動に落とし込みましょう。たとえば「自分の仕事についてフィードバックを求める」などです。
チームが率直さを重視しているなら、代わりに「ミスを早い段階で報告した具体的な例を挙げた」を採点しましょう。
3. 必須要件が最も重視されるように、面接スコアに重みを付けるにはどうすればよいですか?
すべてのスキルに同じ重みを与え、必須要件の下限を設けるか、最初の面接前に重みを固定しましょう。等しい重みは、過去データに適合させた重みと同程度に新しいケースを予測できることがよくあります。
その2点目は心理学者ロビン・ドーズに由来し、カーネマンがファスト&スローで要約しています。
過去の採用者に合わせて調整した重みは、その集団の偶然も学習してしまいます。たとえば、サポート職で最も優秀だった採用者3人がたまたま全員優れたコーチだったとします。調整済みの重みは、将来のすべての候補者でコーチングを優遇してしまうでしょう。
等しい重みはそのような偶然を追いかけられないので、新しい候補者も同程度にうまく予測できることがよくあるのです。カーネマンが助言するように、スキル同士も独立させておきましょう。「コミュニケーション」と「プレゼンテーションスキル」の両方を挙げてはいけません。両方を合わせると同じものを二重に数えてしまうからです。
必須要件の強さは、重みを大きくすることではなく、下限から生まれる。たとえば「怒った顧客への対応ができる」を2点、その他すべてのスキルを5点とする。
25点中22点という合計はすばらしく見えますが、それでも下限に照らすと採用見送りになります。それが、その仕事に欠かせないスキルに対して望ましい結果です。
重みを付ける場合は、事前に面接スコアカードに明記し、全員に適用しましょう。これにより、合計を歪める最も簡単な方法、つまり気に入った人に会ってから重みを変える道が塞がれます。
Flowmingoがどのように役立つか
FlowmingoのAI面接レポートは固定の重みを使用します。Must Have基準は、総合スコアにおいてGood to Have基準の4倍として数えられます。各基準は0~10の独自スコアを保持するため、必須要件の下限は引き続き自分で適用できます。
4. 3という評価を、すべての面接官にとって同じ意味にするにはどうすればよいですか?
最初の面接の前に、各スキルについて、1、3、5の回答に何が含まれるかを書き出します。その行動基準付き評価尺度により、2人の面接官のスコアが比較可能になります。
「行動基準付き」とは、各スコアが候補者の実際の行動に結び付いているというだけで、「なかなか良い」のような感覚に結び付くものではありません。基準がなければ、同じ面接評価表の3は、ある面接官には「問題ない」、別の面接官には「弱い」という意味になります。
基準付き面接は、その後の業績との平均的な関連もより強いことが示されています。Taylor and Smallの過去の行動面接に関する19件の研究の基礎的レビューでは、基準付き尺度では.35、基準なしでは.26の関連が見られました。研究間には他の違いもあったため、この比較は基準を追加した効果だけを切り分けたものではありません。
必須要件「怒っている顧客への対応」の面接評価尺度は次のとおりです。
| スコア | 回答に含まれる内容 |
|---|---|
| 1 | 顧客を責める。自分自身の行動も結果もない |
| 3 | 実際の例:顧客を落ち着かせ、方針を適用するが、結果を確認しない |
| 5 | 実際の例:原因を見つけ、修正し、フォローアップし、修正内容を共有する |
一段上がるごとに、回答から聞き取れる具体的な内容があります。だからこそ、2人の聞き手が同じ数字にたどり着けるのです。
まだ基準を書けない場合は、米国連邦人事管理局(OPM)の構造化面接ガイドにある5段階を借用してください。各段階は、状況がどれほど難しかったか、またその人にどれだけ指導が必要だったかによって決まります。
- 1、気づき:最も単純な状況で、密接かつ広範な指導がある。
- 2、基本:やや難しい状況で、頻繁な指導がある。
- 3、中級:難しい状況で、時々の指導がある。
- 4、上級:かなり難しい状況で、ほとんど、またはまったく指導がない。
- 5、専門家:極めて難しい状況で、本人が他者に助言する。
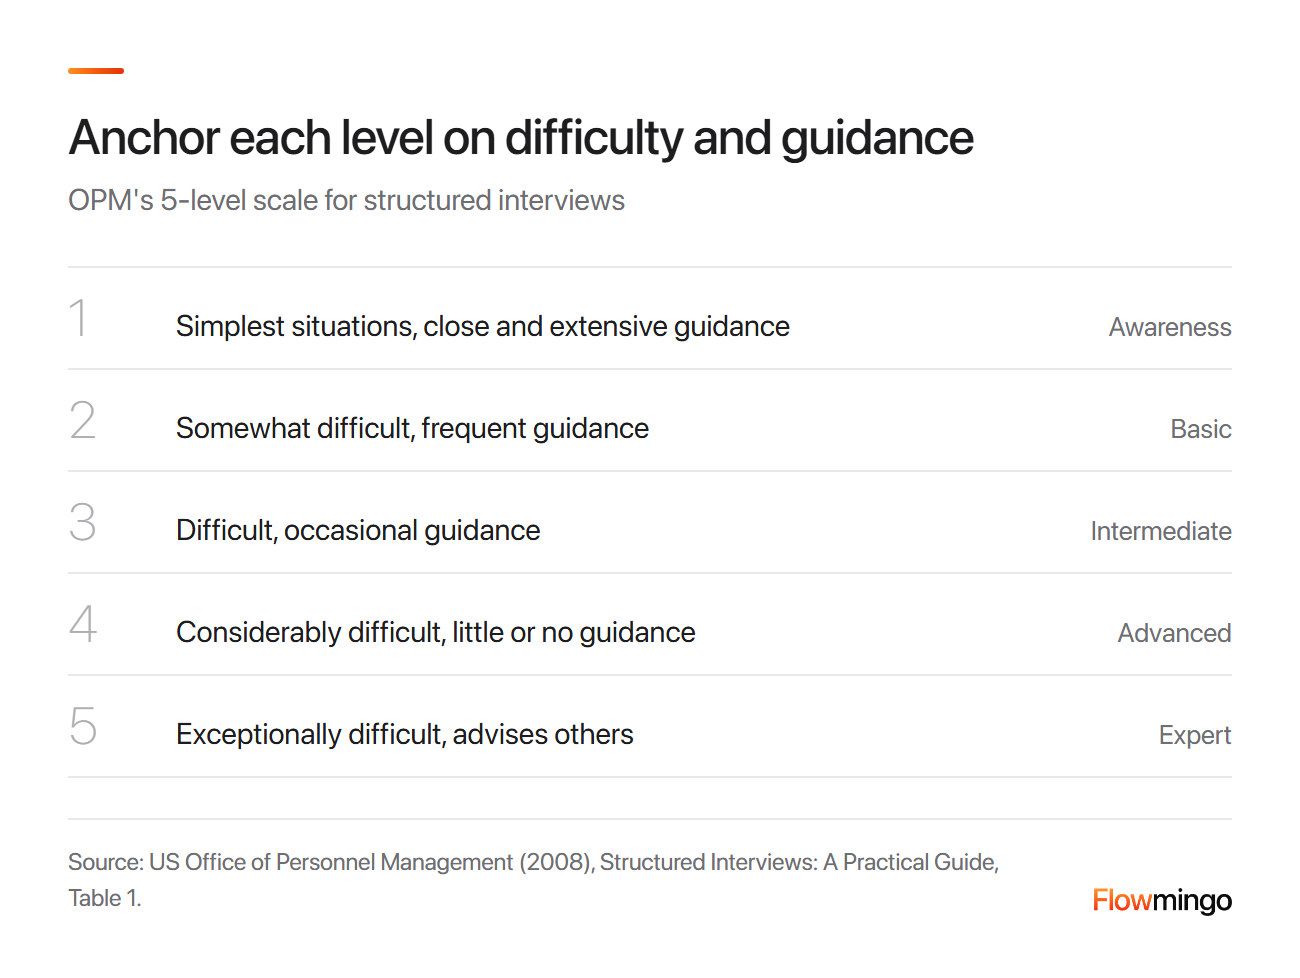
OPMの構造化面接における5つの評価レベル:気づき(最も単純な状況、密接な指導)から専門家(極めて難しい状況、他者に助言)まで。
5. 面接官の意見が分かれたとき、有力な最終候補者2人のどちらを選べばよいですか?
面接評価表の合計で決めましょう。ただし、必須要件が3未満の場合と、2対5に割れた場合の2つは例外で、後者は証拠に基づいて振り返ります。感覚で再投票してはいけません。
これはスコアカードが存在する理由となる瞬間であり、同時にスコアカードを捨てたくなる誘惑が最も強い瞬間でもある。以下は説明用の例で、顧客データではない。サポートリードの最終候補者3名、各セルは3名の面接官の平均値だ。
| スキル | A | B | C |
|---|---|---|---|
| 動揺した顧客への対応(必須) | 4 | 2 | 4 |
| 文章コミュニケーション(必須) | 4 | 4 | 3 |
| 対応キューの優先付け | 3 | 4 | 3 |
| チームの指導 | 3 | 4 | 4(スコア2、5、5) |
| プロセスの改善 | 4 | 4 | 3 |
| 合計、25点満点 | 18 | 18 | 17 |
| 判断 | 採用 | 不採用:最低基準割れ | 振り返りで分裂を検討 |
面接スコアカードを1行ずつ読んでほしい。AとBは25点中18点で並んでいる。しかしBは必須項目で2点を付けており、最低基準に抵触するためBは不採用となる。
Cは合計17点だが、「チームの指導」でのCの平均4は分裂を隠している。1人の面接官は2を付け、残りの2人は5を付けた。この差が振り返りの唯一の議題となる。
実際には、双方に根拠となる発言の引用を読み上げてもらう。たとえば、低い点を付けた面接官はメンバーが退職した話を聞いており、他の2人はうまくいった指導計画の話を聞いていたとする。振り返りではどちらの話がCにとってより典型的かを決め、根拠を見落としていた人がいれば書面でスコアを変更する。
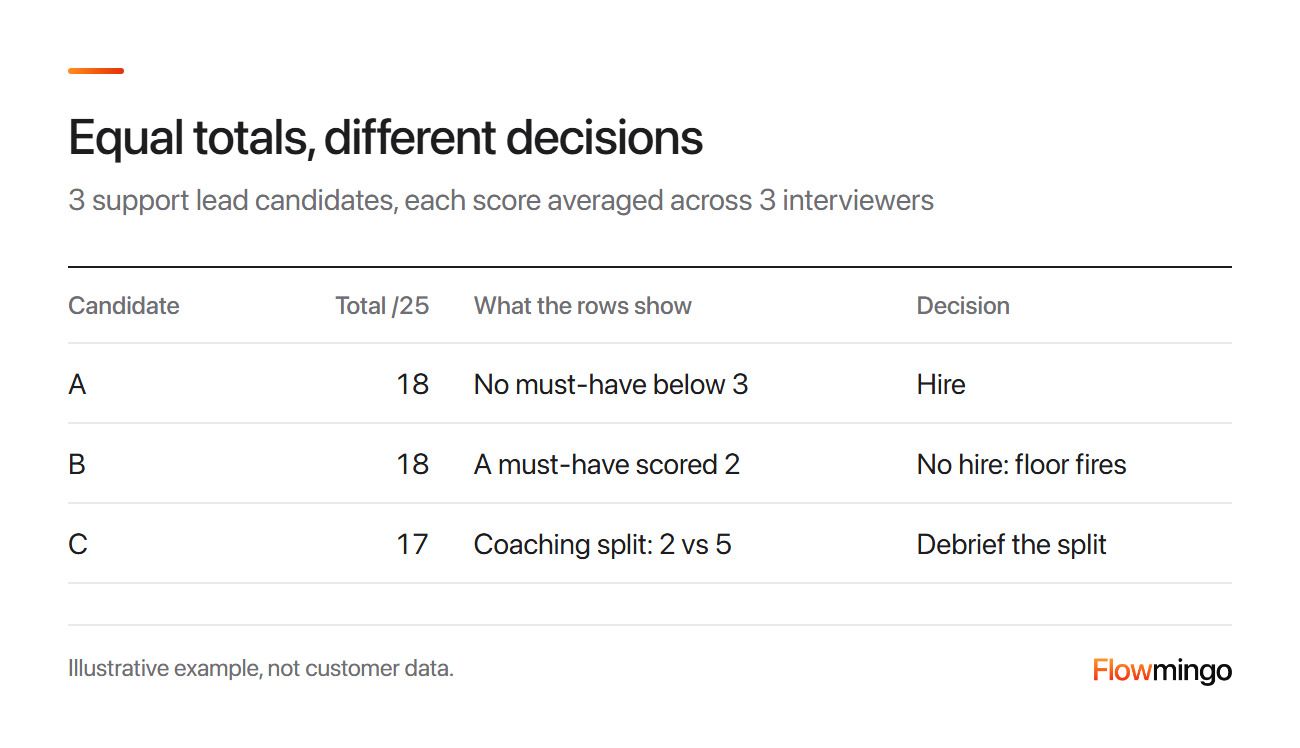
記入済みの面接スコアカード(説明用):AとBは25点中18点で並び、Bは必須項目を外しており、Cには振り返るべき指導評価の分裂がある。
スコアで最終候補者が決まったら、送付前に条件をオファーに書き込もう。弊社の内定通知書テンプレートでは、各確認項目をどこに記載するかを示している。
5.1 直感とスコアが食い違ったら?
スコアが見落としている根拠を書き出せない限り、スコアに従う。Kuncelらによる2013年の基礎的なメタ分析では、全員に同じように適用する公式が職務遂行を0.44で予測したのに対し、全体判断は0.28だった。著者らはこれを、職務を知る専門家と比べても50%以上の予測改善だとしている。
全体判断とは、合意形成ミーティングを含め、人が同じ事実を頭の中で比較検討することだ。したがって振り返りは根拠の空白を埋めるものであり、再投票はしない。
5.2 最終候補者を横並びで比較すべき?
はい、回答ごとに見ていきます。BohnetのHBRのアドバイスは、まず質問1へのすべての回答を比較し、次に質問2へと進むことで、各回答を他の回答と照らし合わせて評価するというものです。
2016年の基礎的な実験室研究では、候補者を一度に1人だけ見せられた人は、その課題のステレオタイプが有利とする性別の方に傾きました。過去の実績はほとんど関係ありませんでした。2人を並べて見せられると、より高い成果を上げた人を54%の確率で選び、低い人は8%でした。
この研究は面接ではなく過去の課題スコアを用いたものなので、証拠ではなく強い示唆として扱うべきです。
6. 一番声の大きい面接官が振り返り会議を仕切るのをどう防げばよいですか?
全員が話し始める前に、各面接官に面接スコアカードを提出させ、そのスコアから振り返りを始めます。
たとえば、上の立場の人が「彼女は最高だった」と口火を切ると、場の空気はその見方に傾き始めます。各自が単独で書いたスコアは、その引き込みから全員を守るので、Noiseが独立した採点を採用ルールにしているのはそのためです。
実際には、共有シートまたは応募者追跡システムにスコアを集め、それらを一斉に公開します。
全員が同じ面接を見るパネル形式は、解決策に見えます。Huffcuttらによる2013年の基礎的なメタ分析では、0〜1の尺度で、パネル評価者の一致度は0.74だったのに対し、個別面接では0.44でした。
その数字はパネル形式を実際より良く見せています。パネリストは全員、同じ日に同じパフォーマンスを採点するため、候補者の調子がその朝に異常に良かったり悪かったりすれば、全員がそれを目の当たりにします。
Iris BohnetがGoogleでの講演で述べたように、「パネル面接のサンプルサイズは事実上1です」。個別面接をそれぞれ単独で採点すれば、より多くの独立した視点が得られます。
6.1 各候補者を何人の面接官が採点すべきですか?
個別面接で最大4人までです。査読付き研究ではなくGoogleの内部データでは、4回の面接が採用判断を86%の信頼度で予測しました。追加の1回ごとに1%未満しか向上しませんでした。
追加の面接は、Google自身の採用判断を予測するうえでほとんど寄与しなかった。これは各選考ラウンドを正当化するための問いかけとして使い、普遍的な上限や、入社後の職務パフォーマンスに関する証拠として扱うべきではない。
7. 忙しい面接官に面接スコアカードを実際に記入してもらうには?
採点を面接の一部にしましょう。各スキルはその質問の直後に採点し、根拠として1行の引用を書き、全体の印象は最後に記載します。
面接を一日終えた後に、また別のフォームを書きたがる人はいません。だからこそ採点は面接の中で行い、その夜の宿題にはしません。
カーネマンは1955年、自由形式の面接が成功の予測にほとんど役立たないことが分かった後、イスラエル軍のためにこの手法を考案した。面接官は6つの特性を1〜5段階で採点し、それぞれを終えてから次を始めたため、第一印象が残りの評価を歪めることはなかった。
そのうえで初めて目を閉じて総合評価を下し、合計点は以前よりはるかに正確に予測した。彼の助言は、合計点が最も高い人を採用することだった。「たとえもっと気に入った別の候補者がいたとしても」。
タイミングも重要です。フィールド研究では、166人の面接官がいつ判断を固めたかを報告しました。最初の1分で決まった判断は4.9%のみでしたが、22.5%は面接が終わった後に下されました。
候補者が退室した後に下される判断は記憶に依存するため、その場で採点しましょう。
当社のサポートリードの場合、次のようになります。
- キューの質問を2つ尋ね、次に進む前に「キューを優先する」を採点する。
- 根拠として引用を1つ書く。例:「バグは、何人の顧客に影響するかで並べ替えます。」
- すべての候補者で同じスキル順を保つ。
当社のデータでは、書かれた根拠はごくまれです。
Flowmingoのデータ · AI面接を受けた候補者86,638人 · 企業2,574社 · 2025年7月〜2026年9月
- AI面接を受けた候補者のうち、採用チームから書面のコメントを得たのは0.3%でした(86,638人中258人)。
チームは別の場所にメモを残している可能性があります。Flowmingo内では、AIレポートが通常、保存されている唯一の書面評価です。
忙しい日には、記述式の理由が真っ先に省略されます。だからこそ、フォームではスキルごとに引用を1つだけ求めています。
8. 面接スコアカードのAIスコアは信頼できますか?
人が確認する1つの入力として使い、まずその理由を読んでください。AIスコアリングは、学習していない質問では大きく精度が落ちることがあります。
この回答には私たち自身が利害関係を持つため、以下の根拠にはAIにとって都合のよくない部分も含めています。
2023年の基礎的な研究では、訓練を受けた評価者2名が7,017件の応募者回答を1~5のアンカー付き評価尺度で採点しました。同じ質問で学習したモデルは、0~1の尺度で0.75と、評価者のスコアに近い一致を示しました。未学習の質問形式では0.30まで低下し、一致度は弱いものでした。
つまり、AIスコアは質問ごとのルーブリックの質以上にはならないため、その数値を信頼する前に理由を読んでください。また、この研究の5名の著者のうち3名は、AI面接ベンダーのModern Hireで働いていた点にも注意してください。
Flowmingoがどのように役立つか
FlowmingoのAI Interviewerは、あなたが承認した評価基準に基づいてスコアリングします。AIが求人票から質問と評価基準の下書きを作成し、あなたが両方を編集します。各応募者には、自分の都合のよい時間に受けられる面接を送信します。
返ってくるのは、録画、文字起こし、そして各評価基準を0~10で評価し、文章による根拠を付けたものです。採用の判断はあなたが行います。
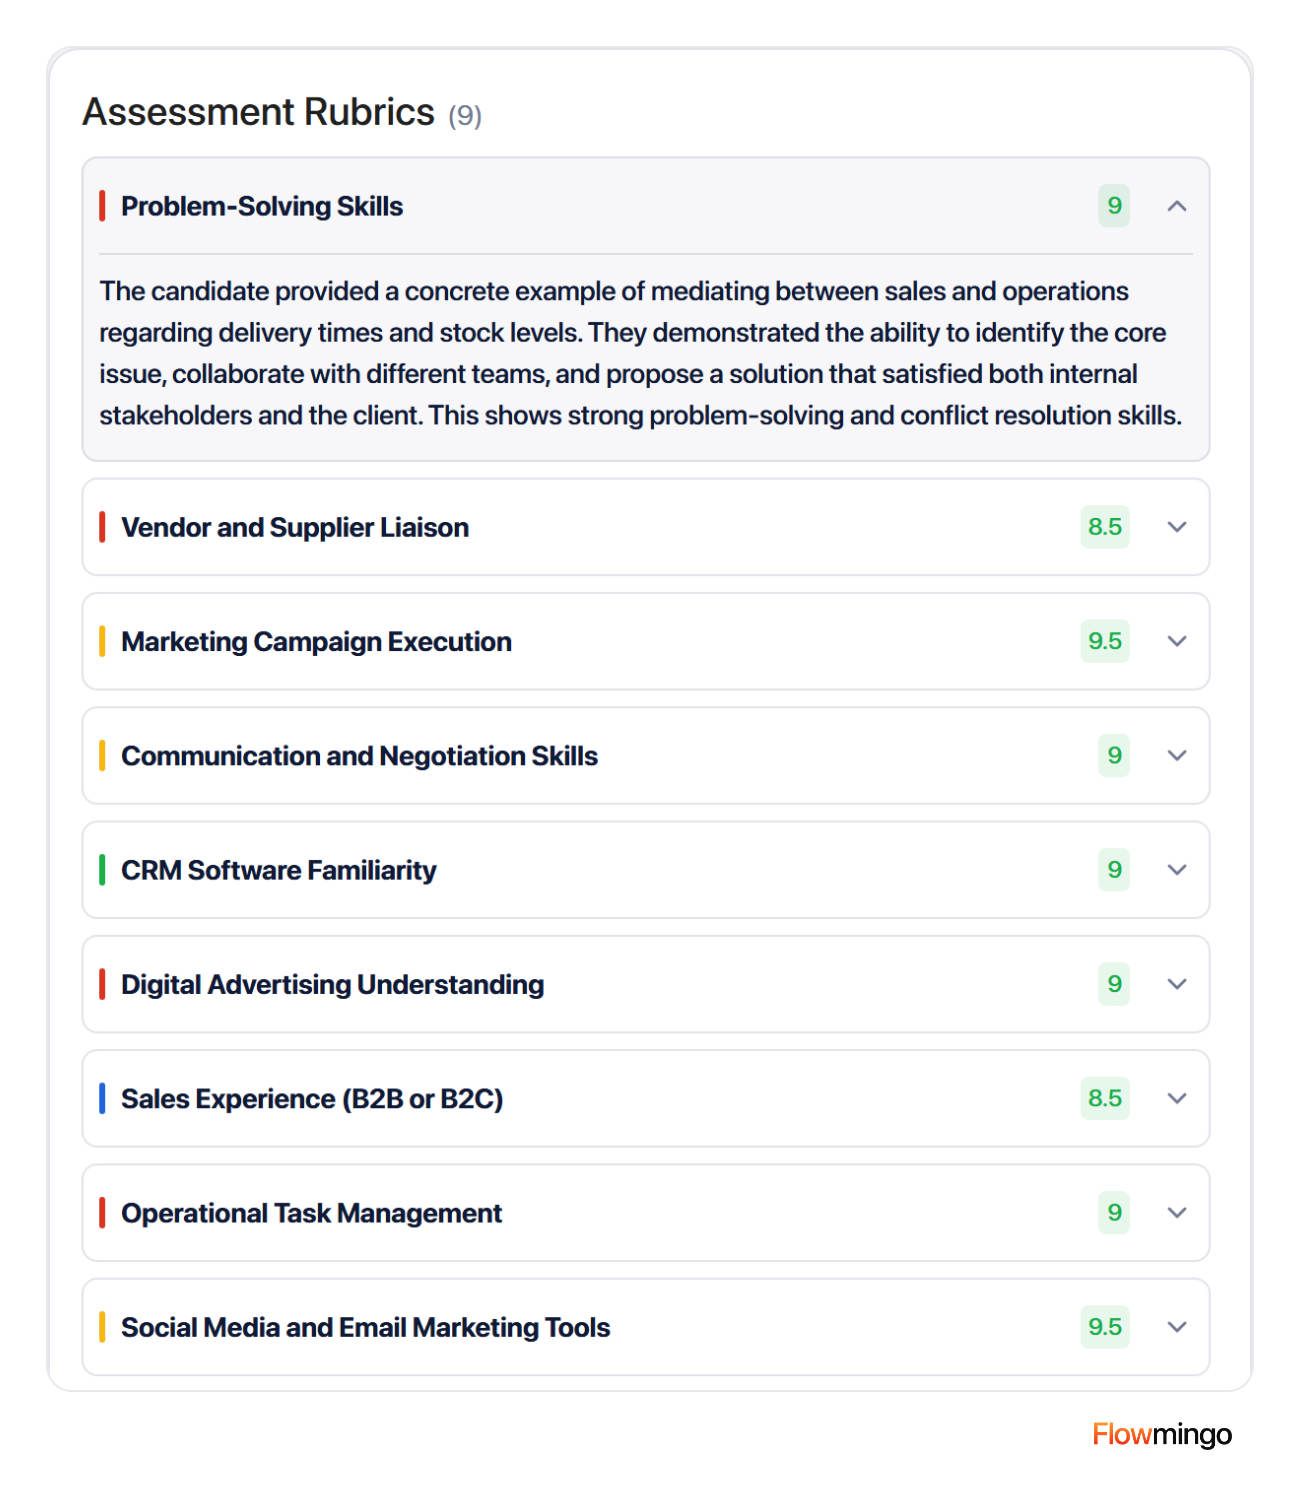
Flowmingoの公開サンプルレポート:評価基準ごとに0~10のスコアと理由が示されるため、必須要件の下限はこの尺度で設定してください。
私たちのデータでは、誰が最も優れているかについて履歴書と面接の評価も一致しません。
Flowmingoデータ · 候補者34,114名 · 379社 · 2025年7月~2026年9月
- 面接で明確な首位スコアが1人に定まった532プロジェクトのうち、19.2%ではその候補者が履歴書スコアでも首位でした。
- 面接で8以上を獲得した3,684名の候補者のうち、54.9%にあたる2,022名は、履歴書の上位20%による絞り込みで除外されていたでしょう。
どちらもFlowmingoのAIスコアであり、実際の職務パフォーマンスではなく、面接受験者も選抜されたグループです。このデータは2つの順位付けが異なることを示すもので、どちらが正しいかではありません。
平たく言えば、そうしたプロジェクトの約5件に4件では、面接で最高スコアの候補者が履歴書でも最高スコアだったわけではありません。ですから、履歴書スコアを引き継ぐのではなく、面接は面接だけで評価してください。
9. 不採用になった候補者が苦情を申し立てた場合、スコアカードは私を守ってくれますか?
職務関連の根拠を採点し、それを保管していれば役に立ちます。合理的な解釈では、米国の連邦規則はスコアカードを少なくとも1年間保管することを意味し、カリフォルニア州の規則では4年間です。
苦情は数か月後に届くことがあり、その頃には誰も面接を覚えていません。スキルごとに引用を添えた面接スコアカードがあれば、何を評価し、なぜそう評価したかを示せます。
米国規則はスコアカードを名指ししていませんが、「採用に関するその他の記録」を対象にしています。誰かが差別の申し立てを行うと、案件が終わるまで関連するすべての記録を保管します。これには同じ職務の他の候補者の記録も含まれるため、1件の申し立てで記録一式が凍結されます。
これらの規則は2026年9月時点のものです。これは概要であり、法的助言ではありません。
| 規則 | 対象地域 | スコアカードへの意味 |
|---|---|---|
| 29 CFR 1602.14 | 米国 | 採用記録を1年間保管し、申し立て後はさらに長く保管する |
| 2 CCR 11013(c) | カリフォルニア州 | 自動意思決定データを含め、記録を4年間保管する |
| ICOガイダンス | 英国 | 候補者は面接メモを請求できる。同点時の優先ルールがあれば開示する |
| TAFEP | シンガポール | 評価フォームを使用し、記録を少なくとも1年間保管する |
| 29 CFR 1630.11(ADA) | 米国 | 障害が発話に影響する場合、職務が発話を必要とするのでなければ、発話ではなくスキルを評価する |
| AI法 第5条(1)(f) | EU、2025年2月2日以降 | 顔、姿勢、キー入力から候補者の感情を推測するAIは禁止 |
| AI法 附属書IIIおよび第26条 | EU、2027年12月2日以降 | 高リスク:人による監視、ログを6か月以上保管、候補者への通知 |
| Local Law 144 | ニューヨーク市 | AIスコアを単独で使用する、他のすべてより重く重み付けする、または人による判断を覆すために使用する場合:バイアスに関する年次監査と通知 |
| AI Video Interview Act | イリノイ州 | まず通知、説明、同意を得る。削除請求から30日以内に動画を削除する |
テンプレートに「採点対象外」の行があるのはそのためです。EUは、顔、姿勢、キー入力から候補者の感情を読み取るAIを禁止しており、米国の障害法(ADA)は発話に影響する障害のある候補者を保護しています。英国では候補者があなたのメモを請求できるため、候補者が読むことを想定して各根拠の行を書いてください。
自己監査するには、Uniform Guidelinesの4/5ルール(経験則)を使ってグループ別の合格率を比較します。たとえば、あるグループの30%が合格し、別のグループの50%が合格したとします。30を50で割ると0.6で、0.8を下回るため、より詳しく確認します。
2026年6月の司法省意見書と2026年7月のOPM規則は、連邦機関をガイドラインから遠ざけます。ただし、ガイドラインは連邦規則に残っているため、このチェックは法的な線引きではなく、低コストの習慣として扱ってください。
10. 今週、チームで面接スコアカードをどのように導入すればよいですか?
この順序で作成し、変更するのは職務と職務の間だけにしてください。最初の版は完璧である必要はありませんが、すべての候補者に対して同じでなければなりません。
- ミッションを1行で書き、成果を3〜8個、優先順位付きで書く。
- それを5つのスキルに落とし込み、必須スキルに印を付ける。
- スキルごとに、過去の行動に関する質問を2つと、1、3、5の評価アンカーを書く。
- 最大4人の面接官に各自で採点させ、デブリーフの前に提出させる。
- 合計点で決定するが、必須スキルのいずれかが3未満なら不採用とする。すべての例外判断を書き留める。
実際の運用では、まず募集中の職種を1つだけ始めてください。そうすればチームは実際の対象で習慣を身につけられます。最初の面接の前に、全員に同じサンプル回答を採点させ、比較してください。
2つのスコアが1ポイントを超えて離れている場合は、それらが一致するまでアンカーを書き直してください。セクション8の研究で訓練を受けた評価者たちも、同じ1ポイントの差を会議を招集する基準にしていました。
ある程度の反発は覚悟してください。Kahnemanの陸軍面接官たちも、回答を記録するだけのやり方に抵抗を示しました。そして彼の解決策は、目を閉じて評価する手法でした。これは彼らの判断をフォーム上に位置づけるものでした。あなたのチームでは、総合印象の欄がその役割を果たします。
Flowmingoがどのように役立つか
応募者全員に、自分の都合のよい時間に受けられる構造化面接を送り、録画して1つの面接スコアカードに沿って採点するには、Flowmingoをお試しください。
11. 出典
上記の外部数値はすべて、下記の出典に登場順で基づいています。Flowmingo自身の数値はデータボックスにあり、2025年7月から2026年9月のものです。
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.