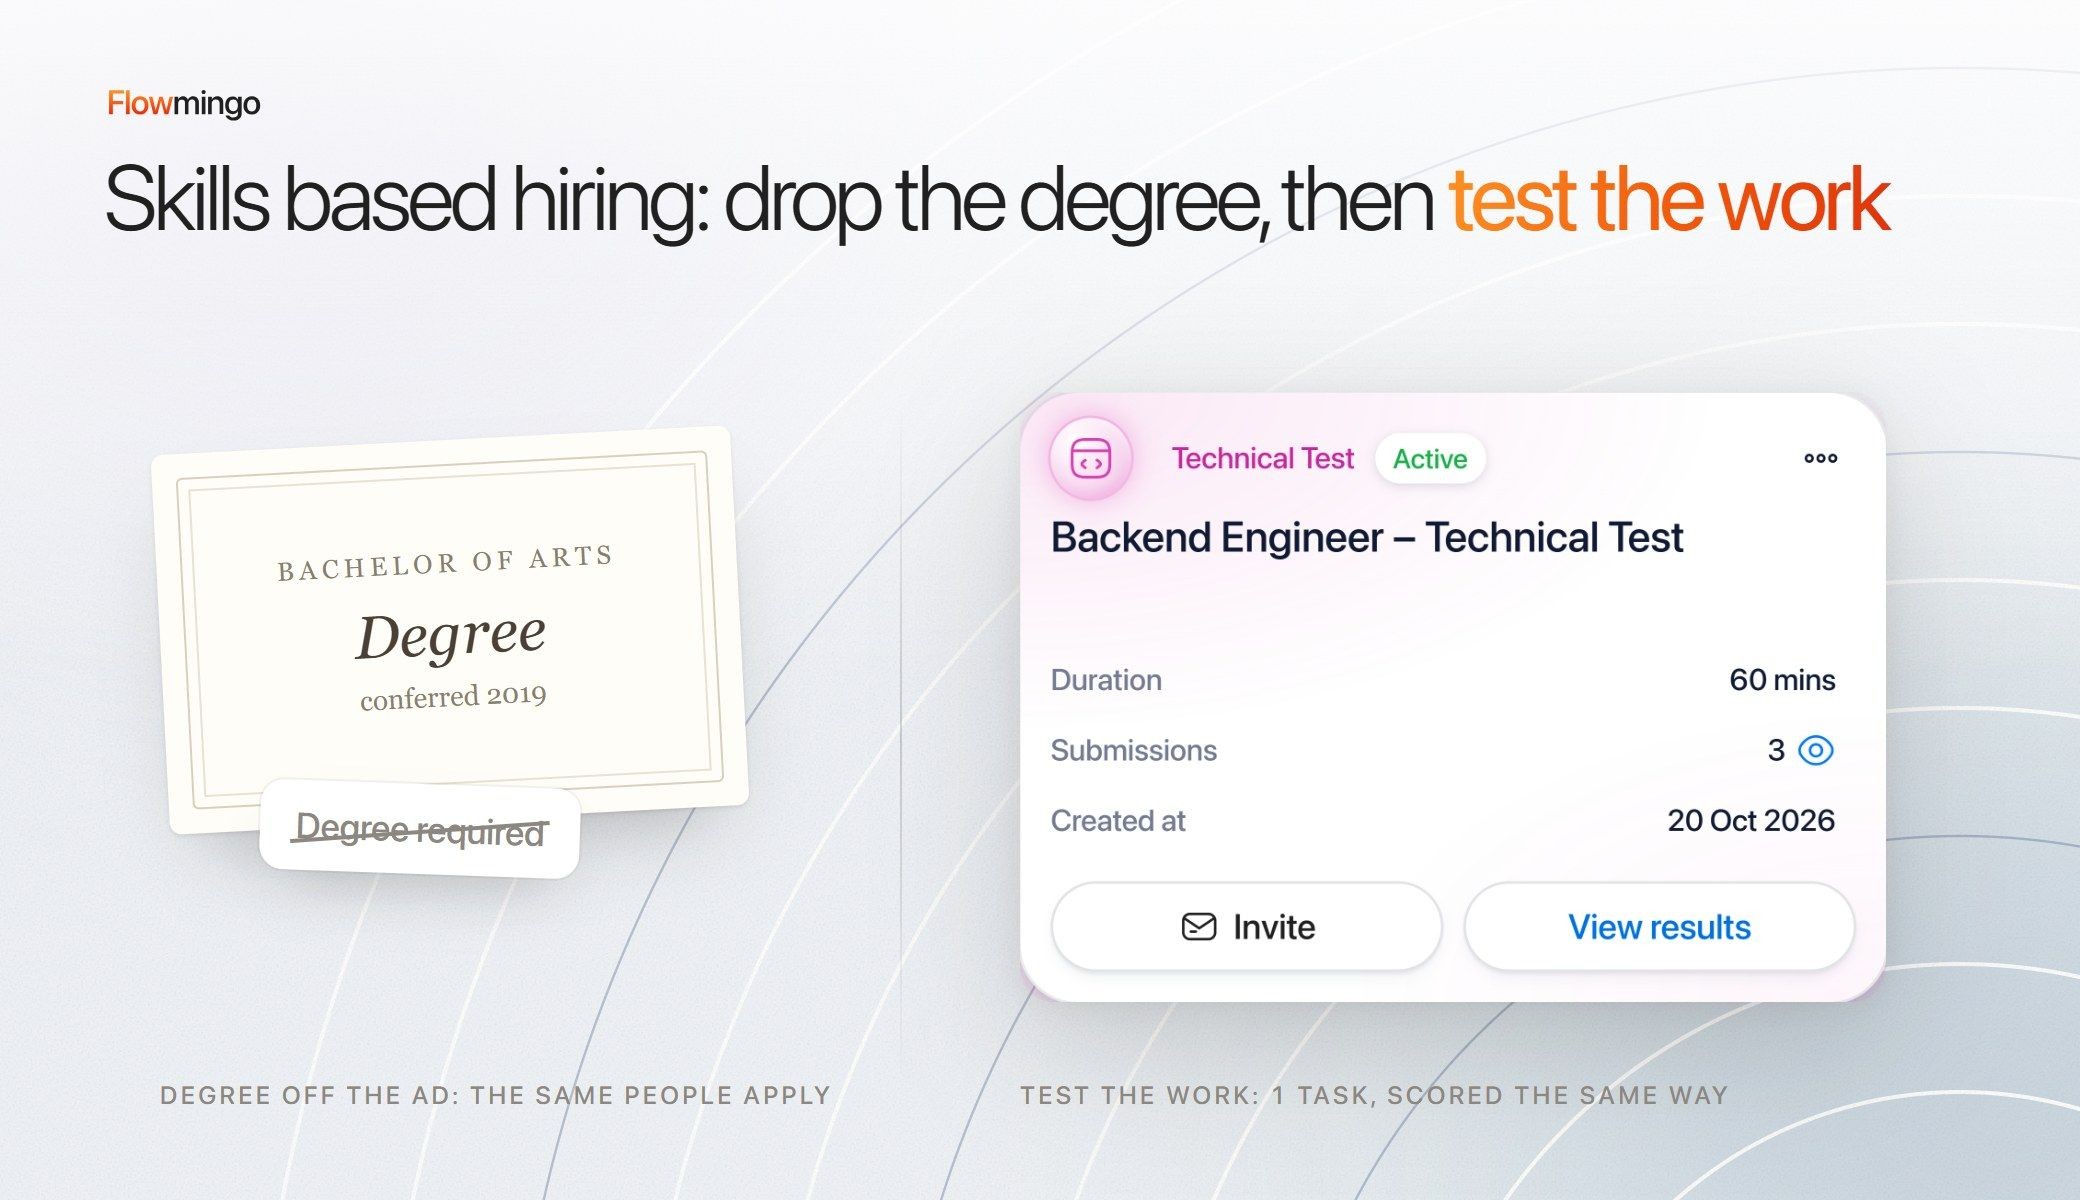
求人広告から学位要件を外しても、同じような人たちが依然として応募してくる。それは名目上のスキルベース採用にすぎず、変化はしばしばそこで止まる。
米国の大企業における11,300職種を対象とした1件の研究では、学位要件を外すことで増えた米国の採用は700人に1人未満にとどまった。学位要件を外した職種はわずか3.6%で、そうした企業のうち採用する人材を変えたのはわずか37%だった。
問題は決して求人広告ではなかった。採用マネージャーは各候補者を応募者集団と比較するため、学位が近道として残り続ける。スキルを確認する採点手法がなければ、古いフィルターが再び忍び込む。
そのせいで、実際に仕事をこなせる人材を失う。SHRMの調査では、人事専門家の85%が、信頼できるスキルチェックがあれば、自組織が学位を持たない候補者を適格と見なしやすくなると答えた。
このガイドでは、HRチームがいない状態で1つの職種においてスキル基準の採用を3つの手順で始める方法を説明します。履歴書を読む前に、短いスキルリストを作成します。最終候補者全員に同じワークサンプルテストを課し、記述した評価例に照らして採点し、その後、グループ別に合格率を確認します。
重要なポイント
- 求人広告から学位要件を外せば、採用する人は変わるのか? 評価方法を変えた場合に限ります。学位要件を外した企業のうち、学位のない人をより多く採用したのはわずか37%でした。
- 最初の履歴書を読む前に何を書き出すべきか? 4〜6個のスキルを挙げ、必須スキルと習得可能スキルに分け、それぞれに対応するタスクを添えます。
- ワークサンプルテストはどのくらいの時間にすべきか? 30〜45分を目安にし(当社のルール)、3時間を超えないようにします。
- スキルテストは優秀な候補者を遠ざけるか? 長さだけが理由ではありません。途中で辞めた人の大半は最初の20分で辞めています。
- 応募者30人でスキルテストのバイアスを確認できるか? できますが、兆候があっても確認する理由になるだけです。10人中5人対10人中3人では偶然の可能性があります。
1. 学位要件を外しても採用する人材は同じに見える。スキル基準の採用は機能するのか?
それだけでは機能しません。11,300職種を対象とした調査で、学位要件の記載を外した企業のうち、採用する人材を変えたのはわずか37%でした。
Burning Glass InstituteとHarvard Business Schoolは、2024年の基礎的調査でこれらの職種を追跡しました。企業が学位要件を外した場合、学士号を持たない人の採用は3.5ポイント増えましたが、要件を外した職種はわずか3.6%でした。米国の全採用で見ると、純変化は0.14ポイントで、700人に1人未満、年間7,700万人中約9万7,000人に相当します(報告書の推計)。
学位要件を外した企業のうち、45%は名目上だけ広告を変え、18%は元に戻りました。実行を徹底した37%だけが、学位のない人材を約18%多く採用しました。
報告書によると、広告だけではほとんど変わらないのは、持続的な変化には新しいプロセスとインセンティブが必要だからです。ただし、37%が用いた具体的な仕組みは名指ししていません。SHRMの2025年調査(HR専門家1,184人対象)では、スキル優先採用の主な障壁は学位への依存(29%)と、評価ツールやプロセスの不在(29%)でした。次いで、実践の一貫性のなさ(25%)が挙げられました。
私たちの解釈では、このガイドの3つの手順がこれらの障壁に応えます。スキルリストが一貫性を生み、同じテストがツールとなり、記述式の採点がプロセスとなります。この調査は年間500件以上の求人広告を出す企業を対象としているため、小規模企業については何も示していません。
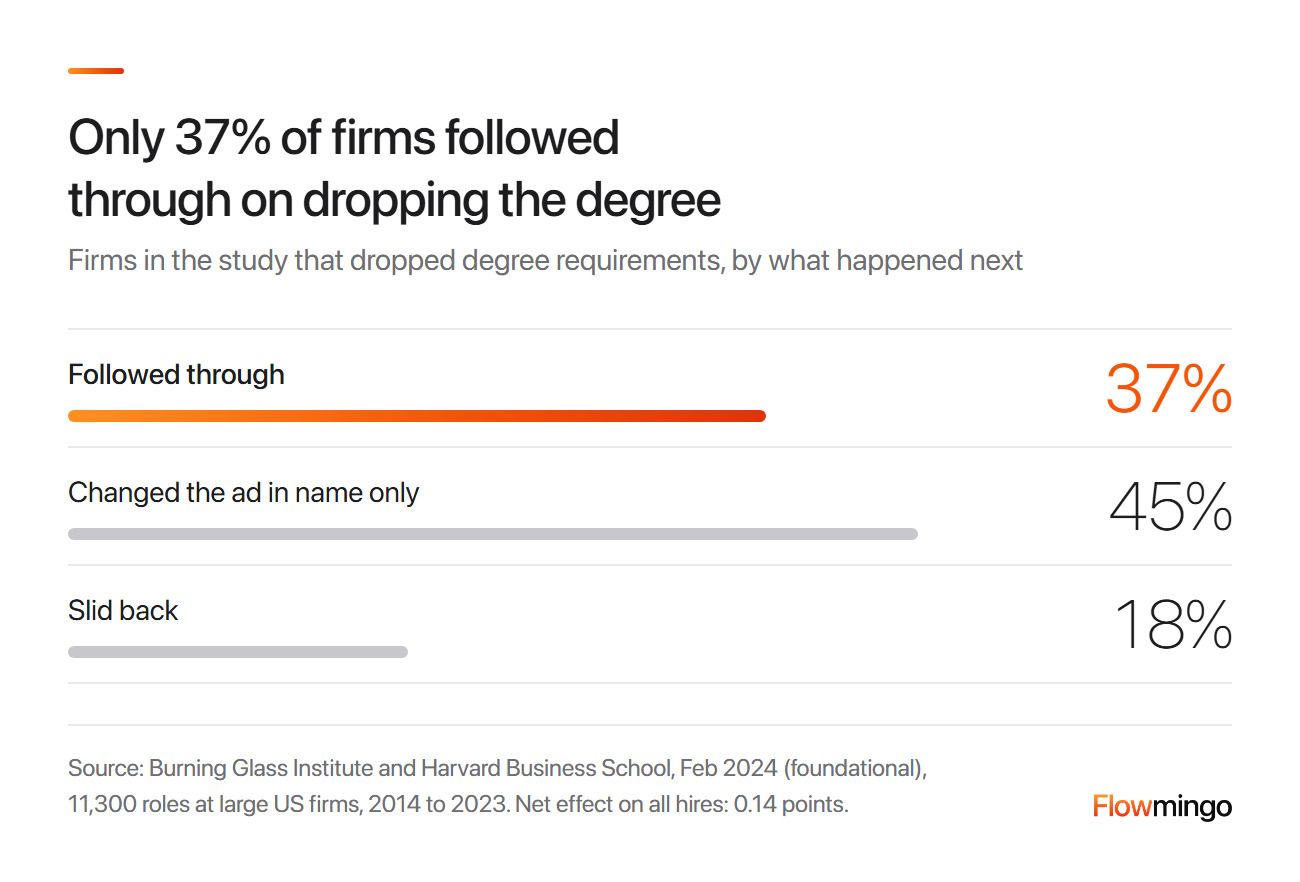
学位要件の実行状況:要件を外した企業の37%が実行を徹底し、45%は名目上だけ広告を変え、18%は元に戻りました。2024年の基礎的調査は11,300職種を対象としています。
2. HRチームがいない中で、次の職種でスキル基準の採用を始めるには?
1つの職種で、3つの変更を伴うスキル基準の採用を試験導入します。短いスキルリスト、スキル評価としての1つのワークサンプルテスト、そして記述式の採点です。
以下の図は調査に基づくものではなく、当社独自の7日間プランです。1日目にスキルリスト、2日目にテスト、3日目にルーブリックを作成します。4~6日目には、最初の面接後に最終候補者全員が同じタスクを行います。7日目にはスコアを合計し、グループ別の合格率を確認し、オーバーライドを記録します。
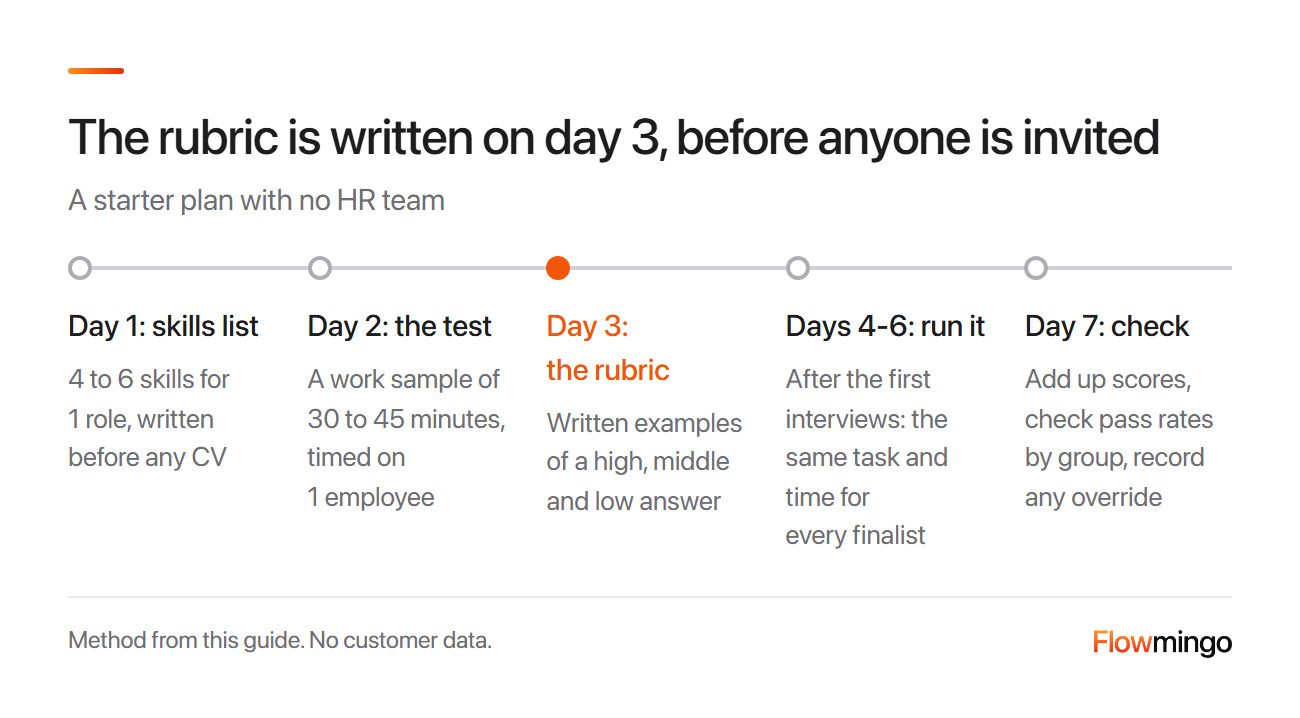
7日間のスタータープラン:1~3日目にスキルリスト、ワークサンプルテスト、ルーブリックを作成します。4~6日目に最終候補者全員が同じタスクを行い、7日目に合格率を確認します。
まずは1つの職種から始めましょう。試験運用なら、採用を誤る前にプロセスを学べます。リストを作成し、採点を運営する責任者を1名指名してください。そうすれば、候補者ごとにプロセスがばらつきません。
選考はコストの低い順に並べます。応募書類で明確な事実を確認し、最初の面接を行い、残った4名程度にワークサンプルテストを実施します。当社の採用プロセスのステップガイドではテストに4日間を割り当てているので、テストに必要なら4~6日目を延ばしてください。
応募者が200名以上の場合は、当社の候補者選定ガイドで示しているように、まず明確な事実で絞り込みましょう。
3. 職務記述書が古い場合、1つの職種のスキルリストはどう作ればよいですか?
古い求人広告ではなく、実際の仕事から作ります。その人が最初の90日間にしなければならないことを列挙し、最も重要な4~6個に絞ります。
まずタスクから始めます。古い求人広告には、もはや存在しない職務が記載されているからです。マネージャーと、その職種に最後に就いていた人に6~10個のタスクを尋ねましょう。
1978年の米国統一ガイドラインでは、内容に基づくテストは職務分析に基づくべきとされており、業務を通じて学ぶスキルには適していません。
必須スキルと学習可能スキルを分けます。必須スキルは初日から必要であり、学習可能スキルは教育するものなので、テストしません。
その後、履歴書を見る前にリストを確定し、日付を記録します。2005年の3つの基礎的実験では、人は自分が好む候補者に合わせて職務要件を再定義しました。基準を先に固定すると、その差別的な偏りがなくなりました(Uhlmann and Cohen)。
説明用の例であり、顧客データではありません。事務管理者のスキル一覧で、[date] 時点で確定しています。
| スキル | 種類 | それを示す課題 | 優れた回答(5) |
|---|---|---|---|
| 記録を正確に保つ | 必須 | 25行の請求書シートで3つの誤りを見つける | 3つすべてを見つけ、それぞれがどのように起きたかを説明する |
| 明確に書く | 必須 | 各誤りについてメモを書く | 同僚が各メモに基づいて行動できる |
| 優先順位を付ける | 必須 | どの誤りを最初に直すかを言う | どの誤りが最も重要かとその理由を言う |
| 表計算の数式 | 学習可能 | テストしない。研修で教える | 該当なし |
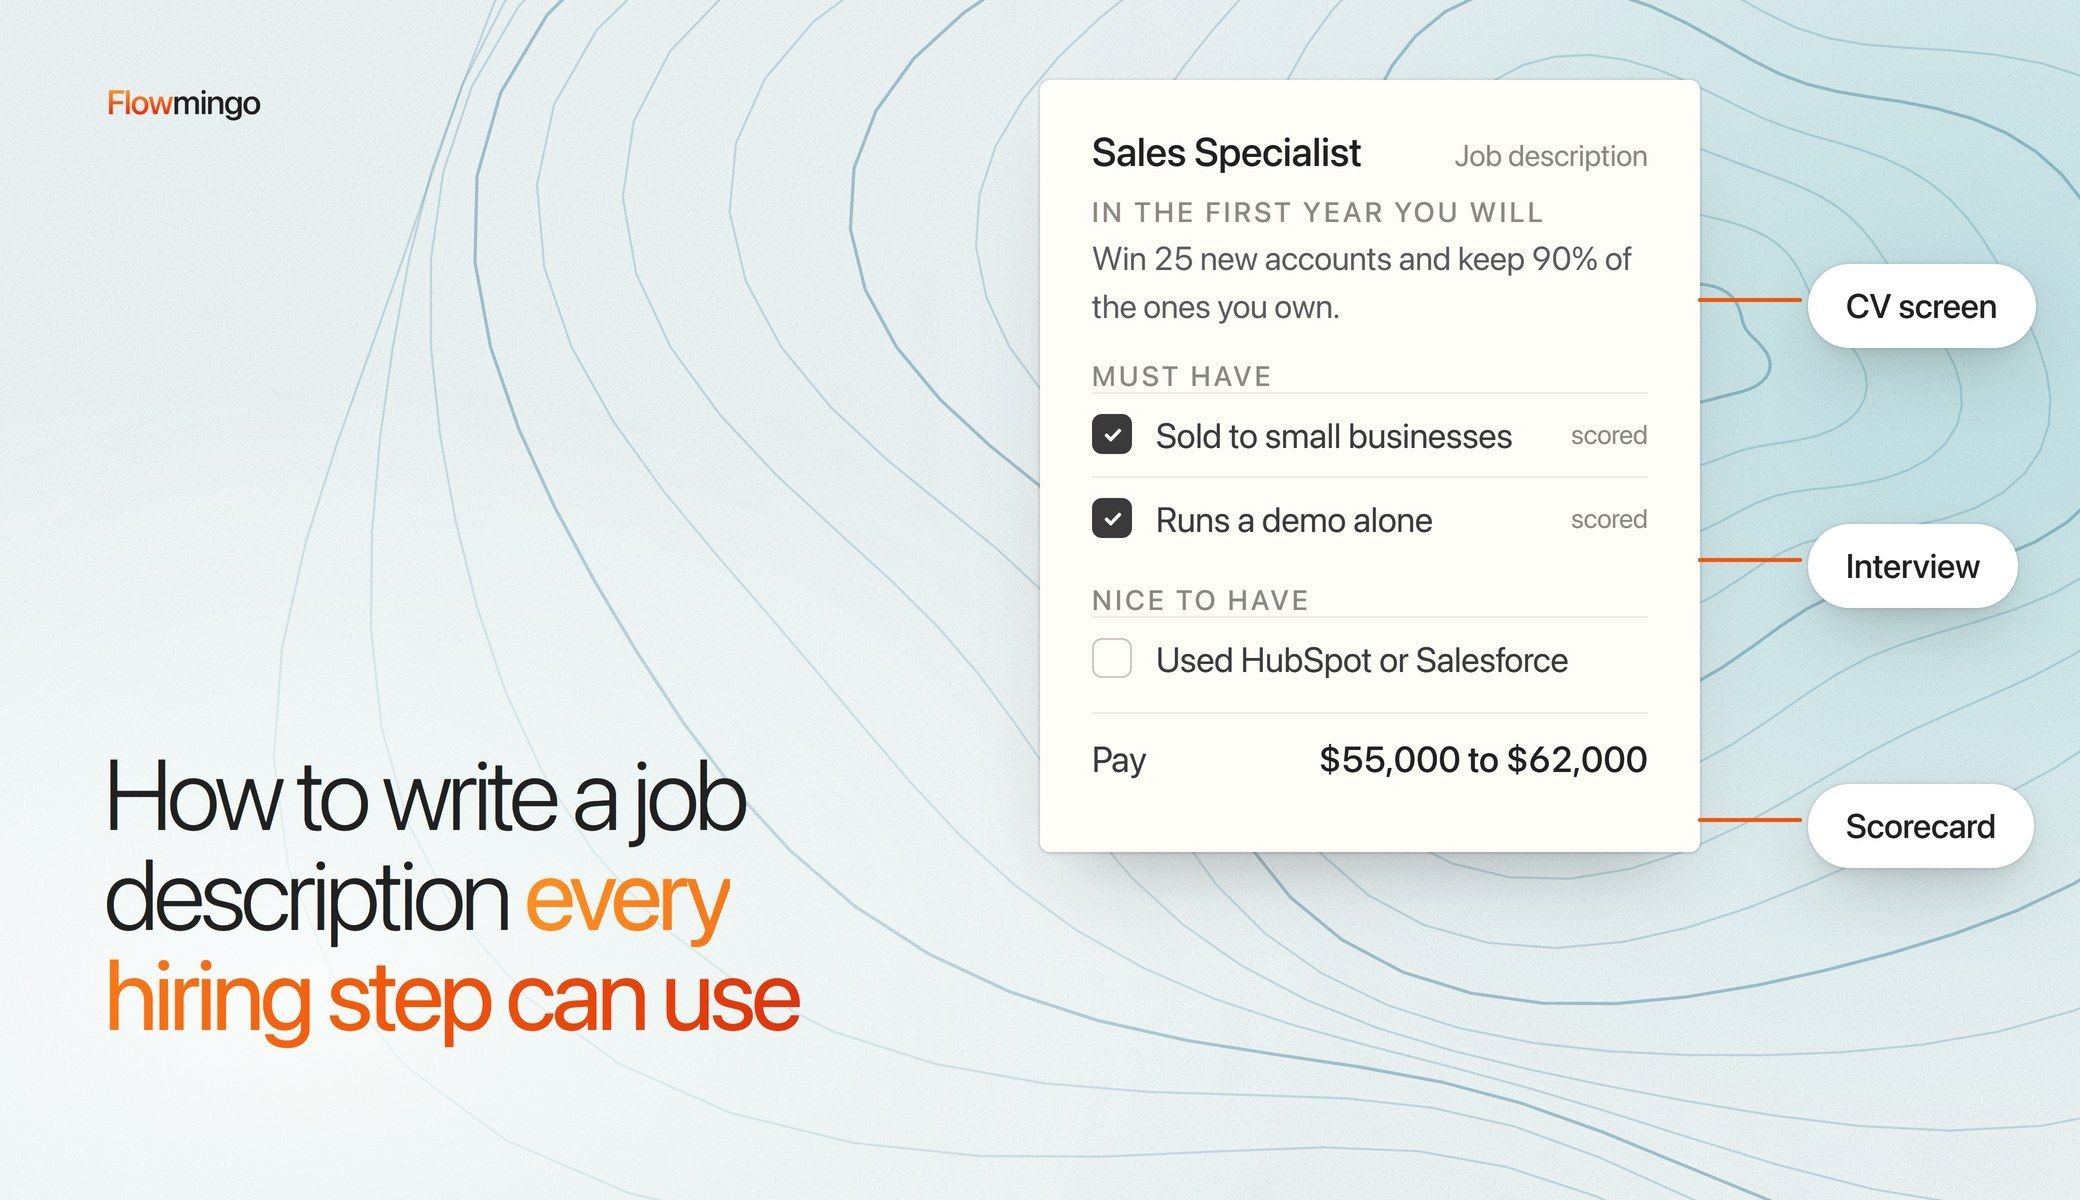
一覧をもとに求人広告を書き換えましょう。ワシントン州のサンプル求人は、仕事内容を先に示し、必須としない要件を列挙しています。私たちの例では、「学位を優先。オフィスでの3年以上の経験」を次のように置き換えます:
「仕入先の請求書を正確に管理していただきます。学位は必須ではありません。」
3.1 実務経験年数も外すべきですか?
数字を捨て、代わりにタスクを挙げよう。Sackettらによる2022年の基礎的な再分析では、職務経験年数とその後のパフォーマンスとの関連はわずか0.07で、0は関連なしを意味する。
経験は具体的な場合に意味を持ちます。1995年の基礎的なレビューでは、同じ仕事をどれだけ経験したかが業績と0.43の相関を示したことがわかりました。2つの研究は異なる補正をしているので、差ではなく方向性を読み取ってください。
ですから、「50人以上のスタッフの給与計算を担当した」と書きましょう。「人事で5年」ではありません。
2年の経験を持つ候補者が10年の候補者よりテストで優れている場合は、両方を同じ評価基準で採点し、例外を適用した場合は記録してください。
4. ワークサンプルテストはどのようなもので、どのくらいの時間をかけるべきですか?
スキルベース採用では、ワークサンプルテストは、最終候補者全員が同じ条件で行う、実際の仕事の小さな一部です。30〜45分で計画し、3時間を超えないようにしてください。
30〜45分というのは私たちのルールです。なぜなら、テストを受けるのは残った4人程度だけで、244人ではないからです。3時間という上限は、実務家のJacob Kaplan-Moss氏が2021年の基礎的な投稿で示しています。同氏は、2〜3回の面接とその運営だけで、候補者の時間をすでに4〜5時間費やすと論じています。
次の6行のブリーフをコピーしてください:
- タスク:[すでにチームが解決した過去の事例を1文で]。
- 時間:[30〜45分]。まず現職員1名が試し、その時間内に終えられるようにする。
- 渡すもの:[1ページの概要と必要なファイル]。
- 提出するもの:[1ファイルまたは1録画]。
- 採点:セクション5のルーブリック、1〜5点。
- 候補者への説明:「[40]分あります。最後まで終える必要はありません。形式や時間を変更する場合は、[名前]([メール])までご連絡ください。[日付、7日以内]までにこちらからご連絡します。」
2022年の基礎的な再分析(Sackettら)では、ワークサンプルとその後のパフォーマンスの相関は0.33で、1998年の基礎的な推定値の0.54から低下していることがわかった。構造化面接(0.42)のほうが順位が高いため、テストは構造化面接と組み合わせるとよい。
0(関連なし)から1(完全)の尺度で、著者らは古い数値が主に統計的補正によって膨らんでいたと述べている。2023年の基礎的な追跡研究では、ワークサンプルは人がすでに持っているスキルに適しており、採用後にスキルを学ぶエントリーレベルの職種には適さないとしている。したがって、必須要件のみをテストしよう。
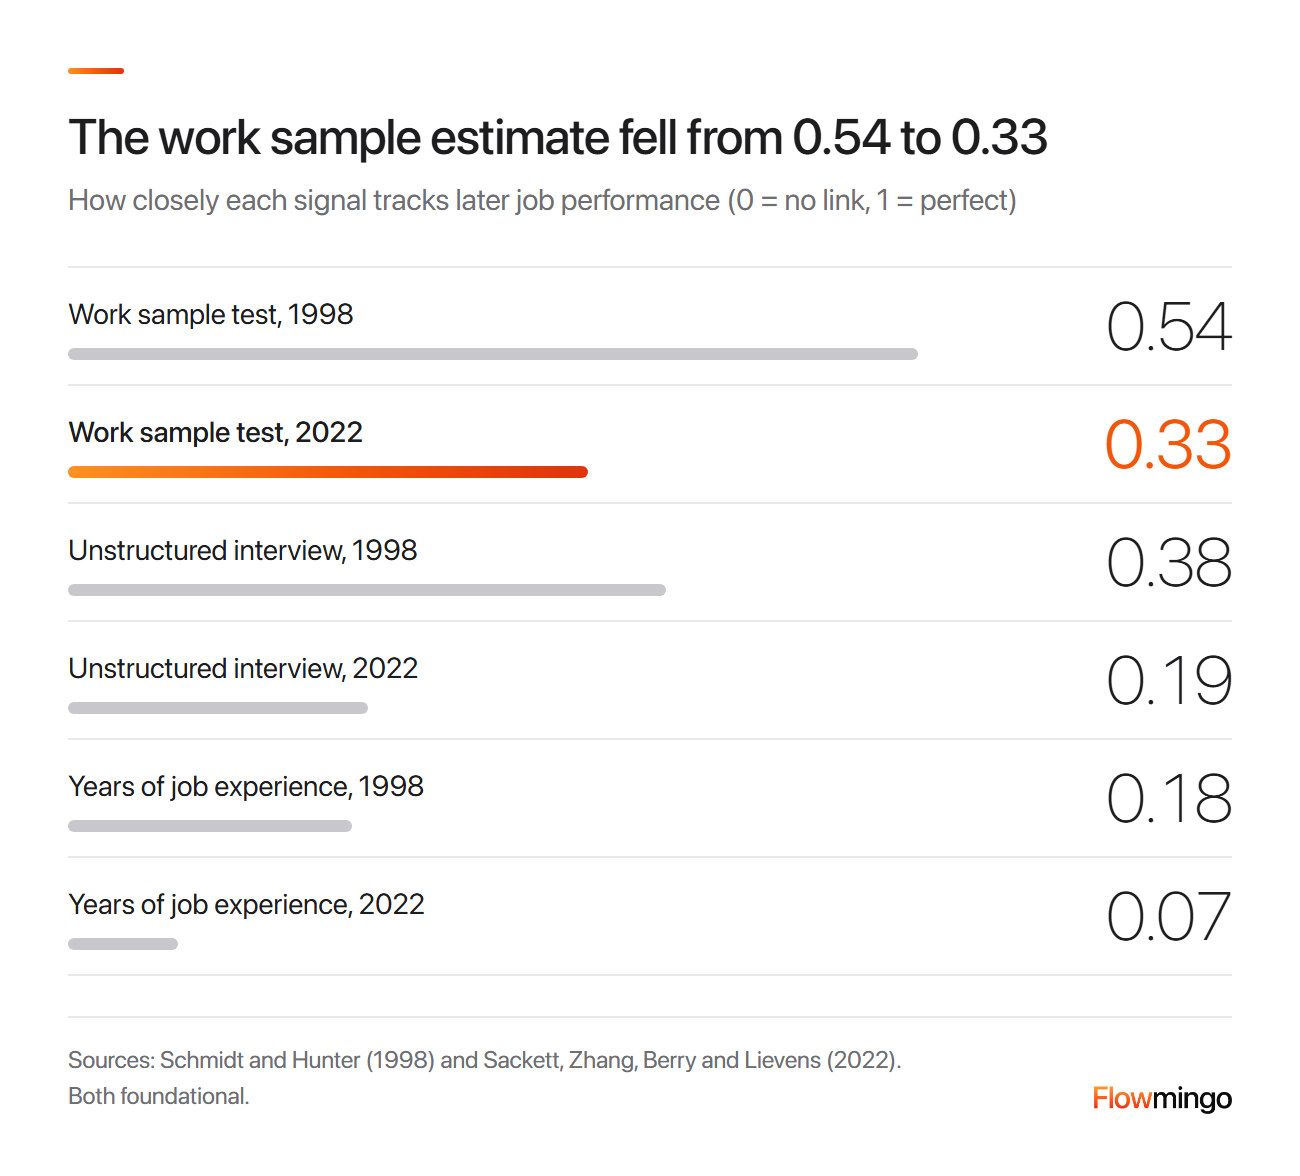
ワークサンプル推定値の推移:1998年の0.54から、2022年の基礎的な再分析では0.33へ。非構造化面接は0.38から0.19に、職務経験年数は0.18から0.07に低下した。
Flowmingoがどのように役立つか
Showcaseはワークサンプルテストです。候補者は自分の都合のよい時間に画面を共有し、各タスクを録画します。最大10件のタスクを設定でき、合計時間はFreeで20分、Starterで30分、GrowthとScaleで60分が上限です。より長いタスクは共有ドキュメントで実施してください。
4.1 候補者が自宅課題テストでChatGPTを使っています。何を変えるべきですか?
マネージャーたちは、r/ExperiencedDevsやr/recruitingで、AIが書いた自宅課題の回答について報告している。どれほど一般的かについての研究は見つからなかった。
私たちの実務では、3つの変更が有効です。タスクを時間制限付きのセッションとして実施し、候補者に1つの選択、たとえばなぜ最初に14行目にフラグを立てたのかを説明してもらいます。毎回タスクを変更し、流出した回答が役に立たないようにします。
5. 2名のレビュアーが同じ候補者について一致するように、ワークサンプルをどう採点すればよいですか?
各スキルを、高・中・低の回答の文章で示された例と照らして個別に採点し、まず2名のレビュアーが別々に作業します。比較し、2点以上の差があれば話し合い、文書化された理由がある場合にのみ点数を変更し、その後平均して合計します。
説明用の例であり、顧客データではありません:セクション3の請求書タスクのルーブリック。
| 基準 | 5 | 3 | 1 |
|---|---|---|---|
| 正確さ | 3つの誤りをすべて見つけ、それぞれがどのように起きたかを示す | 2つの誤りを見つける | 0または1つしか見つけない、または正しい行を変更する |
| メモの明確さ | 同僚が各メモに基づいて行動できる | 正しいが、疑問を生じさせる | 曖昧または欠けている |
| 優先順位付け | どの誤りが最も重要か、その理由を示す | 誤りを順不同で列挙する | 示さない |
レビュアーを2人使う。Huffcuttらによる2013年の基礎的なメタ分析では、同じ面接を視聴したパネル評価者の一致度は0.74だったのに対し、別々の面接では0.44だった。
私たちはそれを類推してワークサンプルに適用する。スコア1は完全な一致を意味するが、一致は正確さではないため、この指標はパネルを実際よりよく見せる。
| 候補者 | 評価者1(正確さ、明確さ、優先順位付け) | 評価者2 | 話し合うべき差 | 合意した合計(15点満点) |
|---|---|---|---|---|
| A | 5, 4, 3 = 12 | 4, 4, 3 = 11 | なし | 11.5 |
| B | 3, 4, 2 = 9 | 5, 3, 2 = 10 | 正確さ、3対5 | 9.5 |
2点以上の差は、両方の評価者の目の前に解答を置いて話し合い、スコアを変えるのは書面の理由がある場合だけにする。差が残る場合は、差が1の場合と同様に両スコアを平均し、その後、基準を等しい重みで合計する。Bでは正確さが3と5のままで平均4だったので、4 + 3.5 + 2 = 9.5。
誰かを招く前にルーブリックを書き、可能なら評価者から名前と履歴書を隠し、合計で順位付けする。上位の一群を、固定の合格点ではなく、面接に割ける時間に合わせた人数で選ぶ。下のカードは、スコアがどれほど広くばらつくかを示すために、ワークサンプルではなくFlowmingoの多肢選択式スキルテストを使用している。
Flowmingoデータ · 最後まで完了したスキルテスト受験227件 · 225名の候補者 · 28社 · 開始 2026年8月25日〜9月30日
- 65%がスコアの中央値(無回答は誤答として計算)。
- 31%から86%がスコアの第10パーセンタイルから第90パーセンタイルの範囲で、第25パーセンタイルは46%、第75パーセンタイルは77%だった。
多肢選択式スキルテストは自動採点で、制限時間は主に20分または30分、ワークサンプルではない。スコアは正答した問題の割合であり、候補者が知っていたことの下限を示すもので、異なるテスト間でまとめたもの。Flowmingo自身の組織、デモ、練習、採用担当者自身のチーム、および2社の非常に大規模な顧客は除外している。
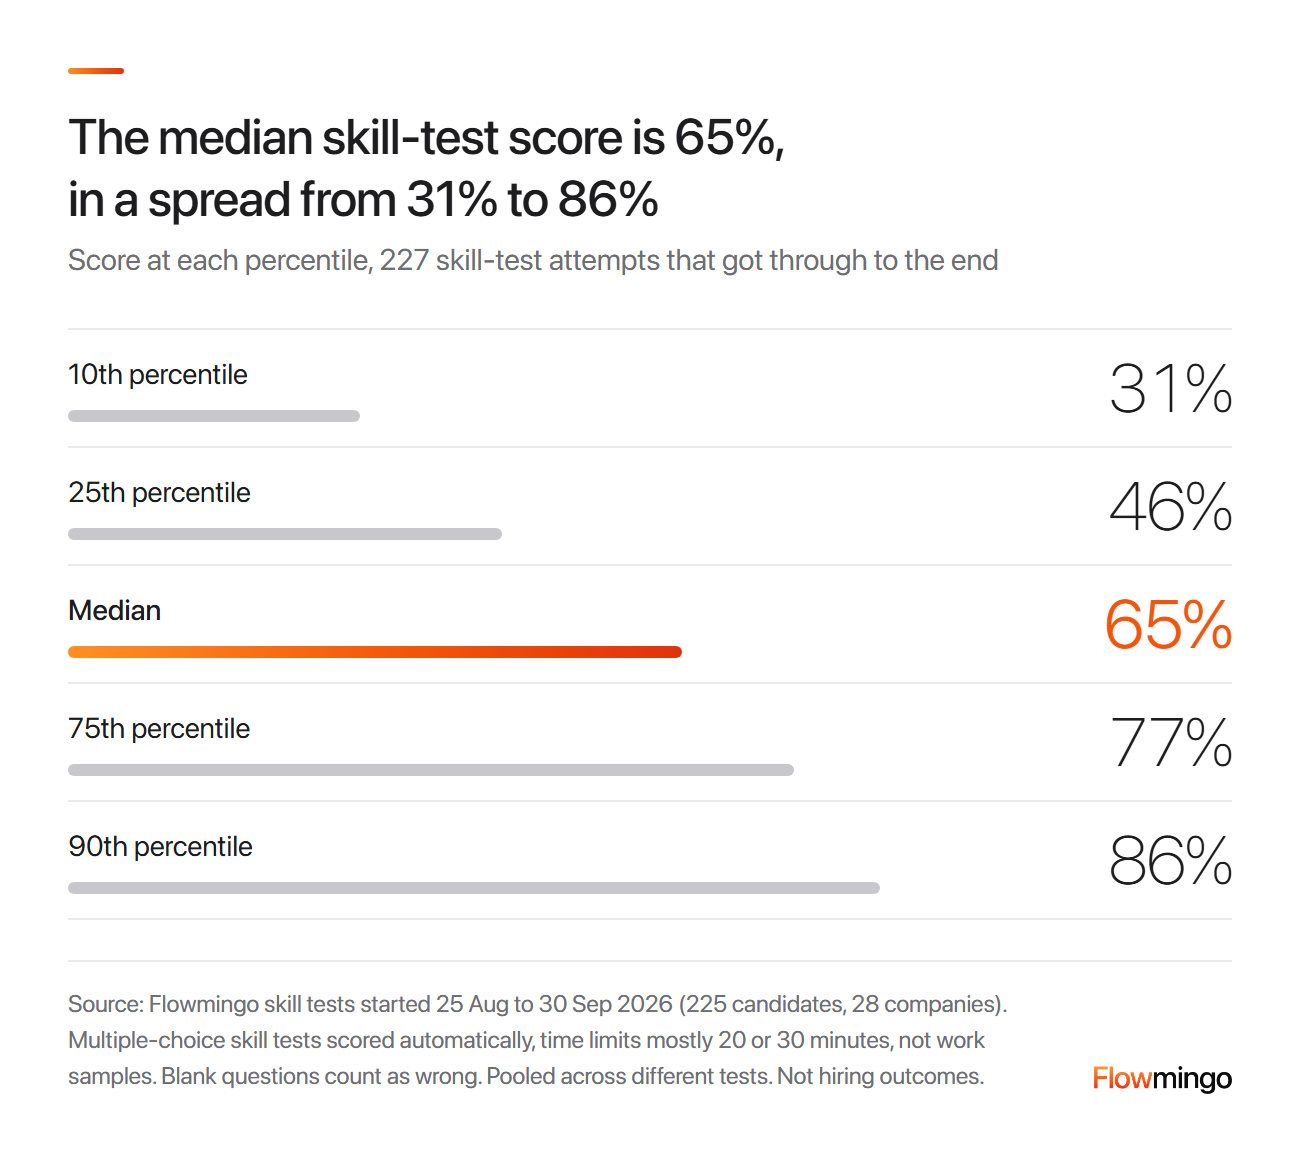
多肢選択式スキルテストのスコア分布:中央値65%、第10パーセンタイルは31%、第90パーセンタイルは86%(Flowmingoデータ、完了した受験227件、2026年、ワークサンプルではない)。
完了した受験者のうち、22.9%が80%以上、18.9%が40%以下だった。異なるテスト間でスコアがこれほど広くばらつくため、固定の合格点では、より優れた候補者ではなく、より簡単なテストが報われることになる。
5.1 自分にないスキルはどう評価すればよいですか?
判断できないものは採点できないため、模範解答を借りる。その仕事に長けた人に、候補者に会う前にタスクと1、3、5の例を書いてもらう。たとえば、会計士ならシートに3つの誤りを仕込み、優れたメモが何を述べるかを書くことができる。
6. スキルテストは優秀な候補者を遠ざけてしまうのか? 候補者の時間はどの程度なら妥当なのか?
私たちが見つけた最大規模の研究では、長さだけが人を遠ざけたわけではありませんでしたが、2025年のベンチマークでは、時間を軽んじられたことが辞退理由の首位でした。所要時間を明示し、必要な分だけを求め、すべての候補者に結果を送りましょう。
2017年の基礎的な研究では、69の選考システムにまたがる222,772名の求職者を対象に、評価全体の長さは離脱を予測しませんでした。辞めた応募者の大半は最初の20分以内に辞めていました。より長い所要時間の見積もりを示したシステムでは、失う人が少なくなりました。
2025年のCandEベンチマークでは、辞退した候補者の32%が、面接や予定が自分の時間を軽んじていたと答えました。このベンチマークの候補者のうち、評価やテストの結果についてフィードバックを受けたのはわずか6%でした。候補者調査ソフトウェアを販売するSurvaleが、現在このベンチマークを実施・公開しています。
Flowmingoデータ · 293件のスキルテスト受験 · 287名の候補者 · 38社 · 2026年8月25日から9月30日に開始
- 受験の77.5%(227件)がテストの最後まで到達しました。
- 受験の9.6%は未完了で、5.5%は回答が記録された状態で制限時間がゼロになった時点で終了し、5.1%は回答が記録されないまま終了し、2.4%は回答ありで別の形で終了しました。
多肢選択式のスキルテストを自動採点したもので、制限時間は主に20分または30分で、ワークサンプルではありません。企業を単位とすると、77.5%は65%から85%の範囲です。人数ではなく受験回数です。5.1%の一部は記録取得の失敗である可能性があります。Flowmingo自身の組織、デモ、練習実行、採用担当者自身のチーム、および2社の非常に大規模な顧客は除外しています。
これらは多肢選択式テストであるため、30〜45分のワークサンプルではなく、短時間の制限付きテストでの行動を示しています。回答が記録されないまま終了した少数の受験は、辞める人は早く離れるというHardyの知見に当てはまるかもしれません。
タイマーがゼロになるのは主に、フラグが立てられた行動に対して時間が差し引かれたためであり、テストが長すぎたことを示すものではありません。結果の日付を7日以内に明示しましょう。そのベンチマークでは候補者のわずか6%しか評価やテスト結果についてフィードバックを受け取っていないからです。
報酬と離脱に関する研究は見つかりませんでした。私たちの実践は、明示した枠内で過去に解決済みの課題を用いることであり、それより長い場合や実際の業務には報酬を支払うというものです。
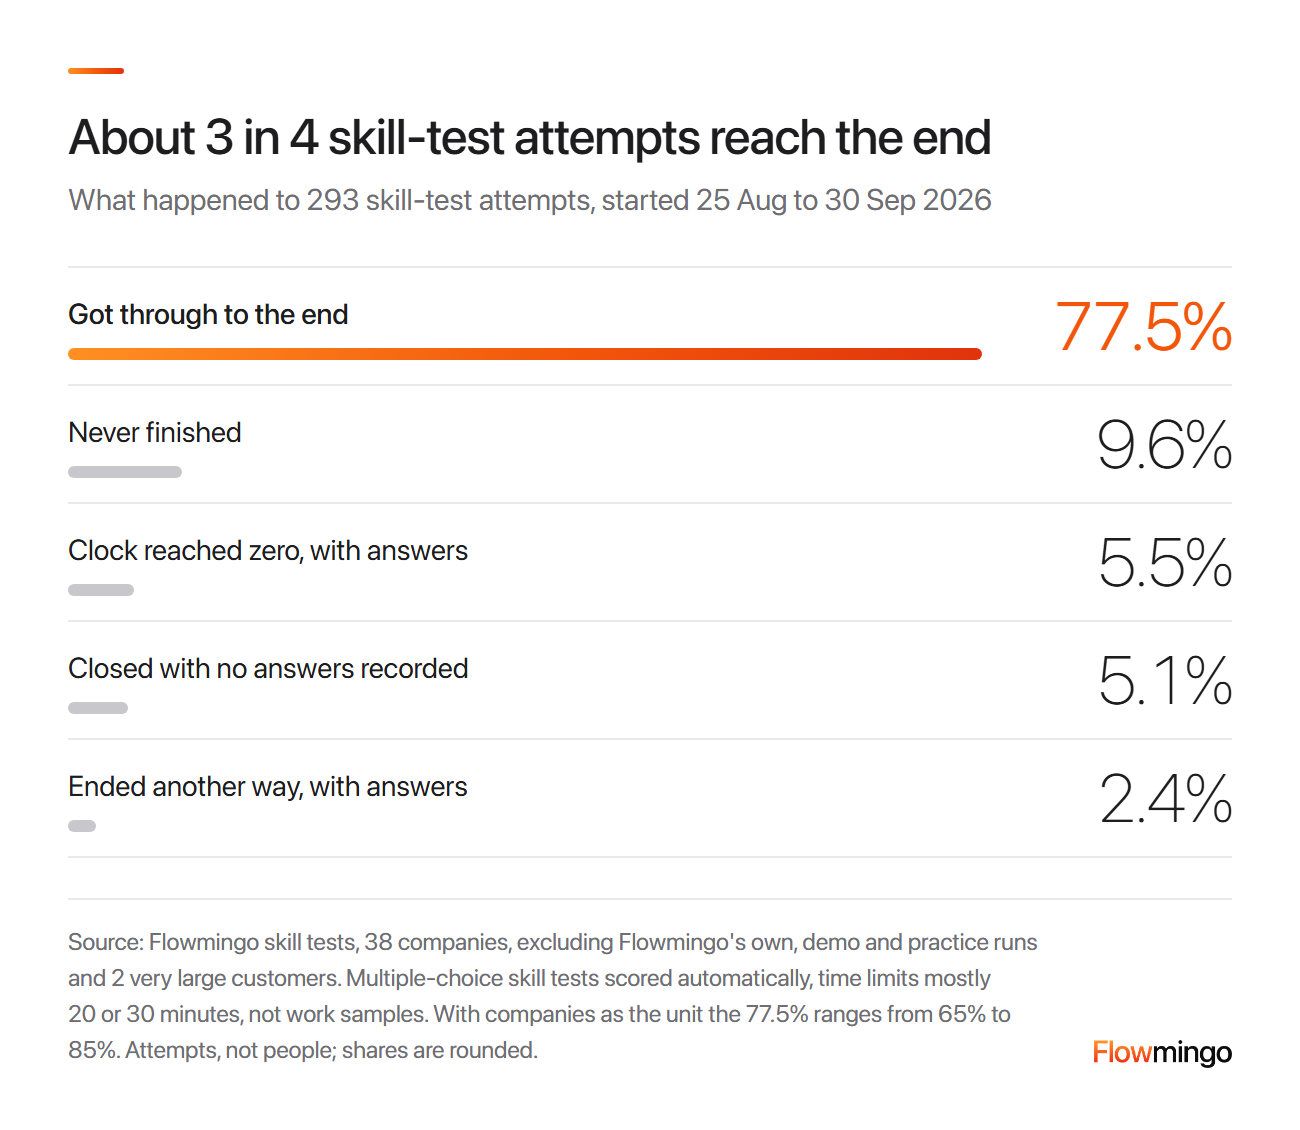
スキルテスト受験の結果:293件の多肢選択式受験のうち、77.5%が最後まで到達し、9.6%は未完了で、5.5%はタイマーがゼロになった時点で終了しました。
6.1 短いテストは履歴書による絞り込みに代われるのか?
短いテストは、スキルの証明として履歴書に代わることはできますが、最初の関門にはなりません。第2節で述べているように、最初の面接後に残った4人程度をテストしましょう。
7. スキルベース採用はより公平ですか、それともテストは年齢の高い応募者や障害のある応募者を排除してしまいますか?
自動的にそうとは限りません。スキルベース採用でもグループを排除してしまうことがあるため、各選考ラウンドでグループ別に結果を確認してください。
Rothらによる2008年の基礎的なメタ分析では、ワークサンプルテストにおいて黒人と白人の応募者の間に0.73標準偏差の差があることが見出されました。これは通常引用される0.38の約2倍で、0は差がないことを意味します。
認知スキルと職務知識スキルを評価する課題は0.80だったのに対し、対人スキルは0.21~0.27でした。データは米国の応募者のみを対象としています。
私たちの解釈では、課題が何を評価するかによって差の大きさが変わります。たとえば、英文を書く必要がほとんどない職務では、文章作成の比重が高い課題はスキルよりも言語能力を測ってしまいます。
Mobley v. Workdayでは、2025年5月16日に裁判所が、40歳以上の応募者による年齢差別の集団訴訟の予備的認証を認めました(Holland & Knight)。Workdayは本案に理由がないと主張しており、これはソフトウェアベンダーに関する件で、スキルテストに関するものではありません。
英国では、Acasは合理的配慮を行う必要があると述べており、面接に来る人すべてに合理的配慮が必要かどうかを尋ねる必要があります。当社の面接招待メールのテンプレートには、コピーして使える一文を示しています。面接の形式について尋ね、健康状態については決して尋ねないでください。
8. 応募者が30人しかいない場合、スキルテストの不利益影響をどう確認すればよいですか?
各グループの合格率を最も高いグループの合格率で割り、80%未満のものに注目します。応募者が30人では、ほとんどのグループが小さすぎて判断できません。そのため、フラグが立った場合はテストを精査する理由にはなりますが、バイアスの証明にはなりません。
グループ区分は、採点者が決して見ない任意の機会均等フォームから得られます。地域の規則、たとえば英国とEUのデータ保護法では、尋ねることが制限される場合があるため、まず確認してください。「合格」は、次の選考段階に進んだ上位層に入っていることを指すものとします。
1978年の基礎となるUniform Guidelinesが米国の規則を定めており、29 CFR 1607.4(D)では、4/5(80%)を下回る比率は一般に不利益影響の証拠とみなされます。より小さな差でも該当し得ますし、数が少ない場合にはより大きな差でも該当しないことがあります。
同ガイドラインは人種、性別、民族グループを明記しているため、年齢や障害については、この比率を大まかな警報としてのみ使用してください。
たとえば、グループAの10人中5人、グループBの10人中3人がワークサンプルに合格したとします。比率は60%で、フラグに該当します。しかしフィッシャーの正確検定では p = 0.65 となり、その程度の差は偶然に約3回中2回生じることを意味します。
100人中50人 対 100人中30人では、比率は同じで、私たちの計算では p = 0.006、1,000回中約6回です。
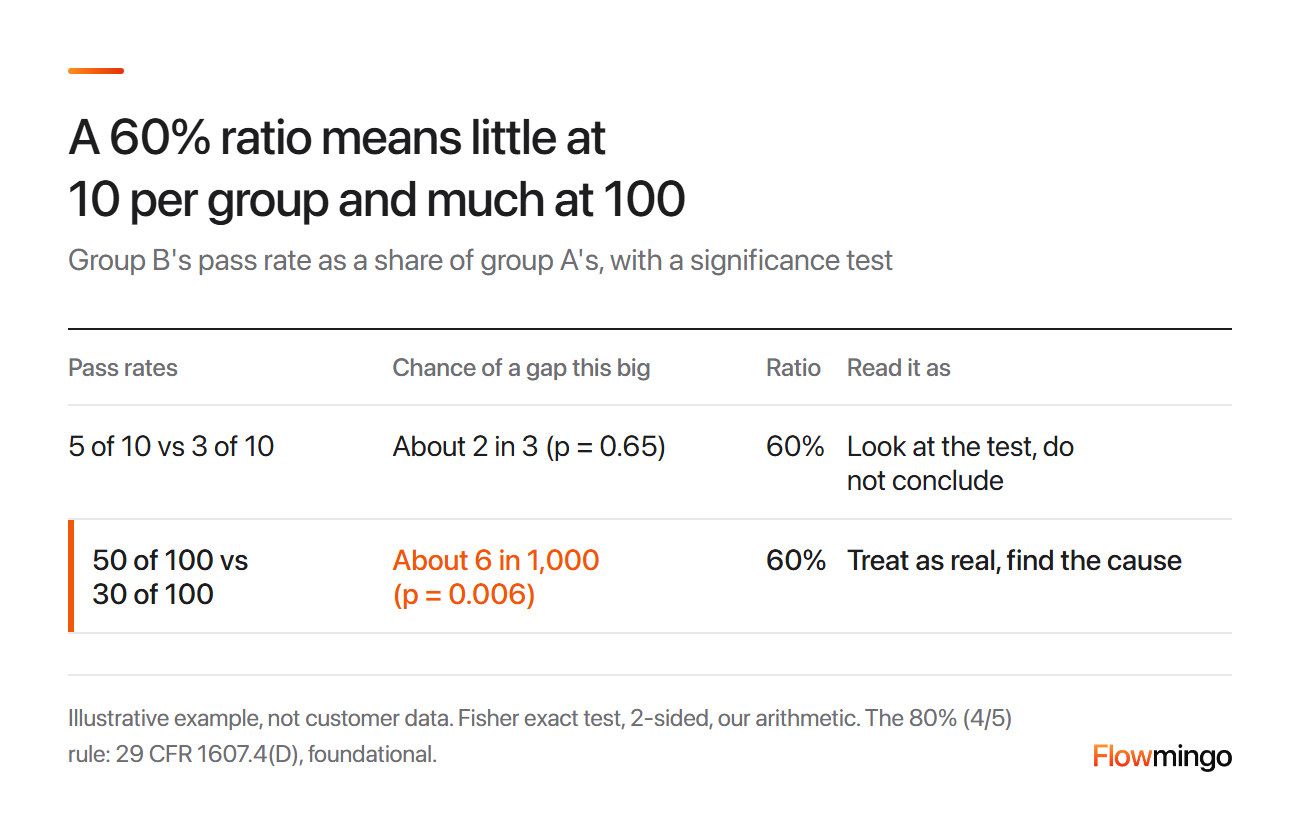
説明用の合格率チェック:どちらの差も比率は60%で、80%のラインを下回ります。各グループ10人の場合は検定結果を見て、結論を出さないこと。100人の場合は実際の差として扱い、原因を突き止めること。
毎回6つの記録を残します:日付入りのスキル一覧、タスク、評価基準、各スコア、グループ別の合格率、および例外適用の理由です。
8.1 80%ルールは現在も米国で適用されますか?
2026年10月4日時点で、80%ルールは依然としてeCFRに残っています。2026年6月の司法省の見解と2026年7月のOPM規則は、いずれも連邦機関をガイドラインから遠ざける方向に動かしています。
EEOCは2026年11月の撤回を一覧に載せていますが、まだ公表されていません。
それでも、上記の6つの記録は残してください。
9. シンガポールの職場公正法と英国の平等法は、私たちのスキルテストにとって何を意味しますか?
英国の平等法は、保護対象グループに不利益をもたらすあらゆるテストについて、正当性を説明することを求めています。シンガポールの三者間ガイドラインはすでに、応募者が確認できる職務関連の基準を求めています。また、2027年末を目標とする同国の法は、申立ての仕組みを追加します。
これは一般的な情報であり、法的助言ではありません。
| 地域 | 規則 | スキルテストにとっての意味 |
|---|---|---|
| 英国 | 2010年平等法、第19条および第60条、Acas | テストには比例性が求められる。障害のある応募者には調整を行う |
| シンガポール | 職場公正法(MOM)、2027年末を目標 | 採用が対象。申立ては最大S$250,000 |
従業員25人未満の企業は、2024年11月のファクトシートでは当初免除されていたため、最終的な法律を確認してください。ガイドラインでは、学位、関連分野での3年の経験、特定のスキルを、職務に関連するものであれば要件として認めています。
したがって、シンガポールではスキルベース採用は義務ではありませんが、書面化したスキルリストが証拠になります。英国では、合格基準が保護対象グループに不利益を与え、正当な目的に比例しない場合、間接差別になります。
9.1 ソフトウェアがテストを採点する場合、AI採用関連法は適用されますか?
チームが手作業で採点するワークサンプルは、EUのAI規則の対象外です。AIで候補者を採点または順位付けするツールは対象外ではありません。なぜなら附属書IIIが、人材の採用または選考に使用されるAIを高リスクとして扱っているからです。
EU、カリフォルニア、ニューヨーク市、イリノイ州については、当社の候補者の絞り込みガイドをご覧ください。
10. スキルベース採用に評価ソフトウェアは必要ですか、それとも共有ドキュメントで十分ですか?
1つの職種なら、共有ドキュメントとスプレッドシートで十分です。最終候補者やレビュー担当者がシートに収まらなくなり、採点を代行してほしい場合に、ソフトウェアの出番があります。
たとえば、最終候補者4人と採点者2人なら、管理する項目が少ないため1枚のシートに収まります。この表は当社の判断であり、調査に基づくものではありません。
| 必要なもの | ドキュメントとシート | ソフトウェアが役立ち始めるのは |
|---|---|---|
| スコア | 採点者ごと・評価基準ごとに列を設けた1枚のシート | 最終候補者や採点者がシートに収まらなくなる |
| グループチェック | 第8節のフォームと現地ルールの確認を用いて、ラウンドごとにグループ別の合格者数を集計 | 職種をまたいで毎ラウンド必要になる |
1日で採点できる数を超える最終候補者がいる場合、またはレビュー担当者が2人を超える場合に、ソフトウェアは役立ちます。それまでは、全員がすべてのスコアを確認できるため、シートのほうが準備が速く、説明も簡単です。
評価ソフトウェアを購入する前に、予算権限を持つチームリードがこう質問しました。
当社を含め、どのベンダーにも次の6つの質問をしてください。
- スコアはどのように算出されますか?
- 各回答を正答と並べて確認できますか?
- 候補者について何が記録されますか?
- バイアスはどのように検証されますか?
- データはどこに保存され、どのくらいの期間保持されますか?
- 候補者1人につきいくら支払いますか?
スキルベース採用は、3つのアクションと1つのチェックに集約されます。スキルリストを作成し、最終候補者全員に同じテストを受けてもらい、それを書面で採点し、その後グループ別の合格率を確認します。
Flowmingoがどのように役立つか
Flowmingoは採用担当者向けの無料AI面接官です。テストは多肢選択式のため、業務サンプルではなく職務知識を確認するものであり、Freeを含むすべてのプランで無制限に利用できます。各結果では、すべての回答が正答と並べて表示されます。ショーケースは業務サンプルであり、AIではなくあなたのチームが採点します。開発者職種では、テクニカルテストが候補者の書いたコードをテストケースに対して実行し、採点します。次回のスキルベース採用でFlowmingoをお試しください。
11. 出典
このガイド内のすべての調査、法律、アンケートは下記の出典にリンクしています。Flowmingoの数値はFlowmingo自身のプラットフォームデータに基づいています。
- Acas(2026年6月30日)。差別法の遵守:採用。Acas。
- Burning Glass Institute, & Harvard Business School Managing the Future of Work(Sigelman, M., Fuller, J., & Martin, A.)(2024年2月)。スキル基準の採用:宣言から実践への長い道のり。Burning Glass Institute。
- Equal Employment Opportunity Commission and others(1978年)。従業員選抜手続きに関する統一ガイドライン、29 CFR 1607.14:妥当性研究の技術基準。eCFR。
- Equal Employment Opportunity Commission and others(1978年)。従業員選抜手続きに関する統一ガイドライン、29 CFR 1607.4:影響に関する情報。Legal Information Institute。
- EU人工知能法 [ウェブサイト](n.d.)。附属書III:第6条(2)に言及される高リスクAIシステム。Future of Life Institute。
- Hardy, J. H., Gibson, C., Sloan, M., & Carr, A.(2017年)。応募者はより長い評価を途中でやめやすいのか?評価の長さが応募者の離脱行動に与える影響の検討。Journal of Applied Psychology, 102(7), 1148-1158。
- Holland & Knight(2025年5月27日)。連邦裁判所、AI採用バイアス疑惑をめぐる集団訴訟を認める。Holland & Knight LLP。
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S.(2013年)。採用面接の信頼性:構造と形式別の新たなメタ分析推定値。International Journal of Selection and Assessment, 21(3)。
- Kaplan-Moss, J.(2021年11月17日)。優れたワークサンプルテストの枠組み:公正なテストのための8つのルール。jacobian.org。
- Legislation.gov.uk(2010年)。2010年平等法 第19条:間接差別。UK Parliament。
- Legislation.gov.uk(2010年)。2010年平等法 第60条:障害と健康に関する照会。UK Parliament。
- シンガポール労働省(2024年11月12日)。職場の公平性法案(第一読会)に関するファクトシート。MOM。
- シンガポール労働省(2025年11月4日)。職場の公平性(紛争解決)法案 プレスリリース。MOM。
- 米国司法省法律顧問室(2026年6月9日)。Title VIIに基づく不均衡影響責任の合憲性。DOJ。
- Office of Personnel Management(2026年7月31日)。連邦人事規則における従業員選抜手続きに関する統一ガイドラインへの参照の削除。Federal Register, 91 FR 48234。
- Quinones, M. A., Ford, J. K., & Teachout, M. S.(1995年)。職務経験と職務遂行の関係:概念的およびメタ分析レビュー。Personnel Psychology, 48(4)。
- Roth, P. L., Bobko, P., McFarland, L., & Buster, M.(2008年)。人事選抜におけるワークサンプルテスト:総合スコアと課題スコアにおける黒人と白人の差に関するメタ分析。Personnel Psychology, 61(3)。
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F.(2022年)。人事選抜における妥当性のメタ分析推定値の再検討:範囲制限に対する系統的な過剰補正への対処。Journal of Applied Psychology。
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F.(2023年)。広く用いられる予測因子の妥当性に関する新たな知見を踏まえた選抜システム設計の再検討。Industrial and Organizational Psychology。
- Schmidt, F. L., & Hunter, J. E.(1998年)。人事心理学における選抜方法の妥当性と有用性:85年にわたる研究成果の実務的および理論的含意。Psychological Bulletin, 124(2)。
- SHRM, & SHRM Foundation(2025年)。スキル優先運動:組織の採用と成長のあり方を再定義する。SHRM。
- Survale(2026年7月21日)。2025年候補者体験(CandE)ベンチマーク調査:主要統計。Survale(CandEプログラムは2011年にTalent Boardによって創設され、現在はSurvaleの一部)。
- Tripartite Alliance for Fair and Progressive Employment Practices(2023年)。公正な雇用慣行に関する三者ガイドライン。TAFEP。
- Uhlmann, E. L., & Cohen, G. L.(2005年)。構築された基準:差別を正当化するための能力の再定義。Psychological Science, 16(6)。
- ワシントン州財務管理局(n.d.、Wayback Machineスナップショット2026-04-18)。スキル基準の採用。Washington State OFM。