3 intervjuare, 1 finalist, 3 utlåtanden. Utan en intervjumall väljer den starkaste rösten i din återkoppling vem som anställs.
Det finns inget kandidatutvärderingsformulär att gå tillbaka till. Därför kan ingen förklara erbjudandet för din VD, eller för en avvisad kandidat som frågar.
Utan ett gemensamt formulär faller upptagna människor tillbaka på magkänsla.
Och magkänsla är svagare än den känns, vilket Noise av Kahneman och hans medförfattare visar.
Säg att allt du vet är att 1 kandidat gjorde bättre ifrån sig på intervjun än en annan. Chansen att de verkligen är den bättre anställningen är bara 56 % till 61 %, knappt bättre än att singla slant.
En intervjumall löser detta i 3 steg. Varje intervjuare bedömer samma 4 till 6 kompetenser mot skriftliga exempel, enskilt, före återkopplingen. Sedan avgör summan, om inte ett minimikrav inte uppfylls.
Viktiga slutsatser
- Leder en intervjumall verkligen till bättre anställningar? Ja, om varje intervjuare bedömer samma kompetenser mot skriftliga exempel. Intervjuer som genomförs på detta sätt förutsade arbetsprestation ungefär dubbelt så bra som fria intervjuer i en granskning från 2022.
- Hur många kompetenser bör den bedöma? 4 till 6, var och en på en skala från 1 till 5 med ett skriftligt exempelsvar per nivå. Varje minimikrav under 3 innebär ingen anställning.
- Hur väljer jag mellan 2 finalister som får samma poäng? Kontrollera minimikraven först, gå sedan igenom varje 2-mot-5-skillnad utifrån bevis. Rösta inte om på magkänsla: en fast formel slog expertbedömning i en granskning från 2013.
- Hur många intervjuare behöver jag? Upp till 4, var och en som bedömer enskilt. I Googles egna data tillförde varje intervju efter den 4:e mindre än 1 % i träffsäkerhet.
- Kan jag lita på AI-poängen? Använd den som 1 underlag och läs dess motiveringar. I en studie från 2023 följde en AI-bedömare utbildade mänskliga bedömare nära på välbekanta frågor och dåligt på nya.
1. Hjälper en intervjumall mig faktiskt att välja bättre anställningar?
Ja, när varje intervjuare bedömer samma kompetenser mot skriftliga exempel. Strukturerade intervjuer, där du ställer samma frågor och bedömer alla på samma sätt, förutspådde arbetsresultat med 0,42, mer än dubbelt så mycket som de 0,19 för ostrukturerade.
Siffrorna kommer från Sackett och kollegors grundläggande omanalys från 2022 av decennier av rekryteringsforskning.
Siffrorna är korrelationer, från 0 (ingen koppling till senare arbetsresultat) till 1 (en perfekt koppling). Så 0,19 betyder inte att ostrukturerade intervjuer väljer rätt 20 % av gångerna. Det betyder att deras koppling till senare resultat är svag.
Diagrammet nedan rangordnar 6 vanliga metoder. Arbetskunskapstester på 0,40 och keyed biodata, ett poängsatt bakgrundsfrågeformulär, på 0,38 kommer tätt efter.
Arbetsprover följer på 0,33 och kognitiva förmågetester på 0,31. Ostrukturerade intervjuer, det fria samtalet som de flesta av oss vuxit upp med, kommer sist.
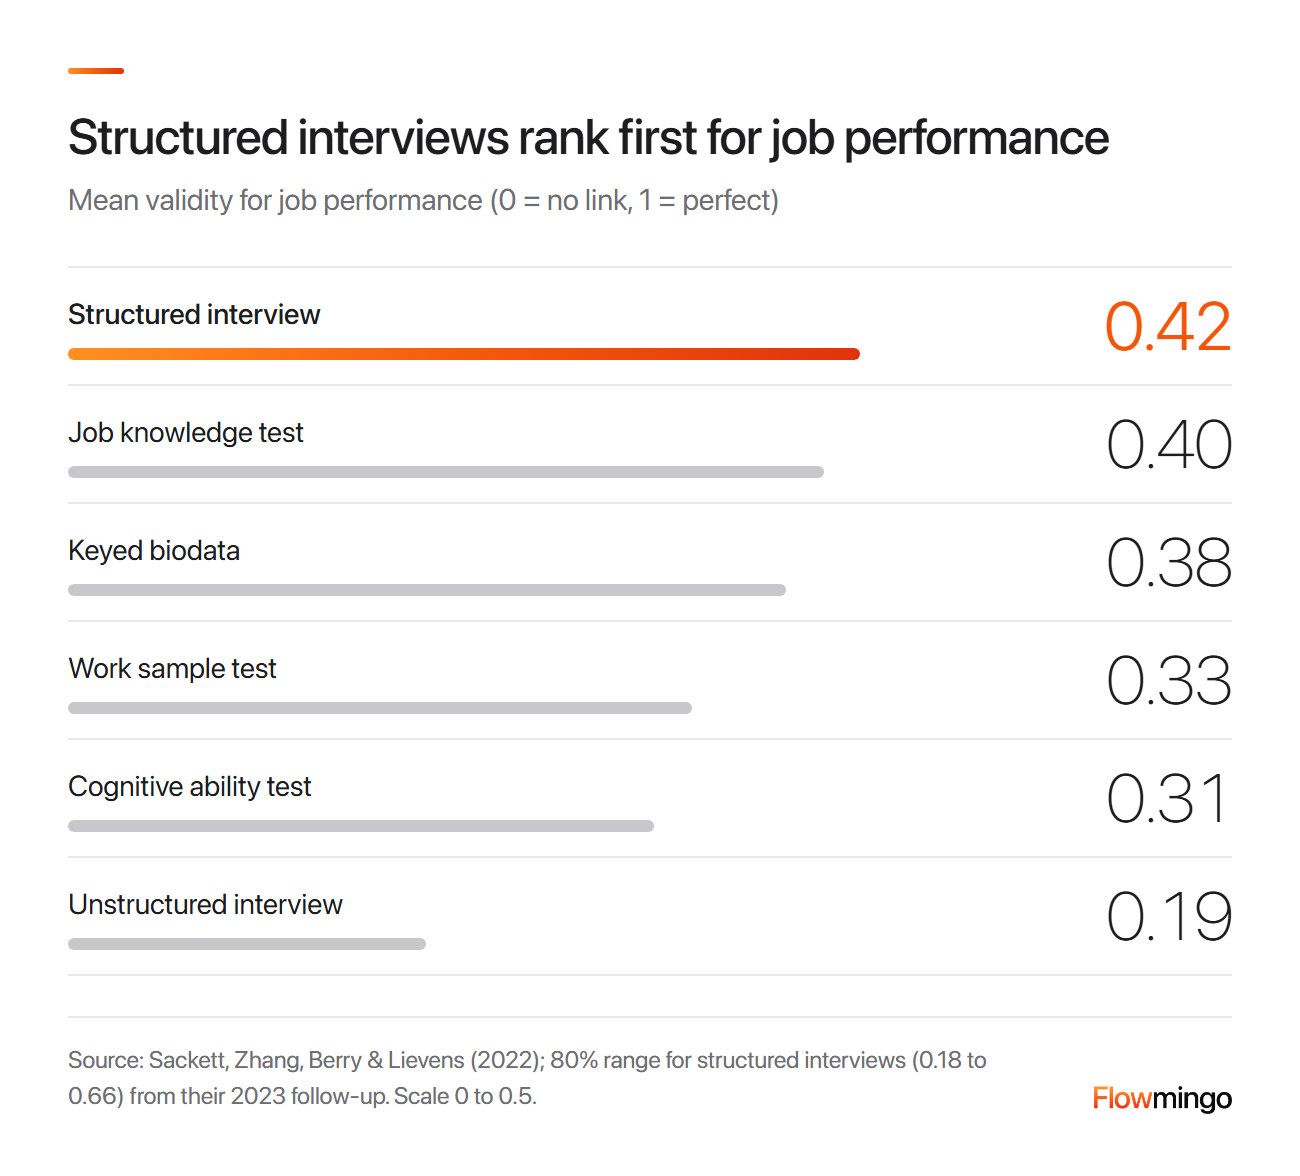
Rekryteringsmetoder rangordnade efter koppling till arbetsresultat: strukturerade intervjuer leder med 0,42, ostrukturerade intervjuer ligger sist med 0,19 (grundläggande om analys av Sackett et al.).
Men 0,42 är ett genomsnitt. Författarnas uppföljning placerar de flesta strukturerade intervjuer mellan 0,18, inte bättre än ett fritt samtal, och 0,66, bättre än något annat i diagrammet.
Utformningen är 1 av 3 anledningar som författarna anger till spridningen. Det betyder att ett intervjupoängkort med vaga kompetenser riskerar att hamna nära botten. Detta är genomsnitt över många arbetsgivare, inte ett löfte om din nästa anställning.
2. Vad bör min mall för intervjupoängkort innehålla?
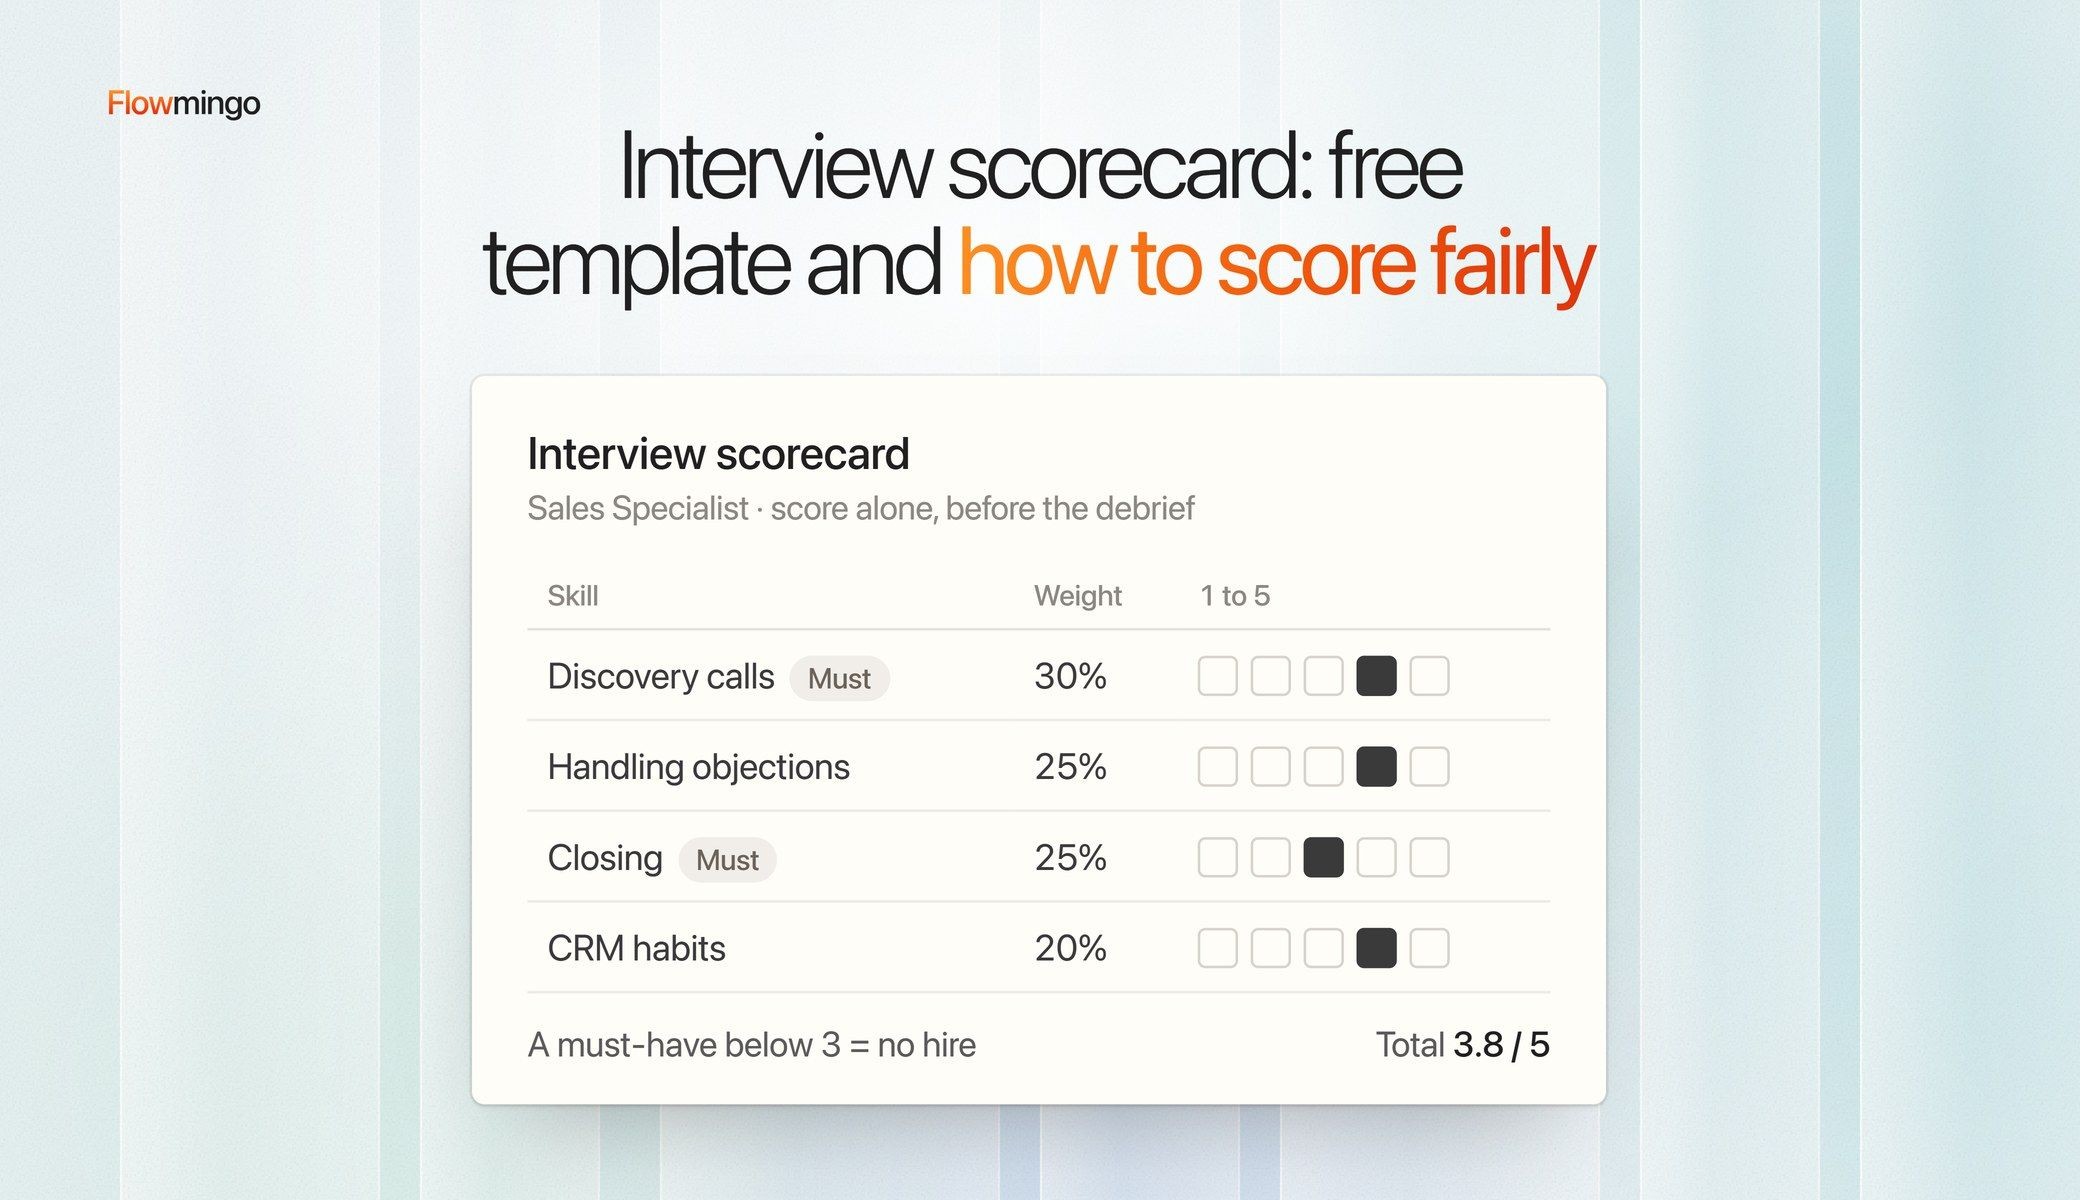
En mall för intervjupoängkort, eller kandidatutvärderingsformulär, innehåller 5 kompetenser, skriftliga ankare, en evidensruta och en måste-ha-gräns, allt på 1 sida. Den avslutas med ett helhetsintryck och en rekommendation.
Ankarna gör att 1 intervjudares 4 betyder samma sak som en annans, och evidensrutan svarar på "varför" när din vd frågar.
Golvet hindrar en stark totalsumma från att dölja ett svagt måste-krav. Helhetsintrycket kommer sist, eftersom en magkänsla som skrivs först färgar varje kompetenspoäng efter den.
Här är det formuläret för en teamledare inom kundsupport, med 2 måste-krav. Var och en av de 5 kompetenserna poängsätts 1 till 5, så totalsumman är av 25.
Ställ 2 frågor om tidigare beteende per kompetens, eftersom ett verkligt exempel från det förflutna ger dig något konkret att hålla mot ankarna. Till exempel: "Berätta om den senaste gången en upprörd kund eskalerade till dig."
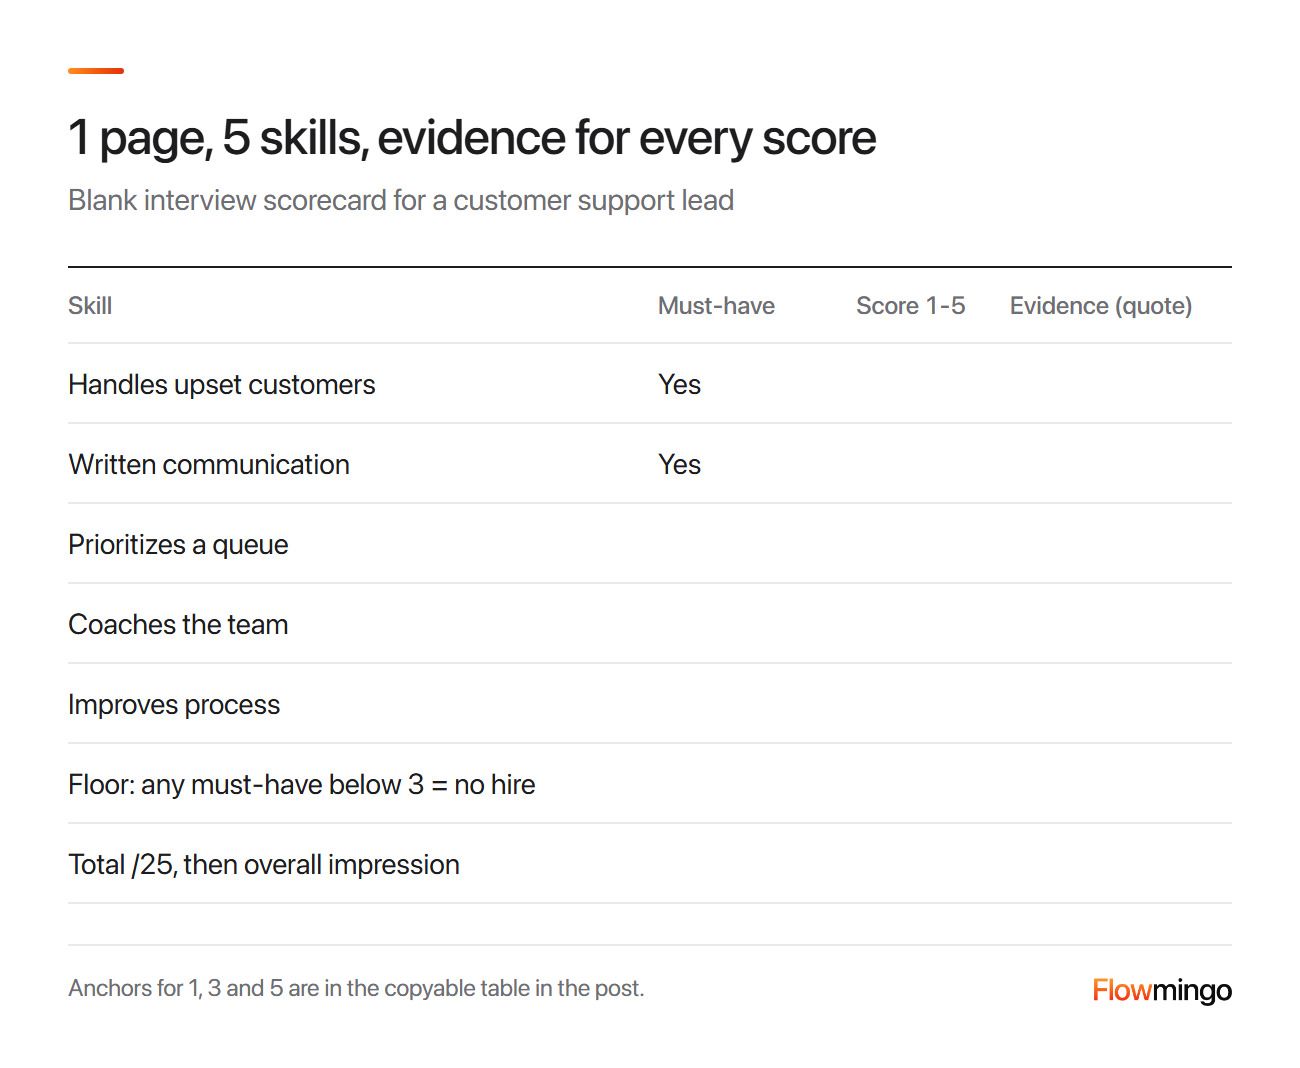
Tom mall för intervjubedömningskort för en teamledare inom kundsupport: 5 kompetenser, 2 måste-krav, en poäng från 1 till 5 och ett bevis-citat för varje.
Kopiera tabellen och byt sedan ut mot dina egna kompetenser och ankar.
| Kompetens | Ankar för 1 / 3 / 5 | Poäng 1-5 | Bevis (citat) |
|---|---|---|---|
| Sidhuvud | Kandidat, roll, intervjuare, datum | ||
| Hanterar upprörda kunder (måste-krav) | Skuldbelägger kunden / tillämpar policy / åtgärdar orsaken | ||
| Skriftlig kommunikation (måste-krav) | Otydlig / tydlig men lång / kort och tydlig | ||
| Prioriterar en kö | Ingen metod / efter brådska / efter effekt | ||
| Coachar teamet | Inget exempel / ger tips / sätter en plan | ||
| Förbättrar processer | Inget exempel / föreslår en åtgärd / levererar en åtgärd | ||
| Golv för måste-krav | Varje måste-krav under 3 innebär ingen anställning | ||
| Poängsätts inte | Känslor avlästa från ansikte, röst eller skrivande; accent eller tempo om inte jobbet kräver det; "kulturell passform" | ||
| Totalsumma | Summan av 5 poäng, av 25 | ||
| Helhetsintryck | 1 till 5, fylls i sist | ||
| Rekommendation | Stark anställning / anställning / ingen anställning / starkt nej till anställning; ett åsidosättande kräver en skriftlig anledning |
2.1 Vad bör jag bestämma innan jag bygger det?
Definiera framgång i rollen först och välj sedan de kompetenser som levererar den. Lås intervjubedömningskortet innan det första CV:t kommer in.
Den ordningen kommer från Who, av Geoff Smart och Randy Street. Skriv 1 mening om uppdraget, sedan 3 till 8 resultat rangordnade efter betydelse, sedan 4 till 6 kompetenser. Ett resultat är ett mätbart utfall, som att öka intäkterna från 25 miljoner dollar till 50 miljoner dollar år 3, inte en aktivitet.
Att frysa kriterierna spelar roll eftersom människor böjer dem utan att märka det. I de grundläggande studierna av Uhlmann och Cohen (2005) bedömde deltagarna en gatuvan och en högutbildad sökande till posten som polischef.
Vilken styrka mannen än hade beslutade de att jobbet behövde den mer, och kvinnan fick ingen sådan förstärkning. Att bestämma sig för kriterierna innan man ser de sökande tog bort den snedvridningen. Så ett bedömningskort som skrivs efter att du träffat kandidater kan tyst böja sig mot den du redan gillar.
2.2 Bör kulturpassning finnas med på bedömningskortet?
Inte som det är formulerat, för ingen kan bedöma det på samma sätt två gånger. Gör om det till 1 eller 2 observerbara beteenden, till exempel "ber om feedback på sitt eget arbete".
Säg att ditt team värderar öppenhet: bedöm i stället "gav ett specifikt exempel på att ha flaggat ett misstag tidigt".
3. Hur viktar jag intervjubedömningar så att måstekraven väger tyngst?
Ge varje färdighet lika stor vikt och lägg till en måstekravsgräns, eller fastställ vikterna före den första intervjun. Lika vikter förutsäger ofta nya fall lika bra som vikter anpassade till tidigare data.
Den andra punkten kommer från psykologen Robyn Dawes, så som Kahneman sammanfattar det i Tänka, snabbt och långsamt.
Vikter som är anpassade till dina tidigare anställningar lär sig också den gruppens tillfälligheter. Säg att dina 3 bästa supportanställningar råkade vara starka coacher: en anpassad vikt skulle gynna coaching hos varje framtida kandidat.
Lika vikter kan inte jaga en sådan tillfällighet, vilket är varför de ofta förutsäger nya kandidater precis lika bra. Håll också färdigheterna oberoende av varandra, som Kahneman råder: lista inte både "kommunikation" och "presentationsteknik", för tillsammans räknar de samma sak två gånger.
Ett måstekrav får sin kraft från gränsen, inte från en större vikt. Säg att "Hanterar upprörda kunder" får 2 och alla andra färdigheter får 5.
Summan 22 av 25 ser utmärkt ut, men gränsen säger ändå ingen anställning. Det är vad du vill ha för en färdighet som jobbet inte klarar sig utan.
Om du viktar ska du skriva ner vikterna på intervjubedömningskortet i förväg och tillämpa dem på alla. Det stänger den enklaste vägen till att böja en summa: att ändra vikterna efter att du träffat någon du gillar.
Hur Flowmingo hjälper till
Flowmingos AI-intervjurapport använder fasta vikter: ett måstekriterium räknas 4 gånger ett bra-att-ha-kriterium i den totala poängen. Varje kriterium behåller sin egen poäng från 0 till 10, så du kan fortfarande tillämpa en måstekravsgräns själv.
4. Hur gör jag så att en 3:a betyder samma sak för varje intervjuare?
Skriv ner vad ett svar som får 1, 3 och 5 innehåller för varje kompetens, innan den första intervjun. En sådan beteendeanknuten bedömningsskala gör två intervjuares poäng jämförbara.
"Beteendeanknuten" betyder helt enkelt att varje poäng knyts till vad kandidaten gjorde, inte till en känsla som "ganska bra". Utan ankare betyder en 3:a på samma intervjumall "okej" för en intervjuare och "svag" för en annan.
Ankrade intervjuer visar också starkare genomsnittliga samband med senare prestation. Taylor och Smalls grundläggande genomgång av 19 studier om intervjuer om tidigare beteende fann ett samband på .35 med ankrade skalor, mot .26 utan. Studierna skilde sig även på andra sätt, så den här jämförelsen isolerar inte effekten av att lägga till ankare.
Här är intervjubedömningsskalan för måste-kompetensen "Hanterar upprörda kunder".
| Poäng | Vad svaret innehåller |
|---|---|
| 1 | Skuldbelägger kunden; ingen egen åtgärd och inget resultat |
| 3 | Ett verkligt exempel: lugnar kunden och tillämpar policyn, men följer aldrig upp resultatet |
| 5 | Ett verkligt exempel: hittar orsaken, åtgärdar den, följer upp och delar lösningen |
Varje steg uppåt är något du kan höra i svaret. Det är därför två lyssnare kan landa på samma siffra.
Om du ännu inte kan skriva ankare kan du låna de fem nivåerna i guiden för strukturerade intervjuer från OPM, den amerikanska federala HR-myndigheten. Var och en kretsar kring hur svår situationen var och hur mycket vägledning personen behövde.
- 1, Medvetenhet: de enklaste situationerna, med nära och omfattande vägledning.
- 2, Grundläggande: något svåra situationer, med frekvent vägledning.
- 3, Medel: svåra situationer, med enstaka vägledning.
- 4, Avancerad: betydligt svåra situationer, med lite eller ingen vägledning.
- 5, Expert: exceptionellt svåra situationer, där personen vägleder andra.
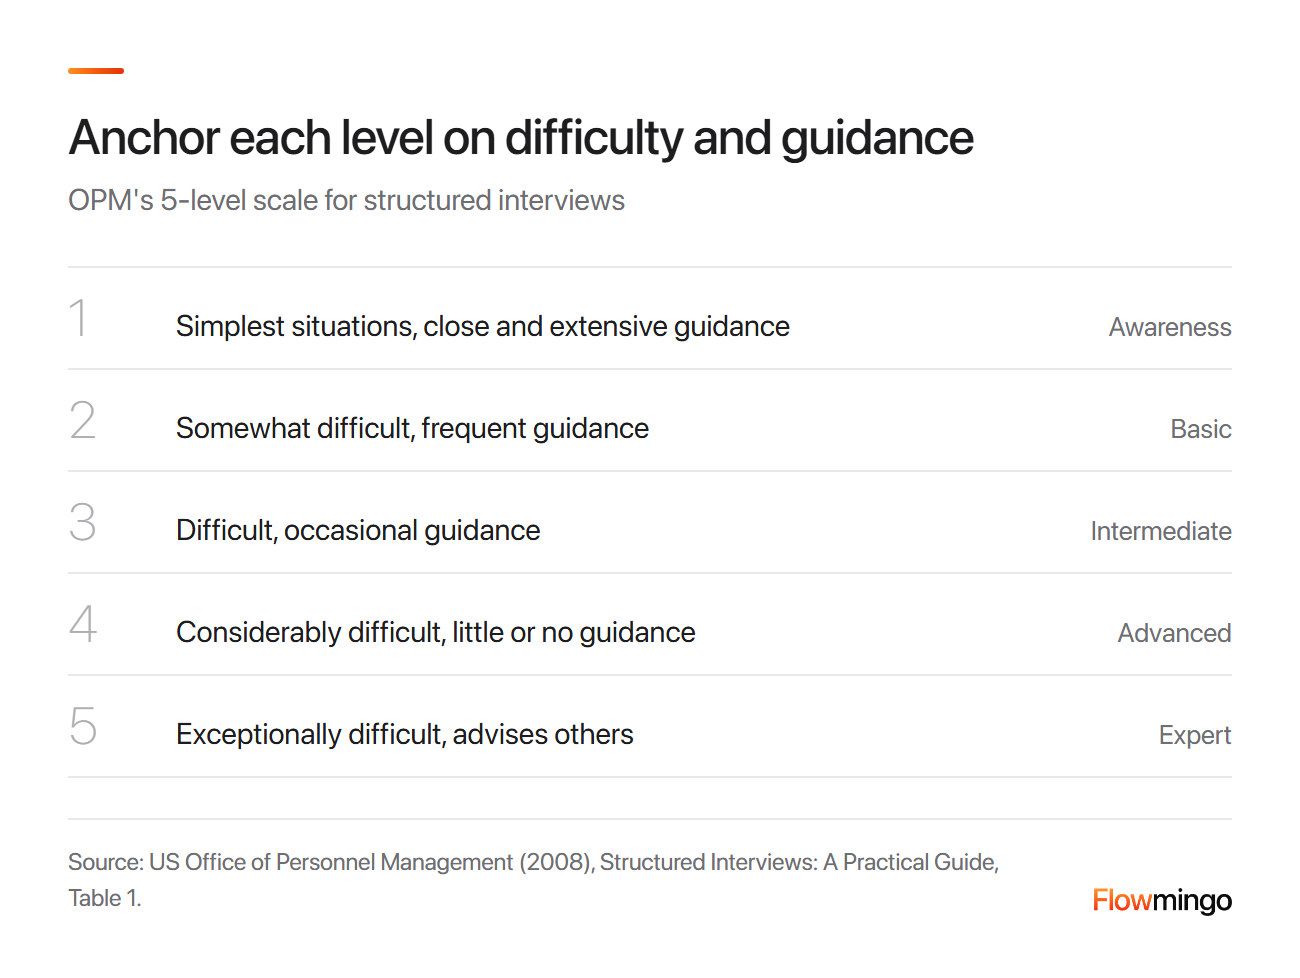
OPM:s 5 bedömningsnivåer för strukturerade intervjuer: från Medvetenhet (enklaste situationerna, nära vägledning) till Expert (exceptionellt svåra situationer, vägleder andra).
5. Hur väljer jag mellan 2 starka finalister när mina intervjuare inte är eniga?
Låt intervjuscoringens total avgöra, med 2 undantag: ett måste-krav under 3, eller en 2-mot-5-splittring, som ni följer upp med avstämning utifrån bevis. Rösta inte om på känsla.
Det här är ögonblicket som scoringskort finns till för, och ögonblicket då det är som mest frestande att hoppa över dem. Här är ett illustrativt exempel, inte kunddata: 3 finalister för supportledarrollen, varje cell ett medelvärde över 3 intervjuare.
| Förmåga | A | B | C |
|---|---|---|---|
| Hanterar upprörda kunder (måste-krav) | 4 | 2 | 4 |
| Skriftlig kommunikation (måste-krav) | 4 | 4 | 3 |
| Prioriterar en kö | 3 | 4 | 3 |
| Coachar teamet | 3 | 4 | 4 (betyg 2, 5, 5) |
| Förbättrar processer | 4 | 4 | 3 |
| Totalt, av 25 | 18 | 18 | 17 |
| Beslut | Anställ | Anställ inte: golvet slår till | Stäm av splittringen |
Läs intervjuscoringen rad för rad. A och B delar 18 av 25. Men B fick 2 på ett måste-krav, så golvet slår till och B är inte aktuell för anställning.
C har totalt 17, men C:s medelvärde på 4 för "Coachar teamet" döljer en splittring: 1 intervjuare gav 2, och de andra 2 gav 5. Den klyftan blir den enda punkten på avstämningens agenda.
I praktiken: be varje sida läsa upp sina beviscitat. Säg att den som gav lågt betyg hörde om en teammedlem som slutade, och att de andra hörde om en coachningsplan som fungerade. Avstämningen avgör vilken berättelse som är mer typisk för C, och alla som missade bevis ändrar sitt betyg skriftligt.
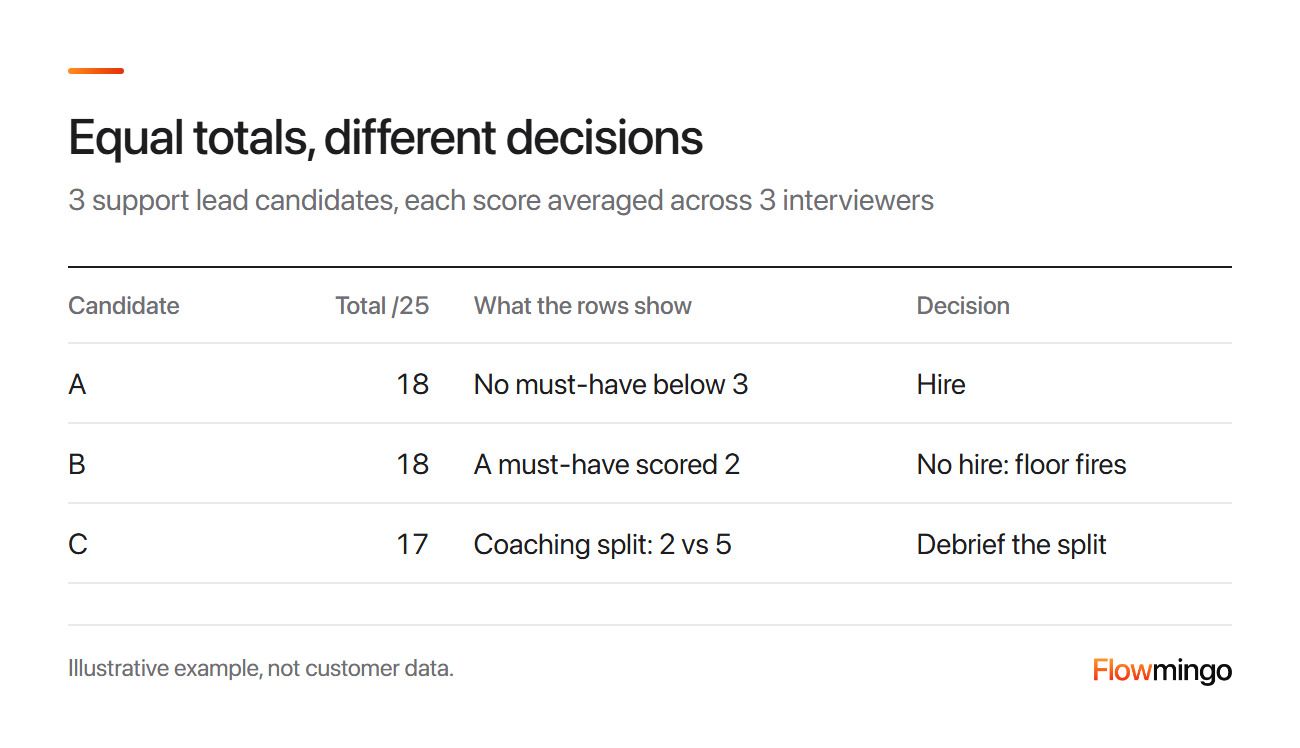
Ifylld intervjuscoring, illustrativ: A och B delar 18 av 25, B missar ett måste-krav, och C har en coachningssplittring att stämma av.
När betygen har utsett en finalist, skriv in villkoren i erbjudandet innan du skickar det: vår mall för jobberbjudande visar var varje kontroll hör hemma.
5.1 Vad gör jag om magkänslan säger en sak och betygen en annan?
Gå på betygen om du inte kan skriva ner bevisen de missade. I Kuncel och kollegors grundläggande metaanalys från 2013 förutspådde en formel som tillämpades likadant på alla arbetsprestation med 0,44, mot 0,28 för holistiskt omdöme. Författarna kallar det en förbättring av prediktionen med över 50 %, även mot experter som kände till jobbet.
Holistiskt omdöme innebär att människor väger samma fakta i huvudet, inklusive konsensusmöten. Så avstämningen fyller bevisluckor och röstar inte om.
5.2 Bör jag jämföra finalister sida vid sida?
Ja, svar för svar. Bohnets HBR-råd är att jämföra alla svar på fråga 1, sedan fråga 2, så att du bedömer varje svar mot de andra.
I en grundläggande laboratoriestudie från 2016 lutade personer som såg 1 kandidat i taget mot det kön som uppgiftens stereotyp gynnade. Tidigare prestation spelade knappt någon roll. När de såg 2 sida vid sida valde de den högpresterande 54 % av gångerna och den lägrepresterande 8 %.
Studien använde tidigare uppgiftspoäng, inte intervjuer, så behandla den som en stark antydan snarare än bevis.
6. Hur hindrar jag att den som hörs mest vinner utvärderingen?
Låt varje intervjuare lämna in sitt bedömningsformulär innan någon pratar, och inled sedan utvärderingen med poängen.
Säg att en senior person inleder med "jag älskade henne", och rummet börjar drifta mot den bilden. Poäng som skrivs ner enskilt skyddar alla från den dragningen, vilket är varför Noise gör oberoende poängsättning till en anställningsregel.
I praktiken samlar du in poäng i ett delat kalkylblad eller i ditt ATS och avslöjar dem alla på en gång.
En panel, där alla ser samma intervju, ser ut som en lösning. I Huffcutt och kollegors grundläggande metaanalys från 2013 var panelbedömare överens i 0,74, mot 0,44 för separata intervjuer, på en skala från 0 till 1.
Den siffran smickrar paneler. Panelmedlemmar bedömer alla samma prestation samma dag, så om kandidaten hade en ovanligt bra eller dålig morgon ser de alla det.
Som Iris Bohnet uttryckte det i ett föredrag på Google: "the sample size of a panel interview is basically one". Separata intervjuer, var och en bedömd enskilt, ger dig fler oberoende intryck.
6.1 Hur många intervjuare bör bedöma varje kandidat?
Upp till 4, i separata intervjuer. I Googles interna data, inte en peer-reviewed studie, förutsade 4 intervjuer anställningsbeslutet med 86 % säkerhet. Varje extra intervju tillförde mindre än 1 %.
Extra intervjuer tillförde lite för att förutsäga Googles eget anställningsbeslut. Använd det som en påminnelse att motivera varje omgång, inte som ett universellt maximum eller bevis om framtida jobbprestation.
7. Hur får jag upptagna intervjuare att faktiskt fylla i intervjubedömningen?
Gör bedömningen till en del av intervjun. Betygsätt varje färdighet direkt efter dess frågor, skriv ett enradigt citat som bevis och ge det övergripande intrycket sist.
Ingen vill ha ännu ett formulär efter en dag av intervjuer. Därför sker bedömningen inne i intervjun, inte som läxa för ikväll.
Kahneman byggde den här metoden för israeliska armén 1955, efter att fria intervjuer visat sig nästan oanvändbara för att förutsäga framgång. Intervjuarna betygsatte 6 egenskaper på en skala från 1 till 5 och avslutade varje innan de började med nästa, så att ett första intryck inte kunde färga resten.
Först då blundade de och gav en övergripande bedömning, och summan förutsade mycket mer träffsäkert än tidigare. Hans råd: anställ den med högst summa, "även om det finns en annan som du gillar bättre".
Tidpunkten spelar också roll. I en fältstudie rapporterade 166 intervjuare när de hade bestämt sig. Endast 4,9 % av besluten fattades under den första minuten, men 22,5 % kom efter att intervjun hade avslutats.
Ett beslut som fattas efter att kandidaten har gått vilar på minnet, så bedöm medan du går.
För vår supportlead ser det ut så här:
- Ställ de 2 köfrågorna och bedöm sedan "Prioriterar en kö" innan du går vidare.
- Skriv 1 citat som bevis, till exempel "Jag sorterar buggar efter hur många kunder de påverkar."
- Håll samma färdighetsordning för varje kandidat.
Skriftliga bevis är sällsynta i vår data.
Flowmingo-data · 86 638 AI-intervjuade kandidater · 2 574 företag · juli 2025 till sep 2026
- 0,3 % av de AI-intervjuade kandidaterna fick en skriftlig kommentar från rekryteringsteamet (258 av 86 638).
Team kan föra anteckningar någon annanstans; i Flowmingo är AI-rapporten vanligtvis den enda skriftliga bedömningen i akten.
En skriftlig motivering är det första som prioriteras bort en stressig dag. Därför ber formuläret om bara 1 citat per kompetens.
8. Kan jag lita på en AI-poäng på mitt intervjuprotokoll?
Använd den som 1 underlag som en människa granskar, och läs motiveringarna först. AI-bedömning kan falla kraftigt på frågor den inte har tränats på.
Vi har ett egenintresse i detta svar, så underlaget nedan inkluderar den del som inte smickrar AI.
I en grundläggande studie från 2023 bedömde 2 tränade granskare 7 017 svar från sökande på en förankrad skala från 1 till 5. En modell tränad på samma frågor matchade deras poäng nära, 0,75 på en skala från 0 till 1. På frågeformat den aldrig hade sett föll den till 0,30, en svag matchning.
Detta innebär att en AI-poäng bara är så bra som sin frågespecifika bedömningsmall, så läs motiveringarna innan du litar på siffran. Notera också att 3 av studiens 5 författare arbetade hos AI-intervjuleverantören Modern Hire.
Så hjälper Flowmingo till
Flowmingos AI-intervjuare poängsätter utifrån kriterier du godkänner. AI tar fram frågorna och kriterierna från din jobbannons, och du redigerar båda. Du skickar intervjun till varje sökande att göra när det passar dem.
Du får tillbaka inspelningen, transkriptionen och varje kriterium bedömt 0 till 10 med en skriftlig motivering. Du fattar anställningsbeslutet.
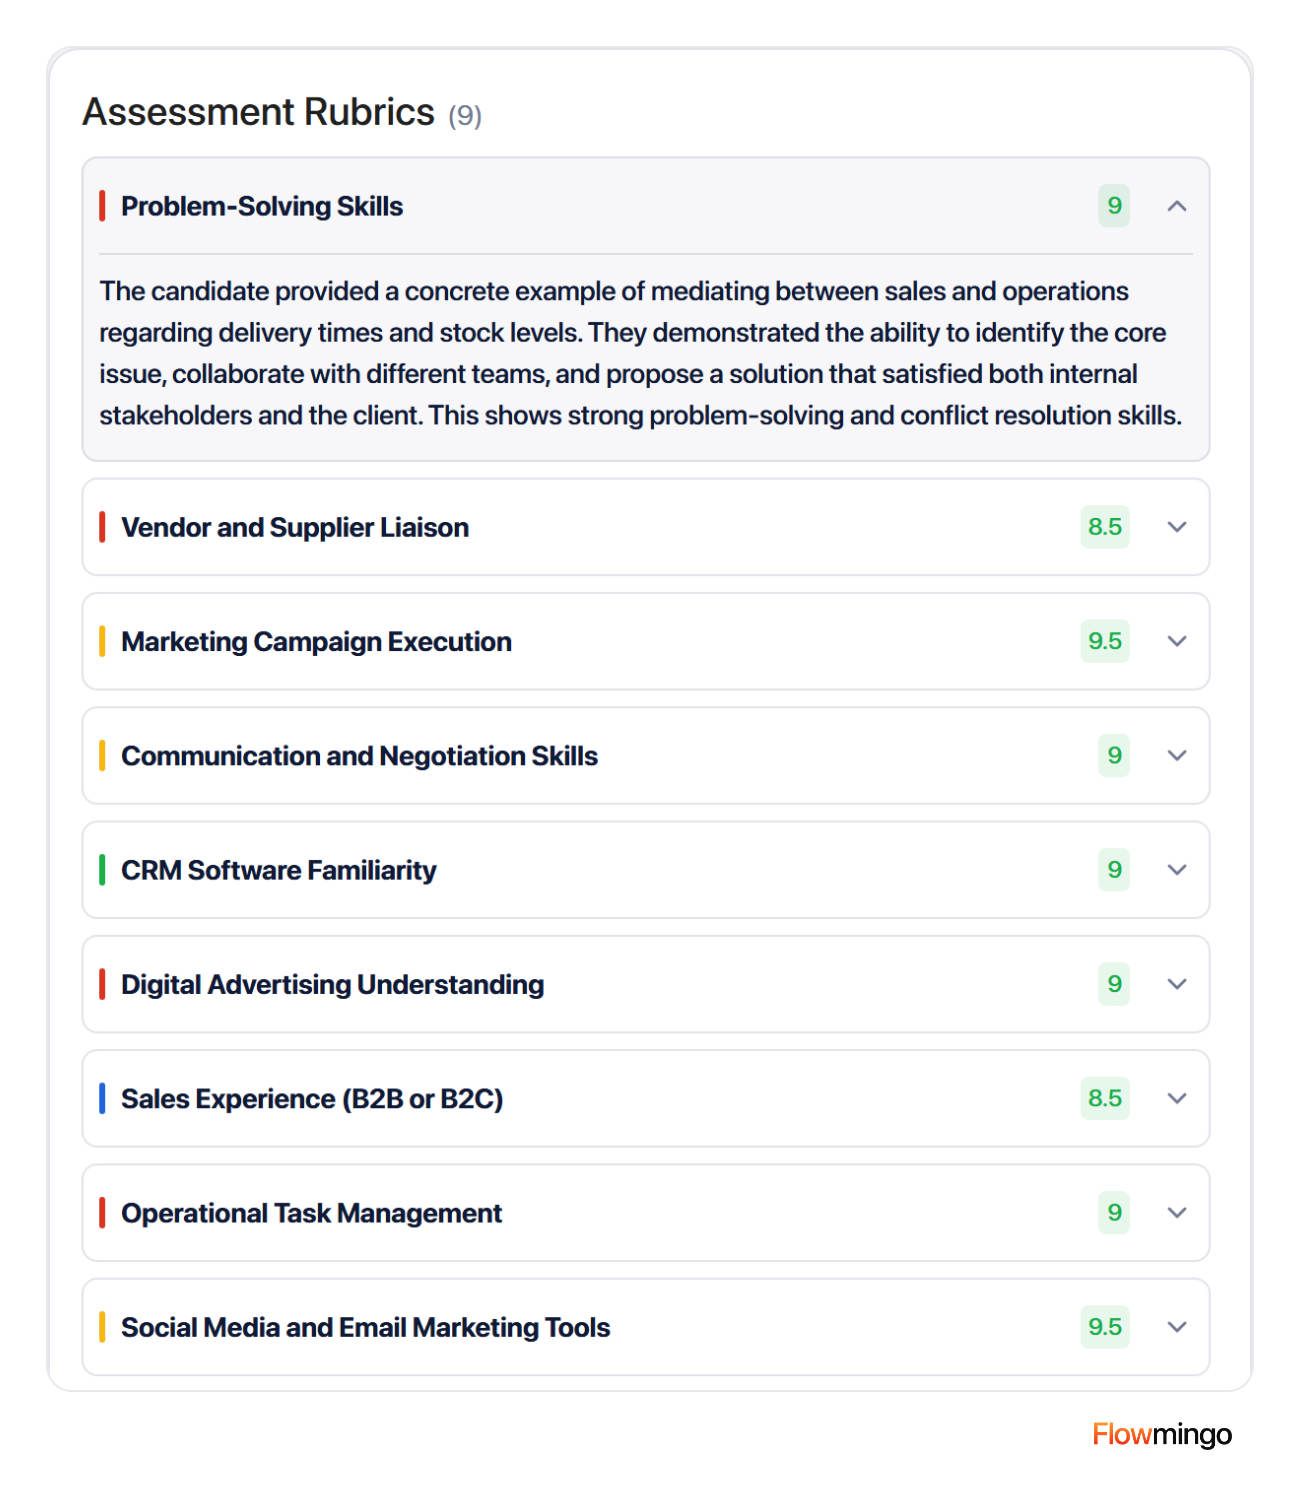
Flowmingos offentliga exempelrapport: en poäng från 0 till 10 och motivering per kriterium, så sätt eventuell miniminivå på den skalan.
I vår data är CV:t och intervjun inte heller överens om vem som är bäst.
Flowmingo-data · 34 114 kandidater · 379 företag · juli 2025 till sep 2026
- 19,2 % av 532 projekt med 1 tydlig toppnotering i intervjun gav också den kandidaten toppnoteringen i CV:t.
- 54,9 % av de 3 684 kandidater som fick 8 eller mer i intervjun (2 022) skulle ha sållats bort av en topp-20 %-CV-kortlista.
Båda är Flowmingo-AI-poäng, inte arbetsprestation, och de intervjuade är en selekterad grupp. Datan visar att de 2 rankningarna skiljer sig, inte vilken som är rätt.
Enkelt uttryckt: i ungefär 4 av 5 av dessa projekt hade den som fick högst poäng i intervjun inte också högst CV-poäng. Så betygsätt intervjun för sig, i stället för att låta CV-poängen följa med.
9. Skyddar mina bedömningsmallar mig om en avvisad kandidat klagar?
De hjälper, om de betygsätter jobbrelaterade bevis och du behåller dem. Vid en rimlig tolkning innebär amerikanska federala regler att bedömningsmallar ska behållas i minst 1 år, och Kaliforniens regler i 4 år.
Ett klagomål kan komma månader senare, när ingen minns intervjun. En intervjubedömningsmall med ett citat per färdighet visar vad du bedömde och varför.
Den amerikanska regeln nämner inte bedömningsmallar, men den omfattar "andra register som har med anställning att göra". När någon lämnar in ett diskrimineringsärende behåller du varje relevant register tills ärendet avslutas. Det inkluderar andra kandidaters register för samma tjänst, så 1 ärende fryser hela uppsättningen.
Dessa regler gäller i september 2026. Detta är en sammanfattning, inte juridisk rådgivning.
| Regel | Var | Vad den innebär för din bedömningsmall |
|---|---|---|
| 29 CFR 1602.14 | USA | Behåll anställningsregister i 1 år, längre efter ett ärende |
| 2 CCR 11013(c) | Kalifornien | Behåll register i 4 år, inklusive data från automatiserade beslut |
| ICO:s vägledning | Storbritannien | Kandidater kan begära intervjuanteckningar; redovisa varje regel för att avgöra lika |
| TAFEP | Singapore | Använd ett utvärderingsformulär och behåll register i minst 1 år |
| 29 CFR 1630.11 (ADA) | USA | Om en funktionsnedsättning påverkar talet, betygsätt färdigheten, inte talet, om det inte är att tala som tjänsten kräver |
| AI-förordningen, artikel 5.1 f | EU, sedan 2 februari 2025 | Ingen AI som drar slutsatser om kandidaters känslor från ansikten, hållning eller tangenttryckningar |
| AI-förordningen, bilaga III och artikel 26 | EU, från 2 december 2027 | Hög risk: mänsklig tillsyn, loggar som behålls 6+ månader, kandidater informeras |
| Local Law 144 | New York City | En AI-poäng som används ensam, viktas högre än allt annat eller används för att åsidosätta människor: årlig revision för bias och meddelande |
| AI Video Interview Act | Illinois | Meddelande, förklaring och samtycke först; radera videor inom 30 dagar efter en begäran |
Det är därför mallen har en rad för "Inte betygsatt". EU förbjuder AI som läser av kandidaters känslor från ansikten, hållning eller tangenttryckningar, och den amerikanska funktionsnedsättningslagen (ADA) skyddar kandidater vars funktionsnedsättning påverkar talet. I Storbritannien kan kandidater be om dina anteckningar, så skriv varje bevisrad som om de kommer att läsa den.
För att själv granska, jämför godkännandefrekvenser mellan grupper med 4/5-tumregeln i Uniform Guidelines. Säg att 30 % av 1 grupp klarar sig och 50 % av en annan: 30 delat med 50 är 0,6, under 0,8, så titta närmare.
Ett yttrande från Justitiedepartementet i juni 2026 och en OPM-regel från juli 2026 flyttar federala myndigheter bort från riktlinjerna. De finns dock kvar i de federala reglerna, så se kontrollen som en billig vana, inte en juridisk gräns.
10. Hur inför jag en intervjubedömningsmall med mitt team den här veckan?
Bygg den i den här ordningen och ändra den bara mellan olika roller. En första version behöver inte vara perfekt, men den måste vara densamma för varje kandidat.
- Skriv 1 uppdragsrad och 3 till 8 rangordnade utfall.
- Gör om dem till 5 kompetenser och markera måste-kraven.
- Skriv 2 frågor om tidigare beteende och ankare för 1, 3 och 5 per kompetens.
- Låt upp till 4 intervjuare bedöma var för sig och lämna in före avstämningen.
- Låt summan avgöra, men ett måste-krav under 3 betyder ingen anställning. Skriv ner varje åsidosättande.
I praktiken: börja med 1 öppen roll, så att ditt team lär sig vanan på något verkligt. Låt alla bedöma samma exempelsvar före den första intervjun och jämför.
Om 2 bedömningar ligger mer än 1 poäng ifrån varandra, skriv om ankaret tills de stämmer överens. De tränade bedömarna i studien i avsnitt 8 använde samma 1-poängsglapp för att kalla till ett möte.
Räkna med visst motstånd. Kahnemans arméintervjuare motsatte sig också att bara anteckna svar, och hans lösning var betyget med slutna ögon, som gav deras omdöme en plats i formuläret. Din rad för helhetsintryck gör detsamma för ditt team.
Hur Flowmingo hjälper till
För att skicka en strukturerad intervju till varje sökande som de gör på egen tid, inspelad och bedömd mot 1 intervjubedömningsmall, prova Flowmingo.
11. Källor
Varje extern siffra ovan kommer från källorna nedan, i ordningsföljd efter förekomst. Flowmingos egna siffror finns i datarutorna, juli 2025 till sep 2026.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.