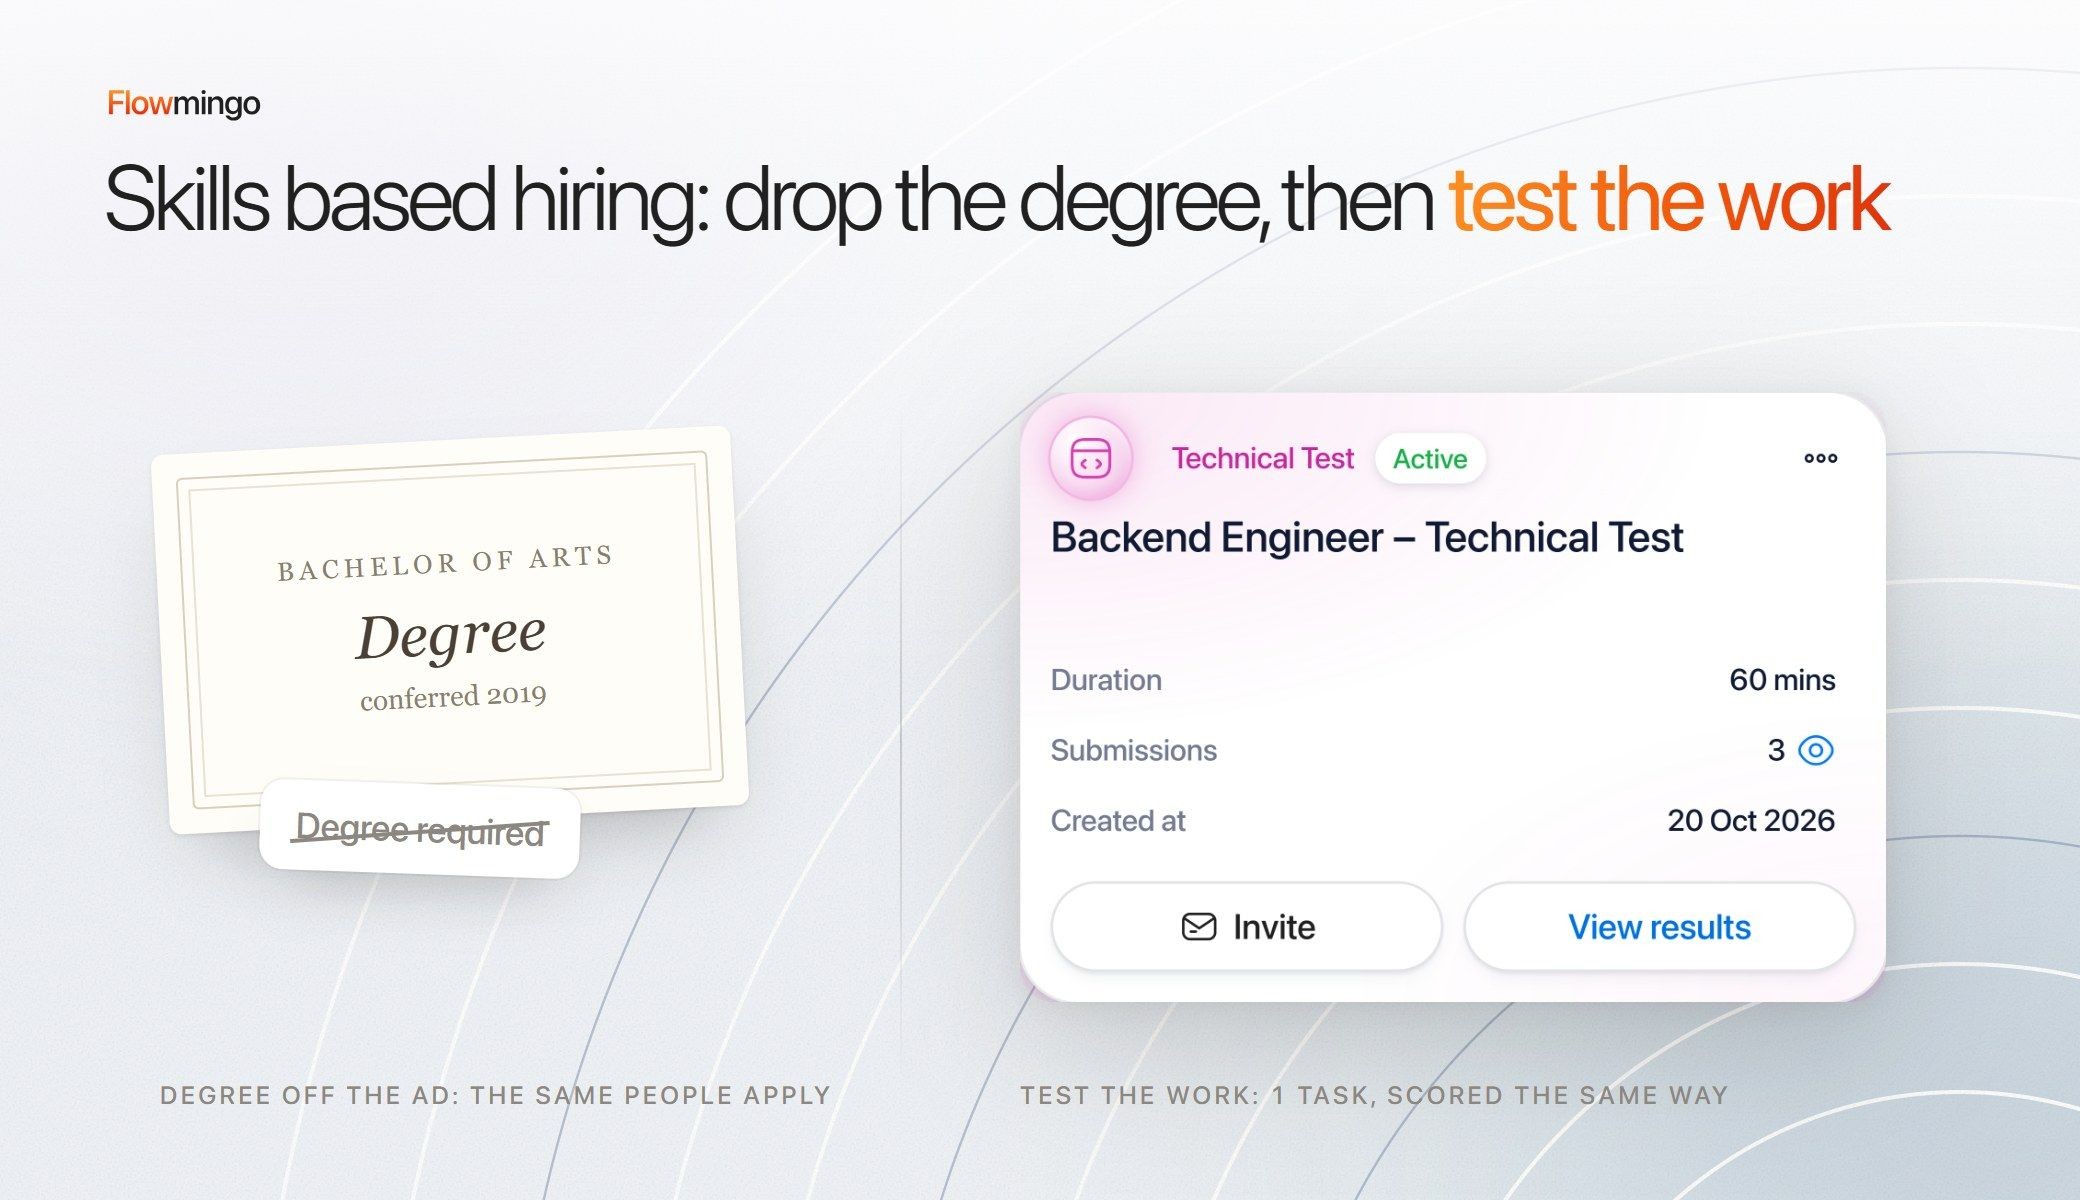
你把学位要求从招聘广告中去掉了,但申请的仍然是同一类人。这只是纸面上的基于技能的招聘,而改变往往止步于此。
在一项针对美国大型企业11,300个职位的研究中,取消学位要求最终带来的美国员工招聘增加不到1/700。只有3.6%的职位取消了学位要求,而在这样做的公司中,只有37%改变了他们雇用的人。
招聘广告从来都不是问题所在。招聘经理会将每位候选人与候选人池进行比较,因此学位仍然是一个捷径。如果没有一种评分方式来评估技能,旧的筛选标准就会悄然回归。
这让你失去了那些能胜任工作的人。在SHRM的调查中,85%的人力资源专业人士表示,可靠的技能检查会让他们的组织更有可能将没有学位的候选人视为合格。
本指南展示如何在没有HR团队的情况下,针对1个职位,通过3个步骤启动基于技能的招聘。在阅读简历之前,先写一份简短的技能清单。给每位入围者同样的工作样本测试,根据书面示例评分,然后按组检查通过率。
关键要点
- 如果我从招聘广告中去掉学位要求,我会招到不同的人吗? 只有当你改变评估方式时才会:在去掉学位要求的公司中,只有37%招到了更多没有学位的员工。
- 在阅读第一份简历之前,我应该写下什么? 列出4到6项技能,分为必备和可学习两类,每项都配有任务。
- 工作样本测试应该持续多长时间? 计划30到45分钟(我们的规则),绝不超过3小时。
- 技能测试会吓跑优秀候选人吗? 单凭长度不会:大多数退出的人是在前20分钟内退出的。
- 我可以用30名申请者来检查技能测试是否存在偏见吗? 可以,但出现警示是值得调查的理由:10人中的5人对10人中的3人可能是偶然。
1. 去掉学位后,我们招的人看起来还是一样。基于技能的招聘有用吗?
仅靠它本身不行:在一项涉及11,300个职位的研究中,去掉学位要求的公司里只有37%改变了他们招聘的对象。
Burning Glass Institute和哈佛商学院在一项2024年的基础研究中追踪了这些职位。在去掉学位要求的公司中,没有学士学位的招聘上升了3.5个百分点,但只有3.6%的职位去掉了这一要求。在全美所有招聘中,净变化为0.14个百分点,不到1/700,每年约77百万中有97,000(报告估计)。
在去掉学位要求的公司中,45%只是名义上修改了招聘广告,18%又退回了原样。只有坚持到底的那37%多招了约18%没有学位的员工。
报告称,仅靠招聘广告改变甚微,因为持久的改变需要新的流程和激励措施,但没有具体说明那37%采用了哪些。在SHRM的2025年调查中,1,184名人力资源专业人士认为,技能优先招聘的最大障碍是依赖学位(29%)和没有评估工具或流程(29%)。不一致的做法紧随其后(25%)。
我们的解读:本指南的3个步骤回应了这些障碍。技能清单带来一致性,相同的测试是工具,书面评分是流程。该研究涵盖每年发布500+招聘广告的公司,因此对小公司没有说明。
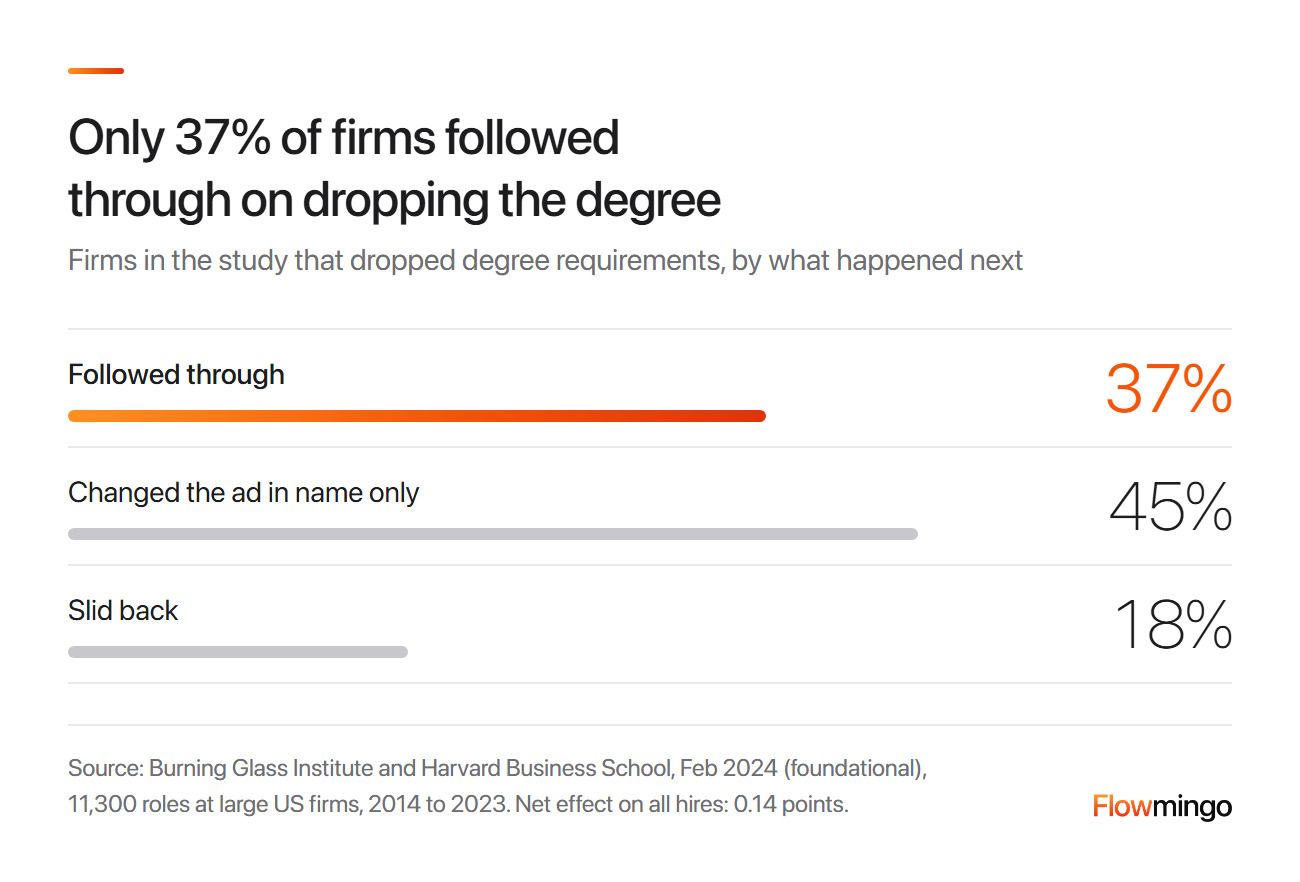
学位要求坚持到底:37%去掉要求的公司坚持到底,45%只是名义上修改了招聘广告,18%又退回了原样。2024年的基础研究涵盖了11,300个职位。
2. 没有HR团队,我该如何在下一个职位上启动基于技能的招聘?
在1个岗位上试点基于技能的招聘,并做3项改变:一份简短技能清单、1个工作样本测试作为技能评估,以及书面评分。
下图是我们自己的7天计划,不是研究:第1天列技能清单,第2天测试,第3天制定评分标准。在第4至第6天,首轮面试之后,每位入围者完成同一任务。第7天,汇总分数,按组检查通过率,并记录任何例外调整。
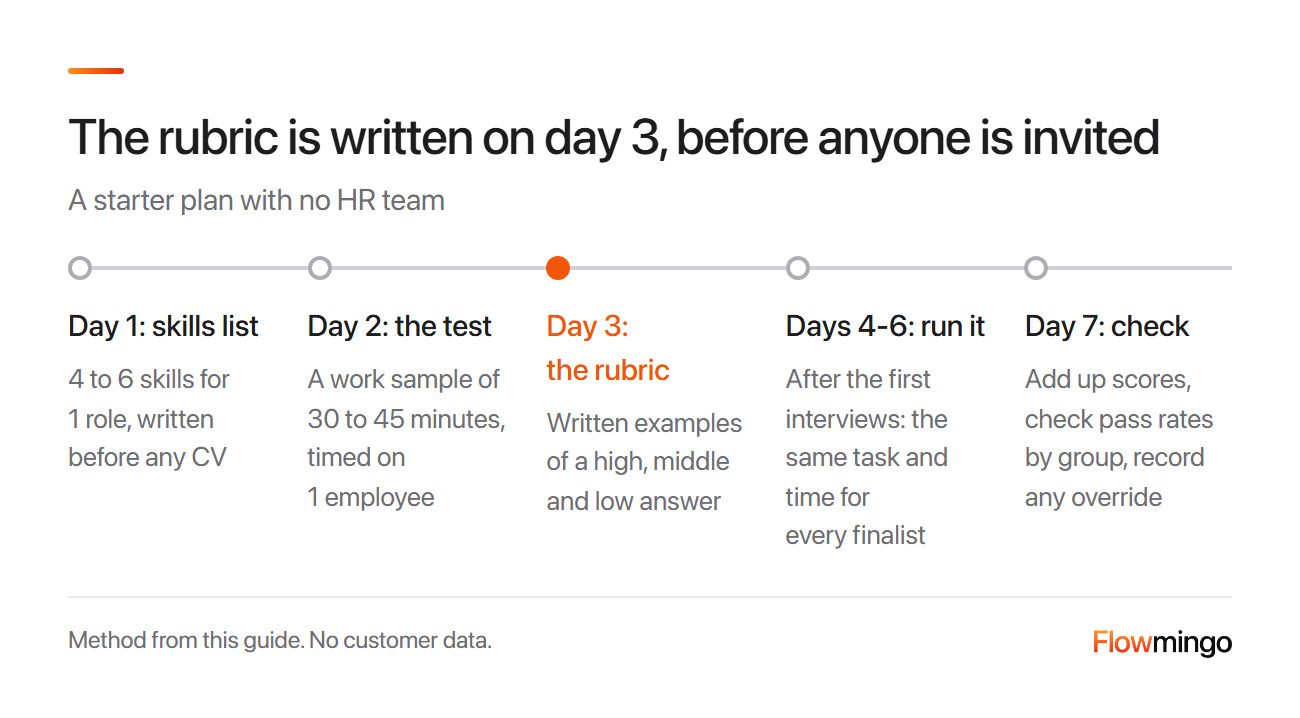
7天启动计划:第1至第3天完成技能清单、工作样本测试和评分标准。每位入围者在第4至第6天完成同一任务,然后第7天检查通过率。
从1个岗位开始,因为试点会在一次糟糕招聘之前让你熟悉流程。指定1位负责人来编写清单并负责评分,这样流程就不会在不同候选人之间走样。
把各项检查按从成本最低到最高排序。在申请环节询问硬性事实,进行首轮面试,然后让剩下的4人左右做工作样本测试。我们的招聘流程步骤指南为测试安排4天,所以如果测试需要,就把第4至第6天延长。
当有200多名申请者时,先按硬性事实筛选,正如我们的候选人筛选指南所示。
3. 当职位描述过时时,我如何为1个岗位构建技能清单?
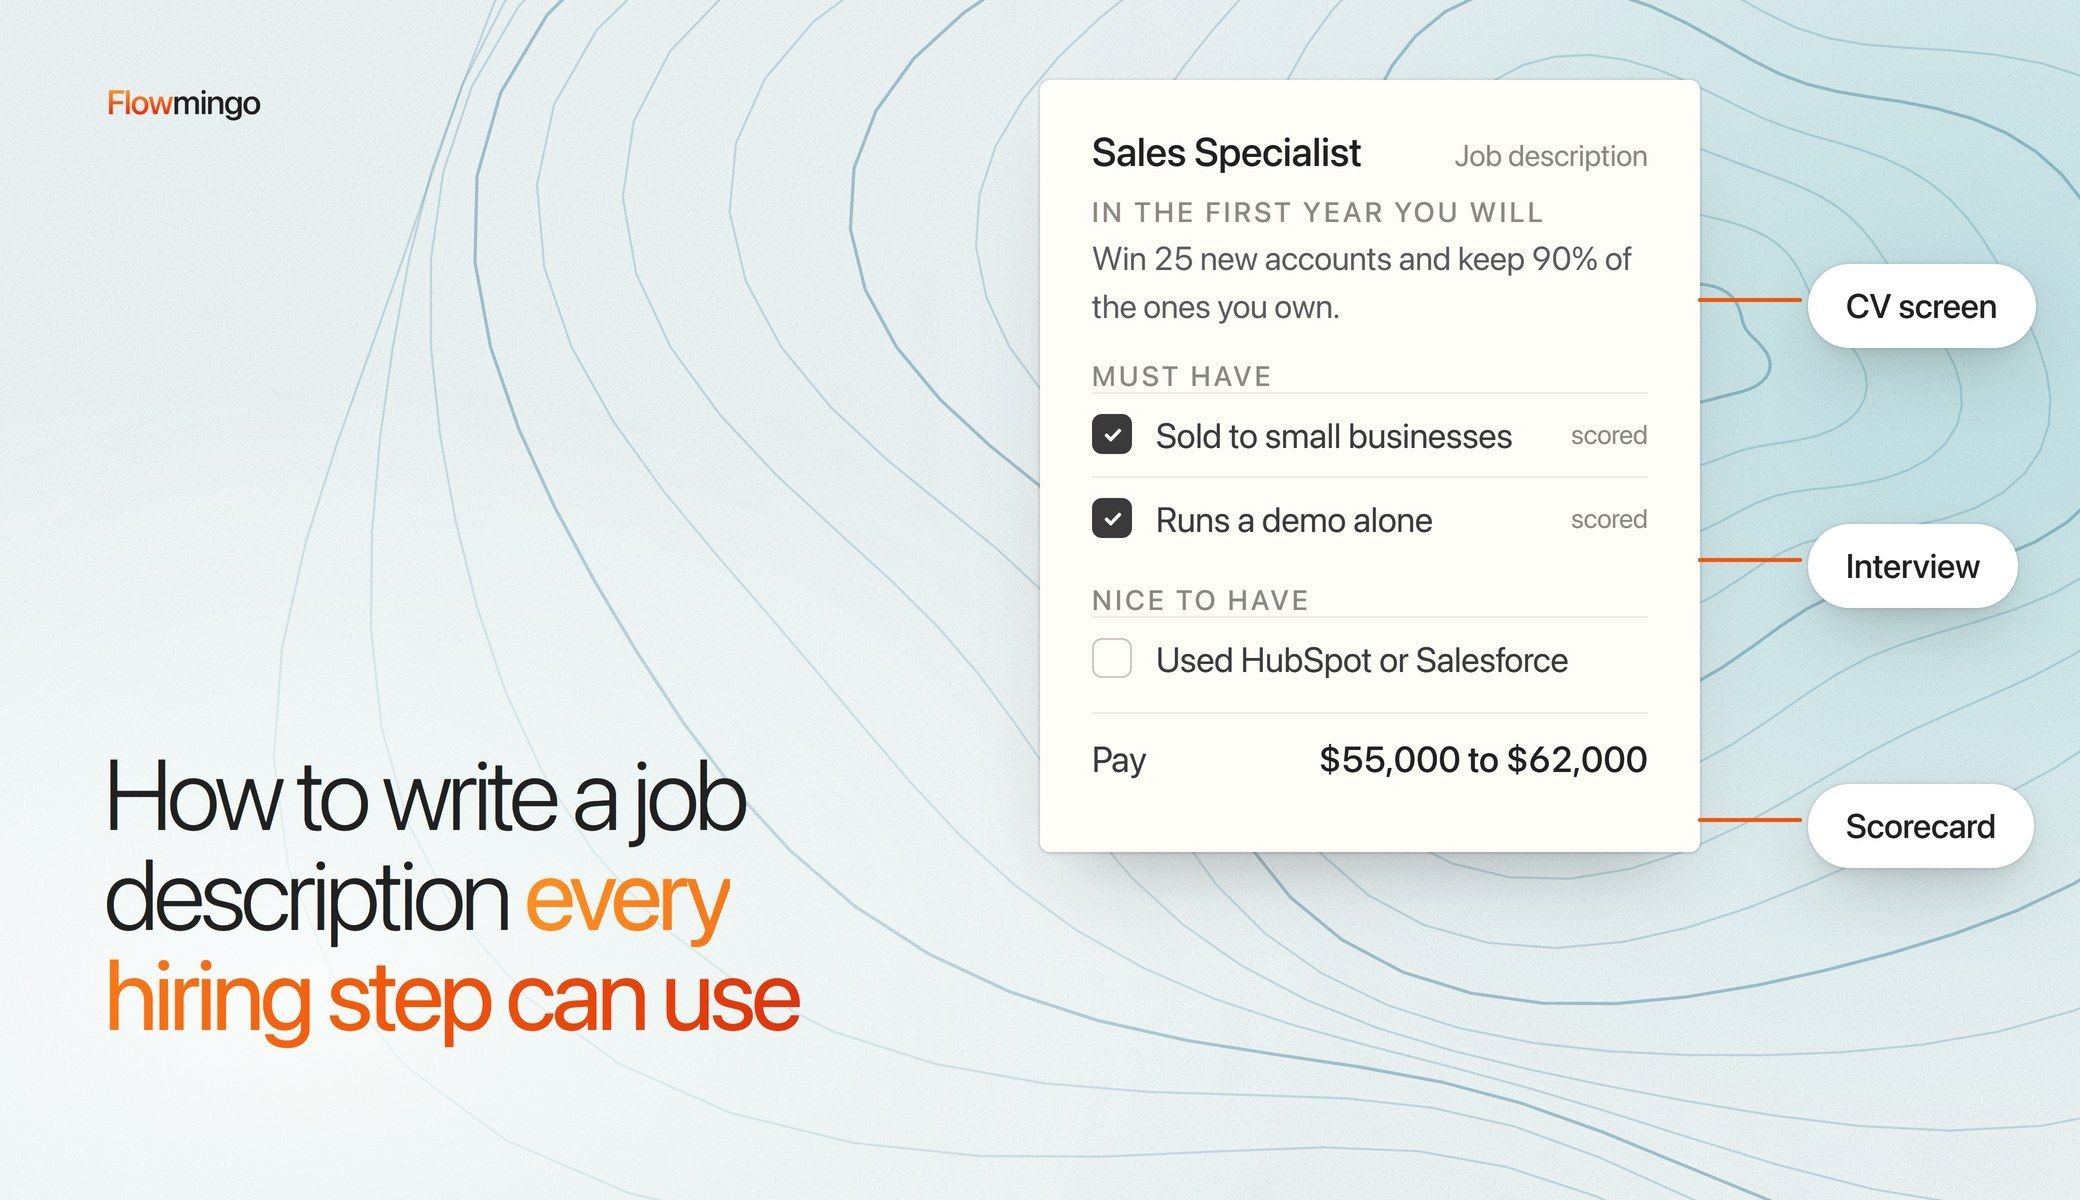
要从实际工作出发,而不是旧招聘广告。列出这个人在前90天必须做的事情,并保留最重要的4到6项。
从任务开始,因为过时的招聘广告列出的职责可能已不复存在。向经理和上一任在岗者询问6到10项任务。
1978年美国《统一准则》这一基础性文件指出,基于内容的测试应建立在工作分析之上,并且不适用于在工作中习得的技能。
把必备项与可学习项区分开:必备项在第1天就需要,而可学习技能可以培训,所以不要测试它。
然后,在查看任何简历之前,锁定并注明该列表的日期。在2005年的3个基础性实验中,人们重新定义职位要求,以迎合他们偏爱的候选人。先固定标准则消除了歧视(Uhlmann and Cohen)。
说明性示例,非客户数据:一名办公室管理员的技能列表,锁定于[日期]。
| 技能 | 类型 | 展示该技能的任务 | 优秀回答(5) |
|---|---|---|---|
| 保持记录准确 | 必备 | 在25行的发票表中找出3处错误 | 找出全部3处并说明每处如何发生 |
| 书写清晰 | 必备 | 针对每处错误写一条备注 | 同事能根据每条备注采取行动 |
| 设定优先级 | 必备 | 说出应先修正哪处错误 | 说出哪处错误最重要以及原因 |
| 电子表格公式 | 可学习 | 不测试;我们培训 | 不适用 |
根据列表重写招聘广告。华盛顿州的示例招聘启事以工作内容开头,并列出不要求的内容。我们的示例将“优先考虑学位;3年以上办公室经验”替换为:
“你将保持供应商发票准确。不要求学位。”
3.1 我也应该去掉工作年限吗?
去掉数字,改为说明任务。Sackett及其同事在2022年的一项基础性再分析中发现,工作年限与后续绩效的相关性仅为0.07,其中0表示无关联。
当经验具体时才有意义:1995年的一项基础性综述发现,一个人做过多少相同工作与绩效的相关性为0.43。这两项研究的校正方式不同,因此要看方向,而不是差距。
因此,写“曾为50多名员工处理薪资”,而不是“5年人力资源经验”。
如果一名有2年经验的候选人在测试中击败了有10年经验的候选人,请用相同的评分标准为两人评分,并记录任何例外情况。
4. 工作样本测试是什么样的,应该花多长时间?
在基于技能的招聘中,工作样本测试是每位最终候选人在相同条件下完成的一小部分真实工作。计划30到45分钟,绝不超过3小时。
30 到 45 分钟是我们的规则,因为只有剩下的 4 个人左右会做它,而不是 244 人。3 小时的上限来自实践者 Jacob Kaplan-Moss 在2021 年的一篇奠基性文章中提出的。他的理由是,2 到 3 轮面试加上后勤安排已经占用候选人 4 到 5 小时的时间。
复制这 6 行简介:
- 任务:[1 句话,你们团队已经解决过的一个过往案例]。
- 时间:[30 到 45 分钟],先由 1 名现有员工试做,他应该能在时间内完成。
- 他们得到什么:[1 页的简介和任何文件]。
- 他们提交什么:[1 个文件或 1 段录音]。
- 评分:第 5 节的评分标准,1 到 5 分。
- 他们被告知什么:"你有 [40] 分钟,不需要完成。要更改格式或时间,请联系 [姓名] 的 [邮箱]。我们会在 [日期,7 天内] 之前通知你。"
Sackett 及其同事在 2022 年的一项奠基性再分析中发现,工作样本与后续绩效的相关系数为 0.33,低于 1998 年一项奠基性估计中的 0.54。结构化面试(0.42)排名更高,所以将测试与之一并使用。
在 0(无关联)到 1(完美)的尺度上,作者表示,较早的数据主要是被一项统计校正夸大了。他们在 2023 年的奠基性后续研究中指出,工作样本适合一个人已经具备的技能,而不是入职后才学习该技能的入门级职位。所以只测试必备条件。
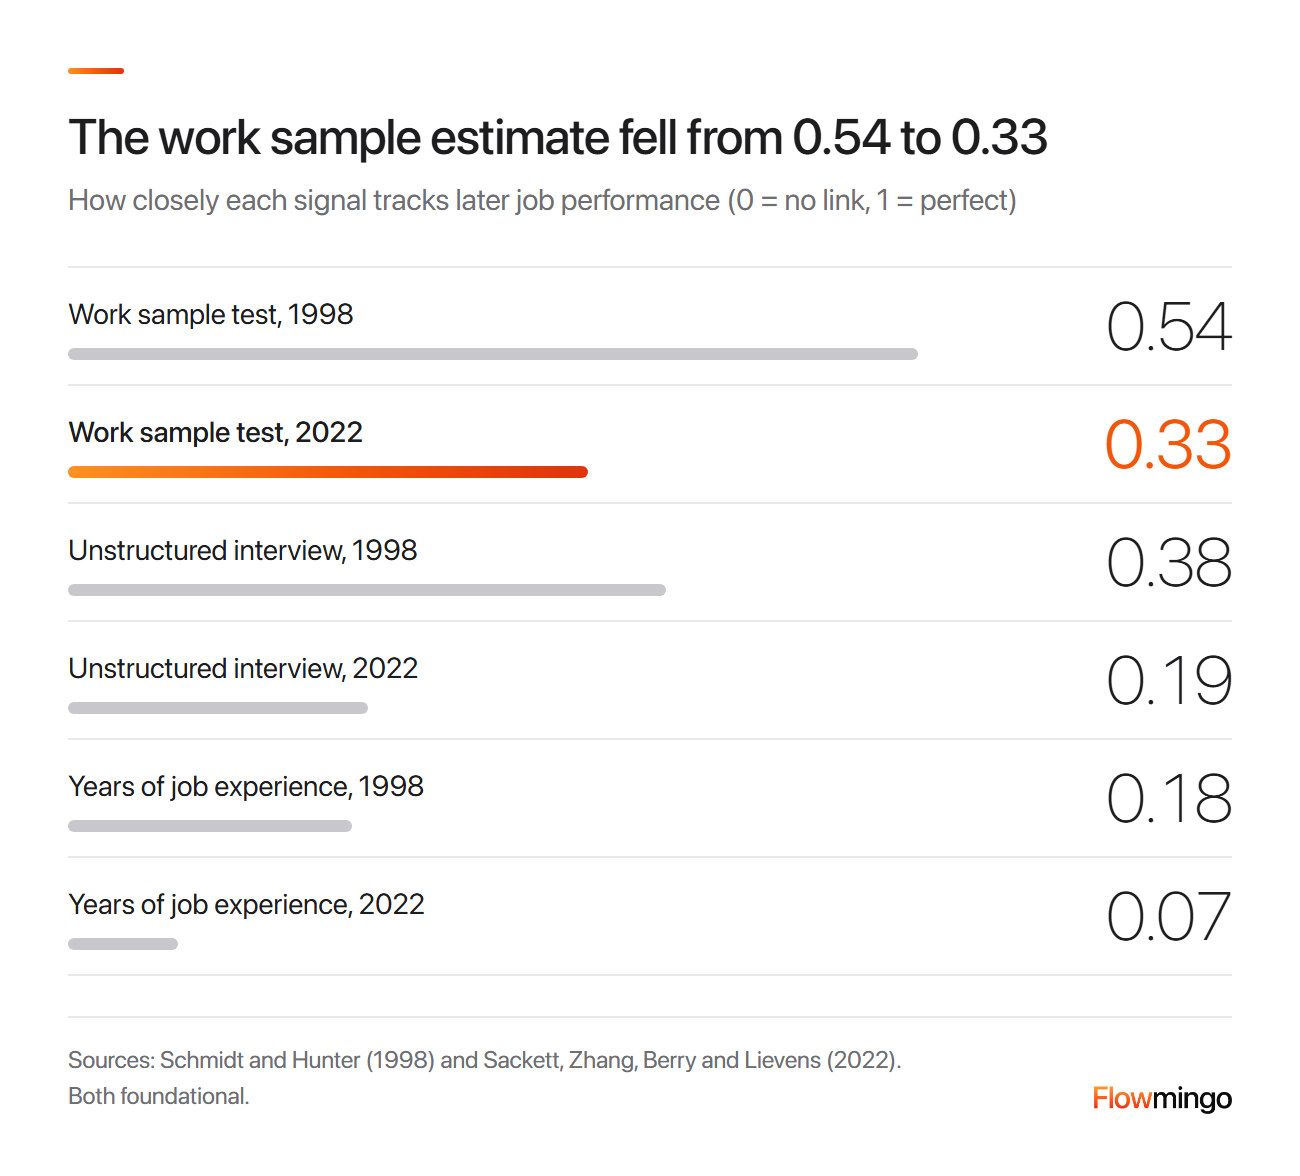
工作样本估计值随时间变化:从 1998 年的 0.54 到 2022 年奠基性再分析中的 0.33。非结构化面试从 0.38 下降到 0.19,工作年限从 0.18 下降到 0.07。
Flowmingo 如何提供帮助
Showcase 是一种工作样本测试:候选人共享屏幕并在自己的时间录制每项任务。最多可容纳 10 项任务,总时长在 Free 上限制为 20 分钟,Starter 为 30 分钟,Growth 和 Scale 为 60 分钟。在共享文档中运行更长的任务。
4.1 候选人在我们的带回家测试中使用 ChatGPT。我应该改变什么?
管理者在 r/ExperiencedDevs 和 r/recruiting 上报告了 AI 撰写的带回家答案。我们没有发现关于这种情况有多普遍的研究。
根据我们的实践,有 3 项改变会有所帮助。将任务作为计时环节来运行,并让候选人解释 1 个选择,例如为什么他们首先标记了第 14 行。每轮更换任务,这样泄露的答案就毫无用处。
5. 我如何给工作样本评分,以便 2 位评审对同一候选人达成一致?
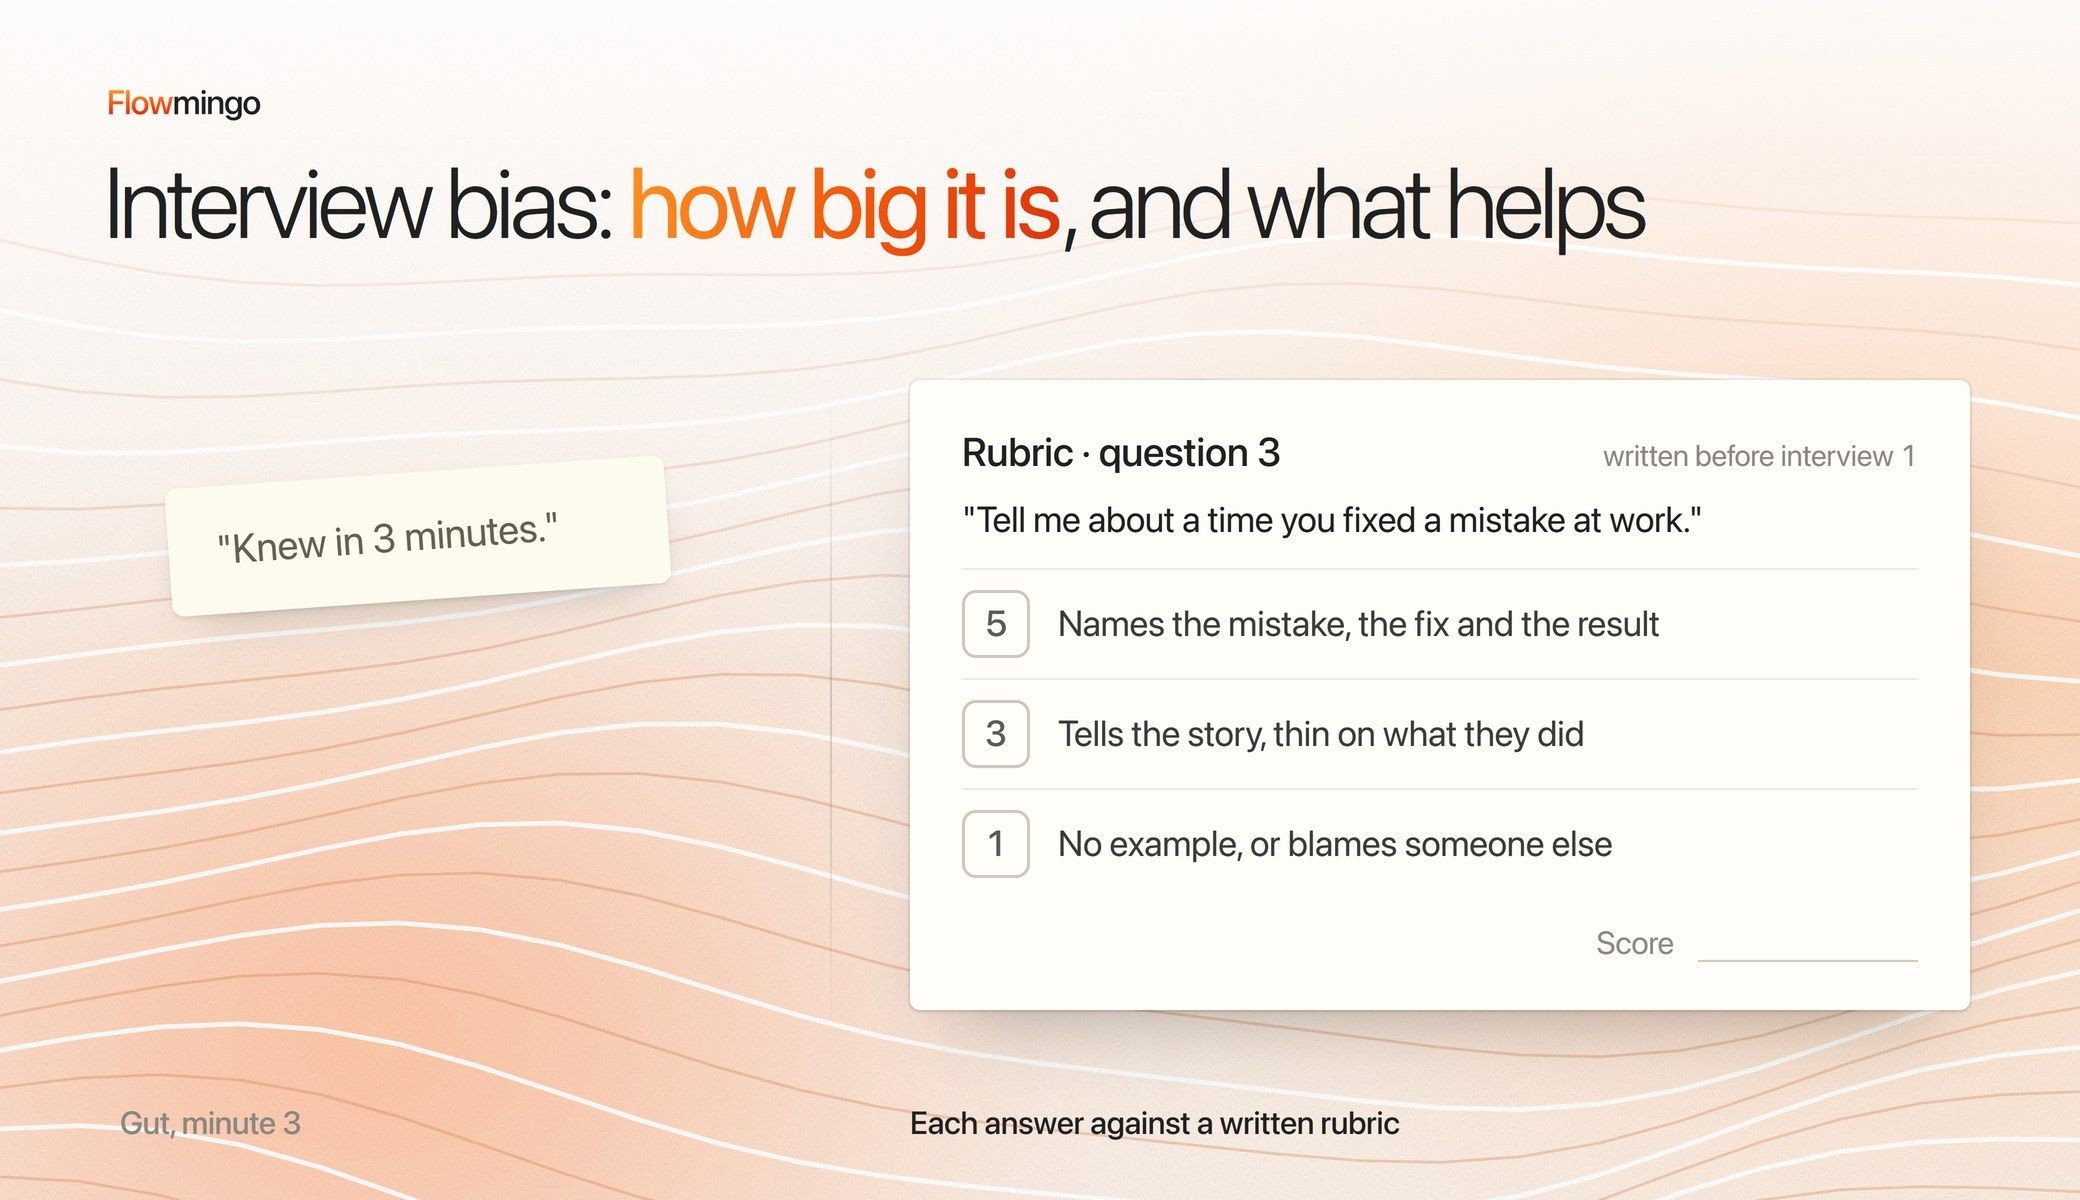
针对每项技能,分别对照高、中、低答案的书面示例进行评分,先让2位评审独立工作。比较分数,讨论任何2分或以上的差距,只有书面理由才能更改分数,然后取平均值并相加。
示例说明,并非客户数据:第3部分发票任务的评分标准。
| 标准 | 5 | 3 | 1 |
|---|---|---|---|
| 准确性 | 发现全部3处错误并说明每处如何发生 | 发现2处错误 | 发现0或1处,或修改正确行 |
| 备注清晰度 | 同事能根据每条备注采取行动 | 正确,但引发疑问 | 模糊或缺失 |
| 优先级排序 | 说明哪个错误最重要及原因 | 无顺序列出错误 | 未说明 |
使用2位评审。在Huffcutt及其同事2013年的一项基础性元分析中,观看同一场面试的小组评分者一致性为0.74,而分别面试的一致性为0.44。
我们通过类比将其应用于工作样本。分数为1表示完全一致,而这一指标会美化小组评分,因为一致性并不等于准确性。
| 候选人 | 评分者1(准确性、清晰度、优先级排序) | 评分者2 | 待讨论的差距 | 商定总分(满分15) |
|---|---|---|---|---|
| A | 5, 4, 3 = 12 | 4, 4, 3 = 11 | 无 | 11.5 |
| B | 3, 4, 2 = 9 | 5, 3, 2 = 10 | 准确性,3对5 | 9.5 |
当差距达到2分或以上时,让两位评分者一起查看答案进行讨论,并且只有书面理由才能更改分数。如果差距仍然存在,则像处理1分差距一样,对两个分数取平均值,然后以相同权重相加各标准。对于B,准确性维持在3和5,平均为4,因此4 + 3.5 + 2 = 9.5。
在邀请任何人之前写好评分标准,尽可能对评分者隐藏姓名和简历,并按总分排名。取排名靠前的一部分,其规模根据你的面试时间确定,而不是固定的及格线。下面的卡片使用Flowmingo的多项选择技能测试(而非工作样本),来展示分数分布的广泛程度。
Flowmingo数据 · 227次完成到最后的技能测试尝试 · 225名候选人 · 28家公司 · 开始于2026年8月25日至9月30日
- 65% 是中位数分数,空白题目计为错误。
- 31%到86% 是分数从第10百分位到第90百分位的范围,其中第25百分位为46%,第75百分位为77%。
多项选择技能测试自动评分,时间限制大多为20或30分钟,并非工作样本。分数是正确回答问题的比例,是候选人知识水平的下限,汇总了不同测试的数据。排除Flowmingo自己的组织、演示、练习运行、招聘人员自己的团队和2个非常大的客户。
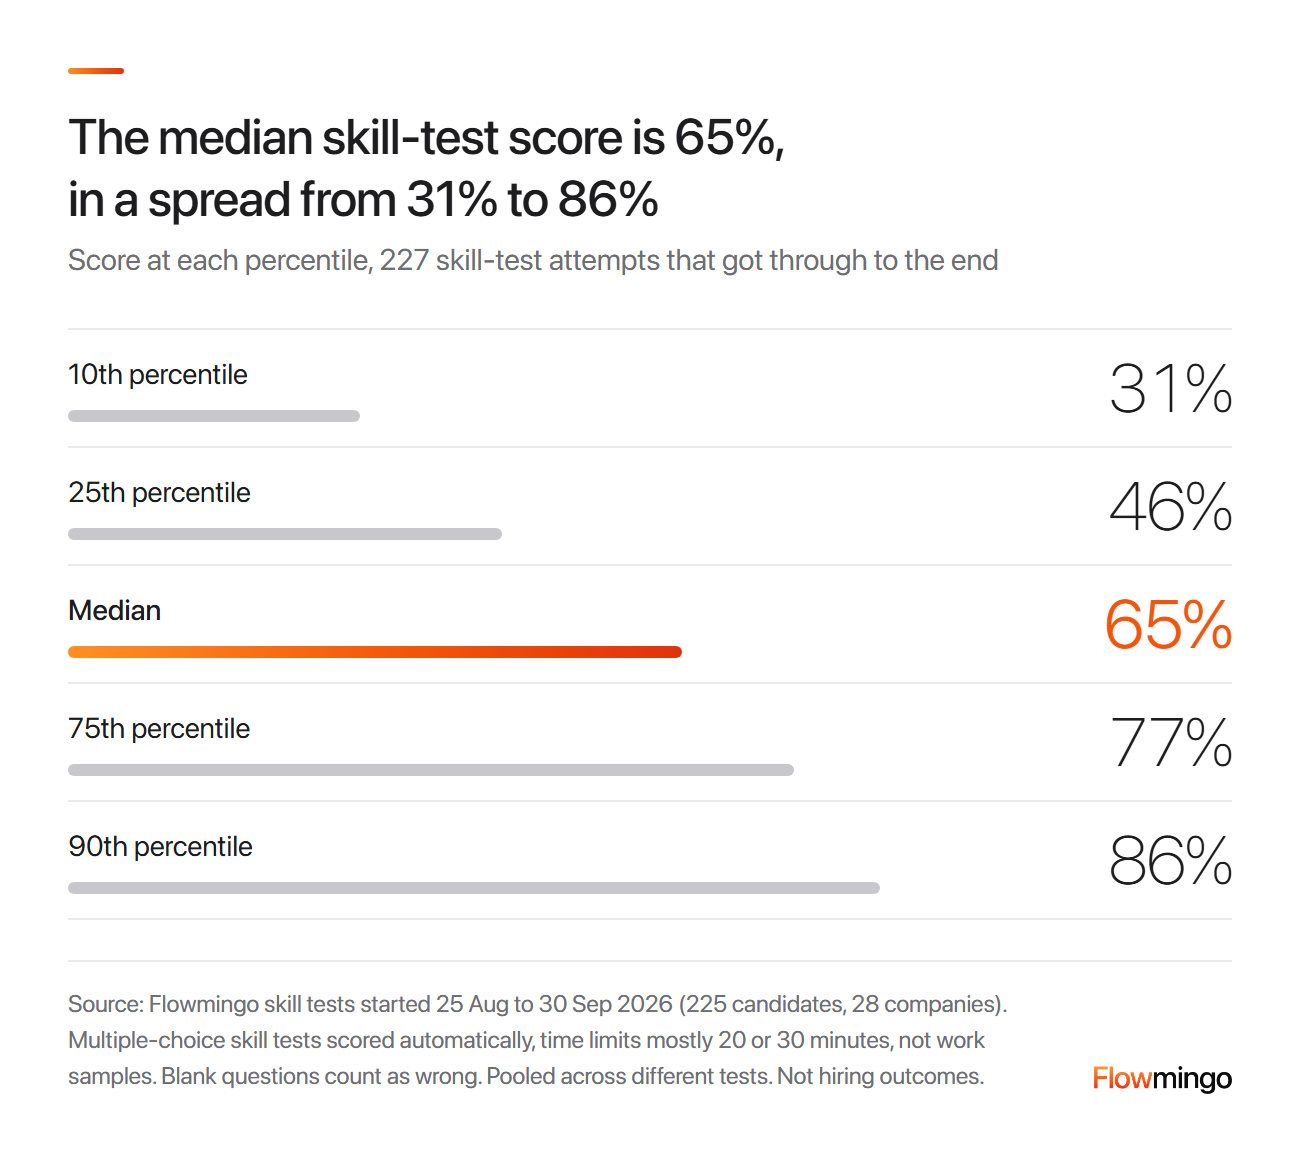
多项选择技能测试分数分布:中位数65%,第10百分位31%,第90百分位86%(Flowmingo数据,227次完成的尝试,2026年,并非工作样本)。
在完成者中,22.9%得分达到80%或以上,18.9%得分在40%或以下。由于不同测试的分数分布如此广泛,固定的及格线会奖励更简单的测试,而不是更优秀的候选人。
5.1 如何评判一项我自己都不具备的技能?
借用答案,因为你无法评判自己不懂的东西,也就无法打分。请一位擅长这份工作的人在你见到任何候选人之前,先把任务以及 1 分、3 分和 5 分的示例写出来。例如,会计师可以在一张表里埋入 3 处错误,并写出优秀的批注应该是什么样。
6. 技能测试会吓跑优秀候选人吗?占用他们多少时间才算合理?
在我们找到的最大规模研究中,仅仅时长本身并不会把人吓跑,但在 2025 年的一项基准调查中,不尊重候选人的时间位列退出原因之首。请明确告知所需时间,只要求你真正需要的那些分钟数,并向每一位候选人反馈结果。
在 2017 年一项针对 69 个筛选系统中 222,772 名求职者的基础性研究中,测评总时长并不能预测退出率。大多数中途放弃的申请者是在前 20 分钟内退出的。给出更长预估时间的系统流失的人反而更少。
在 2025 年的 CandE 基准调查中,32% 退出的候选人表示面试和约见不尊重他们的时间。该基准调查中只有 6% 的候选人收到了关于测评或测试结果的反馈。销售候选人调研软件的 Survale 现在负责运营并发布这项调查。
Flowmingo 数据 · 293 次技能测试作答 · 287 名候选人 · 38 家公司 · 起始时间 2026 年 8 月 25 日至 9 月 30 日
- 77.5% 的作答(227 次)坚持到了测试结束。
- 9.6% 的作答从未完成,5.5% 在计时归零时结束且已记录答案,5.1% 在未记录任何答案的情况下关闭,2.4% 以其他方式结束但记录有答案。
多项选择技能测试自动评分,时限大多为 20 或 30 分钟,不是工作样本。以公司为单位计算时,77.5% 的范围为 65% 至 85%。统计的是作答次数,不是人数。5.1% 中可能有一部分是记录失败。不包含 Flowmingo 自身的组织、演示、练习作答、招聘方自己的团队以及 2 家超大型客户。
这些是多项选择测试,因此反映的是在短时限时测试中的行为,而不是在 30 到 45 分钟工作样本中的行为。那些在未记录答案情况下关闭的少数作答,可能印证了 Hardy 的发现:放弃者往往很早就离开。
计时归零大多是因为异常行为被扣减时间,因此并不能说明测试太长。请给出 7 天内的结果日期,因为该基准调查中只有 6% 的候选人收到了关于测评或测试结果的反馈。
我们没有找到关于报酬与退出的研究。我们的做法是:在所述时段内使用一个已解决的过往任务;任何更长的任务或真实任务都会支付报酬。
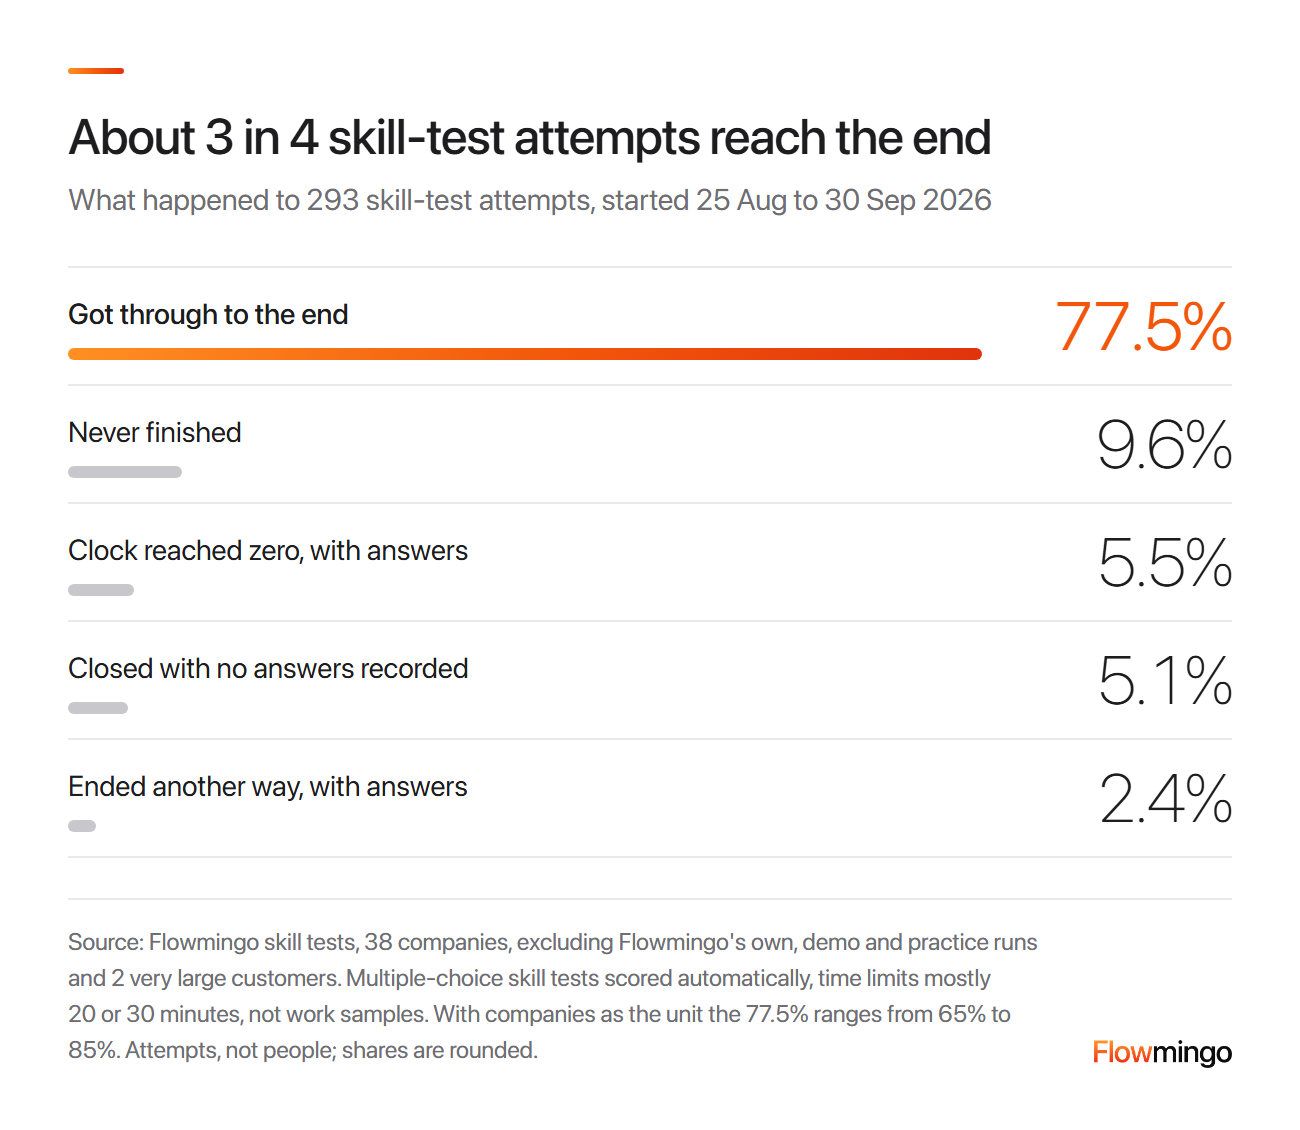
技能测试作答结果:在 293 次多项选择作答中,77.5% 坚持到了结束,9.6% 从未完成,5.5% 在计时归零时结束。
6.1 短测试能取代简历筛选吗?
短测试可以取代简历作为你的技能证明,但不能作为第一道关卡。对第一次面试后剩下的4个人左右进行测试,如第2节所述。
7. 基于技能的招聘更公平吗,还是测试可能筛掉年长或残障候选人?
不一定:基于技能的招聘仍可能筛掉某些群体,因此每轮都要按群体检查结果。
Roth及其同事在2008年的基础性元分析中发现,在工作样本测试中,黑人和白人申请人之间的差距为0.73个标准差。这大约是通常引用的0.38的两倍,而0表示没有差距。
评估认知和职位知识技能的练习显示为0.80,而社交技能为0.21至0.27。数据仅涵盖美国申请人。
我们的解读:练习奖励什么,差距就会移动。例如,如果工作几乎不需要书面英语,那么繁重的写作任务衡量的是语言,而不是技能。
在Mobley诉Workday案中,法院于2025年5月16日初步认证了一个由40岁及以上申请人组成的年龄歧视集体诉讼(Holland & Knight)。Workday表示该案缺乏法律依据,并且它涉及的是软件供应商,而不是技能测试。
在英国,Acas表示,你必须做出合理调整,并且必须询问任何来面试的人是否需要任何调整。我们的面试邀请邮件模板展示了要复制的句子:询问形式,绝不询问健康。
8. 只有30名申请人时,我如何检查技能测试是否存在不利影响?
将每组通过率除以最高组的通过率,并查看任何低于80%的情况。有30名申请人时,大多数群体都太小而无法解读,因此标记是检查测试的理由,而不是偏见的证据。
群体标签来自评分者从未见过的可选的平等机会表格。当地规则,例如英国和欧盟的数据保护法,可能会限制询问,因此先检查。将“通过”计为进入下一阶段的前列部分。
1978年奠定性文件《统一准则》确立了美国的规则,见29 CFR 1607.4(D):低于4/5(80%)的比率通常被视为存在不利影响的证据。差距更小仍可能被认定,而数字很小时差距更大反倒未必。
《统一准则》针对的是种族、性别和族裔群体,因此对于年龄或残疾,只能把这一比率当作粗略的警报。
例如,A组10人中有5人、B组10人中有3人通过了你的工作样本测试。比率为60%,亮起了警示。但费舍尔精确检验给出p = 0.65,也就是说这种幅度的差距约有三分之二的机会是偶然出现的。
若是100人中的50人对100人中的30人,比率相同,而按我们的计算p = 0.006,约为千分之六。
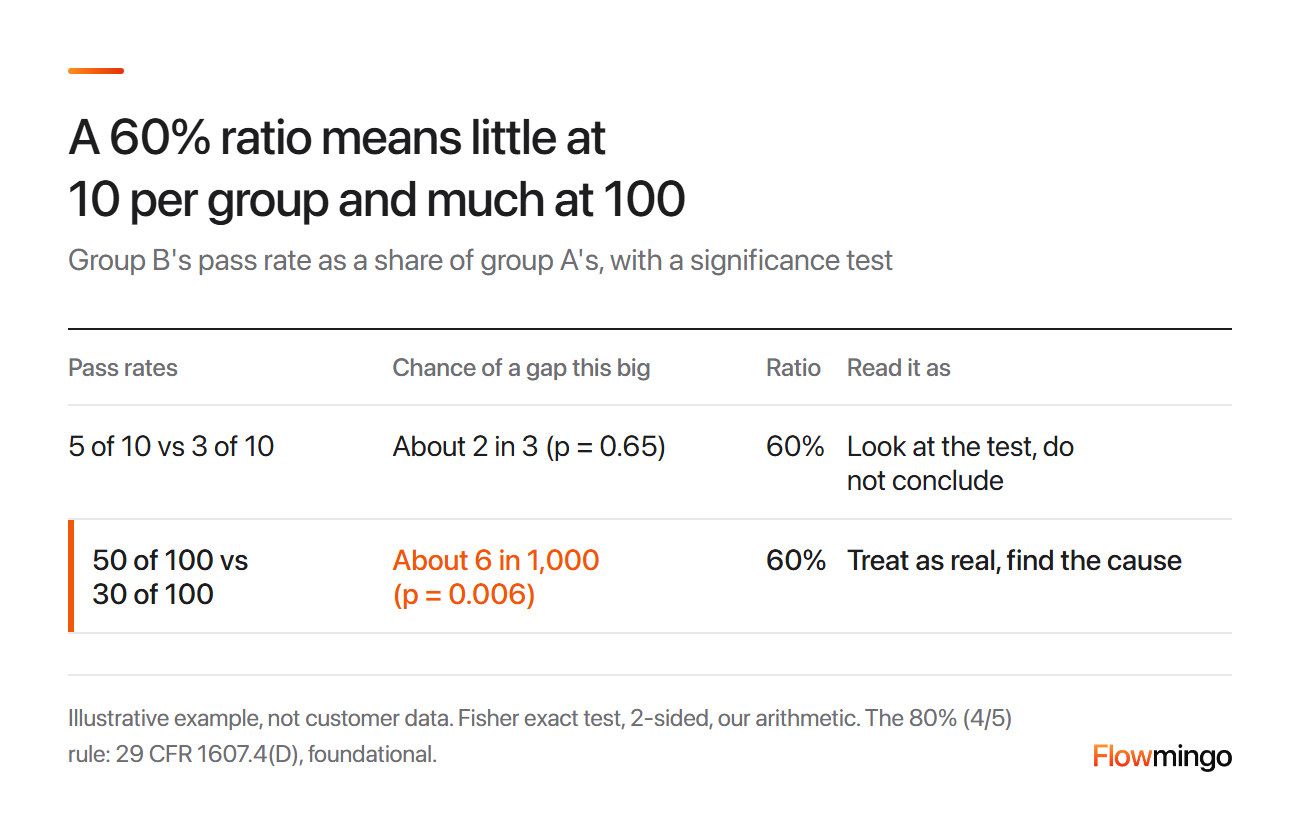
示例性的通过率检查:两个差距的比率都是60%,低于80%这条线。每组10人时,看检验结果,不要下结论;每组100人时,就当作真实差距并查明原因。
每一轮都保留6项记录:带日期的技能清单、任务、评分标准、每一项得分、各组通过率,以及任何破例的理由。
8.1 80%规则目前在美国仍然适用吗?
截至2026年10月4日,它仍留在eCFR中。2026年6月的司法部意见和2026年7月的OPM规则都使联邦机构远离该准则。
EEOC已列出2026年11月的废止计划,但至今尚未公布。
无论如何,仍要保留上述6项记录。
9. 新加坡的《职场公平法》和英国的《平等法》对我们的技能测试意味着什么?
英国《平等法案》要求你证明任何对受保护群体不利的测试是合理的。新加坡的三方指导原则已经要求采用申请人可见的与工作相关的标准,而其法案(目标是在2027年底)增加了索赔途径。
这是一般性信息,不构成法律建议。
| 地区 | 规则 | 对技能测试的意义 |
|---|---|---|
| 英国 | 2010年《平等法案》第19条和第60条;Acas | 测试必须成比例;为残疾申请人调整 |
| 新加坡 | 《工作场所公平法案》(MOM),目标是在2027年底 | 涵盖招聘;索赔最高S$250,000 |
根据2024年11月的情况说明书,最初少于25名员工的公司可豁免,因此请查看最终法案。该指导原则接受学位、相关领域3年经验和特定技能作为要求,前提是与工作相关。
因此,在新加坡,基于技能的招聘不是强制性的,但书面的技能清单是你的证据。在英国,如果及格分数对受保护群体不利,且与合法目标不成比例,则属于间接歧视。
9.1 如果软件对测试评分,AI招聘法律是否适用?
由你的团队手动评分的工作样本不在欧盟AI规则范围内。使用AI对候选人进行评分或排名的工具则不然,因为附件III将用于招聘或选拔人员的AI视为高风险。
关于欧盟、加利福尼亚、纽约市和伊利诺伊州,请参阅我们的候选人筛选指南。
10. 我需要基于技能的招聘的评估软件,还是共享文档就足够了?
共享文档和电子表格对于1个职位来说足够了。当入围者或评审者数量超出表格处理能力,并且你希望评分自动完成时,软件才有其价值。
例如,4名入围者和2名评分者适合1张表格,因为需要跟踪的内容很少。该表格是我们的判断,并非研究。
| 你需要什么 | 文档和表格 | 软件何时开始有帮助 |
|---|---|---|
| 分数 | 1张表格,每个评分者每个标准一列 | 入围者或评分者数量超出表格处理能力 |
| 群体检查 | 每轮按群体统计通过人数,使用第8节中的表格和本地规则检查 | 你需要在所有职位的每一轮都进行 |
当你的入围者多到一天内无法评分,或者评审者超过2人时,软件会有所帮助。在此之前,表格设置更快,更容易解释,因为每个人都能看到每个分数。
一位拥有预算的团队负责人在购买评估软件前提出了这个问题。
向任何供应商,包括我们,提出6个问题:
- 分数是如何产生的?
- 我能看到每个答案与标准答案的对照吗?
- 关于候选人会记录哪些信息?
- 偏见是如何检测的?
- 数据保存在哪里,保存多久?
- 每位候选人我需要支付多少费用?
基于技能的招聘归结为3个步骤和1项检查。列出技能清单,给每位入围者相同的测试并书面评分,然后按组检查通过率。
Flowmingo 如何提供帮助
Flowmingo 是一款面向招聘人员的免费 AI 面试官。Tests 是选择题,因此它们考查的是工作知识,而不是工作样本,并且在每个计划中都是无限量的,包括 Free。每个结果都会显示每个答案与标准答案的对照。Showcase 是工作样本,由你的团队评分,而不是 AI。对于开发人员职位,Technical Test 通过将候选人编写的代码针对测试用例运行来评分。尝试使用 Flowmingo 进行下一轮基于技能的招聘。
11. 来源
本指南中的每一项研究、法律和调查都在下方链接到来源;Flowmingo 的数据来自 Flowmingo 自己的平台数据。
- Acas (2026年6月30日). 遵循反歧视法:招聘. Acas.
- Burning Glass Institute, & Harvard Business School Managing the Future of Work (Sigelman, M., Fuller, J., & Martin, A.) (2024年2月). 基于技能的招聘:从声明到实践的漫漫长路. Burning Glass Institute.
- 平等就业机会委员会等 (1978). 员工选拔程序统一指南,29 CFR 1607.14:效度研究的技术标准. eCFR.
- 平等就业机会委员会等 (1978). 员工选拔程序统一指南,29 CFR 1607.4:影响信息. Legal Information Institute.
- 欧盟《人工智能法案》[网站] (无日期). 附件三:第6(2)条提及的高风险AI系统. Future of Life Institute.
- Hardy, J. H., Gibson, C., Sloan, M., & Carr, A. (2017). 申请人是否更可能退出更长的测评?考察测评长度对申请人流失行为的影响. 《应用心理学杂志》, 102(7), 1148-1158.
- Holland & Knight (2025年5月27日). 联邦法院允许就涉嫌AI招聘偏见提起集体诉讼. Holland & Knight LLP.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). 就业面试信度:按结构和形式得出的新元分析估计. 《国际选拔与评估杂志》, 21(3).
- Kaplan-Moss, J. (2021年11月17日). 良好工作样本测试的框架:公平测试的八条规则. jacobian.org.
- Legislation.gov.uk (2010). 《2010年平等法》第19条:间接歧视. 英国议会.
- Legislation.gov.uk (2010). 《2010年平等法》第60条:关于残疾和健康的询问. 英国议会.
- 新加坡人力部 (2024年11月12日). 《工作场所公平法案》情况说明(一读). MOM.
- 新加坡人力部 (2025年11月4日). 《工作场所公平(争议解决)法案》新闻稿. MOM.
- 美国司法部法律顾问办公室 (2026年6月9日). Title VII 下差别影响责任的合宪性. DOJ.
- 美国人事管理办公室 (2026年7月31日). 删除联邦人事法规中对《员工选拔程序统一指南》的引用. 《联邦公报》, 91 FR 48234.
- Quinones, M. A., Ford, J. K., & Teachout, M. S. (1995). 工作经验与工作绩效之间的关系:概念与元分析综述. 《人事心理学》, 48(4).
- Roth, P. L., Bobko, P., McFarland, L., & Buster, M. (2008). 人员选拔中的工作样本测试:黑人与白人总体分数及练习分数差异的元分析. 《人事心理学》, 61(3).
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). 重新审视人员选拔中效度的元分析估计:处理对范围限制的系统性过度校正. 《应用心理学杂志》.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). 根据关于广泛使用预测因子效度的新发现重新审视选拔系统的设计. 《工业与组织心理学》.
- Schmidt, F. L., & Hunter, J. E. (1998). 人事心理学中选拔方法的效度与效用:85年研究发现的实践与理论意义. 《心理学公报》, 124(2).
- SHRM, & SHRM Foundation (2025). 技能优先运动:重新定义组织招聘与成长的方式. SHRM.
- Survale (2026年7月21日). 2025年候选人体验(CandE)基准研究:关键统计数据. Survale(CandE项目由Talent Board于2011年创立,现为Survale的一部分)。
- 公平与渐进就业实践三方联盟 (2023). 公平就业实践三方指南. TAFEP.
- Uhlmann, E. L., & Cohen, G. L. (2005). 建构的标准:重新定义择优以正当化歧视. 《心理科学》, 16(6).
- 华盛顿州财务管理办公室 (无日期,Wayback Machine快照 2026-04-18). 基于技能的招聘. Washington State OFM.