3 interviewere, 1 finalist, 3 domme. Uden et interviewscorecard vælger den højeste stemme i din debrief den ansatte.
Der er ingen kandidatvurderingsformular at falde tilbage på. Så ingen kan forklare tilbuddet til din CEO, eller til en afvist kandidat, der spørger.
Uden en fælles formular falder travle mennesker tilbage på mavefornemmelsen.
Og mavefornemmelser er svagere, end de føles, som Noise af Kahneman og hans medforfattere viser.
Sig, at alt du ved, er, at 1 kandidat klarede interviewet bedre end en anden. Chancen for, at de virkelig er den bedre ansættelse, er kun 56% til 61%, knap bedre end et møntkast.
Et scorecard løser dette i 3 trin. Hver interviewer scorer de samme 4 til 6 kompetencer ud fra skrevne eksempler, alene, før debriefen. Derefter afgør totalen, medmindre et must-have fejler.
Vigtige pointer
- Fører et scorecard virkelig til bedre ansættelser? Ja, hvis hver interviewer scorer de samme kompetencer ud fra skrevne eksempler. Interviews gennemført på denne måde forudsagde jobpræstation omkring dobbelt så godt som frie interviews i en gennemgang fra 2022.
- Hvor mange kompetencer bør det score? 4 til 6, hver på en skala fra 1 til 5 med et skrevet eksempelsvar pr. niveau. Ethvert must-have under 3 betyder ingen ansættelse.
- Hvordan vælger jeg mellem 2 finalister, der står lige? Tjek must-haves først, og debrief derefter en 2-mod-5-splittelse på evidens. Stem ikke om på fornemmelse: en fast formel slog ekspertvurdering i en gennemgang fra 2013.
- Hvor mange interviewere har jeg brug for? Op til 4, hver scorer alene. I Googles egne data tilføjede hvert interview efter det 4. mindre end 1% nøjagtighed.
- Kan jeg stole på AI-scoren? Brug den som 1 input, og læs dens begrundelser. I en undersøgelse fra 2023 fulgte en AI-vurdering uddannede menneskelige vurderinger tæt på kendte spørgsmål og dårligt på nye.
1. Hjælper et interviewscorecard mig faktisk med at vælge bedre ansættelser?
Ja, når hver interviewer scorer de samme kompetencer ud fra skrevne eksempler. Strukturerede interviews, hvor du stiller spørgsmålene og scorer alle på samme måde, forudsagde jobpræstation på 0,42, mere end dobbelt så meget som de 0,19 for ustrukturerede.
Tallene kommer fra Sackett og kollegers banebrydende reanalyse fra 2022 af årtiers ansættelsesforskning.
Tallene er korrelationer, fra 0 (ingen sammenhæng med senere jobpræstation) til 1 (en perfekt sammenhæng). Så 0,19 betyder ikke, at ustrukturerede interviews vælger den rigtige 20 % af gangene. Det betyder, at deres sammenhæng med senere præstation er svag.
Diagrammet nedenfor rangerer 6 almindelige metoder. Jobvidenstests på 0,40 og keyed biodata, et scoret baggrundsspørgeskema, på 0,38 kommer tæt efter.
Arbejdsprøver følger på 0,33 og kognitive evnetests på 0,31. Ustrukturerede interviews, den frie samtale de fleste af os er vokset op med, kommer sidst.
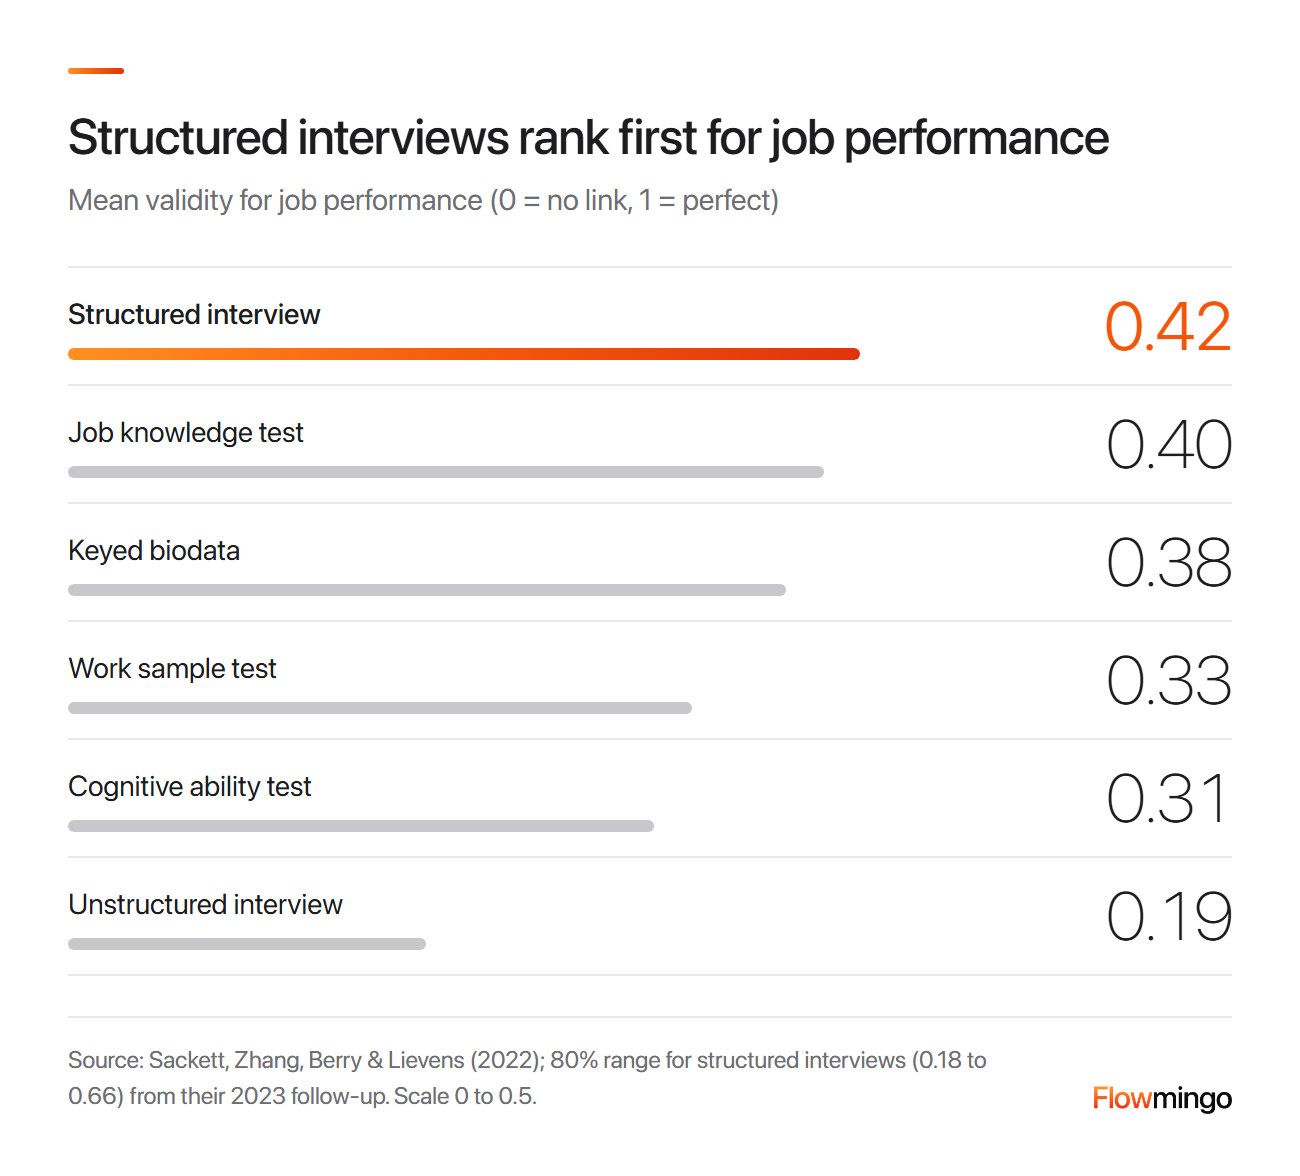
Ansættelsesmetoder rangeret efter sammenhæng med jobpræstation: strukturerede interviews fører med 0,42, ustrukturerede interviews ligger sidst med 0,19 (banebrydende reanalyse af Sackett et al.).
Men 0,42 er et gennemsnit. Forfatternes opfølgning placerer de fleste strukturerede interviews mellem 0,18, ikke bedre end en fri samtale, og 0,66, bedre end noget på diagrammet.
Design er 1 af 3 grunde, forfatterne angiver til den spredning. Det betyder, at et interview-scorecard med vage kompetencer risikerer at lande tæt på bunden. Det er gennemsnit på tværs af mange arbejdsgivere, ikke et løfte om din næste ansættelse.
2. Hvad skal min interview-scorecard-skabelon indeholde?
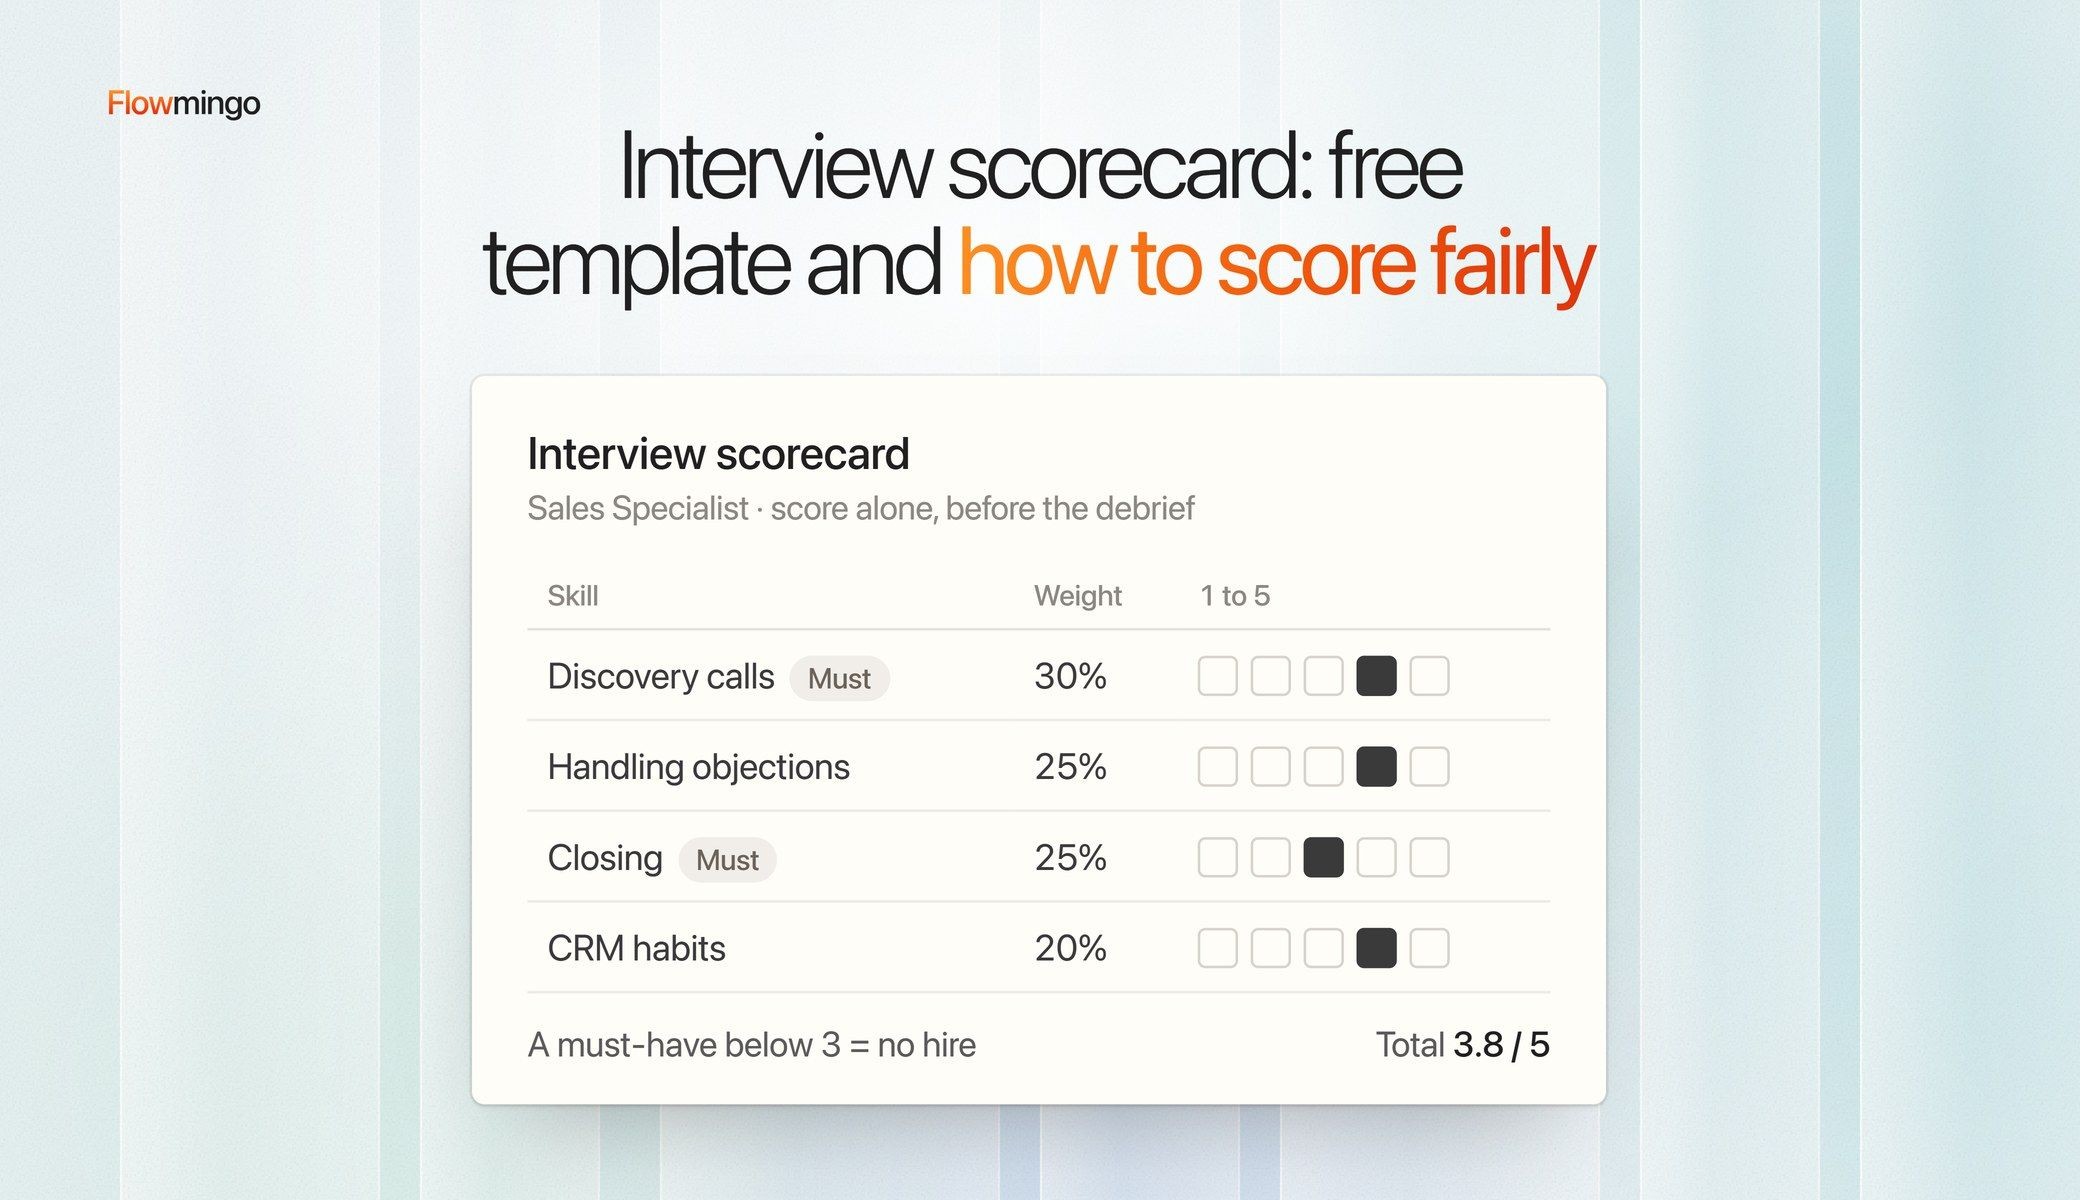
En interview-scorecard-skabelon, eller kandidatvurderingsskema, indeholder 5 kompetencer, skrevne ankerpunkter, et evidensfelt og en must-have-grænse, alt på 1 side. Den afsluttes med et samlet indtryk og en anbefaling.
Ankerpunkterne gør, at 1 interviewers 4 betyder det samme som en andens, og evidensfeltet svarer på "hvorfor", når din CEO spørger.
Gulvet forhindrer, at en stærk total skjuler et svagt must-have. Det samlede indtryk kommer sidst, for en mavefornemmelse skrevet først farver hver færdighedsscore efter den.
Her er den formular til en customer support lead med 2 must-haves. Hver af de 5 færdigheder scores fra 1 til 5, så totalen er ud af 25.
Stil 2 spørgsmål om tidligere adfærd per færdighed, for et rigtigt eksempel fra fortiden giver dig noget konkret at holde op mod ankrene. For eksempel: "Fortæl mig om sidste gang en oprevet kunde eskalerede til dig."
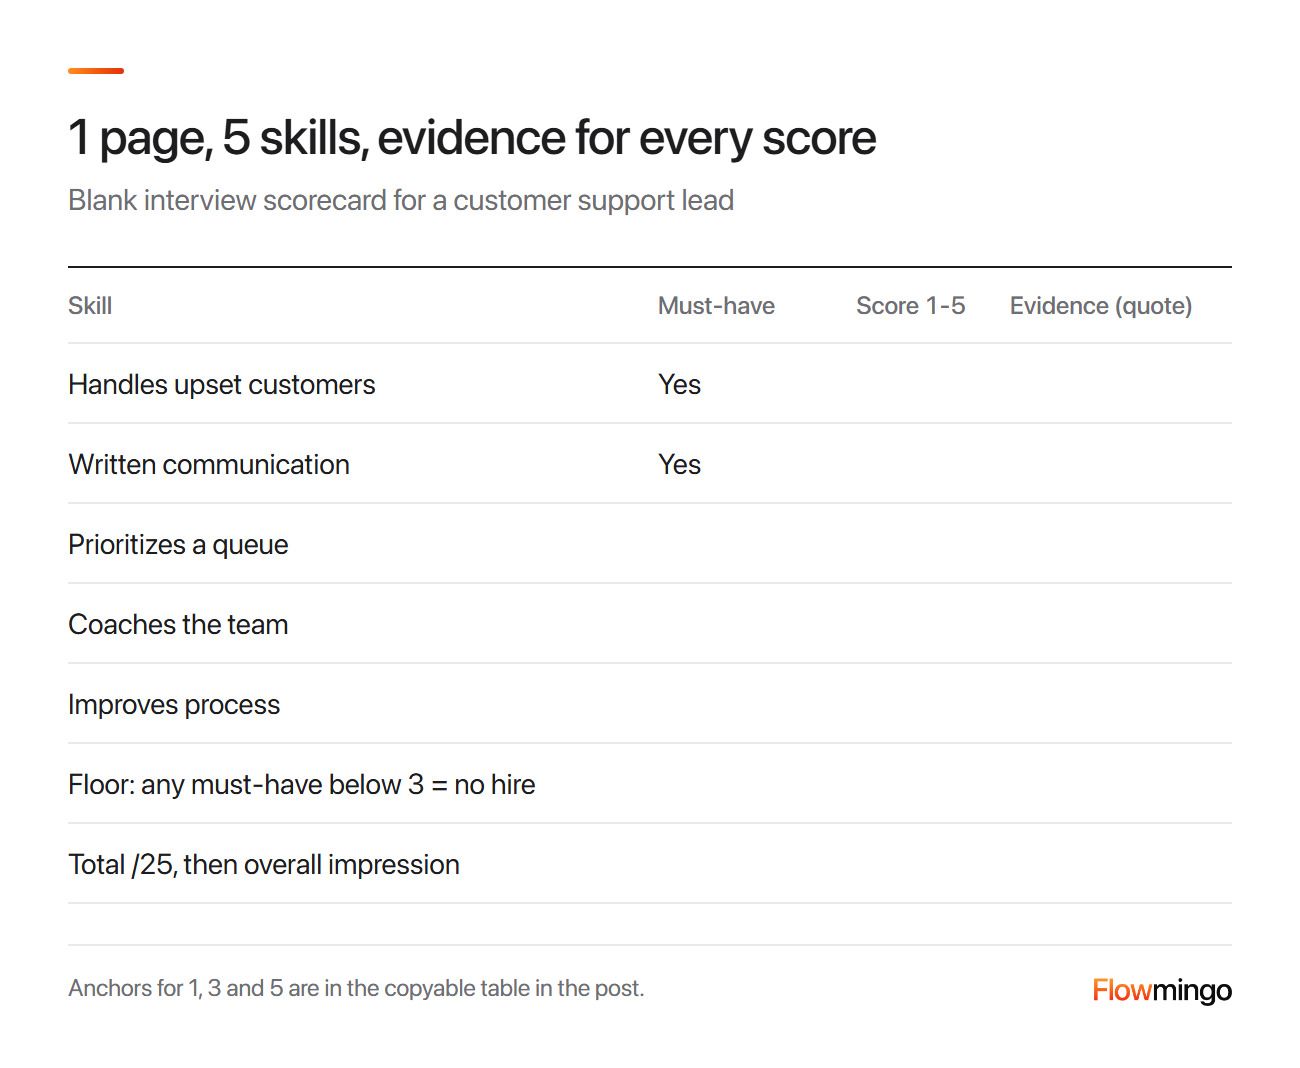
Tom interview scorecard-skabelon til en customer support lead: 5 færdigheder, 2 must-haves, en score fra 1 til 5 og et bevis-citat for hver.
Kopier tabellen, og skift derefter til dine egne færdigheder og ankere.
| Færdighed | Ankere for 1 / 3 / 5 | Score 1-5 | Bevis (citat) |
|---|---|---|---|
| Header | Kandidat, rolle, interviewer, dato | ||
| Håndterer oprevede kunder (must-have) | Bebrejder kunden / følger politik / løser årsagen | ||
| Skriftlig kommunikation (must-have) | Uklar / klar men lang / kort og klar | ||
| Prioriterer en kø | Ingen metode / efter hastighed / efter effekt | ||
| Coacher teamet | Intet eksempel / giver tips / lægger en plan | ||
| Forbedrer proces | Intet eksempel / foreslår en løsning / leverer en løsning | ||
| Must-have-gulv | Enhver must-have under 3 betyder ingen ansættelse | ||
| Ikke scoret | Følelser aflæst fra ansigt, stemme eller skrivning; accent eller tempo, medmindre jobbet kræver det; "culture fit" | ||
| Total | Sum af 5 scorer, ud af 25 | ||
| Samlet indtryk | 1 til 5, udfyldt sidst | ||
| Anbefaling | Stærk ansættelse / ansættelse / ingen ansættelse / stærkt nej; en tilsidesættelse kræver en skriftlig begrundelse |
2.1 Hvad skal jeg beslutte, før jeg bygger den?
Definér succes i rollen først, og vælg derefter de færdigheder, der skaber den. Fastlås interview scorecardet, før det første CV ankommer.
Den rækkefølge kommer fra Who, af Geoff Smart og Randy Street. Skriv 1 missionslinje, derefter 3 til 8 resultater rangordnet efter vigtighed, derefter 4 til 6 færdigheder. Et resultat er et målbart udfald, som at øge omsætningen fra $25 millioner til $50 millioner i år 3, ikke en aktivitet.
Fastlåsning betyder noget, fordi folk bøjer kriterier uden at bemærke det. I de grundlæggende Uhlmann og Cohen (2005)-studier vurderede deltagerne en gadevant og en højtuddannet ansøger til stillingen som politichef.
Uanset hvilken styrke manden havde, besluttede de, at jobbet havde mere brug for den, og kvinden fik ingen sådan bonus. At forpligte sig til kriterierne, før man ser ansøgerne, fjernede den bias. Så et scorecard skrevet efter du møder kandidater, kan stille og roligt bøje sig mod den, du allerede kan lide.
2.2 Bør kulturelt match være på scorecardet?
Ikke som beskrevet, for ingen kan score det ens to gange. Lav det om til 1 eller 2 observerbare adfærdstræk, som "beder om feedback på sit eget arbejde".
Sig, at dit team værdsætter åbenhed: score i stedet "gav et konkret eksempel på at have flagget en fejl tidligt".
3. Hvordan vægter jeg interviewscorer, så must-haves tæller mest?
Giv hver kompetence lige vægt, og tilføj en must-have-bundgrænse, eller fastlæg vægtene før det første interview. Lige vægte forudsiger ofte nye cases lige så godt som vægte tilpasset tidligere data.
Det andet punkt kommer fra psykologen Robyn Dawes, som Kahneman opsummerer det i Thinking, Fast and Slow.
Vægte finjusteret efter dine tidligere ansættelser lærer også den gruppes tilfældigheder. Sig, at dine 3 bedste supportansættelser alle tilfældigvis var stærke coaches: en finjusteret vægt ville favorisere coaching hos enhver fremtidig kandidat.
Lige vægte kan ikke jagte en sådan tilfældighed, og derfor forudsiger de ofte nye kandidater lige så godt. Hold også kompetencerne uafhængige, som Kahneman anbefaler: undlad at liste både "kommunikation" og "præsentationsevner", for sammen tæller de det samme to gange.
En must-have får sin kraft fra bundgrænsen, ikke fra en større vægt. Sig, at "Håndterer oprørte kunder" scorer 2, og alle andre kompetencer scorer 5.
Totalen på 22 ud af 25 ser god ud, men bundgrænsen siger stadig nej til ansættelse. Det er præcis, hvad du vil have for en kompetence, som jobbet ikke kan undvære.
Hvis du endelig vægter, så skriv vægtene på interviewets scorecard på forhånd, og anvend dem på alle. Det lukker den nemmeste måde at bøje en total på: at ændre vægte, efter du har mødt en, du godt kan lide.
Sådan hjælper Flowmingo
Flowmingos AI-interviewrapport bruger faste vægte: et Must Have-kriterium tæller 4 gange en Good to Have i den samlede score. Hvert kriterium beholder sin egen score fra 0 til 10, så du kan stadig selv anvende en must-have-bundgrænse.
4. Hvordan får jeg et 3-tal til at betyde det samme for alle interviewere?
Skriv ned, hvad et 1-, et 3- og et 5-svar indeholder for hver kompetence, inden det første interview. Denne adfærdsforankrede vurderingsskala gør 2 interviewerers score sammenlignelige.
"Adfærdsforankret" betyder blot, at hver score knytter sig til, hvad kandidaten gjorde, og ikke til en fornemmelse som "ret god". Uden forankring betyder et 3-tal på samme interviewscorecard "fint" for én interviewer og "svagt" for en anden.
Forankrede interviews viser også stærkere gennemsnitlige sammenhænge med senere præstation. Taylor og Smalls grundlæggende gennemgang af 19 undersøgelser af adfærdsbaserede interviews fandt en sammenhæng på .35 med forankrede skalaer mod .26 uden. Undersøgelserne adskilte sig også på andre måder, så denne sammenligning isolerer ikke effekten af at tilføje forankring.
Her er interviewvurderingsskalaen for det ufravigelige krav "Håndterer oprørte kunder".
| Score | Hvad svaret indeholder |
|---|---|
| 1 | Giver kunden skylden; ingen egen handling og intet resultat |
| 3 | Et konkret eksempel: beroliger kunden og følger politikken, men tjekker aldrig resultatet |
| 5 | Et konkret eksempel: finder årsagen, løser den, følger op og deler løsningen |
Hvert trin op er noget, du kan høre i svaret. Derfor kan 2 lyttere lande på samme tal.
Hvis du endnu ikke kan skrive forankringer, kan du låne de 5 niveauer i guiden til strukturerede interviews fra OPM, det amerikanske føderale HR-agentur. Hvert niveau afhænger af, hvor svær situationen var, og hvor meget vejledning personen havde brug for.
- 1, Bevidsthed: de simpleste situationer, med tæt og omfattende vejledning.
- 2, Grundlæggende: noget vanskelige situationer, med hyppig vejledning.
- 3, Mellemniveau: vanskelige situationer, med lejlighedsvis vejledning.
- 4, Avanceret: betydeligt vanskelige situationer, med lidt eller ingen vejledning.
- 5, Ekspert: usædvanligt vanskelige situationer, hvor personen rådgiver andre.
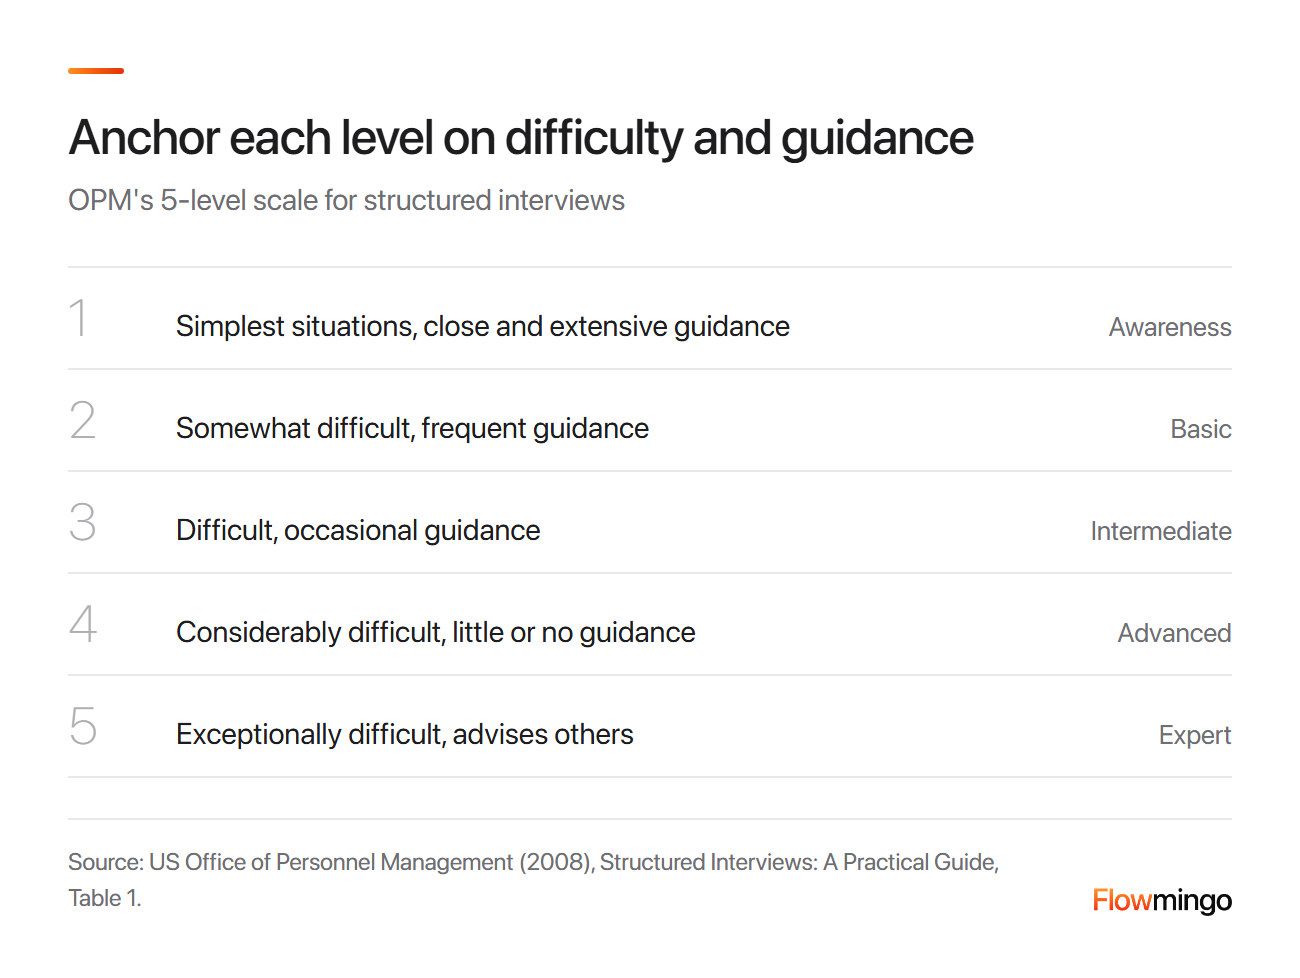
OPM's 5 vurderingsniveauer til strukturerede interviews: fra Bevidsthed (simpleste situationer, tæt vejledning) til Ekspert (usædvanligt vanskelige situationer, rådgiver andre).
5. Hvordan vælger jeg mellem 2 stærke finalister, når mine interviewere er uenige?
Lad interviewscorekortets samlede sum afgøre det, med 2 undtagelser: et must-have under 3, eller en 2-mod-5-splittelse, som I debrief er på baggrund af evidens. Stem ikke igen ud fra mavefornemmelse.
Det er det øjeblik, scorekort findes for, og det øjeblik, hvor det er mest fristende at droppe dem. Her er et illustrativt eksempel, ikke kundedata: 3 finalister til support lead, hvor hver celle er et gennemsnit på tværs af 3 interviewere.
| Kompetence | A | B | C |
|---|---|---|---|
| Håndterer ophidsede kunder (must-have) | 4 | 2 | 4 |
| Skriftlig kommunikation (must-have) | 4 | 4 | 3 |
| Prioriterer en kø | 3 | 4 | 3 |
| Coacher teamet | 3 | 4 | 4 (scorer 2, 5, 5) |
| Forbedrer processer | 4 | 4 | 3 |
| I alt, ud af 25 | 18 | 18 | 17 |
| Beslutning | Ansæt | Ikke ansæt: gulvet udløses | Debrief splittelsen |
Læs interviewscorekortet række for række. A og B ligger lige på 18 ud af 25. Men B scorede 2 på et must-have, så gulvet udløses, og B er ikke ansæt.
C har i alt 17, men C's gennemsnit på 4 på "Coacher teamet" skjuler en splittelse: 1 interviewer gav 2, og de andre 2 gav 5. Det gab bliver det eneste punkt på debriefens dagsorden.
I praksis kan I bede hver side læse deres evidenscitater op. Sig, at den lave scorer hørte om et teammedlem, der stoppede, og de andre hørte om en coachingplan, der virkede. Debriefen afgør, hvilken historie der er mest typisk for C, og enhver, der har overset evidens, ændrer scoren skriftligt.
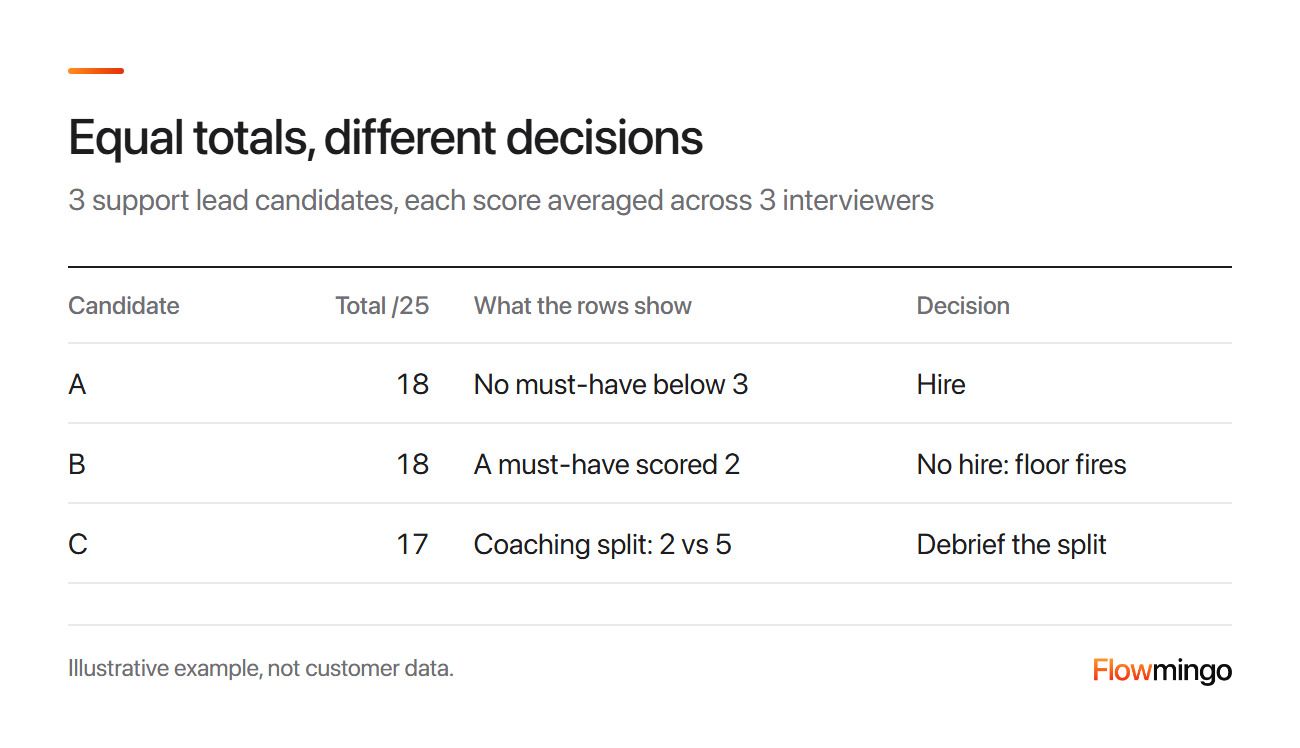
Udfyldt interviewscorekort, illustrativt: A og B ligger lige på 18 af 25, B mangler et must-have, og C har en coaching-splittelse, der skal debriefes.
Når scorerne peger på en finalist, skal du skrive betingelserne ind i tilbuddet, før du sender det: vores skabelon til jobtilbudsbrev viser, hvor hvert tjek hører til.
5.1 Hvad hvis min mavefornemmelse siger én ting, og scorerne siger en anden?
Følg scorerne, medmindre du kan skrive den evidens ned, de har overset. I Kuncel og kollegers grundlæggende meta-analyse fra 2013 forudsagde en formel anvendt ens for alle jobpræstation med 0,44 mod 0,28 for holistisk vurdering. Forfatterne kalder det en forbedring i forudsigelse på over 50 %, selv sammenlignet med eksperter, der kendte jobbet.
Holistisk vurdering betyder, at folk vejer de samme fakta i hovedet, inklusive konsensusmøder. Så debriefen udfylder evidenshuller og stemmer ikke igen.
5.2 Bør jeg sammenligne finalister side om side?
Ja, svar for svar. Bohnets HBR-råd er at sammenligne alle svar på spørgsmål 1, derefter spørgsmål 2, så du vurderer hvert svar op imod de andre.
I et grundlæggende laboratoriestudie fra 2016 hældede folk, der blev præsenteret for 1 kandidat ad gangen, mod det køn, som opgavens stereotype favoriserede. Tidligere præstationer betød næsten intet. Da de blev præsenteret for 2 side om side, valgte de den bedst præsterende 54% af gangene og den dårligst præsterende 8%.
Studiet brugte tidligere opgavescorer, ikke interviews, så betragt det som et stærkt hint snarere end bevis.
6. Hvordan forhindrer jeg, at den mest højtråbende interviewer vinder debriefen?
Lad hver interviewer aflevere deres interviewscorecard, før nogen taler, og åbn derefter debriefen med scorerne.
Forestil dig, at en senior person åbner med "jeg elskede hende", og lokalet begynder at glide mod den opfattelse. Scorer skrevet alene beskytter alle mod den tiltrækning, hvilket er grunden til, at Noise gør uafhængig scoring til en ansættelsesregel.
I praksis kan du indsamle scorer i et delt regneark eller dit applicant tracking system og afsløre dem alle på én gang.
Et panel, hvor alle ser det samme interview, ser ud som en løsning. I Huffcutt og kollegers grundlæggende meta-analyse fra 2013 var panelbedømmerne enige i 0,74 mod 0,44 for separate interviews på en skala fra 0 til 1.
Det tal smigrer paneler. Paneldeltagere scorer alle den samme præstation samme dag, så hvis kandidaten havde en usædvanligt god eller dårlig morgen, ser de det alle sammen.
Som Iris Bohnet formulerede det i en tale hos Google: "the sample size of a panel interview is basically one". Separate interviews, hver scoret alene, giver dig flere uafhængige blikke.
6.1 Hvor mange interviewere bør score hver kandidat?
Op til 4, i separate samtaler. I Googles interne data, ikke et peer-reviewed studie, forudsagde 4 samtaler ansættelsesbeslutningen med 86 % sikkerhed. Hver ekstra tilføjede mindre end 1 %.
Ekstra samtaler tilføjede lidt til at forudsige Googles egen ansættelsesbeslutning. Brug det som en påmindelse om at begrunde hver runde, ikke som et universelt maksimum eller bevis for senere jobpræstation.
7. Hvordan får jeg travle interviewere til rent faktisk at udfylde interviewscorecardet?
Gør scoring til en del af samtalen. Score hver kompetence lige efter dens spørgsmål, skriv et citat på 1 linje som bevis, og giv det samlede indtryk til sidst.
Ingen har lyst til endnu et skema efter en hel dag med samtaler. Derfor foregår scoringen inde i samtalen, ikke som lektier for i aften.
Kahneman udviklede denne metode til den israelske hær i 1955, efter at frie samtaler viste sig næsten ubrugelige til at forudsige succes. Interviewerne scorede 6 træk på en skala fra 1 til 5 og afsluttede hvert, før de begyndte på det næste, så et førsteindtryk ikke kunne farve resten.
Først derefter lukkede de øjnene og gav en samlet vurdering, og totalen forudsagde meget mere præcist end før. Hans råd: ansæt den med den højeste total, "selv hvis der er en anden, du bedre kan lide".
Timing betyder også noget. I et feltstudie rapporterede 166 interviewere, hvornår de havde truffet deres beslutning. Kun 4,9 % af beslutningerne faldt i det første minut, men 22,5 % faldt efter, at samtalen var slut.
En beslutning, der træffes efter kandidaten er gået, hviler på hukommelsen, så score mens du går.
For vores support lead ser det sådan ud:
- Stil de 2 køspørgsmål, og score derefter "Prioriterer en kø", før du går videre.
- Skriv 1 citat som bevis, for eksempel "Jeg sorterer bugs efter, hvor mange kunder de berører."
- Hold samme rækkefølge af kompetencer for hver kandidat.
Skriftligt bevis er sjældent i vores data.
Flowmingo-data · 86.638 AI-interviewede kandidater · 2.574 virksomheder · jul 2025 til sep 2026
- 0,3% af de AI-interviewede kandidater fik en skriftlig kommentar fra ansættelsesteamet (258 af 86.638).
Teams kan gemme noter andre steder; inde i Flowmingo er AI-rapporten normalt den eneste skriftlige evaluering, der ligger i systemet.
En skriftlig begrundelse er det første, man springer over på en travl dag. Derfor beder formularen kun om 1 citat pr. kvalifikation.
8. Kan jeg stole på en AI-score på mit interview-scorecard?
Brug den som 1 input, som en person gennemgår, og læs først dens begrundelser. AI-scoring kan falde kraftigt på spørgsmål, den ikke er trænet til.
Vi har en interesse i dette svar, så dokumentationen nedenfor indeholder også den del, der ikke stiller AI i et flatterende lys.
I et grundlæggende studie fra 2023 scorede 2 trænede bedømmere 7.017 ansøgersvar på en ankerbaseret skala fra 1 til 5. En model trænet på de samme spørgsmål matchede deres score tæt med 0,75 på en skala fra 0 til 1. På spørgsmålsformater, den aldrig havde set, faldt den til 0,30, et svagt match.
Det betyder, at en AI-score kun er så god som sin spørgespecifikke rubric, så læs dens begrundelser, før du stoler på tallet. Bemærk også, at 3 af studiets 5 forfattere arbejdede hos AI-interviewudbyderen Modern Hire.
Sådan hjælper Flowmingo
Flowmingos AI Interviewer scorer ud fra kriterier, du godkender. AI udarbejder spørgsmålene og kriterierne ud fra dit jobopslag, og du redigerer begge dele. Du sender interviewet til hver ansøger, så de kan tage det på et tidspunkt, der passer dem.
Du får optagelsen, transskriptionen og hvert kriterium vurderet fra 0 til 10 med en skriftlig begrundelse. Du træffer ansættelsesbeslutningen.
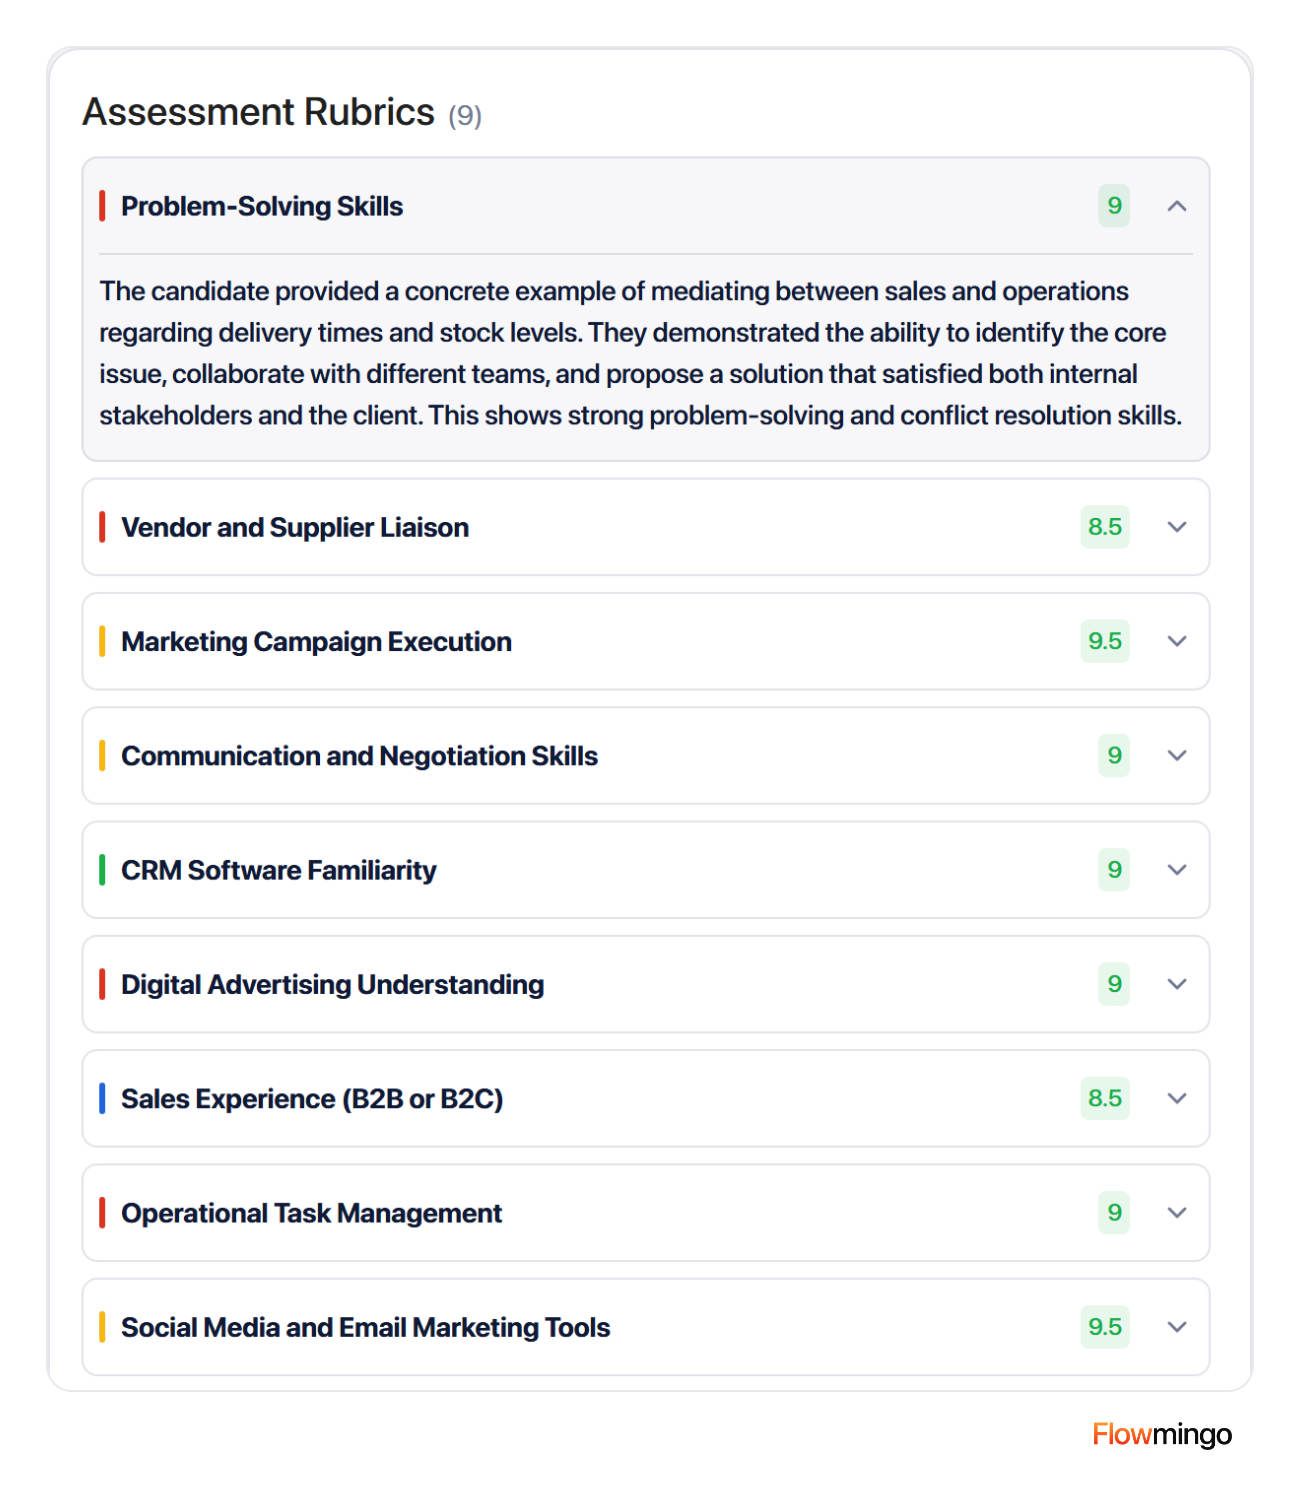
Flowmingos offentlige eksempelrapport: en score fra 0 til 10 og begrundelse pr. kriterium, så sæt en hvilken som helst minimumsgrænse på den skala.
I vores data er CV'et og interviewet heller ikke enige om, hvem der er bedst.
Flowmingo-data · 34.114 kandidater · 379 virksomheder · jul 2025 til sep 2026
- 19,2% af 532 projekter med 1 klar top-interviewscore gav også den kandidat den højeste CV-score.
- 54,9% af de 3.684 kandidater, der scorede 8 eller mere i interviewet (2.022), ville være blevet sorteret fra af en CV-shortliste med top-20%.
Begge er Flowmingo AI-scorer, ikke jobpræstation, og de interviewede er en udvalgt gruppe. Dataene viser, at de 2 rangeringer er forskellige, ikke hvilken der er rigtig.
Enkelt sagt: I omkring 4 ud af hver 5 af disse projekter havde den, der scorede højest i interviewet, ikke også den højeste CV-score. Så bedøm interviewet for sig selv i stedet for at lade CV-scoren følge med over.
9. Beskytter mine scorecards mig, hvis en afvist kandidat klager?
De hjælper, hvis de vurderer jobrelevante beviser, og du gemmer dem. Ved en rimelig fortolkning betyder de amerikanske føderale regler, at du skal gemme scorecards i mindst 1 år, og Californiens regler i 4 år.
En klage kan komme måneder senere, når ingen husker interviewet. Et interview-scorecard med et citat pr. kompetence viser, hvad du vurderede, og hvorfor.
Den amerikanske regel nævner ikke scorecards, men den dækker "andre registreringer med tilknytning til ansættelse". Når nogen indgiver en klage om diskrimination, skal du gemme enhver relevant registrering, indtil sagen er afsluttet. Det omfatter andre kandidaters registreringer for samme job, så 1 klage fastfryser hele sættet.
Disse regler gælder pr. september 2026. Dette er et resumé, ikke juridisk rådgivning.
| Regel | Hvor | Hvad det betyder for dit scorecard |
|---|---|---|
| 29 CFR 1602.14 | USA | Gem ansættelsesregistreringer i 1 år, længere efter en klage |
| 2 CCR 11013(c) | Californien | Gem registreringer i 4 år, inklusive data om automatiserede beslutninger |
| ICO-vejledning | Storbritannien | Kandidater kan anmode om interviewnotater; oplys enhver tie-break-regel |
| TAFEP | Singapore | Brug en evalueringsformular, og gem registreringer i mindst 1 år |
| 29 CFR 1630.11 (ADA) | USA | Hvis et handicap påvirker talen, skal du vurdere kompetencen, ikke talen, medmindre det at tale er det, jobbet kræver |
| AI-forordningen, artikel 5(1)(f) | EU, siden 2. februar 2025 | Ingen AI, der udleder kandidaters følelser fra ansigter, kropsholdning eller tastetryk |
| AI-forordningen, bilag III og artikel 26 | EU, fra 2. december 2027 | Høj risiko: menneskeligt tilsyn, logfiler gemt i 6+ måneder, kandidater informeres |
| Local Law 144 | New York City | En AI-score, der bruges alene, vægtes højere end alt andet eller bruges til at tilsidesætte mennesker: årlig revision for bias og underretning |
| AI Video Interview Act | Illinois | Underretning, forklaring og samtykke først; slet videoer inden for 30 dage efter en anmodning |
Derfor har skabelonen en "Ikke vurderet"-række. EU forbyder AI, der læser kandidaters følelser ud fra ansigter, kropsholdning eller tastetryk, og den amerikanske handicapplov (ADA) beskytter kandidater, hvis handicap påvirker talen. I Storbritannien kan kandidater bede om dine notater, så skriv hver bevismæssig linje, som om de vil læse den.
For at lave en selvrevison kan du sammenligne beståelsesprocenter gruppe for gruppe med 4/5-tommelfingerreglen i Uniform Guidelines. Sig, at 30 % af 1 gruppe består, og 50 % af en anden: 30 divideret med 50 er 0,6, under 0,8, så se nærmere på det.
En udtalelse fra Justitsministeriet fra juni 2026 og en OPM-regel fra juli 2026 flytter føderale agenturer væk fra Guidelines. De er dog stadig i de føderale regler, så behandl tjekket som en billig vane, ikke en juridisk grænse.
10. Hvordan ruller jeg et interview-scorecard ud med mit team i denne uge?
Byg det i denne rækkefølge, og ændr det kun mellem stillinger. En første version behøver ikke være perfekt, men den skal være den samme for hver kandidat.
- Skriv 1 missionslinje og 3 til 8 rangerede resultater.
- Omsæt dem til 5 kompetencer, og markér must-have-kravene.
- Skriv 2 spørgsmål om tidligere adfærd og ankre for 1, 3 og 5 pr. kompetence.
- Lad op til 4 interviewere score alene og indsende, før debriefen.
- Lad totalen afgøre det, men ethvert must-have under 3 betyder ingen ansættelse. Skriv hver tilsidesættelse ned.
I praksis: start med 1 åben stilling, så dit team lærer vanen på noget virkeligt. Før den første samtale skal alle score det samme eksempelsvar og sammenligne.
Hvis 2 scorer ligger mere end 1 point fra hinanden, skal du omskrive ankeret, indtil de er enige. De trænede bedømmere i undersøgelsen i afsnit 8 brugte samme 1-points afstand til at indkalde til et møde.
Forvent noget modstand. Kahnemans hærs interviewere modsatte sig også bare at registrere svar, og hans løsning var luk-øjnene-vurderingen, som gav deres dømmekraft en plads i skemaet. Din linje for det samlede indtryk gør det samme for dit team.
Sådan hjælper Flowmingo
For at sende hver ansøger en struktureret samtale, de kan tage på et tidspunkt, der passer dem, optaget og scoret efter 1 interview-scorecard, prøv Flowmingo.
11. Kilder
Alle eksterne tal ovenfor kommer fra kilderne nedenfor, i rækkefølgen de optræder. Flowmingos egne tal står i databoksene, jul 2025 til sep 2026.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.