ຜູ້ສຳພາດ 3 ຄົນ, ຜູ້ເຂົ້າຮອບສຸດທ້າຍ 1 ຄົນ, ຄຳຕັດສິນ 3 ແບບ. ຖ້າບໍ່ມີ ໃບໃຫ້ຄະແນນການສຳພາດ, ສຽງທີ່ດັງທີ່ສຸດໃນການປະເມີນຜົນຂອງທ່ານຈະເປັນຜູ້ເລືອກຄົນທີ່ຈະຮັບເຂົ້າວຽກ.
ບໍ່ມີແບບຟອມປະເມີນຜູ້ສະໝັກໃຫ້ກັບໄປເບິ່ງ. ດັ່ງນັ້ນ ຈຶ່ງບໍ່ມີໃຜສາມາດອະທິບາຍຂໍ້ສະເໜີຕໍ່ CEO ຂອງທ່ານ, ຫຼື ຕໍ່ ຜູ້ສະໝັກທີ່ຖືກປະຕິເສດທີ່ຖາມຂຶ້ນມາ ໄດ້.
ຖ້າບໍ່ມີແບບຟອມຮ່ວມກັນ, ຄົນທີ່ຫຼຸດຫຼາຍຈະກັບໄປໃຊ້ຄວາມຮູ້ສຶກ.
ແລະ ການຕັດສິນຕາມຄວາມຮູ້ສຶກນັ້ນອ່ອນແອກວ່າທີ່ຮູ້ສຶກ, ດັ່ງທີ່ Noise ໂດຍ Kahneman ແລະ ຜູ້ຮ່ວມຂຽນສະແດງໃຫ້ເຫັນ.
ສົມມຸດວ່າທ່ານຮູ້ພຽງແຕ່ວ່າ ຜູ້ສະໝັກ 1 ຄົນ ສຳພາດໄດ້ດີກວ່າອີກຄົນໜຶ່ງ. ໂອກາດທີ່ເຂົາຈະເປັນຄົນທີ່ເໝາະສົມກວ່າຢ່າງແທ້ຈິງ ມີພຽງ 56% ຫາ 61% ເທົ່ານັ້ນ, ດີກວ່າການໂຍນເຫຼັ້ມຫຼຽນພຽງເລັກນ້ອຍ.
ໃບໃຫ້ຄະແນນແກ້ບັນຫານີ້ໄດ້ໃນ 3 ຂັ້ນຕອນ. ຜູ້ສຳພາດທຸກຄົນໃຫ້ຄະແນນທັກສະດຽວກັນ 4 ຫາ 6 ຢ່າງ ທຽບກັບຕົວຢ່າງທີ່ຂຽນໄວ້, ໂດຍຕ່າງຄົນຕ່າງໃຫ້ ກ່ອນການປະເມີນຜົນ. ຈາກນັ້ນ ຄະແນນລວມເປັນຕົວຕັດສິນ, ເວັ້ນເສຍແຕ່ວ່າລະດັບຂັ້ນຕ່ຳທີ່ຕ້ອງມີບໍ່ຜ່ານ.
ຂໍ້ສຳຄັນ
- ໃບໃຫ້ຄະແນນນຳໄປສູ່ການຮັບຄົນເຂົ້າວຽກທີ່ດີກວ່າແທ້ບໍ? ແມ່ນ, ຖ້າຜູ້ສຳພາດທຸກຄົນໃຫ້ຄະແນນທັກສະດຽວກັນ ທຽບກັບຕົວຢ່າງທີ່ຂຽນໄວ້. ການສຳພາດແບບນີ້ ຄາດຄະເນຜົນການເຮັດວຽກໄດ້ດີກວ່າແບບບໍ່ມີໂຄງສ້າງ ປະມານສອງເທົ່າ ໃນການທົບທວນປີ 2022.
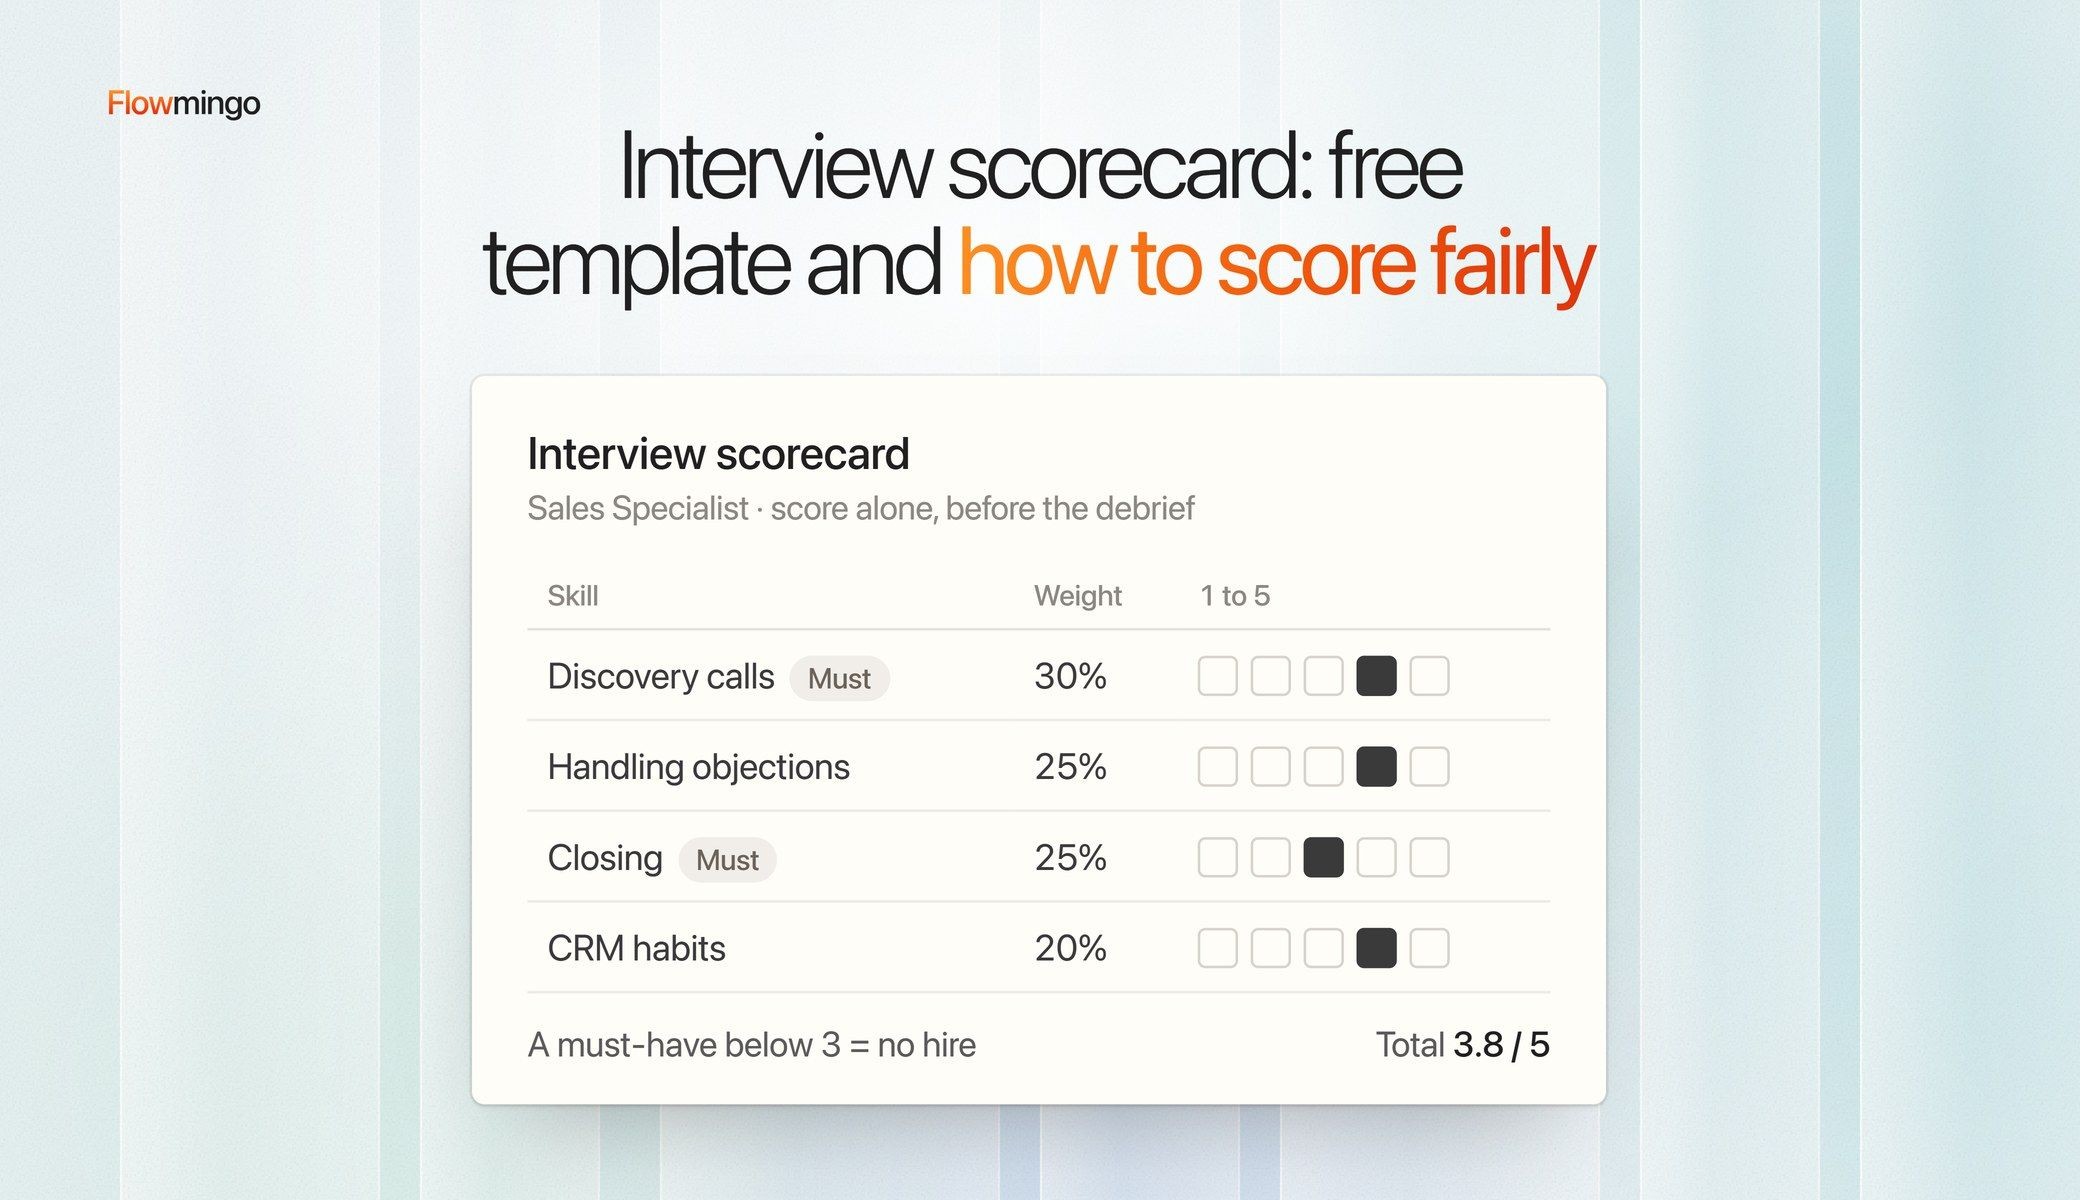
- ຄວນໃຫ້ຄະແນນຈັກທັກສະ? 4 ຫາ 6 ຢ່າງ, ແຕ່ລະຢ່າງໃຊ້ມາດຕະສ່ວນ 1 ຫາ 5 ພ້ອມຄຳຕອບຕົວຢ່າງທີ່ຂຽນໄວ້ຕໍ່ແຕ່ລະລະດັບ. ລະດັບຂັ້ນຕ່ຳທີ່ຕ້ອງມີອັນໃດຕ່ຳກວ່າ 3 ໝາຍຄວາມວ່າບໍ່ຮັບເຂົ້າວຽກ.
- ຈະເລືອກລະຫວ່າງຜູ້ເຂົ້າຮອບສຸດທ້າຍ 2 ຄົນທີ່ຄະແນນເທົ່າກັນໄດ້ແນວໃດ? ກວດລະດັບຂັ້ນຕ່ຳທີ່ຕ້ອງມີກ່ອນ, ຈາກນັ້ນປະເມີນຜົນການແຕກຕ່າງ 2 ຕໍ່ 5 ໂດຍອີງໃສ່ຫຼັກຖານ. ຢ່າລົງຄະແນນສຽງຄືນຕາມຄວາມຮູ້ສຶກ: ສູດຕາຍຕົວເອີ້ນໄດ້ຊະນະການຕັດສິນຂອງຜູ້ຊ່ຽວຊານ ໃນການທົບທວນປີ 2013.
- ຕ້ອງການຜູ້ສຳພາດຈັກຄົນ? ສູງສຸດ 4 ຄົນ, ແຕ່ລະຄົນໃຫ້ຄະແນນຕ່າງຄົນຕ່າງ. ໃນຂໍ້ມູນຂອງ Google ເອງ, ການສຳພາດແຕ່ລະຄັ້ງຫຼັງຈາກຄັ້ງທີ 4 ເພີ່ມຄວາມແມ່ນຍຳໜ້ອຍກວ່າ 1%.
- ໄວ້ໃຈຄະແນນ AI ໄດ້ບໍ? ໃຫ້ໃຊ້ເປັນຂໍ້ມູນ 1 ຢ່າງ ແລະ ອ່ານເຫດຜົນຂອງມັນ. ໃນການສຶກສາປີ 2023, ຜູ້ໃຫ້ຄະແນນ AI ຕາມຜູ້ໃຫ້ຄະແນນມະນຸດທີ່ຜ່ານການຝຶກອົບຮົມໄດ້ຢ່າງໃກ້ຊິດ ໃນຄຳຖາມທີ່ຄຸ້ນເຄີຍ ແລະ ໄດ້ບໍ່ດີ ໃນຄຳຖາມໃໝ່.
1. ໃບໃຫ້ຄະແນນການສຳພາດຊ່ວຍໃຫ້ຂ້ອຍເລືອກຄົນທີ່ດີກວ່າໄດ້ແທ້ບໍ?
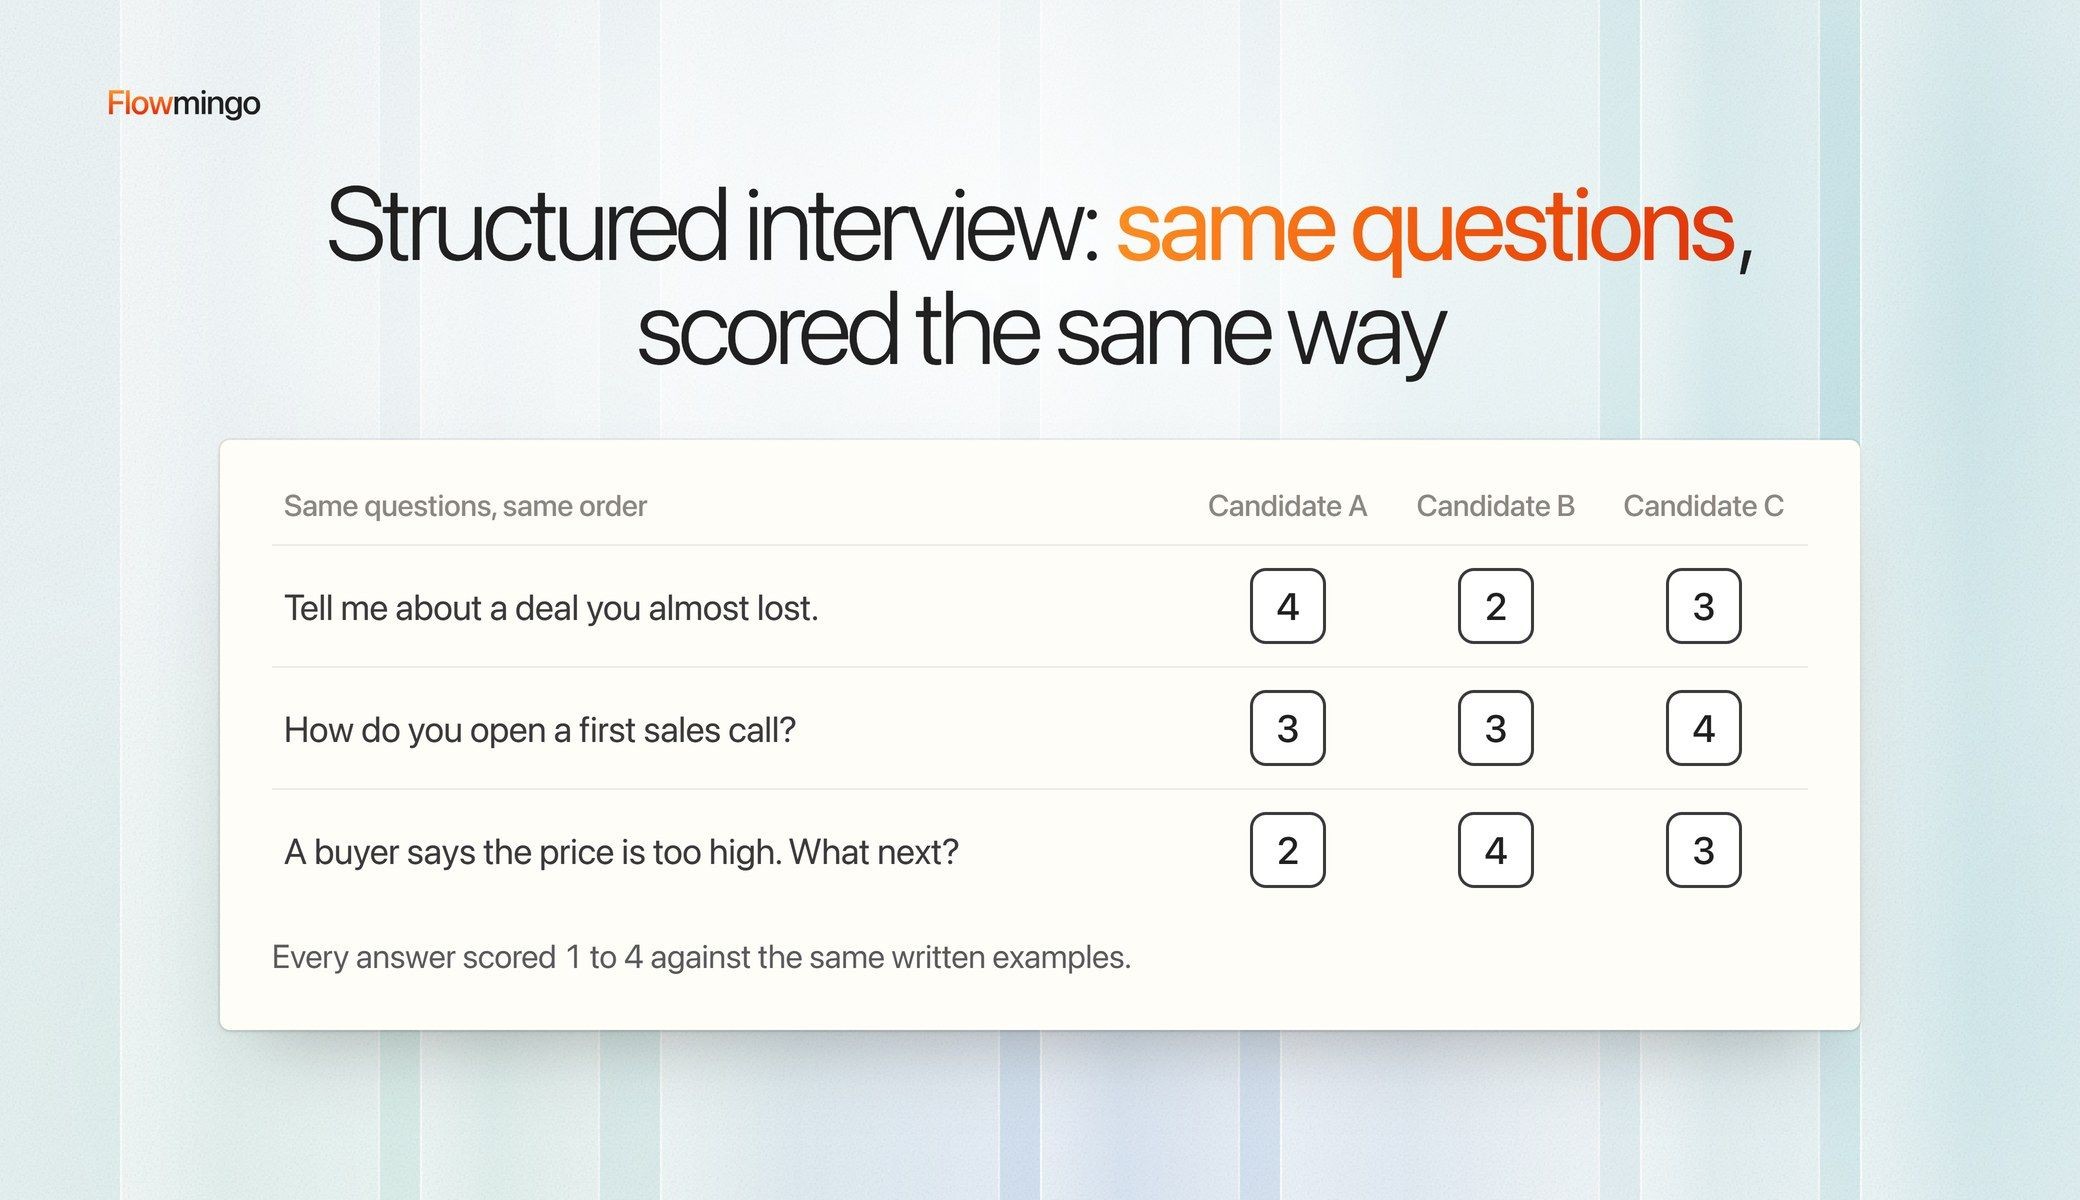
ແມ່ນແລ້ວ, ເມື່ອຜູ້ສຳພາດທຸກຄົນໃຫ້ຄະແນນທັກສະດຽວກັນຕາມຕົວຢ່າງທີ່ຂຽນໄວ້. ການສຳພາດແບບມີໂຄງຮ່າງ, ບ່ອນທີ່ທ່ານຖາມ ແລະ ໃຫ້ຄະແນນທຸກຄົນໃນແບບດຽວກັນ, ຄາດຄະເນຜົນການເຮັດວຽກໄດ້ 0.42, ຫຼາຍກວ່າ 2 ເທົ່າຂອງ 0.19 ຂອງການສຳພາດແບບບໍ່ມີໂຄງຮ່າງ.
ຕົວເລກເຫຼົ່ານັ້ນມາຈາກ ການວິເຄາະຄືນໃໝ່ທີ່ເປັນພື້ນຖານໃນປີ 2022 ຂອງ Sackett ແລະ ເພື່ອນຮ່ວມງານ ກ່ຽວກັບການຄົ້ນຄວ້າການຈ້າງງານຫຼາຍທົດສະວັດ.
ຕົວເລກເຫຼົ່ານີ້ແມ່ນຄ່າສະຫຼະສໍາພັນ, ຈາກ 0 (ບໍ່ມີຄວາມກ່ຽວຂ້ອງກັບຜົນການເຮັດວຽກໃນພາຍຫຼັງ) ຫາ 1 (ຄວາມກ່ຽວຂ້ອງທີ່ສົມບູນແບບ). ດັ່ງນັ້ນ 0.19 ບໍ່ໄດ້ໝາຍຄວາມວ່າການສຳພາດແບບບໍ່ມີໂຄງຮ່າງເລືອກໄດ້ຖືກຕ້ອງ 20% ຂອງເວລາ. ມັນໝາຍຄວາມວ່າຄວາມກ່ຽວຂ້ອງຂອງມັນກັບຜົນການເຮັດວຽກໃນພາຍຫຼັງແມ່ນອ່ອນແອ.
ຕາຕະລາງຂ້າງລຸ່ມຈັດອັນດັບ 6 ວິທີການທົ່ວໄປ. ການທົດສອບຄວາມຮູ້ດ້ານວຽກຢູ່ທີ່ 0.40 ແລະ ຂໍ້ມູນຊີວະປະຫວັດແບບກຳນົດຄະແນນ, ເຊິ່ງເປັນແບບສອບຖາມປະຫວັດພື້ນຫຼັງທີ່ໃຫ້ຄະແນນ, ຢູ່ທີ່ 0.38 ມາໃນອັນດັບຮອງລົງມາ.
ການທົດສອບຕົວຢ່າງວຽກຕາມມາຢູ່ທີ່ 0.33 ແລະ ການທົດສອບຄວາມສາມາດທາງດ້ານສະຕິປັນຍາຢູ່ທີ່ 0.31. ການສຳພາດແບບບໍ່ມີໂຄງຮ່າງ, ເຊິ່ງເປັນການລົມກັນແບບອິດສະຫຼະທີ່ພວກເຮົາສ່ວນຫຼາຍເຄີຍພົບມາແຕ່ນ້ອຍ, ມາເປັນອັນດັບສຸດທ້າຍ.
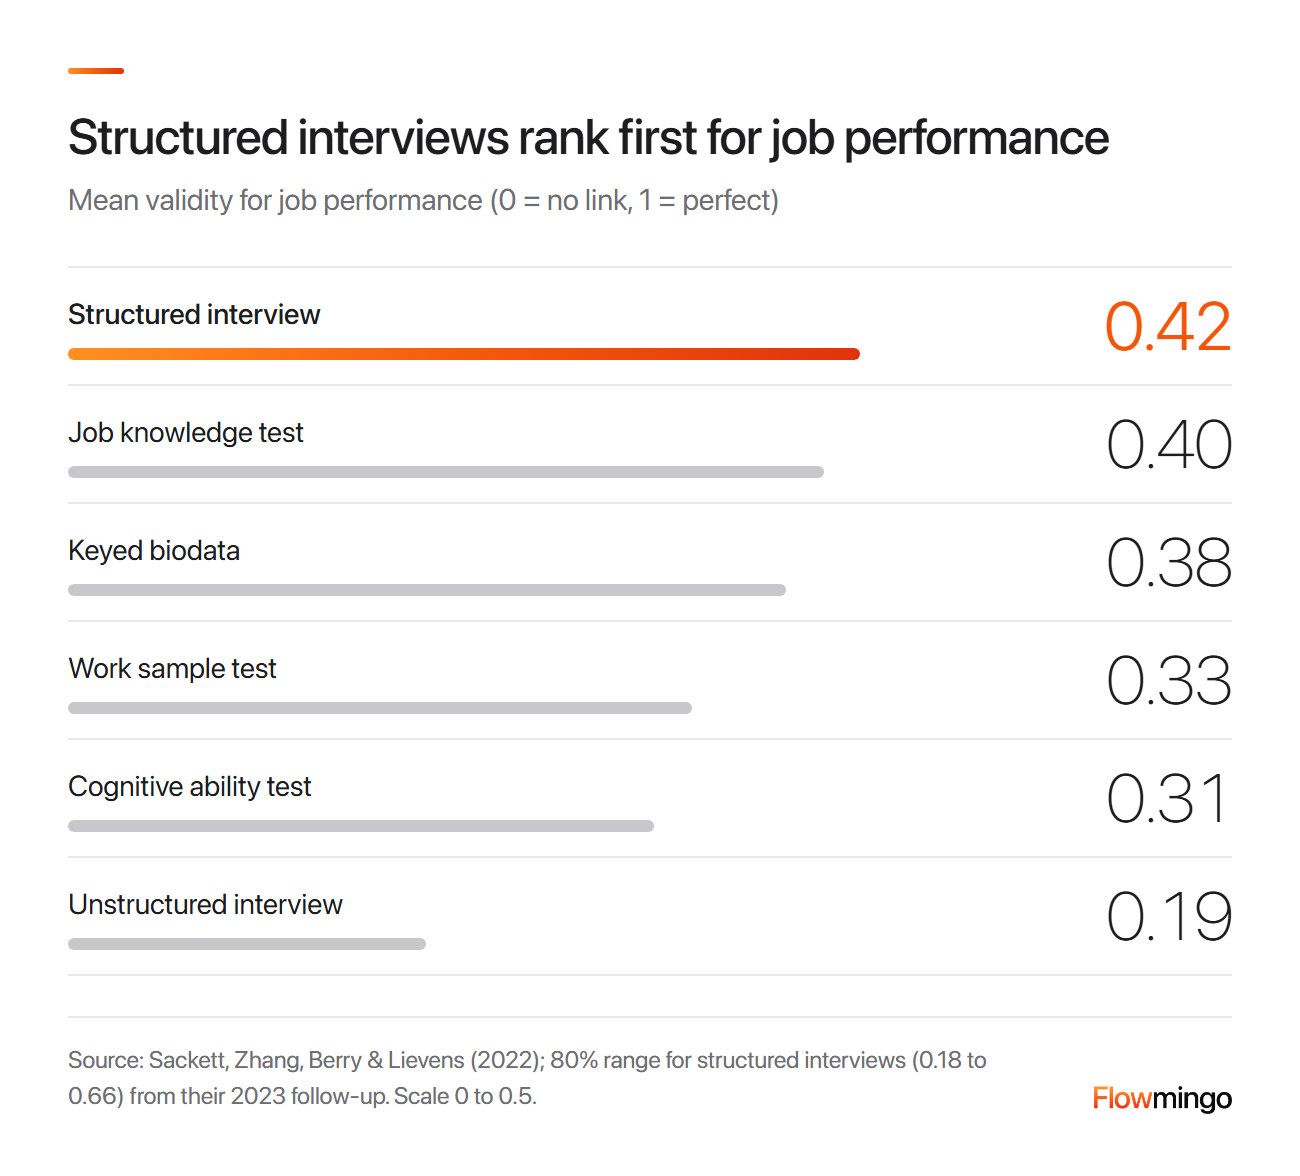
ວິທີການຈ້າງງານຈັດອັນດັບຕາມຄວາມກ່ຽວຂ້ອງກັບຜົນການເຮັດວຽກ: ການສຳພາດແບບມີໂຄງຮ່າງນຳໜ້າຢູ່ທີ່ 0.42, ການສຳພາດແບບບໍ່ມີໂຄງຮ່າງຕາມຫຼັງຢູ່ທີ່ 0.19 (ການວິເຄາະຄືນໃໝ່ທີ່ເປັນພື້ນຖານຂອງ Sackett ແລະ ເພື່ອນຮ່ວມງານ).
ແຕ່ 0.42 ແມ່ນຄ່າສະເລ່ຍ. ການສຶກສາຕິດຕາມຂອງຜູ້ຂຽນ ຊີ້ວ່າການສຳພາດແບບມີໂຄງຮ່າງສ່ວນຫຼາຍຢູ່ລະຫວ່າງ 0.18, ເຊິ່ງບໍ່ດີກວ່າການລົມກັນແບບອິດສະຫຼະ, ແລະ 0.66, ເຊິ່ງດີກວ່າທຸກຢ່າງໃນຕາຕະລາງ.
ການອອກແບບແມ່ນ 1 ໃນ 3 ເຫດຜົນທີ່ຜູ້ຂຽນໃຫ້ສຳລັບຄວາມແຜ່ກວ້າງນັ້ນ. ນີ້ໝາຍຄວາມວ່າເກນການໃຫ້ຄະແນນສຳພາດທີ່ມີທັກສະບໍ່ຊັດເຈນມີຄວາມສ່ຽງທີ່ຈະຢູ່ໃກ້ອັນດັບລຸ່ມສຸດ. ເຫຼົ່ານີ້ແມ່ນຄ່າສະເລ່ຍຈາກນາຍຈ້າງຫຼາຍລາຍ, ບໍ່ແມ່ນຄຳໝັ້ນສັນຍາ່ກ່ຽວກັບການຈ້າງຄັ້ງຕໍ່ໄປຂອງທ່ານ.
2. ເກນການໃຫ້ຄະແນນສຳພາດຂອງຂ້ອຍຄວນມີຫຍັງແດ່?
ເກນການໃຫ້ຄະແນນສຳພາດ, ຫຼື ແບບຟອມປະເມີນຜູ້ສະໝັກ, ປະກອບມີ 5 ທັກສະ, ຕົວຊີ້ວັດທີ່ຂຽນໄວ້, ຊ່ອງສຳລັບຫຼັກຖານ ແລະ ລະດັບຂັ້ນຕ່ຳທີ່ຈຳເປັນ, ທັງໝົດຢູ່ໃນ 1 ໜ້າ. ມັນລົງທ້າຍດ້ວຍຄວາມປະທັບໃຈໂດຍລວມ ແລະ ຄຳແນະນຳ.
ຕົວຊີ້ວັດເຮັດໃຫ້ຄະແນນ 4 ຂອງຜູ້ສຳພາດຄົນໜຶ່ງໝາຍຄວາມດຽວກັນກັບຂອງອີກຄົນໜຶ່ງ, ແລະ ຊ່ອງສຳລັບຫຼັກຖານຕອບຄຳຖາມ "ເປັນຫຍັງ" ເມື່ອ CEO ຂອງທ່ານຖາມ.
ຊັ້ນຕ່ຳສຸດປ້ອງກັນບໍ່ໃຫ້ຄະແນນລວມສູງປົກຄຸມຄຸນສົມບັດຈຳເປັນທີ່ອ່ອນແອ. ຄວາມປະທັບໃຈລວມມາທ້າຍສຸດ ເພາະຄວາມຮູ້ສຶກທີ່ຂຽນກ່ອນຈະຍ້ອມສີທຸກຄະແນນທັກສະທີ່ຕາມມາ.
ນີ້ແມ່ນແບບຟອມດັ່ງກ່າວສຳລັບຫົວໜ້າຝ່າຍບໍລິການລູກຄ້າ ພ້ອມ 2 ຄຸນສົມບັດຈຳເປັນ. ແຕ່ລະທັກສະໃນ 5 ທັກສະໄດ້ຄະແນນ 1 ຫາ 5 ດັ່ງນັ້ນຄະແນນລວມແມ່ນຈາກ 25.
ຖາມຄຳຖາມກ່ຽວກັບພຶດຕິກຳໃນອະດີດ 2 ຂໍ້ຕໍ່ທັກສະ ເພາະຕົວຢ່າງໃນອະດີດຕົວຈິງຈະໃຫ້ທ່ານມີສິ່ງທີ່ເປັນຮູບປະທຳເພື່ອທຽບກັບຫຼັກອ້າງອີງ. ຕົວຢ່າງ: "ເລົ່າໃຫ້ຟັງກ່ຽວກັບຄັ້ງຫຼ້າສຸດທີ່ລູກຄ້າທີ່ບໍ່ພໍໃຈຍົກບັນຫາມາຫາທ່ານ."
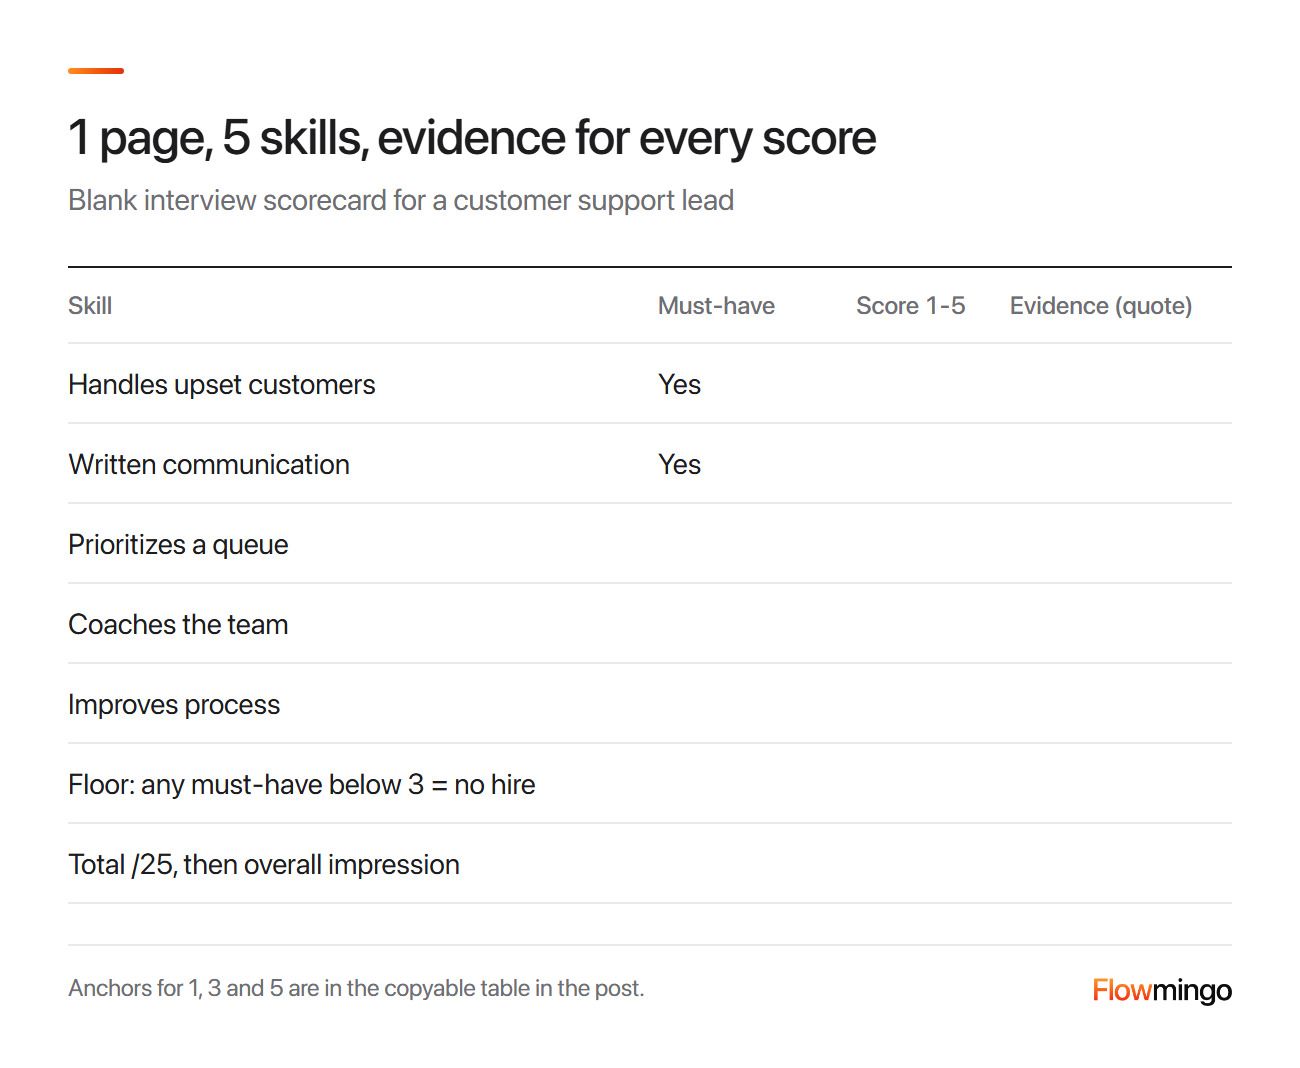
ແບບຟອມຄະແນນສຳພາດຫວ່າງສຳລັບຫົວໜ້າຝ່າຍບໍລິການລູກຄ້າ: 5 ທັກສະ, 2 ຄຸນສົມບັດຈຳເປັນ, ຄະແນນ 1 ຫາ 5 ແລະ ຄຳເວົ້າຫຼັກຖານໜຶ່ງຂໍ້ຕໍ່ທັກສະ.
ສຳເນົາຕາຕະລາງແລ້ວປ່ຽນເປັນທັກສະ ແລະ ຫຼັກອ້າງອີງຂອງທ່ານເອງ.
| ທັກສະ | ຫຼັກອ້າງອີງສຳລັບ 1 / 3 / 5 | ຄະແນນ 1-5 | ຫຼັກຖານ (ຄຳເວົ້າ) |
|---|---|---|---|
| ສ່ວນຫົວ | ຜູ້ສະໝັກ, ຕຳແໜ່ງ, ຜູ້ສຳພາດ, ວັນທີ | ||
| ຮັບມືກັບລູກຄ້າທີ່ບໍ່ພໍໃຈ (ຈຳເປັນ) | ໂທດລູກຄ້າ / ປະຕິບັດຕາມນະໂຍບາຍ / ແກ້ໄຂຕົ້ນເຫດ | ||
| ການສື່ສານດ້ວຍການຂຽນ (ຈຳເປັນ) | ບໍ່ຊັດເຈນ / ຊັດເຈນແຕ່ຍາວ / ສັ້ນແລະຊັດເຈນ | ||
| ຈັດລຳດັບຄວາມສຳຄັນຂອງຄິວ | ບໍ່ມີວິທີ / ຕາມຄວາມຮີບດ່ວນ / ຕາມຜົນກະທົບ | ||
| ຝຶກສອນທີມ | ບໍ່ມີຕົວຢ່າງ / ໃຫ້ຄຳແນະນຳ / ວາງແຜນ | ||
| ປັບປຸງຂະບວນການ | ບໍ່ມີຕົວຢ່າງ / ສະເໜີການແກ້ໄຂ / ລົງມືແກ້ໄຂ | ||
| ຊັ້ນຕ່ຳສຸດຂອງຄຸນສົມບັດຈຳເປັນ | ຄຸນສົມບັດຈຳເປັນໃດໜຶ່ງຕ່ຳກວ່າ 3 ໝາຍຄວາມວ່າບໍ່ຈ້າງ | ||
| ບໍ່ໃຫ້ຄະແນນ | ອາລົມທີ່ອ່ານຈາກໃບໜ້າ, ສຽງ ຫຼື ການພິມ; ສຳນຽງ ຫຼື ຄວາມໄວ ເວັ້ນແຕ່ວຽກຕ້ອງການ; "ຄວາມເຂົ້າກັນກັບວັດທະນະທຳ" | ||
| ລວມ | ຜົນບວກຂອງ 5 ຄະແນນ, ຈາກ 25 | ||
| ຄວາມປະທັບໃຈລວມ | 1 ຫາ 5, ຕື່ມທ້າຍສຸດ | ||
| ຄຳແນະນຳ | ຈ້າງແນ່ນອນ / ຈ້າງ / ບໍ່ຈ້າງ / ບໍ່ຈ້າງແນ່ນອນ; ການປ່ຽນແປງຕ້ອງມີເຫດຜົນເປັນລາຍລັກອັກສອນ |
2.1 ຂ້ອຍຄວນຕັດສິນໃຈຫຍັງກ່ອນຈະສ້າງມັນ?
ກຳນົດຄວາມສຳເລັດໃນຕຳແໜ່ງກ່ອນ ແລ້ວຈຶ່ງເລືອກທັກສະທີ່ເຮັດໃຫ້ໄດ້ຜົນນັ້ນ. ລັອກແບບຟອມຄະແນນສຳພາດໄວ້ກ່ອນ CV ທຳອິດຈະມາຮອດ.
ລຳດັບນັ້ນມາຈາກ Who ໂດຍ Geoff Smart ແລະ Randy Street. ຂຽນພາລະກິດ 1 ແຖວ ແລ້ວຂຽນຜົນລັບ 3 ຫາ 8 ຂໍ້ຈັດລຳດັບຕາມຄວາມສຳຄັນ ຈາກນັ້ນຈຶ່ງຂຽນທັກສະ 4 ຫາ 6 ຢ່າງ. ຜົນລັບແມ່ນຜົນໄດ້ຮັບທີ່ວັດແທກໄດ້ ເຊັ່ນ ການເຕີບໂຕລາຍຮັບຈາກ 25 ລ້ານໂດລາເປັນ 50 ລ້ານໂດລາພາຍໃນປີທີ 3 ບໍ່ແມ່ນກິດຈະກຳ.
ການລັອກມີຄວາມສຳຄັນ ເພາະຄົນເຮົາມັກດັດແປງເງື່ອນໄຂໂດຍບໍ່ຮູ້ຕົວ. ໃນການສຶກສາພື້ນຖານຂອງ Uhlmann ແລະ Cohen (2005) ຜູ້ເຂົ້າຮ່ວມໄດ້ຕັດສິນຜູ້ສະໝັກຕຳແໜ່ງຫົວໜ້າຕຳຫຼວດສອງຄົນ ຄື ຄົນໜຶ່ງທີ່ມີປະສົບການຕາມທ້ອງຖະໜົນ ແລະ ອີກຄົນໜຶ່ງທີ່ຮຽນສູງ.
ບໍ່ວ່າຜູ້ຊາຍຈະມີຄວາມເກັ່ງດ້ານໃດ ພວກເຂົາກໍຕັດສິນວ່າວຽກນັ້ນຕ້ອງການຄວາມເກັ່ງດ້ານນັ້ນຫຼາຍກວ່າ ແຕ່ຜູ້ຍິງບໍ່ໄດ້ຮັບການໜູນດັ່ງກ່າວເລີຍ. ການຜູກມັດກັບເງື່ອນໄຂກ່ອນເຫັນຜູ້ສະໝັກໄດ້ຂັດອະຄະຕິນັ້ນອອກ. ດັ່ງນັ້ນ ແບບຟອມຄະແນນທີ່ຂຽນຫຼັງຈາກພົບຜູ້ສະໝັກແລ້ວ ອາດຈະຄ່ອຍໆງໍໄປຫາຄົນທີ່ທ່ານມັກຢູ່ແລ້ວ.
2.2 ຄວາມເຂົ້າກັນທາງວັດທະນະທຳຄວນຢູ່ໃນໃບຄະແນນຫຼືບໍ່?
ບໍ່ຄວນຕາມທີ່ຂຽນໄວ້ ເພາະບໍ່ມີໃຜສາມາດໃຫ້ຄະແນນຄືກັນໄດ້ສອງເທື່ອ. ປ່ຽນມັນໃຫ້ເປັນພຶດຕິກຳທີ່ສັງເກດເຫັນໄດ້ 1 ຫຼື 2 ຢ່າງ ເຊັ່ນ "ຂໍຄຳຄິດເຫັນຕໍ່ວຽກຂອງຕົນເອງ".
ສົມມຸດວ່າທີມຂອງທ່ານໃຫ້ຄຸນຄ່າຄວາມຊື່ສັດ: ໃຫ້ຄະແນນ "ໃຫ້ຕົວຢ່າງສະເພາະຂອງການລາຍງານຄວາມຜິດພາດແຕ່ເນີນ" ແທນ.
3. ຂ້ອຍຈະຖ່ວງນ້ຳໜັກຄະແນນສຳພາດແນວໃດໃຫ້ທັກສະທີ່ຈຳເປັນທີ່ສຸດນັບຫຼາຍທີ່ສຸດ?
ໃຫ້ທຸກທັກສະຖ່ວງນ້ຳໜັກເທົ່າກັນ ແລະ ເພີ່ມຂັ້ນຕ່ຳສຳລັບທັກສະທີ່ຈຳເປັນ, ຫຼື ກຳນົດນ້ຳໜັກກ່ອນການສຳພາດຄັ້ງທຳອິດ. ນ້ຳໜັກເທົ່າກັນມັກຈະຄາດຄະເນກໍລະນີໃໝ່ໄດ້ດີເທົ່າກັບນ້ຳໜັກທີ່ປັບໃຫ້ເຂົ້າກັບຂໍ້ມູນໃນອະດີດ.
ຈຸດທີສອງນັ້ນມາຈາກນັກຈິດຕະວິທະຍາ Robyn Dawes ດັ່ງທີ່ Kahneman ສະຫຼຸບໄວ້ໃນ Thinking, Fast and Slow.
ນ້ຳໜັກທີ່ປັບໃຫ້ເຂົ້າກັບການຈ້າງໃນອະດີດຂອງທ່ານຍັງຮຽນຮູ້ອຸບັດຕິເຫດຂອງກຸ່ມນັ້ນນຳ. ສົມມຸດວ່າພະນັກງານສະໜັບສະໜູນ 3 ຄົນທີ່ດີທີ່ສຸດຂອງທ່ານບັງເອີນເປັນຄູຝຶກທີ່ເກັ່ງ: ນ້ຳໜັກທີ່ປັບແລ້ວຈະໃຫ້ຄວາມສຳຄັນກັບການເປັນຄູຝຶກໃນຜູ້ສະໝັກໃນອະນາຄົດທຸກຄົນ.
ນ້ຳໜັກເທົ່າກັນບໍ່ສາມາດໄລ່ຕາມອຸບັດຕິເຫດແບບນັ້ນໄດ້ ຊຶ່ງເປັນເຫດຜົນວ່າເປັນຫຍັງມັນຈຶ່ງມັກຈະຄາດຄະເນຜູ້ສະໝັກໃໝ່ໄດ້ດີພໍໆກັນ. ຮັກສາໃຫ້ທັກສະເປັນເອກະລາດຈາກກັນນຳ ດັ່ງທີ່ Kahneman ແນະນຳ: ຢ່າລະບຸທັງ "ການສື່ສານ" ແລະ "ທັກສະການນຳສະເໜີ" ເພາະສອງຢ່າງນີ້ຮ່ວມກັນນັບສິ່ງດຽວກັນສອງເທື່ອ.
ທັກສະທີ່ຈຳເປັນໄດ້ອຳນາດຈາກຂັ້ນຕ່ຳ ບໍ່ແມ່ນຈາກນ້ຳໜັກທີ່ໃຫຍ່ກວ່າ. ສົມມຸດວ່າ "ຮັບມືກັບລູກຄ້າທີ່ບໍ່ພໍໃຈ" ໄດ້ຄະແນນ 2 ແລະ ທຸກທັກສະອື່ນໄດ້ຄະແນນ 5.
ຄະແນນລວມ 22 ຈາກ 25 ເບິ່ງຄືດີຫຼາຍ ແຕ່ຂັ້ນຕ່ຳຍັງບອກວ່າບໍ່ຈ້າງ. ນັ້ນຄືສິ່ງທີ່ທ່ານຕ້ອງການສຳລັບທັກສະທີ່ວຽກນີ້ຂາດບໍ່ໄດ້.
ຖ້າທ່ານຖ່ວງນ້ຳໜັກແທ້ ໃຫ້ຂຽນມັນໄວ້ໃນໃບຄະແນນສຳພາດຕັ້ງແຕ່ຕົ້ນ ແລະ ໃຊ້ກັບທຸກຄົນ. ນັ້ນປິດທາງທີ່ງ່າຍທີ່ສຸດໃນການບິດເບືອນຄະແນນລວມ: ການປ່ຽນນ້ຳໜັກຫຼັງຈາກທີ່ທ່ານໄດ້ພົບຄົນທີ່ທ່ານມັກ.
Flowmingo ຊ່ວຍແນວໃດ
ລາຍງານການສຳພາດດ້ວຍ AI ຂອງ Flowmingo ໃຊ້ນ້ຳໜັກຄົງທີ່: ເກນ Must Have ນັບ 4 ເທົ່າຂອງເກນ Good to Have ໃນຄະແນນລວມ. ແຕ່ລະເກນຮັກສາຄະແນນ 0 ຫາ 10 ຂອງຕົນເອງ ດັ່ງນັ້ນທ່ານຍັງສາມາດໃຊ້ຂັ້ນຕ່ຳສຳລັບທັກສະທີ່ຈຳເປັນດ້ວຍຕົນເອງໄດ້.
4. ເຮັດແນວໃດໃຫ້ຄະແນນ 3 ມີຄວາມໝາຍດຽວກັນສຳລັບຜູ້ສຳພາດທຸກຄົນ?
ຂຽນສິ່ງທີ່ຄຳຕອບລະດັບ 1, 3 ແລະ 5 ປະກອບມີສຳລັບແຕ່ລະທັກສະ ກ່ອນການສຳພາດຄັ້ງທຳອິດ. ເຄື່ອງມືວັດແທກທີ່ອີງໃສ່ພຶດຕິກຳນີ້ ເຮັດໃຫ້ຄະແນນຂອງຜູ້ສຳພາດ 2 ຄົນສາມາດປຽບທຽບກັນໄດ້.
"ອີງໃສ່ພຶດຕິກຳ" ໝາຍຄວາມວ່າແຕ່ລະຄະແນນຜູກກັບສິ່ງທີ່ຜູ້ສະໝັກໄດ້ເຮັດ ບໍ່ແມ່ນຄວາມຮູ້ສຶກຄື "ດີພໍສົມຄວນ". ຖ້າບໍ່ມີຫຼັກອີງ, ຄະແນນ 3 ໃນໃບຄະແນນການສຳພາດດຽວກັນ ໝາຍເຖິງ "ພໍໃຊ້" ສຳລັບຜູ້ສຳພາດຄົນໜຶ່ງ ແລະ "ອ່ອນ" ສຳລັບອີກຄົນໜຶ່ງ.
ການສຳພາດແບບມີຫຼັກອີງຍັງສະແດງໃຫ້ເຫັນຄວາມສໍາພັນສະເລ່ຍທີ່ແຂງແກ່ນກວ່າກັບຜົນງານໃນພາຍຫຼັງ. ການທົບທວນພື້ນຖານຂອງ Taylor ແລະ Small ຕໍ່ການສຶກສາການສຳພາດແບບຖາມພຶດຕິກຳໃນອະດີດ 19 ວຽກ ພົບຄວາມສໍາພັນ .35 ກັບມາດຕະສ່ວນແບບມີຫຼັກອີງ ເມື່ອທຽບກັບ .26 ເມື່ອບໍ່ມີ. ບັນດາການສຶກສາຍັງແຕກຕ່າງກັນໃນດ້ານອື່ນໆອີກ ດັ່ງນັ້ນການປຽບທຽບນີ້ຈຶ່ງບໍ່ໄດ້ແຍກຜົນຂອງການເພີ່ມຫຼັກອີງອອກມາເປັນເອກະລາດ.
ນີ້ແມ່ນມາດຕະສ່ວນການໃຫ້ຄະແນນການສຳພາດສຳລັບຄຸນສົມບັດທີ່ຈຳເປັນ "ຮັບມືກັບລູກຄ້າທີ່ບໍ່ພໍໃຈ".
| ຄະແນນ | ສິ່ງທີ່ຄຳຕອບປະກອບມີ |
|---|---|
| 1 | ໂທດລູກຄ້າ; ບໍ່ມີການກະທຳຂອງຕົນເອງ ແລະ ບໍ່ມີຜົນໄດ້ຮັບ |
| 3 | ຕົວຢ່າງຕົວຈິງ: ເຮັດໃຫ້ລູກຄ້າ� seme ແລະ ນຳໃຊ້ນະໂຍບາຍ ແຕ່ບໍ່ເຄີຍກວດເບິ່ງຜົນ |
| 5 | ຕົວຢ່າງຕົວຈິງ: ຊອກຫາສາເຫດ, ແກ້ໄຂ, ຕິດຕາມຜົນ ແລະ ແບ່ງປັນວິທີແກ້ໄຂ |
ແຕ່ລະຂັ້ນທີ່ເພີ່ມຂຶ້ນແມ່ນສິ່ງທີ່ທ່ານສາມາດໄດ້ຍິນໃນຄຳຕອບ. ນັ້ນແມ່ນເຫດຜົນທີ່ຜູ້ຟັງ 2 ຄົນສາມາດລົງເຖິງຕົວເລກດຽວກັນ.
ຖ້າທ່ານຍັງຂຽນຫຼັກອີງບໍ່ໄດ້, ໃຫ້ຢືມ 5 ລະດັບໃນ ຄູ່ມືການສຳພາດແບບມີໂຄງສ້າງ ຈາກ OPM, ອົງການ HR ຂອງລັດຖະບານກາງສະຫະລັດ. ແຕ່ລະລະດັບອີງໃສ່ຄວາມຍາກຂອງສະຖານະການ ແລະ ຄຳແນະນຳທີ່ບຸກຄົນນັ້ນຕ້ອງການ.
- 1, ຮັບຮູ້: ສະຖານະການທີ່ງ່າຍທີ່ສຸດ, ມີຄຳແນະນຳຢ່າງໃກ້ຊິດ ແລະ ກວ້າງຂວາງ.
- 2, ພື້ນຖານ: ສະຖານະການທີ່ຂ້ອນຂ້າງຍາກ, ມີຄຳແນະນຳເລື້ອຍໆ.
- 3, ຂັ້ນກາງ: ສະຖານະການທີ່ຍາກ, ມີຄຳແນະນຳເປັນບາງເທື່ອ.
- 4, ຂັ້ນສູງ: ສະຖານະການທີ່ຍາກຢ່າງຫຼວງຫຼາຍ, ມີຄຳແນະນຳໜ້ອຍ ຫຼື ບໍ່ມີເລີຍ.
- 5, ຜູ້ຊ່ຽວຊານ: ສະຖານະການທີ່ຍາກເປັນພິເສດ, ທີ່ບຸກຄົນນັ້ນໃຫ້ຄຳແນະນຳແກ່ຄົນອື່ນ.
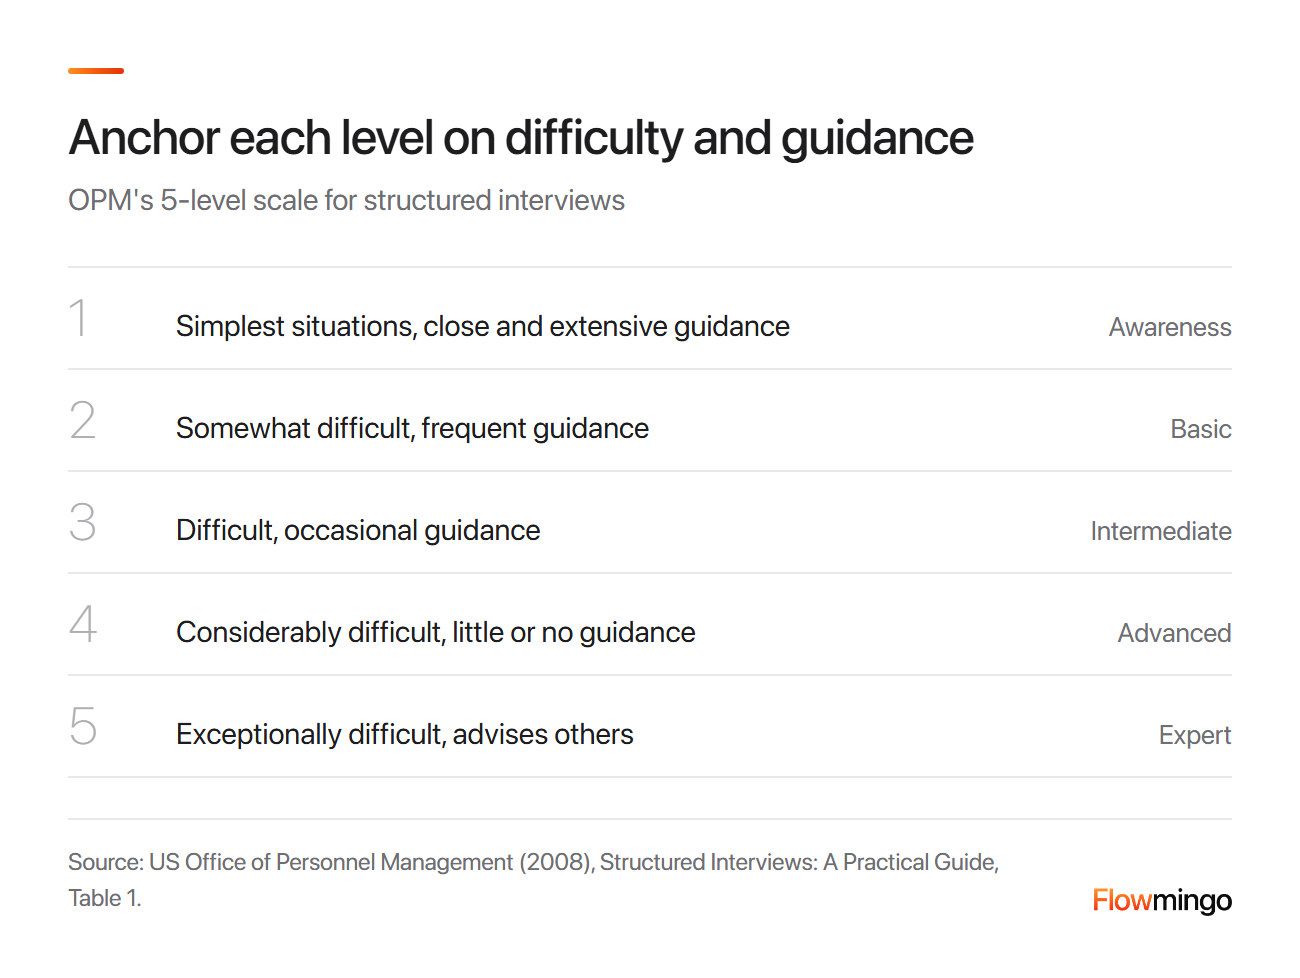
5 ລະດັບການໃຫ້ຄະແນນຂອງ OPM ສຳລັບການສຳພາດແບບມີໂຄງສ້າງ: ຈາກ ຮັບຮູ້ (ສະຖານະການທີ່ງ່າຍທີ່ສຸດ, ຄຳແນະນຳຢ່າງໃກ້ຊິດ) ຈົນເຖິງ ຜູ້ຊ່ຽວຊານ (ສະຖານະການທີ່ຍາກເປັນພິເສດ, ໃຫ້ຄຳແນະນຳແກ່ຄົນອື່ນ).
5. ເຮັດແນວໃດໃຫ້ເລືອກລະຫວ່າງຜູ້ເຂົ້າຮອບສຸດທ້າຍ 2 ຄົນທີ່ເກັ່ງ ເມື່ອຜູ້ສຳພາດຂອງຂ້ອຍບໍ່ເຫັນດີນຳກັນ?
ໃຫ້ຄະແນນລວມຂອງໃບຄະແນນສຳພາດເປັນຕົວຕັດສິນ ໂດຍມີ 2 ຂໍ້ຍົກເວັ້ນ: ຄຸນສົມບັດທີ່ຈຳເປັນ (must-have) ໄດ້ຄະແນນຕ່ຳກວ່າ 3, ຫຼື ມີການແບ່ງຄະແນນແບບ 2 ຕໍ່ 5, ຊຶ່ງເຈົ້າຕ້ອງປະຊຸມທົບທວນໂດຍອີງໃສ່ຫຼັກຖານ. ຢ່າລົງຄະແນນຄືນຕາມຄວາມຮູ້ສຶກ.
ນີ້ແມ່ນຊ່ວງເວລາທີ່ໃບຄະແນນຖືກສ້າງຂຶ້ນມາເພື່ອ, ແລະ ເປັນຊ່ວງເວລາທີ່ເຮົາຢາກປະຖິ້ມມັນທີ່ສຸດ. ນີ້ເປັນຕົວຢ່າງປະກອບຄຳອະທິບາຍ, ບໍ່ແມ່ນຂໍ້ມູນລູກຄ້າ: ຜູ້ສະໝັກສຸດທ້າຍ 3 ຄົນສຳລັບຕຳແໜ່ງຫົວໜ້າຝ່າຍສະໜັບສະໜູນ, ແຕ່ລະຊ່ອງແມ່ນຄະແນນສະເລ່ຍຈາກຜູ້ສຳພາດ 3 ຄົນ.
| ທັກສະ | A | B | C |
|---|---|---|---|
| ຮັບມືກັບລູກຄ້າທີ່ບໍ່ພໍໃຈ (must-have) | 4 | 2 | 4 |
| ການສື່ສານດ້ວຍການຂຽນ (must-have) | 4 | 4 | 3 |
| ຈັດລຳດັບຄວາມສຳຄັນຂອງຄິວວຽກ | 3 | 4 | 3 |
| ສອນງານທີມ | 3 | 4 | 4 (ຄະແນນ 2, 5, 5) |
| ປັບປຸງຂະບວນການ | 4 | 4 | 3 |
| ລວມ, ຈາກ 25 | 18 | 18 | 17 |
| ການຕັດສິນໃຈ | ຈ້າງ | ບໍ່ຈ້າງ: ຕົກເກນຂັ້ນຕ່ຳ | ປະຊຸມທົບທວນການແບ່ງຄະແນນ |
ອ່ານໃບຄະແນນສຳພາດເປັນແຖວໆ. A ແລະ B ໄດ້ຄະແນນເທົ່າກັນທີ່ 18 ຈາກ 25. ແຕ່ B ໄດ້ຄະແນນ 2 ໃນຄຸນສົມບັດທີ່ຈຳເປັນ, ດັ່ງນັ້ນຈຶ່ງຕົກເກນຂັ້ນຕ່ຳ ແລະ B ຖືກຈັດເປັນບໍ່ຈ້າງ.
C ໄດ້ລວມ 17, ແຕ່ຄະແນນສະເລ່ຍ 4 ຂອງ C ໃນ "ສອນງານທີມ" ປົກປິດການແບ່ງຄະແນນໄວ້: ຜູ້ສຳພາດ 1 ຄົນໃຫ້ 2, ສ່ວນອີກ 2 ຄົນໃຫ້ 5. ຊ່ອງຫວ່າງນັ້ນຈະກາຍເປັນວາລະດຽວຂອງການປະຊຸມທົບທວນ.
ໃນພາກປະຕິບັດ, ໃຫ້ແຕ່ລະຝ່າຍອ່ານຄຳເວົ້າທີ່ເປັນຫຼັກຖານຂອງຕົນອອກມາ. ສົມມຸດວ່າຜູ້ໃຫ້ຄະແນນຕ່ຳໄດ້ຍິນເລື່ອງສະມາຊິກທີມຄົນໜຶ່ງທີ່ລາອອກ, ສ່ວນຄົນອື່ນໆໄດ້ຍິນເລື່ອງແຜນການສອນງານທີ່ໄດ້ຜົນ. ການປະຊຸມທົບທວນຈະຕັດສິນວ່າເລື່ອງໃດເປັນຕົວແທນຂອງ C ຫຼາຍກວ່າ, ແລະ ຜູ້ໃດທີ່ພາດຫຼັກຖານກໍຈະປ່ຽນຄະແນນເປັນລາຍລັກອັກສອນ.
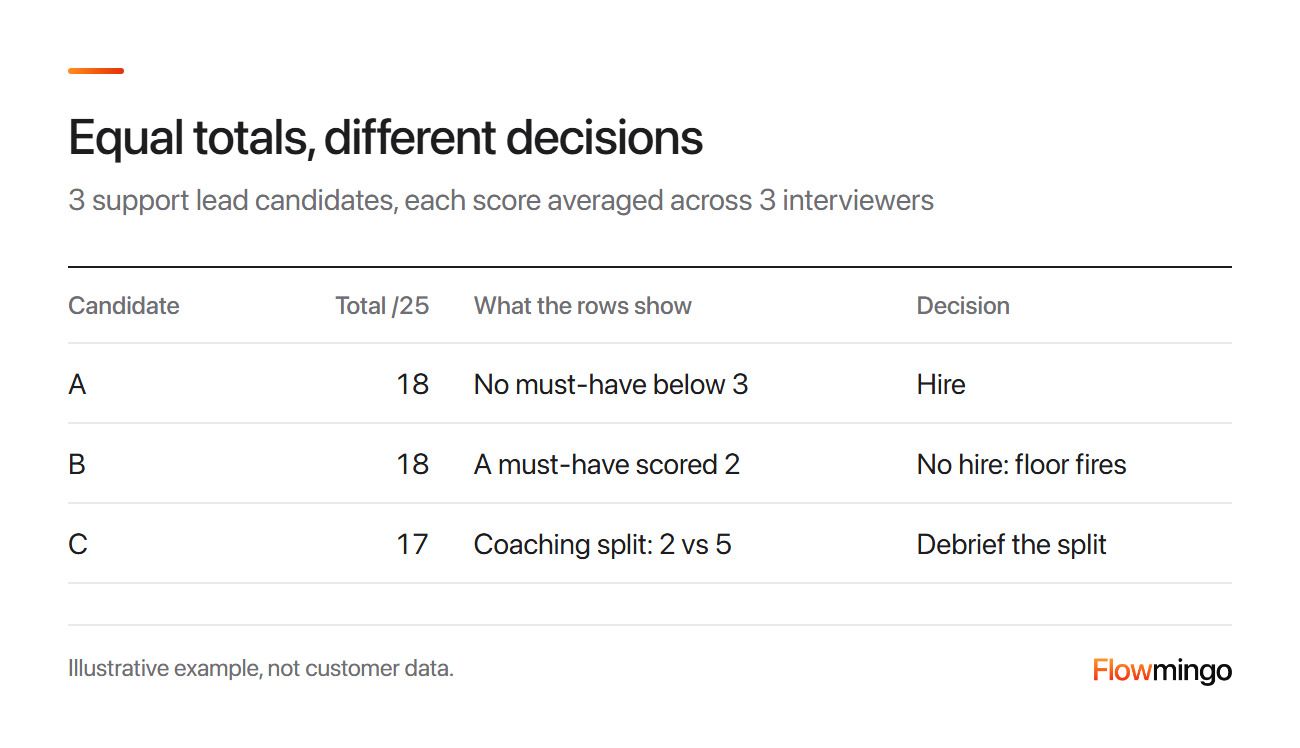
ໃບຄະແນນສຳພາດທີ່ຕື່ມແລ້ວ, ເປັນຕົວຢ່າງປະກອບຄຳອະທິບາຍ: A ແລະ B ເທົ່າກັນທີ່ 18 ຈາກ 25, B ພາດຄຸນສົມບັດທີ່ຈຳເປັນ, ແລະ C ມີການແບ່ງຄະແນນດ້ານການສອນງານທີ່ຕ້ອງທົບທວນ.
ເມື່ອຄະແນນເລືອກຜູ້ສະໝັກສຸດທ້າຍໄດ້ແລ້ວ, ໃຫ້ຂຽນເງື່ອນໄຂລົງໃນຂໍ້ສະເໜີວຽກກ່ອນສົ່ງ: ແບບຟອມຈົດໝາຍສະເໜີວຽກ ຂອງພວກເຮົາສະແດງໃຫ້ເຫັນວ່າແຕ່ລະການກວດສອບຢູ່ບ່ອນໃດ.
5.1 ຖ້າຄວາມຮູ້ສຶກບອກຢ່າງໜຶ່ງ ແລະ ຄະແນນບອກອີກຢ່າງໜຶ່ງ ຈະເຮັດແນວໃດ?
ໃຫ້ຍຶດຕາມຄະແນນ ເວັ້ນແຕ່ເຈົ້າສາມາດຂຽນຫຼັກຖານທີ່ພວກເຂົາພາດໄປອອກມາໄດ້. ໃນ meta-analysis ທີ່ເປັນພື້ນຖານປີ 2013 ຂອງ Kuncel ແລະ ສະຫາຍ, ສູດທີ່ໃຊ້ກັບທຸກຄົນໃນແບບດຽວກັນໄດ້ຄາດຄະເນຜົນການປະຕິບັດງານທີ່ 0.44, ທຽບກັບ 0.28 ຂອງການຕັດສິນແບບລວມທັງໝົດ. ຜູ້ຂຽນເອີ້ນສິ່ງນີ້ວ່າເປັນການປັບປຸງການຄາດຄະເນຫຼາຍກວ່າ 50%, ແມ່ນແຕ່ທຽບກັບຜູ້ຊ່ຽວຊານທີ່ຮູ້ຈັກວຽກນັ້ນ.
ການຕັດສິນແບບລວມທັງໝົດໝາຍເຖິງການທີ່ຜູ້ຄົນຊັ່ງນ້ຳໜັກຂໍ້ເທັດຈິງດຽວກັນໃນຫົວຂອງພວກເຂົາ, ລວມທັງການປະຊຸມຫາຂໍ້ຕົກລົງ. ດັ່ງນັ້ນ ການປະຊຸມທົບທວນຈຶ່ງເຕີມເຕັມຊ່ອງຫວ່າງຂອງຫຼັກຖານ, ບໍ່ແມ່ນການລົງຄະແນນຄືນ.
5.2 ຂ້ອຍຄວນປຽບທຽບຜູ້ສຸດທ້າຍແບບຄຽງຄູ່ກັນບໍ່?
ແມ່ນແລ້ວ, ຕອບເທື່ອລະຄຳຖາມ. ຄຳແນະນຳ HBR ຂອງ Bohnet ແມ່ນໃຫ້ປຽບທຽບຄຳຕອບທັງໝົດຂອງຄຳຖາມທີ 1, ແລ້ວຈຶ່ງຄຳຖາມທີ 2, ເພື່ອໃຫ້ທ່ານຕັດສິນແຕ່ລະຄຳຕອບທຽບກັບຄຳຕອບອື່ນໆ.
ໃນ ການສຶກສາໃນຫ້ອງທົດລອງ ພື້ນຖານປີ 2016, ຜູ້ທີ່ໄດ້ເຫັນຜູ້ສະໝັກເທື່ອລະຄົນມີແນວໂນ້ມໄປທາງເພດທີ່ຄວາມຄິດເຫັນແບບຕາຍຕົວຂອງໜ້າວຽກນັ້ນສະໜັບສະໜູນ. ຜົນງານໃນອະດີດເກືອບບໍ່ມີຜົນຫຍັງເລີຍ. ເມື່ອເຫັນ 2 ຄົນຄຽງຄູ່ກັນ, ພວກເຂົາເລືອກຄົນທີ່ມີຜົນງານສູງກວ່າ 54% ຂອງເວລາ ແລະ ເລືອກຄົນທີ່ຕ່ຳກວ່າ 8%.
ການສຶກສານັ້ນໃຊ້ຄະແນນໜ້າວຽກໃນອະດີດ, ບໍ່ແມ່ນການສຳພາດ, ສະນັ້ນຖືວ່າເປັນຄຳແນະນຳທີ່ແຮງ ບໍ່ແມ່ນຫຼັກຖານຢືນຢັນ.
6. ຂ້ອຍຈະຢຸດບໍ່ໃຫ້ຜູ້ສຳພາດທີ່ສຽງດັງທີ່ສຸດຊະນະໃນການປະເມີນຜົນໄດ້ແນວໃດ?
ໃຫ້ຜູ້ສຳພາດທຸກຄົນສົ່ງແບບປະເມີນການສຳພາດຂອງຕົນກ່ອນທີ່ຈະມີການລົມກັນ, ແລ້ວເປີດການປະເມີນຜົນດ້ວຍຄະແນນເຫຼົ່ານັ້ນ.
ສົມມຸດວ່າຜູ້ອາວຸໂສເປີດກ່ອນວ່າ "ຂ້ອຍມັກລາວ", ແລ້ວຫ້ອງປະຊຸມກໍເລີ່ມເອື່ອຍອີງໄປຕາມທັດສະນະນັ້ນ. ຄະແນນທີ່ຂຽນໄວ້ຄົນດຽວປົກປ້ອງທຸກຄົນຈາກແຮງດຶງນັ້ນ, ເຊິ່ງເປັນເຫດຜົນທີ່ Noise ກຳນົດໃຫ້ການໃຫ້ຄະແນນແບບເອກະລາດເປັນກົດເກນຂອງການຈ້າງງານ.
ໃນພາກປະຕິບັດ, ເກັບຄະແນນໃນຕາຕະລາງຮ່ວມ ຫຼື ໃນລະບົບຕິດຕາມຜູ້ສະໝັກຂອງທ່ານ, ແລ້ວເປີດເຜີຍທັງໝົດພ້ອມກັນ.
ຄະນະກຳມະການ, ທີ່ທຸກຄົນເບິ່ງການສຳພາດດຽວກັນ, ເບິ່ງຄືວ່າເປັນການແກ້ໄຂ. ໃນ ການວິເຄາະຮວມ ພື້ນຖານປີ 2013 ຂອງ Huffcutt ແລະ ຄະນະ, ຜູ້ປະເມີນໃນຄະນະກຳມະການມີຄວາມເຫັນດີກັນຢູ່ 0.74, ທຽບກັບ 0.44 ສຳລັບການສຳພາດແຍກກັນ, ໃນມາດຕາສ່ວນ 0 ຫາ 1.
ຕົວເລກນັ້ນເຮັດໃຫ້ຄະນະກຳມະການເບິ່ງດີເກີນຄວາມຈິງ. ສະມາຊິກຄະນະທຸກຄົນໃຫ້ຄະແນນການສະແດງດຽວກັນໃນມື້ດຽວກັນ, ດັ່ງນັ້ນຖ້າຜູ້ສະໝັກມີຕອນເຊົ້າທີ່ດີ ຫຼື ບໍ່ດີຜິດປົກກະຕິ, ພວກເຂົາທຸກຄົນກໍເຫັນຄືກັນໝົດ.
ດັ່ງທີ່ Iris Bohnet ໄດ້ກ່າວໃນ ການສົນທະນາທີ່ Google ວ່າ, "ຂະໜາດຕົວຢ່າງຂອງການສຳພາດແບບຄະນະກຳມະການແມ່ນພື້ນຖານແລ້ວພຽງໜຶ່ງ". ການສຳພາດແຍກກັນ, ແຕ່ລະອັນໃຫ້ຄະແນນຄົນດຽວ, ໃຫ້ທ່ານເຫັນຫຼາຍມຸມທີ່ເປັນເອກະລາດກວ່າ.
6.1 ຄວນມີຜູ້ສຳພາດຈັກຄົນທີ່ໃຫ້ຄະແນນຜູ້ສະໝັກແຕ່ລະຄົນ?
ສູງສຸດ 4 ຄັ້ງ, ໃນການສຳພາດແຍກຕ່າງຫາກ. ໃນຂໍ້ມູນພາຍໃນຂອງ Google, ເຊິ່ງບໍ່ແມ່ນການສຶກສາທີ່ຜ່ານການກວດທົບໂດຍຜູ້ຊ່ຽວຊານ, ການສຳພາດ 4 ຄັ້ງ ຄາດຄະເນການຕັດສິນໃຈຈ້າງງານດ້ວຍຄວາມໝັ້ນໃຈ 86%. ແຕ່ລະຄັ້ງທີ່ເພີ່ມຂຶ້ນເພີ່ມໄດ້ໜ້ອຍກວ່າ 1%.
ການສຳພາດເພີ່ມເຕີມເພີ່ມໄດ້ໜ້ອຍຫຼາຍຕໍ່ການຄາດຄະເນການຕັດສິນໃຈຈ້າງງານຂອງ Google ເອງ. ໃຊ້ສິ່ງນີ້ເປັນຕົວກະຕຸ້ນໃຫ້ມີເຫດຜົນສຳລັບແຕ່ລະຮອບ, ບໍ່ແມ່ນຂີດຈຳກັດສູງສຸດທົ່ວໄປ ຫຼື ຫຼັກຖານກ່ຽວກັບການປະຕິບັດງານໃນພາຍຫຼັງ.
7. ຂ້ອຍຈະເຮັດແນວໃດໃຫ້ຜູ້ສຳພາດທີ່ຫຍຸ້ງຕື່ນ ຕື່ມແບບປະເມີນການສຳພາດຕົວຈິງ?
ເຮັດໃຫ້ການໃຫ້ຄະແນນເປັນສ່ວນໜຶ່ງຂອງການສຳພາດ. ໃຫ້ຄະແນນແຕ່ລະທັກສະທັນທີຫຼັງຈາກຄຳຖາມຂອງທັກສະນັ້ນ, ຂຽນຄຳເວົ້າອ້າງອີງ 1 ແຖວເປັນຫຼັກຖານ, ແລະ ໃຫ້ຄວາມປະທັບໃຈໂດຍລວມເປັນອັນສຸດທ້າຍ.
ບໍ່ມີໃຜຢາກຕື່ມແບບຟອມອີກອັນໜຶ່ງຫຼັງຈາກສຳພາດມາທັງວັນ. ນັ້ນແມ່ນເຫດຜົນທີ່ການໃຫ້ຄະແນນເກີດຂຶ້ນພາຍໃນການສຳພາດ, ບໍ່ແມ່ນເປັນວຽກບ້ານສຳລັບຄືນນີ້.
Kahneman ສ້າງວິທີນີ້ສຳລັບກອງທັບອິດສະຣາເອນໃນປີ 1955, ຫຼັງຈາກການສຳພາດແບບເສລີພິສູດໃຫ້ເຫັນວ່າເກືອບບໍ່ມີປະໂຫຍດໃນການຄາດຄະເນຄວາມສຳເລັດ. ຜູ້ສຳພາດໃຫ້ຄະແນນ 6 ຄຸນລັກສະນະໃນລະດັບ 1 ຫາ 5, ໂດຍເຮັດແຕ່ລະອັນໃຫ້ສຳເລັດກ່ອນເລີ່ມອັນຕໍ່ໄປ, ດັ່ງນັ້ນຄວາມປະທັບໃຈທຳອິດຈຶ່ງບໍ່ສາມາດເຮັດໃຫ້ສ່ວນທີ່ເຫຼືອປົນເປື້ອນໄດ້.
ຫຼັງຈາກນັ້ນພວກເຂົາຈຶ່ງຫຼັບຕາແລ້ວໃຫ້ຄະແນນໂດຍລວມ, ແລະ ຄະແນນລວມຄາດຄະເນໄດ້ຖືກຕ້ອງຫຼາຍກວ່າແຕ່ກ່ອນຫຼາຍ. ຄຳແນະນຳຂອງລາວ: ຈ້າງຄົນທີ່ມີຄະແນນລວມສູງສຸດ, "ເຖິງແມ່ນວ່າຈະມີອີກຄົນໜຶ່ງທີ່ເຈົ້າມັກກວ່າ".
ເວລາກໍສຳຄັນເຊັ່ນກັນ. ໃນ ການສຶກສາພາກສະໜາມ, ຜູ້ສຳພາດ 166 ຄົນໄດ້ລາຍງານວ່າພວກເຂົາຕັດສິນໃຈເມື່ອໃດ. ພຽງ 4.9% ຂອງການຕັດສິນໃຈເກີດຂຶ້ນໃນນາທີທຳອິດ, ແຕ່ 22.5% ເກີດຂຶ້ນຫຼັງຈາກການສຳພາດສິ້ນສຸດລົງແລ້ວ.
ການຕັດສິນໃຈທີ່ເຮັດຫຼັງຜູ້ສະໝັກອອກໄປແລ້ວອາໄສຄວາມຊົງຈຳ, ດັ່ງນັ້ນຈົ່ງໃຫ້ຄະແນນໄປເລື້ອຍໆ.
ສຳລັບຫົວໜ້າຝ່າຍສະໜັບສະໜູນຂອງພວກເຮົາ, ມັນເບິ່ງຄືແບບນີ້:
- ຖາມຄຳຖາມກ່ຽວກັບຄິວ 2 ຂໍ້, ແລ້ວໃຫ້ຄະແນນ "ຈັດລຳດັບຄວາມສຳຄັນຂອງຄິວ" ກ່ອນຈະໄປຕໍ່.
- ຂຽນຄຳເວົ້າອ້າງອີງ 1 ອັນເປັນຫຼັກຖານ, ເຊັ່ນ "ຂ້ອຍຈັດລຳດັບບັກໂດຍອີງໃສ່ຈຳນວນລູກຄ້າທີ່ໄດ້ຮັບຜົນກະທົບ."
- ຮັກສາລຳດັບທັກສະດຽວກັນສຳລັບຜູ້ສະໝັກທຸກຄົນ.
ຫຼັກຖານທີ່ຂຽນເປັນລາຍລັກອັກສອນແມ່ນພົບໜ້ອຍຫຼາຍໃນຂໍ້ມູນຂອງພວກເຮົາ.
ຂໍ້ມູນ Flowmingo · ຜູ້ສະໝັກທີ່ສຳພາດໂດຍ AI 86,638 ຄົນ · ບໍລິສັດ 2,574 ແຫ່ງ · ກໍລະກົດ 2025 ຫາ ກັນຍາ 2026
- 0.3% ຂອງຜູ້ສະໝັກທີ່ສຳພາດໂດຍ AI ໄດ້ຮັບຄຳເຫັນເປັນລາຍລັກອັກສອນຈາກທີມງານຈ້າງ (258 ຈາກ 86,638 ຄົນ).
ທີມງານອາດເກັບບັນທຶກໄວ້ບ່ອນອື່ນ; ພາຍໃນ Flowmingo, ລາຍງານ AI ມັກຈະເປັນການປະເມີນເປັນລາຍລັກອັກສອນອັນດຽວທີ່ມີໄວ້ໃນລະບົບ.
ເຫດຜົນເປັນລາຍລັກອັກສອນເປັນສິ່ງທຳອິດທີ່ມັກຈະຖືກຂ້າມໄປໃນມື້ທີ່ຫຍຸ້ງວຽກ. ນັ້ນຄືເຫດຜົນທີ່ແບບຟອມຂໍພຽງ 1 ຂໍ້ຄວາມຕໍ່ທັກສະ.
8. ຂ້ອຍສາມາດໄວ້ໃຈຄະແນນ AI ໃນໃບຄະແນນການສຳພາດຂອງຂ້ອຍໄດ້ບໍ່?
ໃຫ້ໃຊ້ມັນເປັນ 1 ຂໍ້ມູນທີ່ຄົນກວດສອບ, ແລະ ອ່ານເຫດຜົນຂອງມັນກ່ອນ. ການໃຫ້ຄະແນນໂດຍ AI ສາມາດຫຼຸດລົງຢ່າງຫຼາຍໃນຄຳຖາມທີ່ມັນບໍ່ໄດ້ຮັບການຝຶກສຳລັບ.
ພວກເຮົາມີສ່ວນໄດ້ເສຍໃນຄຳຕອບນີ້, ດັ່ງນັ້ນຫຼັກຖານຂ້າງລຸ່ມນີ້ລວມມີສ່ວນທີ່ບໍ່ໄດ້ເຮັດໃຫ້ AI ເບິ່ງດີ.
ໃນ ການສຶກສາ ພື້ນຖານໃນປີ 2023, ຜູ້ປະເມີນທີ່ໄດ້ຮັບການຝຶກ 2 ຄົນໄດ້ໃຫ້ຄະແນນຄຳຕອບຂອງຜູ້ສະໝັກ 7,017 ຄຳຕອບ ໃນມາດຕະສ່ວນແບບກຳນົດຈຸດ 1 ຫາ 5. ຕົວແບບທີ່ຝຶກດ້ວຍຄຳຖາມດຽວກັນໃຫ້ຄະແນນໃກ້ຄຽງກັບພວກເຂົາ, ຢູ່ທີ່ 0.75 ໃນມາດຕະສ່ວນ 0 ຫາ 1. ໃນຮູບແບບຄຳຖາມທີ່ມັນບໍ່ເຄີຍເຫັນມາກ່ອນ, ມັນຫຼຸດລົງເຫຼືອ 0.30, ເຊິ່ງເປັນການຈັບຄູ່ທີ່ອ່ອນ.
ນີ້ໝາຍຄວາມວ່າຄະແນນ AI ດີໄດ້ພຽງເທົ່າກັບເກນການໃຫ້ຄະແນນສະເພາະຄຳຖາມຂອງມັນ, ດັ່ງນັ້ນຈົ່ງອ່ານເຫດຜົນຂອງມັນກ່ອນທີ່ຈະໄວ້ໃຈຕົວເລກ. ພ້ອມກັນນັ້ນ ຂໍໃຫ້ສັງເກດວ່າ 3 ຈາກ 5 ຜູ້ຂຽນຂອງການສຶກສາດັ່ງກ່າວເຮັດວຽກຢູ່ Modern Hire ຜູ້ສະໜອງການສຳພາດໂດຍ AI.
Flowmingo ຊ່ວຍໄດ້ແນວໃດ
AI Interviewer ຂອງ Flowmingo ໃຫ້ຄະແນນຕາມເກນທີ່ທ່ານອະນຸມັດ. AI ຮ່າງຄຳຖາມ ແລະ ເກນຈາກຄຳອະທິບາຍລັກສະນະວຽກຂອງທ່ານ, ແລະ ທ່ານແກ້ໄຂທັງສອງຢ່າງ. ທ່ານສົ່ງການສຳພາດໃຫ້ຜູ້ສະໝັກແຕ່ລະຄົນເຮັດໃນເວລາຂອງເຂົາເອງ.
ທ່ານຈະໄດ້ຮັບການບັນທຶກສຽງ-ພາບ, ບົດຖອດສຽງ ແລະ ເກນແຕ່ລະຂໍ້ທີ່ໃຫ້ຄະແນນ 0 ຫາ 10 ພ້ອມເຫດຜົນເປັນລາຍລັກອັກສອນ. ທ່ານເປັນຜູ້ຕັດສິນໃຈຈ້າງ.
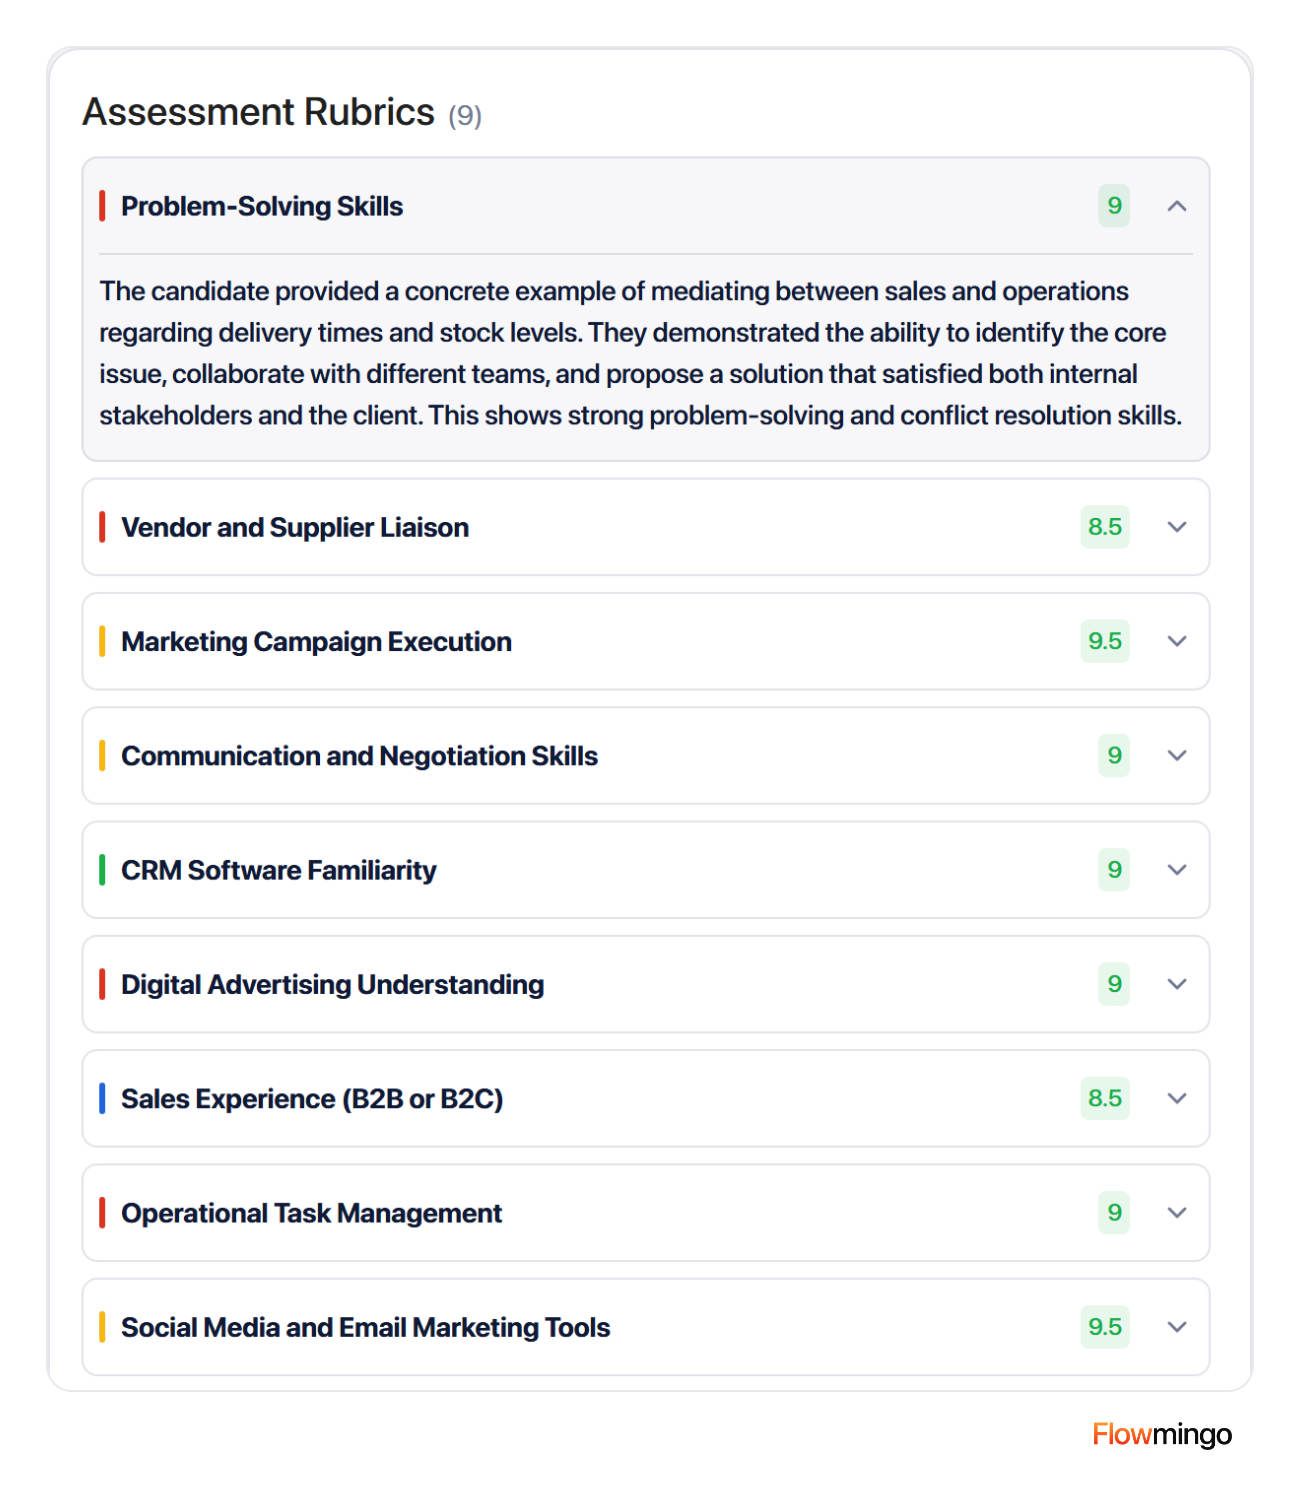
ລາຍງານຕົວຢ່າງສາທາລະນະຂອງ Flowmingo: ຄະແນນ 0 ຫາ 10 ແລະ ເຫດຜົນຕໍ່ເກນແຕ່ລະຂໍ້, ດັ່ງນັ້ນຈົ່ງຕັ້ງເກນຂັ້ນຕ່ຳທີ່ຈຳເປັນໃດໆໃນມາດຕະສ່ວນນັ້ນ.
ໃນຂໍ້ມູນຂອງພວກເຮົາ, CV ແລະ ການສຳພາດຍັງບໍ່ສອດຄ່ອງກັນກ່ຽວກັບວ່າໃຜເກັ່ງທີ່ສຸດ.
ຂໍ້ມູນ Flowmingo · ຜູ້ສະໝັກ 34,114 ຄົນ · ບໍລິສັດ 379 ແຫ່ງ · ກໍລະກົດ 2025 ຫາ ກັນຍາ 2026
- 19.2% ຂອງໂຄງການ 532 ໂຄງການທີ່ມີ 1 ຄະແນນການສຳພາດສູງສຸດທີ່ຊັດເຈນ ຍັງໄດ້ໃຫ້ຜູ້ສະໝັກຄົນນັ້ນມີຄະແນນ CV ສູງສຸດນຳ.
- 54.9% ຂອງຜູ້ສະໝັກ 3,684 ຄົນທີ່ໄດ້ 8 ຫຼື ຫຼາຍກວ່າໃນການສຳພາດ (2,022 ຄົນ) ຈະຖືກຕັດອອກໂດຍ ບັນຊີສັ້ນ CV 20% ອັນດັບຕົ້ນ.
ທັງສອງແມ່ນຄະແນນ AI ຂອງ Flowmingo, ບໍ່ແມ່ນຜົນການເຮັດວຽກ, ແລະ ຜູ້ຖືກສຳພາດແມ່ນກຸ່ມທີ່ຖືກຄັດເລືອກແລ້ວ. ຂໍ້ມູນສະແດງວ່າການຈັດອັນດັບ 2 ຢ່າງນັ້ນແຕກຕ່າງກັນ, ບໍ່ແມ່ນວ່າອັນໃດຖືກ.
ເວົ້າແບບກົງໆ, ໃນປະມານ 4 ໃນ 5 ຂອງໂຄງການເຫຼົ່ານັ້ນ, ຜູ້ທີ່ໄດ້ຄະແນນສຳພາດສູງສຸດກໍບໍ່ໄດ້ມີຄະແນນ CV ສູງສຸດນຳ. ດັ່ງນັ້ນ ຈົ່ງໃຫ້ຄະແນນການສຳພາດແຍກຕ່າງຫາກ, ບໍ່ແມ່ນປ່ອຍໃຫ້ຄະແນນ CV ສົ່ງຕໍ່ມາ.
9. ໃບຄະແນນຂອງຂ້ອຍຈະປົກປ້ອງຂ້ອຍບໍ່ ຖ້າຜູ້ສະໝັກທີ່ຖືກປະຕິເສດມາຮ້ອງທຸກ?
ມັນຊ່ວຍໄດ້, ຖ້າມັນໃຫ້ຄະແນນຫຼັກຖານທີ່ກ່ຽວຂ້ອງກັບວຽກ ແລະ ທ່ານເກັບຮັກສາມັນໄວ້. ຕາມການຕີຄວາມແບບສົມເຫດສົມຜົນ, ກົດລະບຽບຂອງລັດຖະບານກາງສະຫະລັດໝາຍຄວາມວ່າເກັບຮັກສາໃບຄະແນນຢ່າງໜ້ອຍ 1 ປີ, ແລະ ກົດລະບຽບຂອງລັດ California 4 ປີ.
ການຮ້ອງທຸກສາມາດມາຮອດໄດ້ຫຼາຍເດືອນຕໍ່ມາ, ເມື່ອບໍ່ມີໃຜຈື່ການສຳພາດໄດ້ແລ້ວ. ໃບຄະແນນການສຳພາດທີ່ມີຄຳເວົ້າອ້າງອີງຕໍ່ແຕ່ລະທັກສະຈະສະແດງໃຫ້ເຫັນວ່າທ່ານປະເມີນຫຍັງ ແລະ ເພື່ອຫຍັງ.
ກົດລະບຽບຂອງສະຫະລັດບໍ່ໄດ້ລະບຸຊື່ໃບຄະແນນ, ແຕ່ມັນກວມເອົາ "ບັນທຶກອື່ນໆທີ່ກ່ຽວຂ້ອງກັບການຈ້າງງານ". ເມື່ອຜູ້ໃດຜູ້ໜຶ່ງຍື່ນຟ້ອງກ່ຽວກັບການແບ່ງແຍກ, ທ່ານຕ້ອງເກັບບັນທຶກທີ່ກ່ຽວຂ້ອງທັງໝົດໄວ້ຈົນກວ່າຄະດີຈະສິ້ນສຸດ. ນັ້ນລວມເຖິງບັນທຶກຂອງຜູ້ສະໝັກຄົນອື່ນໆສຳລັບວຽກດຽວກັນ, ດັ່ງນັ້ນ 1 ການຟ້ອງຈະຢຸດການເຂົ້າເຖິງຊຸດທັງໝົດ.
ກົດລະບຽບເຫຼົ່ານີ້ຖືກຕ້ອງ ຓ ເດືອນກັນຍາ 2026. ນີ້ແມ່ນບົດສະຫຼຸບ, ບໍ່ແມ່ນຄຳແນະນຳທາງກົດໝາຍ.
| ກົດລະບຽບ | ສະຖານທີ່ | ຄວາມໝາຍຕໍ່ໃບຄະແນນຂອງທ່ານ |
|---|---|---|
| 29 CFR 1602.14 | ສະຫະລັດ | ເກັບບັນທຶກການຈ້າງງານ 1 ປີ, ດົນກວ່ານັ້ນຫຼັງຈາກມີການຟ້ອງ |
| 2 CCR 11013(c) | California | ເກັບບັນທຶກ 4 ປີ, ລວມທັງຂໍ້ມູນການຕັດສິນແບບອັດຕະໂນມັດ |
| ຄຳແນະນຳ ICO | ອັງກິດ | ຜູ້ສະໝັກສາມາດຂໍບັນທຶກການສຳພາດໄດ້; ເປີດເຜີຍກົດລະບຽບການຕັດສິນໃດໆ |
| TAFEP | ສິງກະໂປ | ໃຊ້ແບບຟອມປະເມີນ ແລະ ເກັບບັນທຶກຢ່າງໜ້ອຍ 1 ປີ |
| 29 CFR 1630.11 (ADA) | ສະຫະລັດ | ຖ້າຄວາມພິການສົ່ງຜົນຕໍ່ການເວົ້າ, ໃຫ້ຄະແນນທັກສະ, ບໍ່ແມ່ນການເວົ້າ, ເວັ້ນເສຍແຕ່ການເວົ້າແມ່ນສິ່ງທີ່ວຽກຕ້ອງການ |
| AI Act, ມາດຕາ 5(1)(f) | EU, ຕັ້ງແຕ່ 2 ກຸມພາ 2025 | ຫ້າມ AI ທີ່ເດົາອາລົມຂອງຜູ້ສະໝັກຈາກໃບໜ້າ, ທ່າທາງ ຫຼື ການເຄາະແປ້ນພິມ |
| AI Act, ພາກຜະໜວກ III ແລະ ມາດຕາ 26 | EU, ຕັ້ງແຕ່ 2 ທັນວາ 2027 | ຄວາມສ່ຽງສູງ: ການກຳກັບດູແລໂດຍມະນຸດ, ເກັບບັນທຶກ 6+ ເດືອນ, ແຈ້ງໃຫ້ຜູ້ສະໝັກຊາບ |
| Local Law 144 | ນະຄອນນິວຢອກ | ຄະແນນ AI ທີ່ໃຊ້ຢ່າງດຽວ, ຖ່ວງນ້ຳໜັກສູງກວ່າທຸກຢ່າງ ຫຼື ໃຊ້ເພື່ອຂັດຂຽນຄົນ: ກວດສອບຄວາມລຳອຽງປະຈຳປີ ແລະ ແຈ້ງໃຫ້ຊາບ |
| AI Video Interview Act | Illinois | ແຈ້ງໃຫ້ຊາບ, ອະທິບາຍ ແລະ ຂໍຄວາມຍິນຍອມກ່ອນ; ລຶບວິດີໂອພາຍໃນ 30 ວັນຫຼັງມີຄຳຮ້ອງຂໍ |
ນັ້ນແມ່ນເຫດຜົນທີ່ແບບຟອມມີແຖວ "ບໍ່ໃຫ້ຄະແນນ". EU ຫ້າມ AI ທີ່ອ່ານອາລົມຂອງຜູ້ສະໝັກຈາກໃບໜ້າ, ທ່າທາງ ຫຼື ການເຄາະແປ້ນພິມ, ແລະ ກົດໝາຍຄວາມພິການຂອງສະຫະລັດ (ADA) ປົກປ້ອງຜູ້ສະໝັກທີ່ຄວາມພິການສົ່ງຜົນຕໍ່ການເວົ້າ. ໃນອັງກິດ, ຜູ້ສະໝັກສາມາດຂໍບັນທຶກຂອງທ່ານໄດ້, ດັ່ງນັ້ນ ຈົ່ງຂຽນແຕ່ລະແຖວຫຼັກຖານຄືກັບວ່າພວກເຂົາຈະອ່ານມັນ.
ເພື່ອກວດສອບຕົນເອງ, ຈົ່ງປຽບທຽບອັດຕາການຜ່ານຕາມກຸ່ມກັບກົດ 4/5 ໃນ Uniform Guidelines. ສົມມຸດວ່າ 30% ຂອງ 1 ກຸ່ມຜ່ານ ແລະ 50% ຂອງອີກກຸ່ມໜຶ່ງຜ່ານ: 30 ຫານ 50 ໄດ້ 0.6, ຕ່ຳກວ່າ 0.8, ດັ່ງນັ້ນ ຈົ່ງເບິ່ງໃຫ້ໃກ້ຊິດກວ່າ.
ຄຳເຫັນຂອງກະຊວງຍຸຕິທຳ ເດືອນມິຖຸນາ 2026 ແລະ ກົດລະບຽບ OPM ເດືອນກໍລະກົດ 2026 ເຮັດໃຫ້ອົງກອນລັດຖະບານກາງສະຫະລັດຫ່າງເຫີນຈາກ Guidelines. ແຕ່ຢ່າງໃດກໍດີ ພວກມັນຍັງຄົງຢູ່ໃນກົດລະບຽບລັດຖະບານກາງ, ດັ່ງນັ້ນ ຈົ່ງຖືວ່າການກວດສອບນີ້ເປັນນິໄສທີ່ບໍ່ແພງ, ບໍ່ແມ່ນເສັ້ນທາງທາງກົດໝາຍ.
10. ຂ້ອຍຈະເລີ່ມໃຊ້ໃບຄະແນນການສຳພາດກັບທີມງານຂອງຂ້ອຍໃນອາທິດນີ້ໄດ້ແນວໃດ?
ສ້າງມັນຕາມລຳດັບນີ້, ແລະ ປ່ຽນມັນພຽງແຕ່ລະຫວ່າງຕຳແໜ່ງຕ່າງໆ. ສະບັບທຳອິດບໍ່ຈຳເປັນຕ້ອງສົມບູນແບບ, ແຕ່ມັນຕ້ອງເປັນອັນດຽວກັນສຳລັບຜູ້ສະໝັກທຸກຄົນ.
- ຂຽນຈຸດປະສົງ 1 ແຖວ ແລະ ຜົນໄດ້ຮັບຈັດລຳດັບ 3 ຫາ 8 ຂໍ້.
- ປ່ຽນພວກມັນໃຫ້ເປັນ 5 ທັກສະ ແລະ ໝາຍຂໍ້ທີ່ຈຳເປັນ.
- ຂຽນຄຳຖາມກ່ຽວກັບພຶດຕິກຳໃນອະດີດ 2 ຂໍ້ ແລະ ຫຼັກອ້າງອີງສຳລັບລະດັບ 1, 3 ແລະ 5 ໃນແຕ່ລະທັກສະ.
- ໃຫ້ຜູ້ສຳພາດສູງເຖິງ 4 ຄົນໃຫ້ຄະແນນດ້ວຍຕົນເອງ ແລະ ສົ່ງກ່ອນການປະຊຸມສະຫຼຸບ.
- ໃຫ້ຄະແນນລວມເປັນຕົວຕັດສິນ, ແຕ່ຖ້າຂໍ້ທີ່ຈຳເປັນໃດໜຶ່ງໄດ້ຕ່ຳກວ່າ 3 ໝາຍເຖິງບໍ່ຮັບ. ຂຽນທຸກການປ່ຽນແປງຄະແນນໄວ້.
ໃນພາກປະຕິບັດ, ເລີ່ມຈາກຕຳແໜ່ງທີ່ເປີດຢູ່ 1 ຕຳແໜ່ງ, ເພື່ອໃຫ້ທີມຂອງທ່ານຮຽນຮູ້ນິໄສນີ້ຈາກວຽກຕົວຈິງ. ກ່ອນການສຳພາດຄັ້ງທຳອິດ, ໃຫ້ທຸກຄົນໃຫ້ຄະແນນຄຳຕອບຕົວຢ່າງດຽວກັນ ແລະ ປຽບທຽບກັນ.
ຖ້າຄະແນນ 2 ອັນຕ່າງກັນເກີນ 1 ຄະແນນ, ໃຫ້ຂຽນຫຼັກອ້າງອີງໃໝ່ຈົນກວ່າຈະຕົງກັນ. ຜູ້ໃຫ້ຄະແນນທີ່ຜ່ານການຝຶກໃນການສຶກສາພາກທີ 8 ໄດ້ໃຊ້ຊ່ອງຫວ່າງ 1 ຄະແນນດຽວກັນນີ້ເພື່ອເອີ້ນປະຊຸມ.
ຄາດວ່າຈະມີການຕໍ່ຕ້ານແດ່. ຜູ້ສຳພາດຂອງກອງທັບຂອງ Kahneman ກໍ່ຄັດຄ້ານກັບການພຽງແຕ່ບັນທຶກຄຳຕອບເຊັ່ນກັນ, ແລະ ວິທີແກ້ໄຂຂອງລາວແມ່ນການໃຫ້ຄະແນນແບບປິດຕາ, ເຊິ່ງເຮັດໃຫ້ການຕັດສິນຂອງພວກເຂົາມີບ່ອນຢູ່ໃນແບບຟອມ. ແຖວຄວາມປະທັບໃຈລວມຂອງທ່ານເຮັດໜ້າທີ່ນັ້ນໃຫ້ທີມຂອງທ່ານ.
Flowmingo ຊ່ວຍໄດ້ແນວໃດ
ເພື່ອສົ່ງການສຳພາດແບບມີໂຄງສ້າງໃຫ້ຜູ້ສະໝັກທຸກຄົນເຮັດໃນເວລາຂອງຕົນເອງ, ບັນທຶກ ແລະ ໃຫ້ຄະແນນຕາມແບບຟອມຄະແນນການສຳພາດ 1 ອັນ, ລອງໃຊ້ Flowmingo.
11. ແຫຼ່ງຂໍ້ມູນ
ຕົວເລກພາຍນອກທັງໝົດຂ້າງເທິງມາຈາກແຫຼ່ງຂໍ້ມູນຂ້າງລຸ່ມນີ້, ຕາມລຳດັບການປາກົດຕົວ. ຕົວເລກຂອງ Flowmingo ເອງຢູ່ໃນກ່ອງຂໍ້ມູນ, ກໍລະກົດ 2025 ຫາ ກັນຍາ 2026.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.