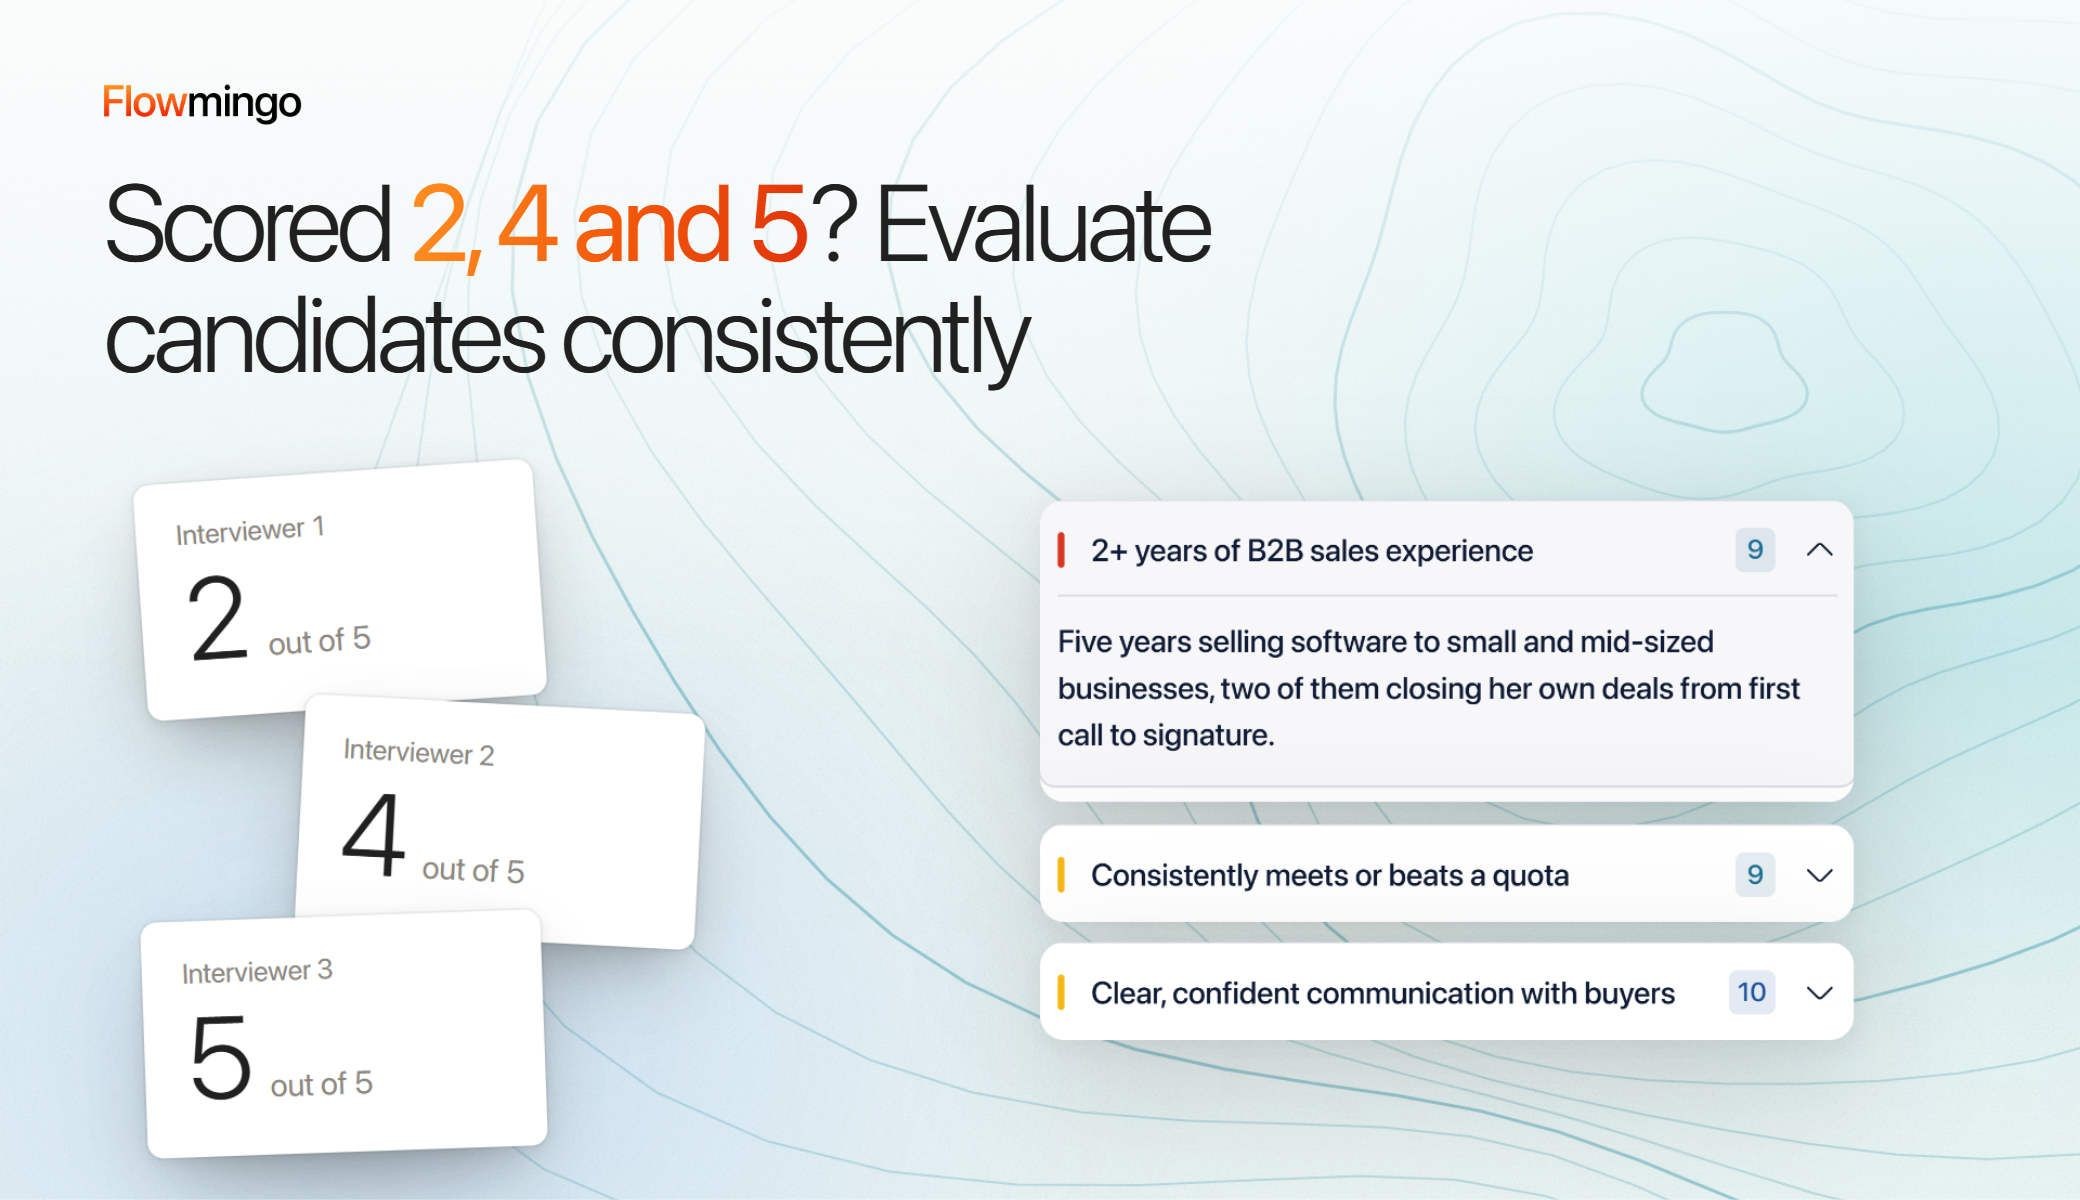
Uw 3 interviewers spraken met dezelfde kandidaat en gaven haar een 2, een 4 en een 5 op 5. U moet kandidaten consistent beoordelen, en een spreiding van 3 punten bij 1 kandidaat betekent dat het proces er nog niet is.
Die spreiding is normaal, geen falen van het team. Afzonderlijke interviewers zijn het slechts eens met 0,44 op een schaal van 0 tot 1, tegenover 0,74 voor een panel. Consistente kandidaatbeoordeling is dus iets wat u controleert, niet iets wat u aanneemt.
Sla de check over en 1 onzorgvuldige score kan het aanbod aan de zwakkere finalist geven. In sectie 8 gebeurt dat ook, 3,67 tegen 3,53, totdat de bewijscheck de sterkere naar 3,80 brengt.
Deze gids voegt de ontbrekende stap toe: met 1 aftrekking controleren of je interviewers het eens zijn voordat iemand het gemiddelde berekent. Onze template voor interview-scorecards behandelt het formulier, en onze gids over de tool voor kandidaat-interviewfeedback behandelt het verkrijgen van bruikbare verslagen.
Belangrijkste inzichten
- Mijn interviewers gaven dezelfde kandidaat een 2, 4 en 5. Is dat normaal? Ja. Afzonderlijke interviewers zijn het veel minder met elkaar eens dan een panel, dus een verschil van 3 punten komt vaak voor. Controleer het voordat je het gemiddelde berekent.
- Wat zorgt ervoor dat interviewers op dezelfde manier scoren? 4 of 5 criteria uit de functie, een schriftelijke onderbouwing bij elke score en eerst een kalibratie van 45 minuten.
- Wat staat er op tafel voordat iemand in de nabespreking iets zegt? De spreidingstabel: de vergrendelde scores van elke interviewer, met elk 1 citaat. Het gesprek gaat daarna alleen over verschillen van 2 of meer.
- Hoe controleer ik overeenstemming zonder statistiek? Trek per criterium de laagste score af van de hoogste, en stuur een verschil van 2 of meer (op 1 tot 5) terug naar het bewijs.
- Kunnen de wegingen bepalen wie het aanbod krijgt? Ja. In het uitgewerkte voorbeeld wint Kandidaat A met 3,80 tegen 3,67 gewogen, maar verliest met 3,58 tegen 4,00 op een gewoon gemiddelde.
1. Mijn 3 interviewers beoordeelden dezelfde kandidaat met 2, 4 en 5. Hoe evalueer ik kandidaten consistent?
Zie de 2, 4 en 5 als een signaal om te controleren voordat je het gemiddelde berekent. Om kandidaten consistent te evalueren, leg je 6 dingen vast: criteria, ankers, kalibratie, citaten, individueel scoren en een spreidingscontrole.
De spreiding zelf is normaal. De baanbrekende meta-analyse van Huffcutt en collega's uit 2013 bundelde 125 betrouwbaarheidsschattingen van 32.428 personen. Afzonderlijke interviews door verschillende mensen kwamen slechts tot 0,44 overeen op een schaal van 0 tot 1, tegen 0,74 voor panels.
Dit gebeurt omdat elke interviewer scoort vanuit een eigen idee van wat goed eruitziet, dat niemand heeft opgeschreven. Volgens US OPM verhoogt structuur de overeenstemming door "de hoeveelheid discretie die een interviewer is toegestaan" te beperken (OPM).
Gedeelde criteria en ankers zijn dus de moeite waard. Gestructureerde interviews stonden op de eerste plaats onder de selectiemethoden in de baanbrekende heranalyse van Sackett en collega's uit 2022, zelfs na strengere correcties.
De secties 2 tot en met 7 behandelen de 6 onderdelen in volgorde, en sectie 8 past ze allemaal toe op 1 illustratieve functie, geen klantgegevens. Daar verschuift het toetsen van elke score aan het bijbehorende citaat de 2 van Interviewer 1 naar een 4, zodat de 2, 4 en 5 veranderen in 4, 4 en 5.
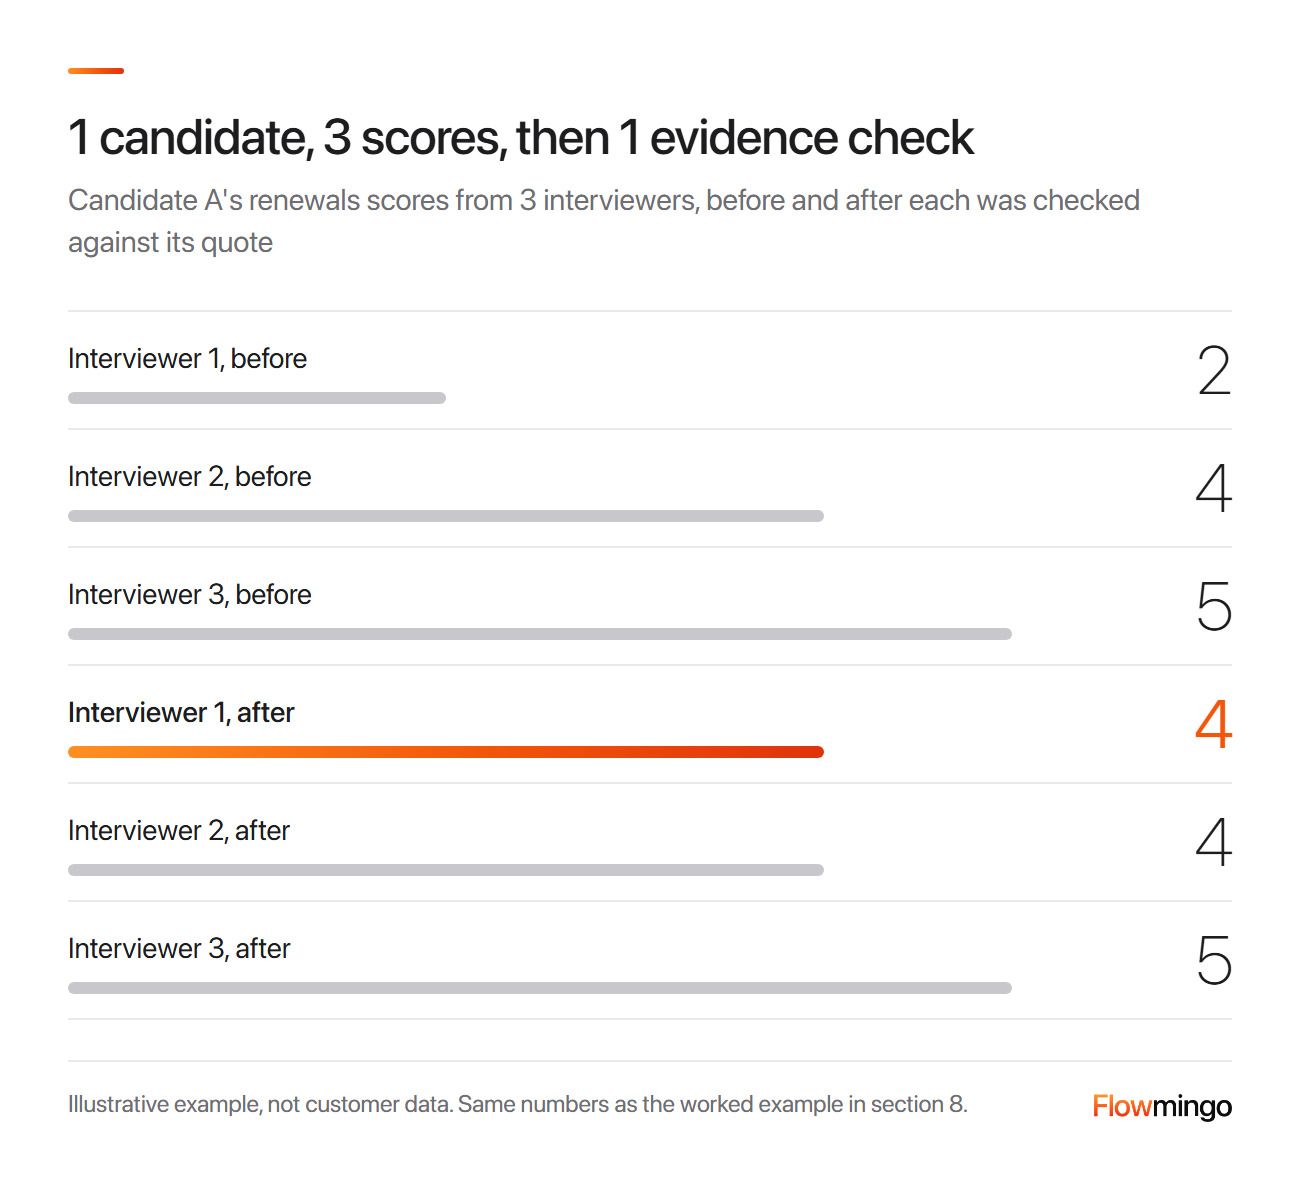
Voor en na de bewijscontrole: Interviewers 1, 2 en 3 gaven 2, 4 en 5, en daarna 4, 4 en 5 (illustratief).
2. Hoe zet ik de functiebeschrijving om in 4 of 5 criteria waarop iedereen op dezelfde manier scoort?
Haal de 4 of 5 resultaten op die de functie in de eerste 6 maanden moet opleveren, en schrijf elk resultaat als iets wat een kandidaat kan laten zien. Weeg ze voordat het eerste interview plaatsvindt en gebruik ze in elke fase.
Criteria falen wanneer ze een persoonlijkheid beschrijven in plaats van een resultaat, want niemand kan een "commerciële instelling" horen. "Houdt verlengingen op koers" wijst op werk dat een kandidaat kan beschrijven.
Als een hiring manager het "weet het wanneer die het ziet", vraag dan wat de beste persoon in de functie tegen maand 3 deed dat een gemiddelde niet deed. Dat antwoord wordt een criterium in je raamwerk voor kandidaatevaluatie.
Meer structuur heeft grenzen. In een fundamentele meta-analyse uit 1994 van 114 validiteitsschattingen vonden Huffcutt en Arthur dat extra structuur vanaf een bepaald punt vrijwel niets meer toevoegde.
Hier is een illustratieve rol als Customer Success Manager, gewogen van 4 voor een must have tot 1.
| Criterium | Weging | Uit de functiebeschrijving | Gecontroleerd bij |
|---|---|---|---|
| Houdt verlengingen op koers | Must have (4) | Beheert verlengingen voor B2B-accounts | CV, interview |
| Kalmeert een boze klant | Zeer belangrijk (3) | Eerste aanspreekpunt voor escalaties | Interview |
| Onboardt een nieuwe klant | Belangrijk (2) | Verzorgt onboarding voor nieuwe accounts | Interview, werkopdracht |
| Houdt het CRM up to date | Goed om te hebben (1) | Legt elk klantcontact vast | Screeningsvraag, interview |
De laatste kolom legt vast waar je elk criterium controleert, zodat geen enkele fase iets nieuws beoordeelt. Elke must-have onder 3 betekent geen aanwerving, de ondergrens uit onze scorecard-template. Bij meerdere interviewers pas je dat toe op het gemiddelde van dat criterium.
Hoe Flowmingo helpt
Plak je vacature en de AI Interviewer stelt de vragen en gewogen criteria op. Je kunt de vragen bewerken voordat je iemand uitnodigt. Een Must Have telt 4 keer zo zwaar als een Goed om te hebben, en wijst nooit automatisch iemand af (Hoe we scoren). CV-screening gebruikt dezelfde criteria als het interview (FAQ).
3. Hoe zou een 1, een 3 en een 5 er voor elk criterium eigenlijk moeten uitzien?
Schrijf op wat een antwoord met een 1, een 3 en een 5 bevat: wat de kandidaat deed en liet zien, niet hoe die overkwam. Voeg 1 voorbeeldregel per score toe, zodat elke interviewer op hetzelfde let.
Ankers werken omdat ze het oordeel van smaak naar bewijs verplaatsen. "Goede energie" beschrijft een gevoel, terwijl "noemde de actie en het resultaat" een antwoord beschrijft.
Volgens de US OPM gebruiken de meest gestructureerde interviews "benchmarks of proficiency" (OPM). De fundamentele review van Levashina en collega's uit 2014 noemt beoordelingsschalen als 1 van 8 kernthema's in het onderzoek.
Schrijf eerst de 1, 3 en 5, dan de 2 en 4. Hier is de illustratieve must-have, voor "Vertel me over een verlenging die je bijna verloor."
| Score | Wat het antwoord bevat | Voorbeeldregel |
|---|---|---|
| 5 | Een 4, plus wat ze daarna hebben veranderd | "Nadat ik er 2 kwijtraakte, begon ik 90 dagen voor de verlenging met reviews" |
| 4 | Een voorbeeld, de actie en een resultaat met een getal | "Ik verlengde 38 van mijn 40 accounts en verloor er 2 door budgetkortingen" |
| 3 | Een actie en een resultaat, maar geen getal | "Ik plande een gesprek met de inkoper en ze verlengden" |
| 2 | Een actie zonder resultaat | "Ik zou vroeg contact opnemen" |
| 1 | Geen voorbeeld, alleen algemene uitspraken | "Verlengingen draaien om relaties" |
| Niet getoond | Kwam nooit aan het criterium toe | Noteer "niet getoond" en vraag opnieuw |
Een 2 noemt een actie en een 3 voegt het resultaat toe, zodat 2 luisteraars op hetzelfde cijfer uitkomen. De HR-gids van de University of Washington vraagt beoordelaars om vooraf af te spreken wat een 2 van een 3 scheidt, wat dit anker vastlegt.
Op een schaal van 1 tot 5 is een 3 echte erkenning, dus middel alleen de interviewers die bewijs hebben gehoord. Als niemand dat deed, vraag dan opnieuw voordat je gaat bespreken.
4. Hoe voer ik een kalibratiesessie uit zodat mijn interviewers kandidaten consistent beoordelen?
Plan 45 minuten vóór het eerste gesprek en laat iedereen dezelfde 2 voorbeeldantwoorden apart beoordelen. Onthul daarna de scores en herschrijf elk anker dat een verschil van 2 of meer opleverde.
Onderzoekers noemen dit frame-of-reference-training. In een fundamentele meta-analyse uit 2012 met meer dan 4 keer zoveel studies als de eerdere review, ontdekten Roch en collega's dat het beoordelingen nauwkeuriger maakte. Onze agenda is onze eigen versie, niet het protocol uit het artikel.
Onze handleiding voor gestructureerde interviews kalibreert op 1 antwoord, en de langere sessie in onze gids over interviewbias gebruikt er 3. Deze versie gebruikt er 2, het kleinste aantal dat laat zien of een verschil zich herhaalt.
Lees de ankers 5 minuten, bekijk 2 voorbeeldantwoorden 10 minuten en beoordeel ze 10 minuten apart met elk 1 citaat. Onthul daarna de scores en controleer de spreiding 10 minuten, en herstel de ankers 10 minuten.
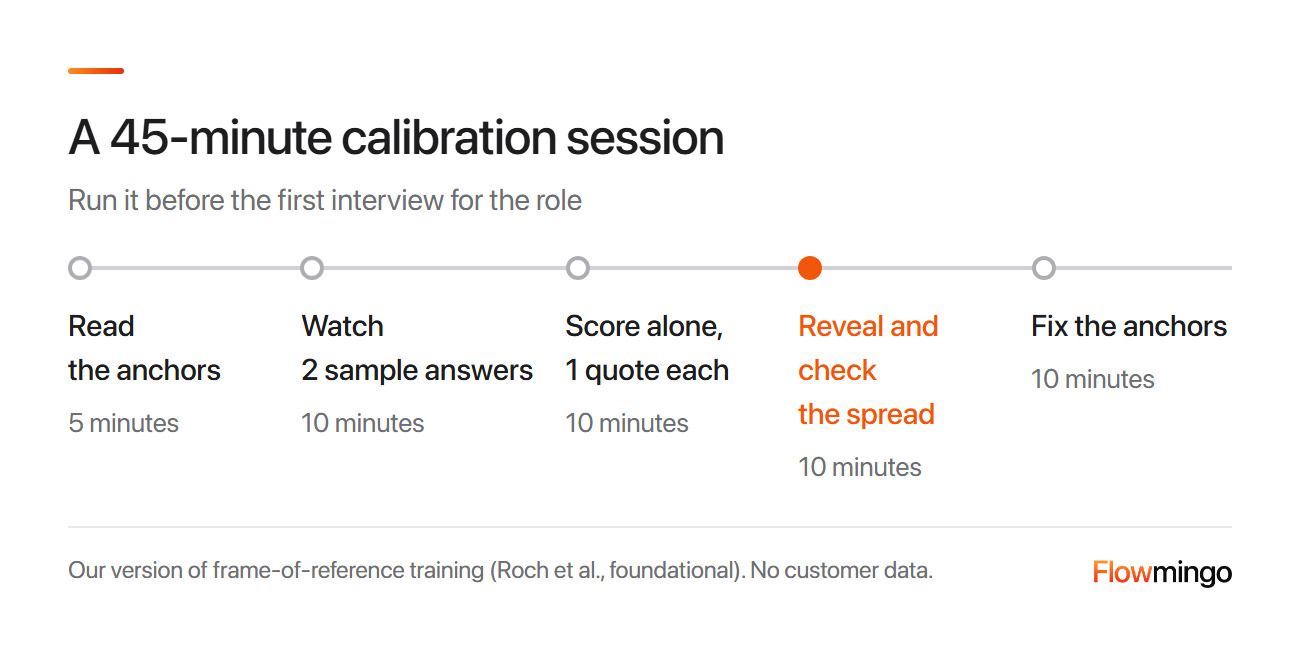
Kalibratiesessie: 5 stappen, 45 minuten, met het onthullen en controleren van de spreiding als stap 4.
Stap 4 is het belangrijkst, omdat iedereen dezelfde woorden hoorde. Een 2 tegenover een 4 op dezelfde opname ligt dus aan het anker, en je past de formulering aan, niet de kandidaat.
Gebruik een opgenomen antwoord van een eerdere aanname die daarmee instemde, of schrijf er 2. Herhaal de sessie wanneer een interviewer toetreedt, de rol verandert, of wanneer meer dan 1 op de 4 scores 2 of meer uiteenlopen.
Alleen aanwerven: calibreer tegen jezelf: scoor 2 opnames en scoor ze een week later blind opnieuw. Een verschil van 2 of meer betekent dat het ankerpunt werk nodig heeft.
5. Hoe krijg ik interviewers zover dat ze feedback met bewijs schrijven in plaats van 'goed gevoel'?
Maak van 1 citaat of concreet voorbeeld de prijs van elke score: geen citaat, geen score. Iedereen kan een 4 naast "Ik heb 38 van mijn 40 accounts verlengd" controleren, en niemand kan "goed gevoel" controleren.
Drukke interviewers schrijven op wat ze zich herinneren, en dat is meestal een gevoel. Een post op r/humanresources zegt dat interviewers essays of "goed gevoel" schrijven in plaats van scores.
In 3 fundamentele onderzoeken uit 2013 ontdekten Dana, Dawes en Peterson dat mensen net zo zelfverzekerd indrukken vormden op basis van willekeurige antwoorden als op basis van echte antwoorden. De deelnemers waren studenten die cijfers voorspelden, dus de link met aanwerving is een analogie.
Vraag dus om een notitie van 3 regels per criterium: de score, de woorden van de kandidaat en wat er voor de volgende score nodig was. De notitie van interviewer 2 over kandidaat A geeft bijvoorbeeld een 4, citeert "Ik heb 38 van mijn 40 accounts verlengd" en voegt toe "geen verandering na de 2 verliezen".
Verzamel de notities binnen 24 uur, zolang de antwoorden nog vers zijn. De HR-gids van Yale vraagt om evaluaties binnen 1 dag.
Schrijf elke notitie alsof de kandidaat hem zal lezen, want in het VK kan die erom vragen (sectie 9). Onze templates voor afwijzingsmails aan kandidaten zetten de notities om in 1 eerlijk sterk punt en 1 hiaat.
Hoe Flowmingo helpt
In een Flowmingo AI-interviewrapport komt elke criteriumbeoordeling met schriftelijke redenen, sterke punten en hiaten, plus de opname en het volledige transcript (FAQ). Een highlight moet een exacte zin uit het transcript zijn, en een parafrase telt niet als citaat (Hoe we scoren).
6. Moeten mijn interviewers eerst zelf scoren voor de nabespreking, of eerst samen overleggen?
Scoor altijd eerst apart. Elke interviewer dient scores en citaten in voordat hij die van iemand anders ziet, en daarna bespreekt de nabespreking alleen de verschillen en combineert een formule de rest.
Eerst overleggen laat 1 mening de lat bepalen. Het fundamentele boek Noise uit 2021 van Kahneman, Sibony en Sunstein noemt onafhankelijkheid 1 van de 3 principes van gestructureerd oordelen (geciteerd in highlights van lezers). Bij het Amerikaanse OPM beoordelen panelleden "de antwoorden van kandidaten individueel" voordat de groepsdiscussie begint (OPM).
In de baanbrekende meta-analyse van Conway en collega's uit 1995 hielpen verschillende beoordelingen alleen wanneer een vaste regel ze combineerde, zonder enig bewijs dat discussie hielp.
In de baanbrekende meta-analyse van Kuncel en collega's uit 2013 voorspelde een vaste formule de werkprestatie meer dan 50% beter dan mensen die alles in hun hoofd tegen elkaar afwegen. Dat gold zelfs voor experts die de functies kenden, en de data bundelden vele soorten selectie-informatie.
Voer de nabespreking in deze volgorde uit: iedereen leest zijn eigen citaat voor, een score verandert alleen ten opzichte van het anker, en de meest senior persoon spreekt als laatste.
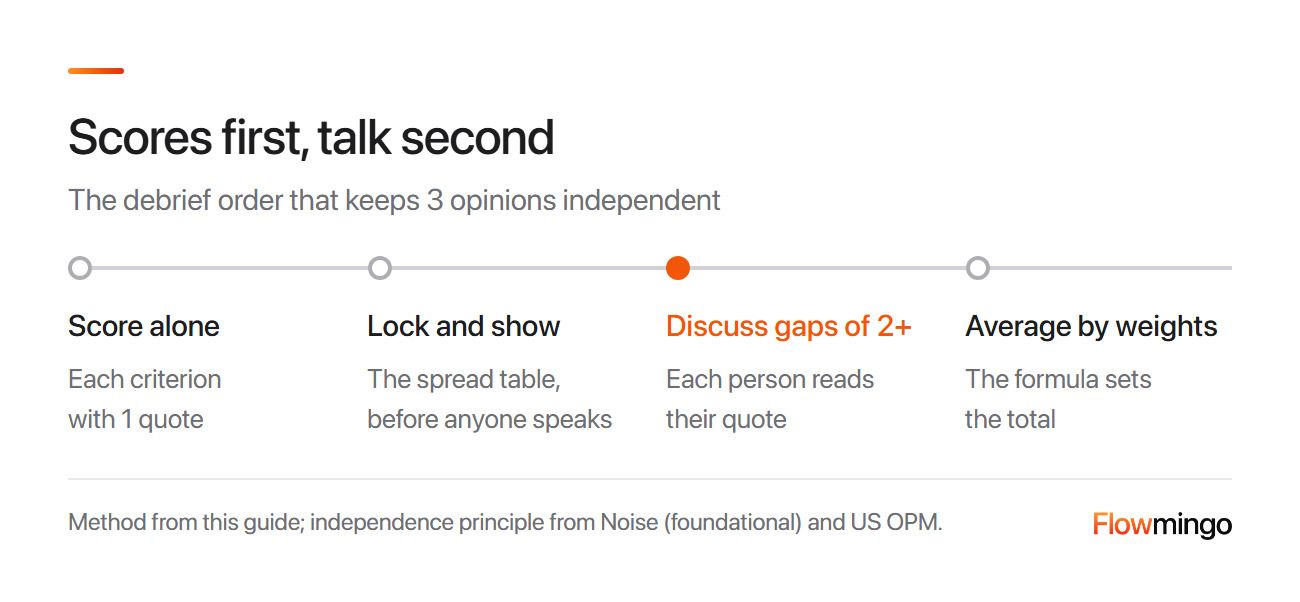
Volgorde van de nabespreking: eerst individueel scoren, vastzetten en de spreidingstabel tonen, verschillen van 2+ bespreken, dan wegen en middelen.
6.1 Moet mijn panel samen of apart interviewen, en hoeveel interviewers heb ik nodig?
Beide werken als iedereen individueel scoort. Panels waren het veel vaker eens in de meta-analyse van Huffcutt (sectie 1), waarschijnlijk deels omdat panelleden dezelfde prestatie zien, onze lezing.
Aparte interviews geven meer onafhankelijke blikken. Singapore's TAFEP-handboek suggereert waar mogelijk meer dan 1 interviewer, en een divers panel om vooroordelen te helpen minimaliseren.
Gebruik dus tot 4 interviewers in aparte rondes, van wie 1 een specialist. Ieder stelt dezelfde kernvraag per criterium en scoort elk criterium, en de specialist gaat ook 1 must-have dieper na.
Splits de criteria nooit: 1 score per criterium laat de spreidingscheck niets om mee te vergelijken. Een 5e voegt meer meningsverschil dan bewijs toe, onze vuistregel.
7. Hoe kan ik controleren of mijn interviewers het echt eens zijn, zonder statistiekdiploma?
Trek voor elke kandidaat en elk criterium de laagste score af van de hoogste. Op een schaal van 1 tot 5 gaat een verschil van 2 of meer terug naar het bewijs.
Check 1, de spreiding: de 2-puntsmarkering is onze vuistregel. OPM adviseert panels om eerst individueel te beoordelen en daarna "significante scoreverschillen" op te lossen, en 2 punten is hoe wij significant definiëren.
In de figuur lopen A's scores voor verlengingen van 2, 4 en 5 uiteen met 3 punten, terwijl de andere 3 criteria binnen 1 punt overeenkomen.
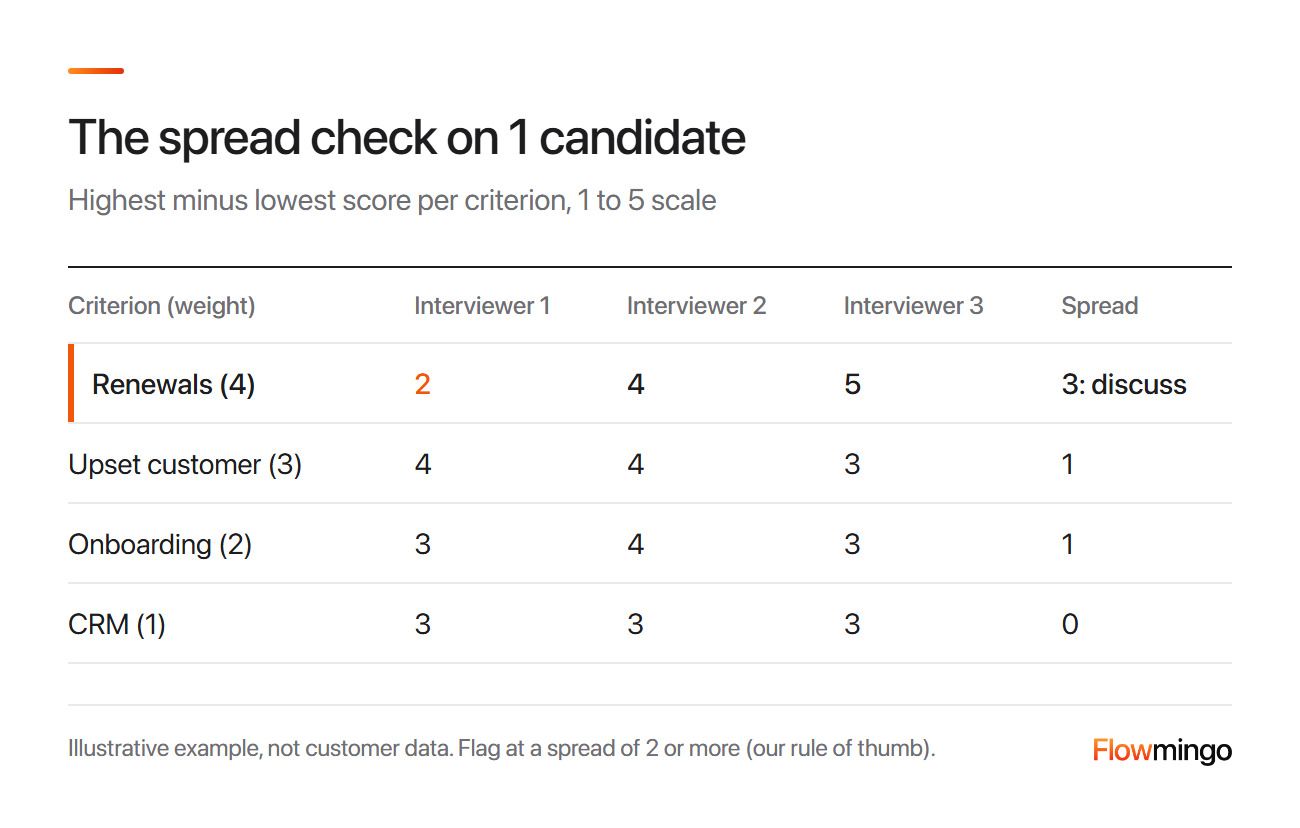
Spreidingscontrole, ter illustratie: verlengingen spreiden 3 punten en gaan terug naar het bewijs, terwijl de andere 3 criteria binnen 1 punt overeenkomen.
Check 2, de neiging van de interviewer: over 10+ kandidaten trek je het teamgemiddelde af van het gemiddelde van elke interviewer. In de figuur komen Interviewers 1, 2 en 3 uit op gemiddelden van 3,1, 3,6 en 4,4, tegen een teamgemiddelde van 3,7.
Hun neigingen zijn -0,6, -0,1 en +0,7. Een neiging van meer dan 0,5 in beide richtingen, onze vuistregel, levert een 1-op-1-kalibratie op, geen verwijt, dus Interviewers 1 en 3 krijgen er elk een.
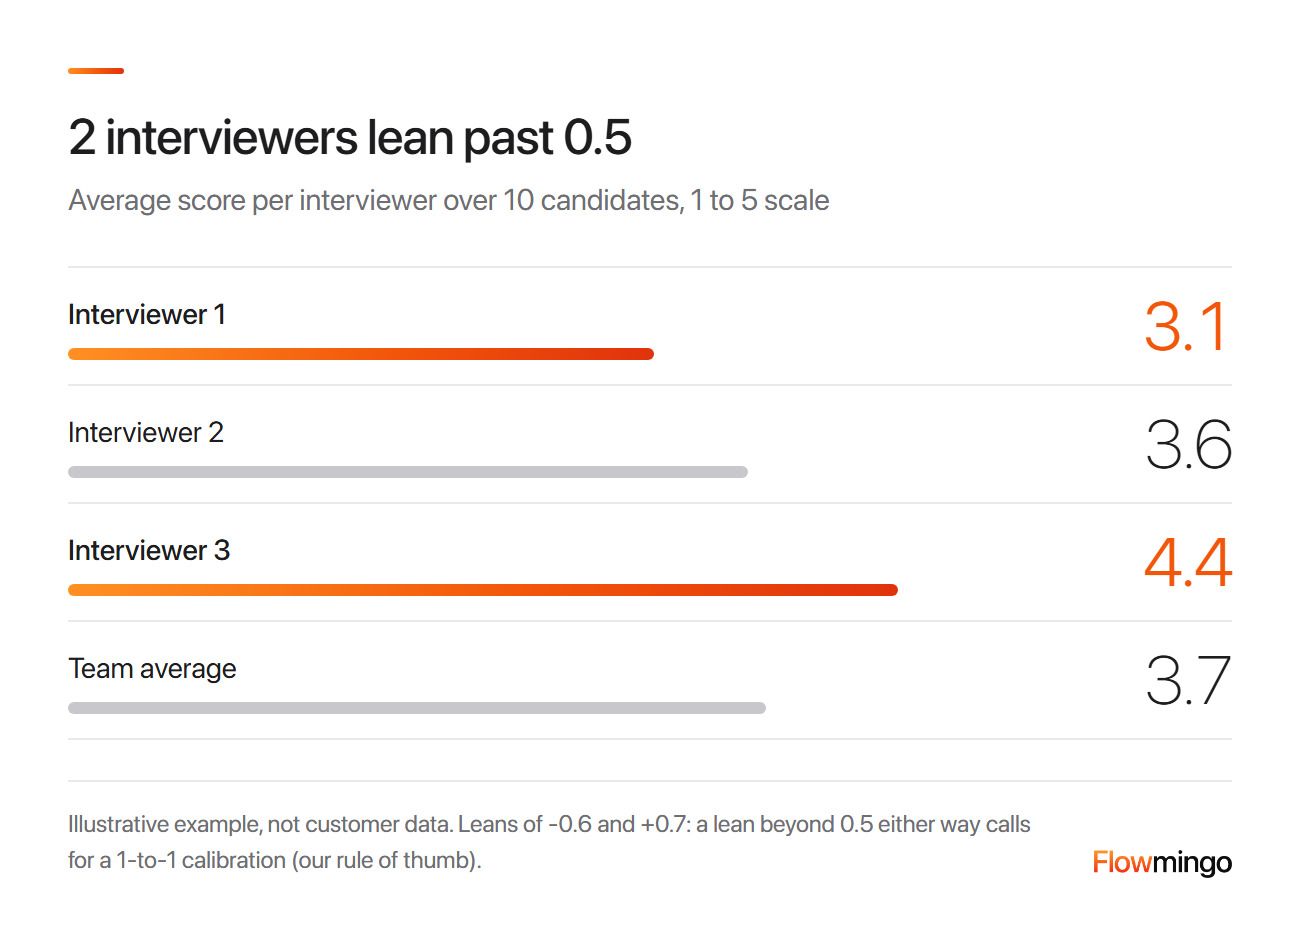
Neiging van interviewers, ter illustratie: Interviewers 1 en 3 komen uit op gemiddelden van 3,1 en 4,4 tegen een teamgemiddelde van 3,7, neigingen van -0,6 en +0,7.
Check 3, het markeringspercentage: als meer dan 1 op de 4 scores in een ronde in een gemarkeerde kloof valt, kalibreer opnieuw, onze vuistregel.
Bijvoorbeeld, 3 interviewers die 4 criteria scoren voor 5 kandidaten geven 60 scores, en 18 in gemarkeerde kloven is 30%. Dat wijst op vage ankers, dus pas de ankers aan, niet de mensen.
Slagingspercentages per groep zijn een aparte controle, in sectie 9 en onze gids over interviewbias.
8. Kan ik een uitgewerkt voorbeeld zien van hoe je kandidaten consistent beoordeelt, van vacature tot beslissing?
Ja: 1 illustratieve Customer Success Manager-rol, geen klantgegevens, met 4 gewogen criteria, 3 interviewers en 2 finalisten. Vóór de controle geeft 1 ongecontroleerde score van 2 de baan aan B, 3,67 tegen A's gewogen 3,53.
De spreidingscontrole markeert A's renewals-scores van 2, 4 en 5. Interviewer 1 gaf de 2 omdat A "onzeker leek", maar dezelfde notitie citeert "Ik heb 38 van mijn 40 accounts verlengd".
Dat komt overeen met het ankerpunt voor een 4, dus de score gaat naar 4. Interviewer 3 houdt de 5, omdat A in die ronde toevoegde "nadat ik er 2 kwijt was, begon ik reviews 90 dagen voor de verlenging". Interviewer 2 hoorde dat nooit, dus de definitieve 4, 4 en 5 hebben een spreiding van 1.
| Criterium (gewicht) | A: Interviewers 1, 2, 3 | A-gemiddelde | B: Interviewers 1, 2, 3 | B-gemiddelde |
|---|---|---|---|---|
| Renewals (4) | 4, 4, 5 (was 2, 4, 5) | 4,33 (was 3,67) | 3, 3, 3 | 3,00 |
| Ontevreden klant (3) | 4, 4, 3 | 3,67 | 3, 4, 4 | 3,67 |
| Onboarding (2) | 3, 4, 3 | 3,33 | 4, 5, 4 | 4,33 |
| CRM (1) | 3, 3, 3 | 3,00 | 5, 5, 5 | 5,00 |
| Gewogen totaal | 3,80 (was 3,53) | 3,67 | ||
| Gewoon gemiddelde | 3,58 (was 3,42) | 4,00 |
De som voor A: (4,33 x 4 + 3,67 x 3 + 3,33 x 2 + 3,00 x 1) / 10 = 3,80.
Ongerwogen zou B met 4,00 tegen 3,58 winnen op de 2 kleinere criteria.
Beiden halen de must-have-ondergrens van 3, B precies, dus A krijgt het aanbod op basis van het hogere totaal. Zo beoordeel je kandidaten consistent: het bewijs voedt de formule, en de formule beslist.
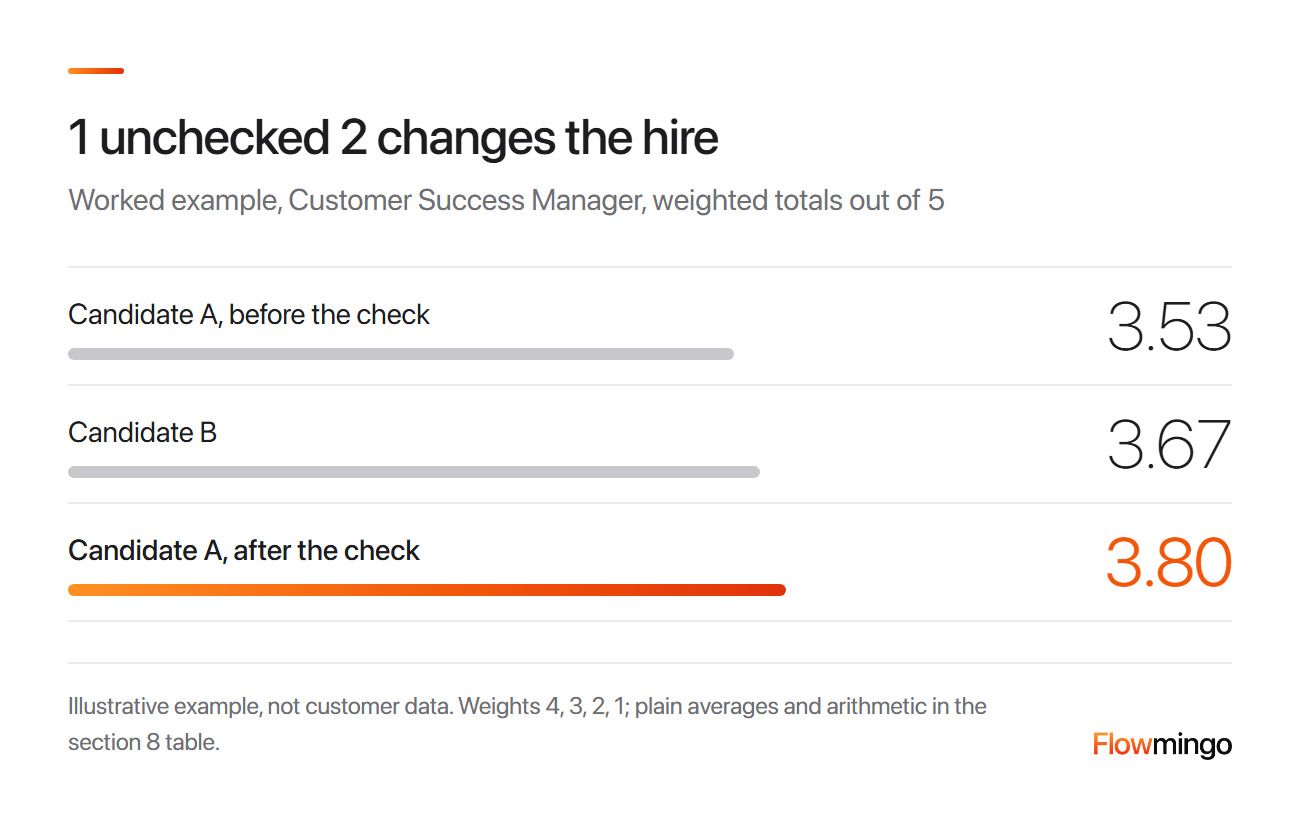
Gewogen totalen, illustratief: Kandidaat A gaat van 3,53 vóór de controle naar 3,80 erna, voorbij Kandidaat B op 3,67. Ongerwogen zou B leiden met 4,00 tegen 3,58.
8.1 Hoe kies ik tussen 2 finalisten als hun scores dicht bij elkaar liggen?
Beschouw gewogen totalen van 1 tot 5 die binnen 0,1 van elkaar liggen als gelijk, onze vuistregel. A en B liggen 0,13 uit elkaar, dus geen gelijkspel, maar een echt gelijkspel wordt in deze volgorde doorbroken:
- Het must-have-gemiddelde, waar A 4,33 heeft tegen 3,00 voor B.
- Los de breedste spreiding op die nog open is en vergelijk daarna opnieuw.
- Een korte werkproef op de zwakste must-have.
Beslis nooit op onderbuikgevoel of "culture fit" bij een gelijkspel, zoals onze gids over interviewbias uitlegt, en schrijf de reden op.
9. Wat moet ik bewaren zodat een aanwervingsbeslissing standhoudt als een afgewezen kandidaat die aanvecht?
Bewaar de criteria en wegingen, de scores van elke interviewer met citaten, de controle op de spreiding en de reden voor de beslissing. Bewaar ze minstens 12 maanden na de beslissing, en langer als er een claim openstaat.
Dit is algemene informatie, geen juridisch advies.
In de VS hebben federale instanties een slaagpercentage onder 4/5 (80%) van dat van de sterkste groep beschouwd als bewijs van ongunstige impact (29 CFR 1607.4). Dus 20 van de 100 die slagen tegenover 30 van de 100 geeft 67%, wat volgens deze vuistregel een nadere blik verdient.
Per 2 november 2026 staat deze regel, uit de fundamentele Uniform Guidelines van 1978, nog steeds in de eCFR. Een advies van het ministerie van Justitie van 9 juni 2026 en een OPM-regel van juli 2026 bewegen federale instanties er echter van weg.
De agenda van de EEOC vermeldt intrekking ervan in november 2026, maar Title VII en particuliere rechtszaken blijven bestaan. Houd dus, waar dat rechtmatig is, de slaagpercentages per groep bij als je eigen monitoring.
Los daarvan vraagt 29 CFR 1602.14 van gedekte werkgevers om aanwervingsgegevens 1 jaar te bewaren vanaf het record of de beslissing, afhankelijk van wat later is. Na een klacht bewaar je ze tot de zaak is afgelopen.
In het VK verbiedt de Equality Act discriminatie bij de beslissing "aan wie werk wordt aangeboden" (s39). Zodra feiten op discriminatie wijzen, moet de tribunal die vaststellen tenzij de werkgever het tegendeel aantoont (s136).
De EHRC adviseert interviewnotities 12 maanden te bewaren, omdat ze kunnen aantonen dat je niet hebt gediscrimineerd. Voor claims die voortkomen uit 1 oktober 2026 moeten de meeste binnen 6 maanden min 1 dag worden ingediend (Acas).
De ontwerp-richtlijnen van de ICO stellen dat kandidaten interviewnotities kunnen opvragen. Leg dus alleen vast wat de werving nodig heeft, en bewaar records na de claimperiode alleen met een duidelijke zakelijke reden.
In Singapore vraagt het TAFEP-handboek om criteria op basis van verdienste, een checklist die per criterium wordt gescoord, en gegevens die minstens 1 jaar worden bewaard. De Workplace Fairness Act van Singapore, aangenomen in januari 2025 (MOM), verbiedt vanaf eind 2027 aanwervingsbeslissingen op basis van 5 groepen eigenschappen, de doelstelling van MOM (MOM).
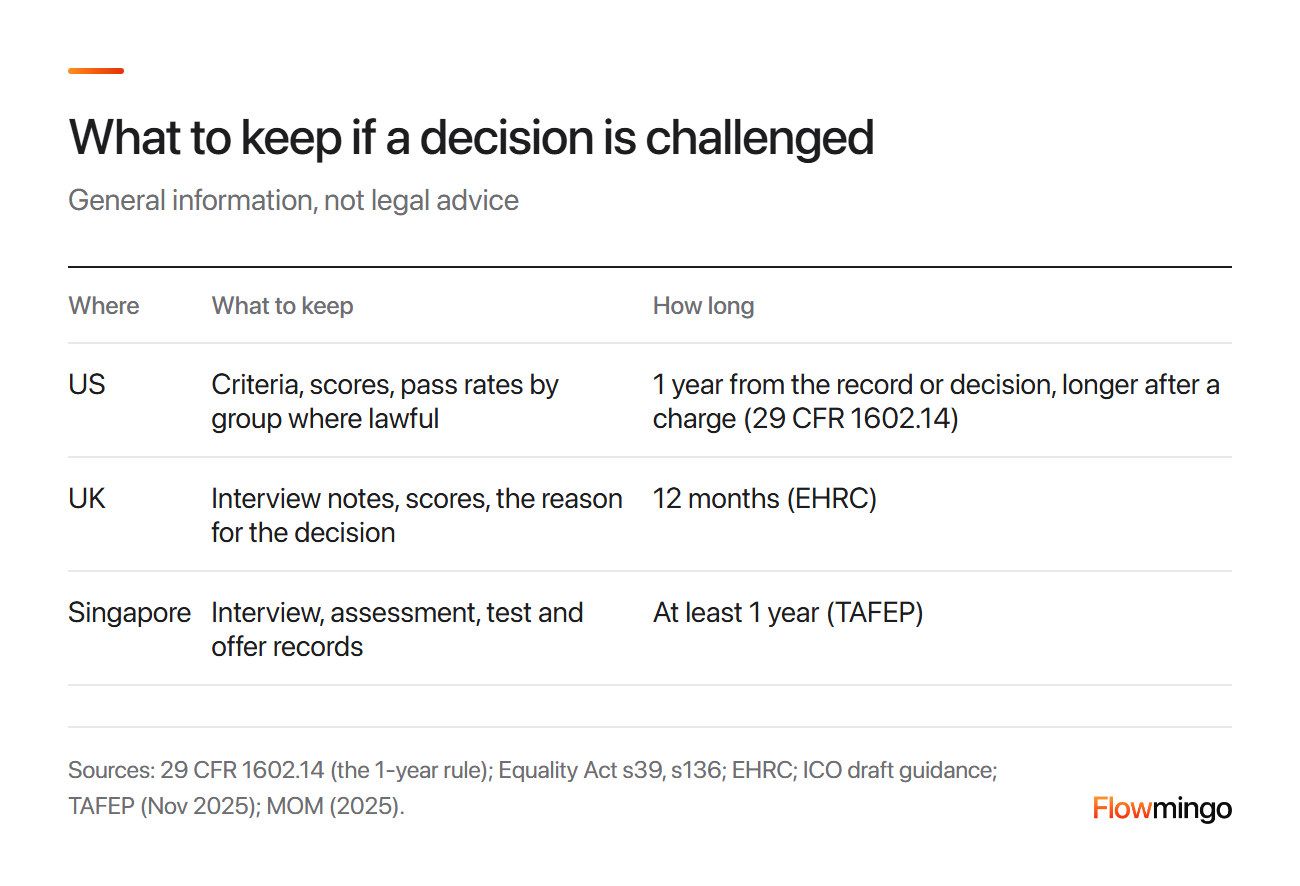
Registraties per locatie: bewaar notities, scores en de reden, 12 maanden in het VK (EHRC) en minstens 1 jaar in de VS en Singapore.
Schrijf elke notitie voor een rechtbank of voor de kandidaat. "Verlengingen 2: zei 'ik zou vroeg contact opnemen', noemde geen resultaat, dus geen 3" is voldoende. "Niet geschikt" voldoet niet, want het wijst niets aan dat de functie vereist.
9.1 Is het legaal om kandidaten verschillende vragen te stellen?
Geen van deze regels uit de VS, het VK of Singapore vereist woordelijk identieke vragen, maar verschillende vragen zijn moeilijker te vergelijken.
Volgens Titel VII is een vraag die alleen aan 1 geslacht, ras of andere beschermde groep wordt gesteld op zichzelf bewijs van discriminatie. De EEOC noemt gezinsvragen "duidelijk discriminerend" als ze alleen aan vrouwen worden gesteld, en verdacht als ze aan iedereen worden gesteld (EEOC). De Uniform Guidelines, nog steeds in de eCFR (sectie 9), rekenen zelfs een informeel interview als selectieprocedure (29 CFR 1607.16).
Stel in de praktijk iedereen dezelfde kernvraag, zoals de verlengingsvraag uit sectie 3. Vervolgvragen mogen verschillen wanneer een antwoord tekortschiet, zolang ze bij het criterium blijven.
Wanneer je een vraag moet aanpassen, bijvoorbeeld voor een voorziening bij een beperking, noteer dan wat er is veranderd en waarom.
10. Kan een AI-interviewscore mij helpen kandidaten consistent te evalueren, en hoe controleer ik dat?
Het helpt, al hebben we niet gemeten hoeveel, omdat iedereen in een rol dezelfde vragen beantwoordt aan de hand van dezelfde schriftelijke criteria. Behandel het als een vierde interviewer, niet als de rechter.
Een AI-interview haalt 2 bronnen van afwijking weg: verschillende interviewers en verschillende dagen. Het maakt vooroordelen niet onmogelijk, en de vervolgvragen variëren nog steeds, dus controleer het met onze steekproef van 10 kandidaten.
| Stap | Wat te doen | Cesuur |
|---|---|---|
| 1 | 2 mensen beoordelen 10 recente kandidaten in 1 rol, blind voor de AI | -- |
| 2 | Controleer de spreiding mens tegen mens, dan mens tegen AI | Onder 2 op 1 tot 5, of onder 3 tegen de 0 tot 10 van de AI zodra je de menselijke score verdubbelt |
| 3 | Open het citaat achter elk verschil | De exacte woorden van de kandidaat |
| 4 | Pas de formulering of weging van het criterium aan | Verschillen worden kleiner in de volgende ronde |
Als de AI en je interviewers het blijven oneens zijn over 1 criterium, pas dan één keer de formulering aan in plaats van scores één voor één te overschrijven.
Flowmingo-gegevens · 44.665 kandidaten met een AI-interviewscore, in 700 interviewsets van 10+ gescoorde kandidaten, bij 317 bedrijven, interviews afgerond tussen 9 jul en 31 okt 2026 (huidige scoring)
- Ongeveer 2,8 punten van de 10 beslaan de middelste 80% van de kandidaten in een typische set, dus scores onderscheiden mensen nog steeds.
- 6,1 van de 10 is de gemiddelde score van de mediane set, maar 1 op de 10 sets heeft een gemiddelde van 4,8 of lager en 1 op de 10 een gemiddelde van 7,1 of hoger.
- Ongeveer 1,2 punten scheiden de sets met het hoogste en laagste gemiddelde van een bedrijf mediaan gezien, over 127 bedrijven.
- 6.391 van deze kandidaten, bij 277 bedrijven, scoorden 7,0 tot 7,4, en de typische scoorde hoger dan 70% van de anderen in hun set.
- 1 op de 10 van hen scoorde hoger dan ten hoogste 46% van de anderen in hun set. Voor weer 1 op de 10 was dat ongeveer 89% of meer.
Dit zijn Flowmingo AI-interviewscores, geen werkprestaties. Sets verschillen in rol, criteria en kandidatenpool, dus verschillende gemiddelden wijzen niet op inconsistente scoring. Spreiding is geen bewijs van de juiste volgorde, en sommige interviews eindigden vroegtijdig.
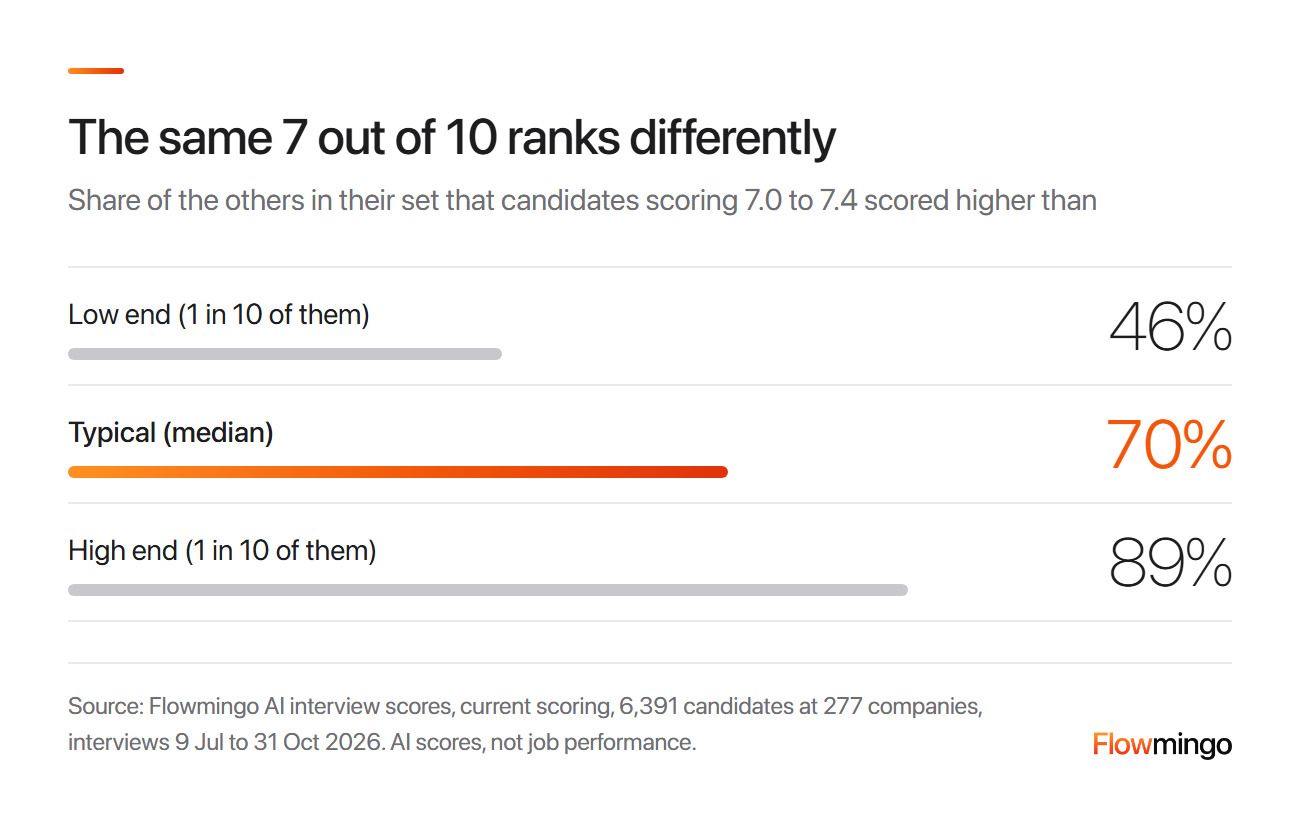
Zelfde score, andere rang: kandidaten die 7,0 tot 7,4 scoorden, scoorden mediaan gezien hoger dan 70% van de anderen in hun set. Aan de lage en hoge kant, elk 1 op de 10, was dat 46% en 89%.
Stel je 3 kandidaten voor met allemaal 7,2. Dat zit ruim boven het midden van een typische set, ongeveer in het midden van een sterke en bijna bovenaan een zwakke. Rangschik kandidaten dus binnen hun eigen set, en gebruik nooit 1 vaste drempel voor alle rollen.
De fundamentele EU AI Act van 2024 noemt AI die gebruikt wordt om kandidaten te evalueren ook hoogrisico (Bijlage III), dus het op deze manier controleren is verstandig.
In elke rol maakt de spreidingscheck een gemiddelde veiliger om te gebruiken, omdat hij de scores die afwijken terugstuurt naar hun citaten.
Hoe Flowmingo helpt
In de AI Interviewer krijgt elke sollicitant voor een rol dezelfde vragenset. Elke eis krijgt een beoordeling van 0 tot 10, gewogen volgens jouw instellingen (Hoe wij scoren). Je team kan elke score overschrijven (FAQ). Doe de check met 10 kandidaten gratis op Flowmingo en evalueer kandidaten consistent.
11. Bronnen
Elke hierboven aangehaalde studie, wet en gids, alfabetisch op auteur. Flowmingo-cijfers komen uit Flowmingo's eigen platformgegevens.
- Acas (2026, bijgewerkt 1 oktober). Termijnen voor het arbeidstribunaal. Acas.
- Conway, J. M., Jako, R. A., & Goodman, D. F. (1995). Een meta-analyse van de interbeoordelaarsbetrouwbaarheid en interne consistentiebetrouwbaarheid van selectiegesprekken. Journal of Applied Psychology, 80(5), 565-579.
- Dana, J., Dawes, R., & Peterson, N. (2013). Geloof in het ongestructureerde interview: het voortbestaan van een illusie. Judgment and Decision Making, 8(5), 512-520.
- Equal Employment Opportunity Commission en anderen (1978). Uniforme richtlijnen voor personeelsselectieprocedures, 29 CFR deel 1607. eCFR, geraadpleegd 2 november 2026.
- Equal Employment Opportunity Commission (z.d., geraadpleegd 2 november 2026). Vragen vóór indiensttreding en burgerlijke staat of aantal kinderen. EEOC.
- Equal Employment Opportunity Commission (2026). Intrekking van de Uniforme richtlijnen voor personeelsselectieprocedures, RIN 3046-AB43. Unified Agenda, via de Wayback Machine (kopie van 19 oktober 2026).
- Equality and Human Rights Commission (z.d.). Wat de gelijkheidswet voor u als werkgever betekent: wanneer u iemand aanneemt om voor u te werken. EHRC.
- European Union (2024). AI-verordening, bijlage III: AI-systemen met hoog risico. AI Act Explorer.
- Huffcutt, A. I., & Arthur, W., Jr. (1994). Hunter en Hunter (1984) opnieuw bekeken: validiteit van sollicitatiegesprekken voor instapfuncties. Journal of Applied Psychology, 79(2), 184-190.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Betrouwbaarheid van sollicitatiegesprekken: nieuwe meta-analytische schattingen naar structuur en vorm. International Journal of Selection and Assessment, 21(3), 264-276.
- Information Commissioner's Office (z.d., geraadpleegd 2026). Kandidaten voorsorteren, testen en interviewen en Wervingsgegevens bewaren [Conceptrichtlijn, in herziening]. ICO.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021; paperback 2022). Ruis: een fout in het menselijk oordeel. Little, Brown Spark. Passage over de 3 principes geciteerd in leesmarkeringen van lezers, Goodreads.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanische versus klinische combinatie van gegevens bij selectie- en toelatingsbeslissingen: een meta-analyse. Journal of Applied Psychology, 98(6), 1060-1072.
- Legal Information Institute (geraadpleegd 2 november 2026). 42 USC 2000e-2, onwettige arbeidspraktijken. Cornell Law School.
- Legal Information Institute (geraadpleegd 2 november 2026). 29 CFR 1602.14, bewaring van gemaakte of bijgehouden gegevens, 29 CFR 1607.4, informatie over impact en 29 CFR 1607.16, definities. Cornell Law School.
- Levashina, J., Hartwell, C. J., Morgeson, F. P., & Campion, M. A. (2014). Het gestructureerde sollicitatiegesprek: narratief en kwantitatief overzicht van de onderzoeksliteratuur. Personnel Psychology, 67(1), 241-293.
- Ministry of Manpower, Singapore (2025, 8 januari). Aanneming van de Workplace Fairness Bill markeert de volgende stap in het bouwen van eerlijke en harmonieuze werkplekken. MOM.
- Ministry of Manpower, Singapore (2025, 4 november). Workplace Fairness (Dispute Resolution) Bill [Persbericht]. MOM.
- r/humanresources (2026, 26 juli). Interviewers vullen nooit scorekaarten in. Wat loste het uiteindelijk op voor jouw team? [Onlineforumbericht]. Reddit.
- Roch, S. G., Woehr, D. J., Mishra, V., & Kieszczynska, U. (2012). Beoordelaarstraining opnieuw bekeken: een bijgewerkte meta-analytische review van frame-of-reference-training. Journal of Occupational and Organizational Psychology, 85(2), 370-395.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Meta-analytische schattingen van validiteit in personeelsselectie opnieuw bekeken: systematische overcorrectie voor beperking van het bereik aanpakken. Journal of Applied Psychology, 107(11), 2040-2068.
- Tripartite Alliance for Fair and Progressive Employment Practices (2025, november). Handboek eerlijke werving en selectie. TAFEP.
- UK Parliament (2010). Equality Act 2010, artikel 39 en artikel 136. legislation.gov.uk, via de Wayback Machine.
- U.S. Department of Justice, Office of Legal Counsel (2026, 9 juni). Grondwettigheid van aansprakelijkheid wegens disparate impact onder Titel VII. DOJ.
- U.S. Office of Personnel Management (2026, 31 juli). Verwijdering van verwijzingen naar de Uniforme richtlijnen voor personeelsselectieprocedures in federale personeelsvoorschriften. Federal Register, 91 FR 48234.
- U.S. Office of Personnel Management (z.d.). Gestructureerde interviews. OPM.
- University of Washington (z.d.). Tips en richtlijnen voor het beoordelen van kandidaten. UW Human Resources.
- Yale University (z.d.). Kandidaten effectief beoordelen en een definitieve keuze maken (FL-HR-069). Yale Human Resources.