3 interviewers, 1 finalist, 3 oordelen. Zonder interview-scorecard beslist de luidste stem in je debrief wie er wordt aangenomen.
Er is geen kandidaatbeoordelingsformulier om op terug te vallen. Dus niemand kan het aanbod uitleggen aan je CEO, of aan een afgewezen kandidaat die ernaar vraagt.
Zonder gedeeld formulier vallen drukbezette mensen terug op buikgevoel.
En onderbuikgevoelens zijn zwakker dan ze aanvoelen, zoals Noise van Kahneman en zijn coauteurs laat zien.
Stel dat je alleen weet dat 1 kandidaat een beter gesprek had dan een ander. De kans dat diegene echt de betere aanwinst is, bedraagt slechts 56% tot 61%, nauwelijks beter dan een muntworp.
Een scorecard lost dit op in 3 stappen. Elke interviewer scoort dezelfde 4 tot 6 vaardigheden tegen geschreven voorbeelden, alleen, vóór de debrief. Dan beslist de totaalscore, tenzij een must-have niet wordt gehaald.
Belangrijkste punten
- Leidt een scorecard echt tot betere aanwervingen? Ja, als elke interviewer dezelfde vaardigheden scoort tegen geschreven voorbeelden. Interviews die zo verlopen, voorspelden de werkprestatie ongeveer twee keer zo goed als vrije gesprekken in een review uit 2022.
- Hoeveel vaardigheden moet hij scoren? 4 tot 6, elk op een schaal van 1 tot 5 met een geschreven voorbeeldantwoord per niveau. Elke must-have onder 3 betekent geen aanwerving.
- Hoe kies ik tussen 2 finalisten die gelijk staan? Controleer eerst de must-haves en bespreek daarna elke 2-tegen-5-verdeling op basis van bewijs. Stem niet opnieuw op gevoel: een vaste formule versloeg het oordeel van experts in een review uit 2013.
- Hoeveel interviewers heb ik nodig? Tot 4, elk met een eigen score. In Google's eigen data voegde elk interview na het 4e minder dan 1% nauwkeurigheid toe.
- Kan ik de AI-score vertrouwen? Gebruik hem als 1 input en lees de redenen. In een studie uit 2023 volgde een AI-beoordelaar getrainde menselijke beoordelaars nauwgezet bij bekende vragen en slecht bij nieuwe.
1. Helpt een interview-scorecard me echt om betere aanwervingen te kiezen?
Ja, wanneer elke interviewer dezelfde vaardigheden beoordeelt aan de hand van vastgelegde voorbeelden. Gestructureerde interviews, waarbij je iedereen op dezelfde manier bevraagt en beoordeelt, voorspelden 0,42 aan werkprestatie, meer dan het dubbele van de 0,19 van ongestructureerde interviews.
Die cijfers komen uit de fundamentele heranalyse uit 2022 van Sackett en collega's van decennia aan onderzoek naar werving.
De getallen zijn correlaties, van 0 (geen verband met latere werkprestatie) tot 1 (een perfect verband). Dus 0,19 betekent niet dat ongestructureerde interviews in 20% van de gevallen de juiste keuze maken. Het betekent dat hun verband met latere prestaties zwak is.
De onderstaande grafiek rangschikt 6 gangbare methoden. Kennisgerichte functietoetsen met 0,40 en gescoorde biodata, een beoordeelde vragenlijst over de achtergrond, met 0,38 volgen dicht daarop.
Werkproeftoetsen volgen met 0,33 en cognitieve vaardigheidstests met 0,31. Ongestructureerde interviews, het vrije gesprek waarmee de meesten van ons zijn opgegroeid, bungelen onderaan.
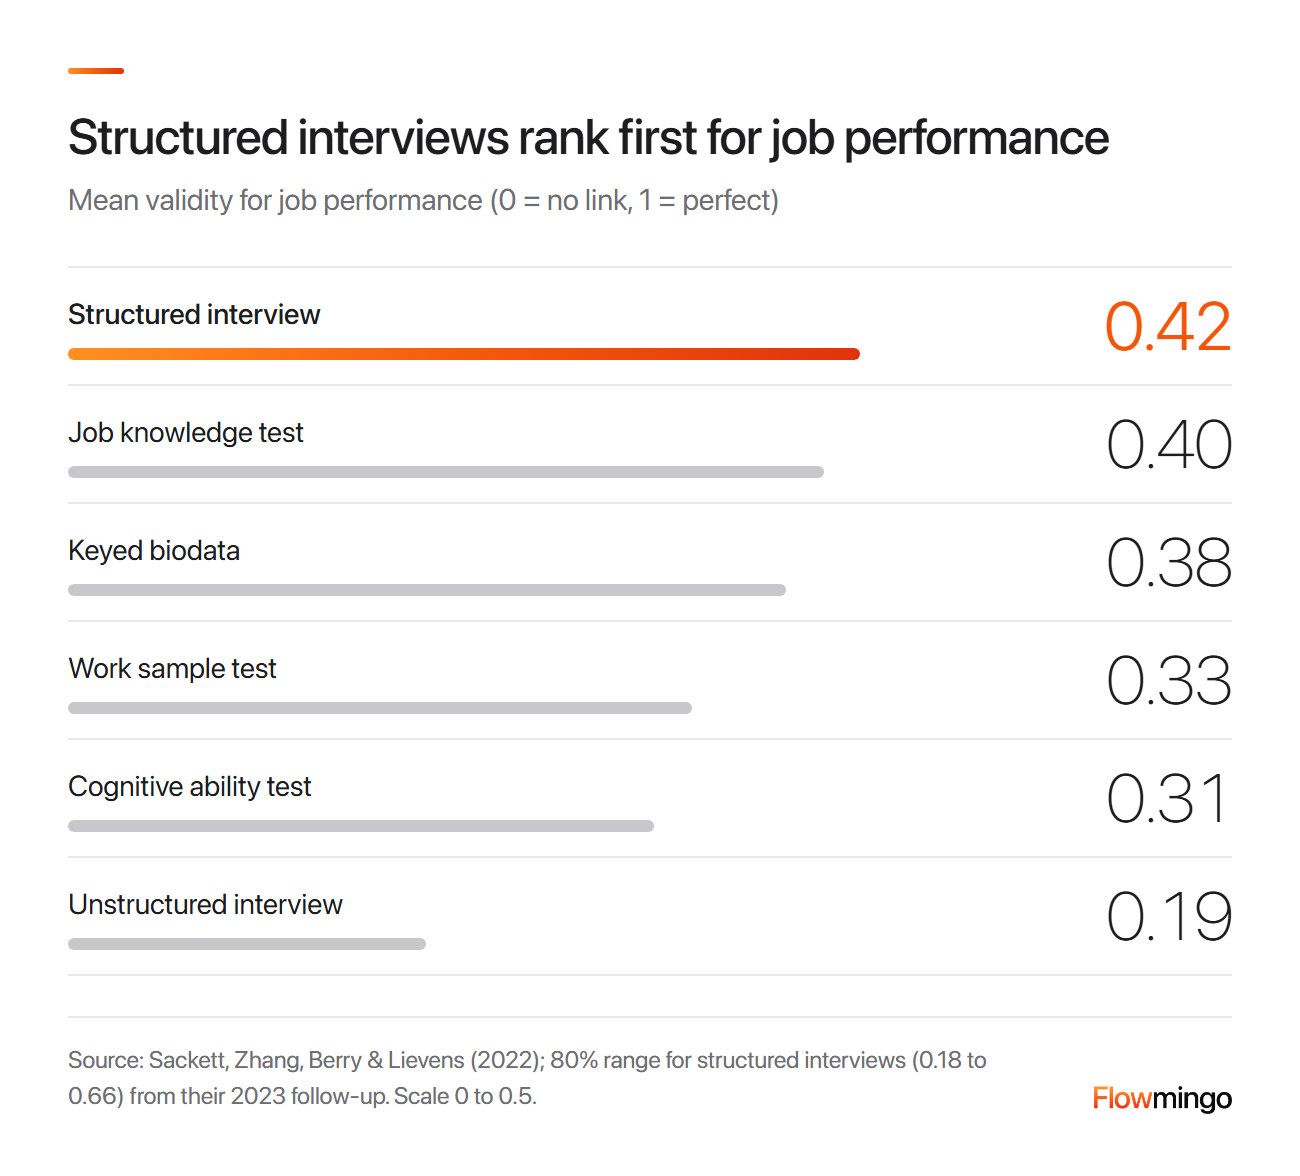
Wervingsmethoden gerangschikt naar verband met werkprestatie: gestructureerde interviews staan bovenaan met 0,42, ongestructureerde interviews onderaan met 0,19 (fundamentele heranalyse van Sackett et al.).
Maar 0,42 is een gemiddelde. Het vervolgonderzoek van de auteurs plaatst de meeste gestructureerde interviews tussen 0,18, niet beter dan een vrij gesprek, en 0,66, beter dan alles in de grafiek.
Het ontwerp is 1 van de 3 redenen die de auteurs voor die spreiding geven. Dat betekent dat een interviewscorekaart met vage vaardigheden het risico loopt onderaan te eindigen. Dit zijn gemiddelden over veel werkgevers, geen belofte voor je volgende aanwerving.
2. Wat moet mijn interviewscorekaart-sjabloon bevatten?
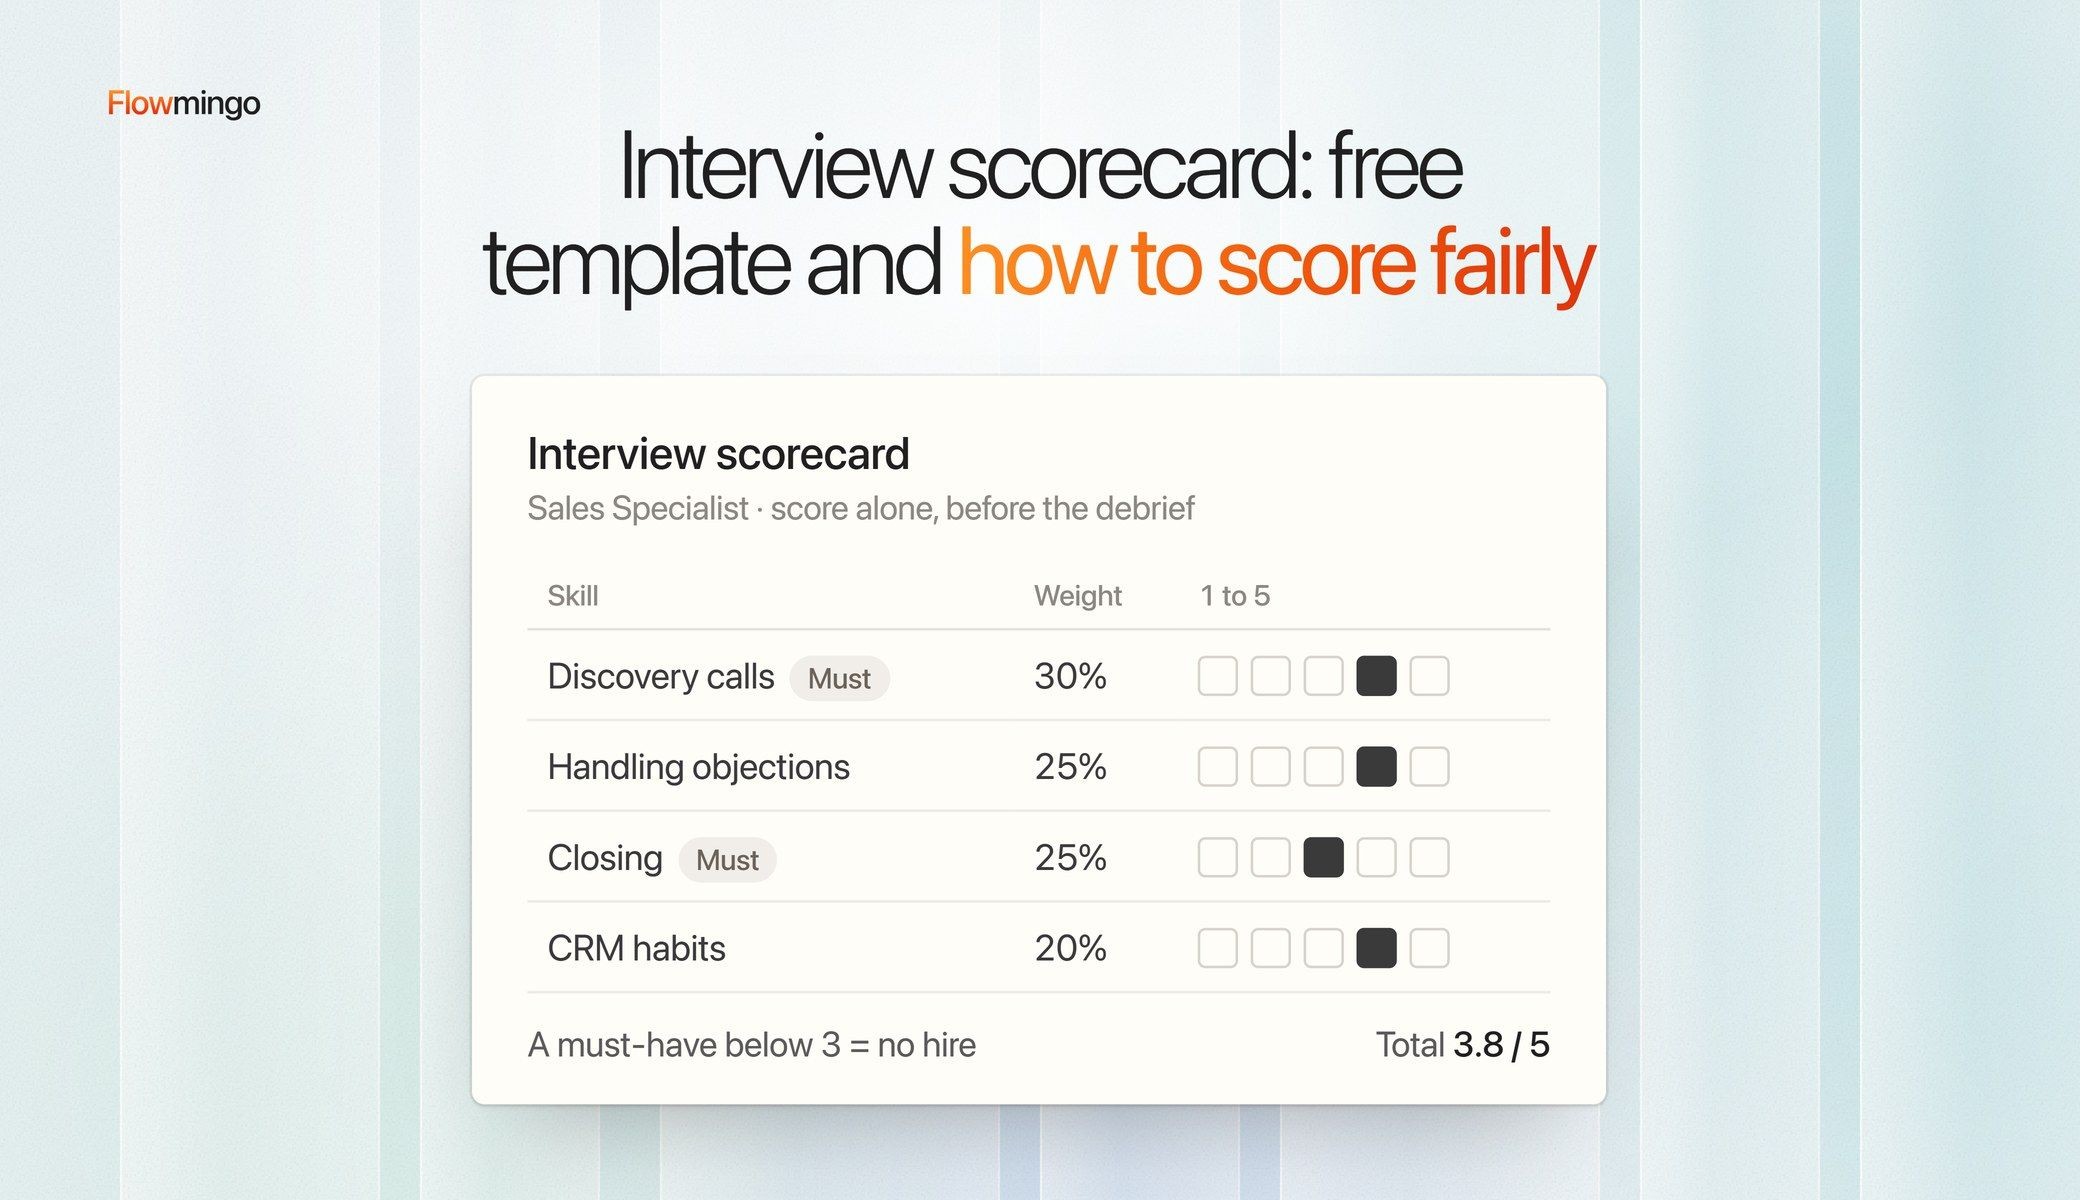
Een interviewscorekaart-sjabloon, of kandidaatevaluatieformulier, bevat 5 vaardigheden, vastgelegde ankers, een vak voor bewijs en een must-have-ondergrens, allemaal op 1 pagina. Het eindigt met een algemene indruk en een aanbeveling.
De ankers zorgen ervoor dat een 4 van de ene interviewer hetzelfde betekent als die van een andere, en het vak voor bewijs geeft antwoord op "waarom" wanneer je CEO ernaar vraagt.
De ondergrens voorkomt dat een sterk totaal een zwakke must-have verbergt. De algemene indruk komt als laatste, want een onderbuikgevoel dat je eerst opschrijft, kleurt elke vaardigheidsscore daarna.
Hier is dat formulier voor een teamleider klantenservice, met 2 must-haves. Elk van de 5 vaardigheden scoort 1 tot 5, dus het totaal is op 25.
Stel 2 vragen over eerder gedrag per vaardigheid, want een echt voorbeeld uit het verleden geeft je iets concreets om tegen de ankers te houden. Bijvoorbeeld: "Vertel me over de laatste keer dat een ontevreden klant bij jou escaleerde."
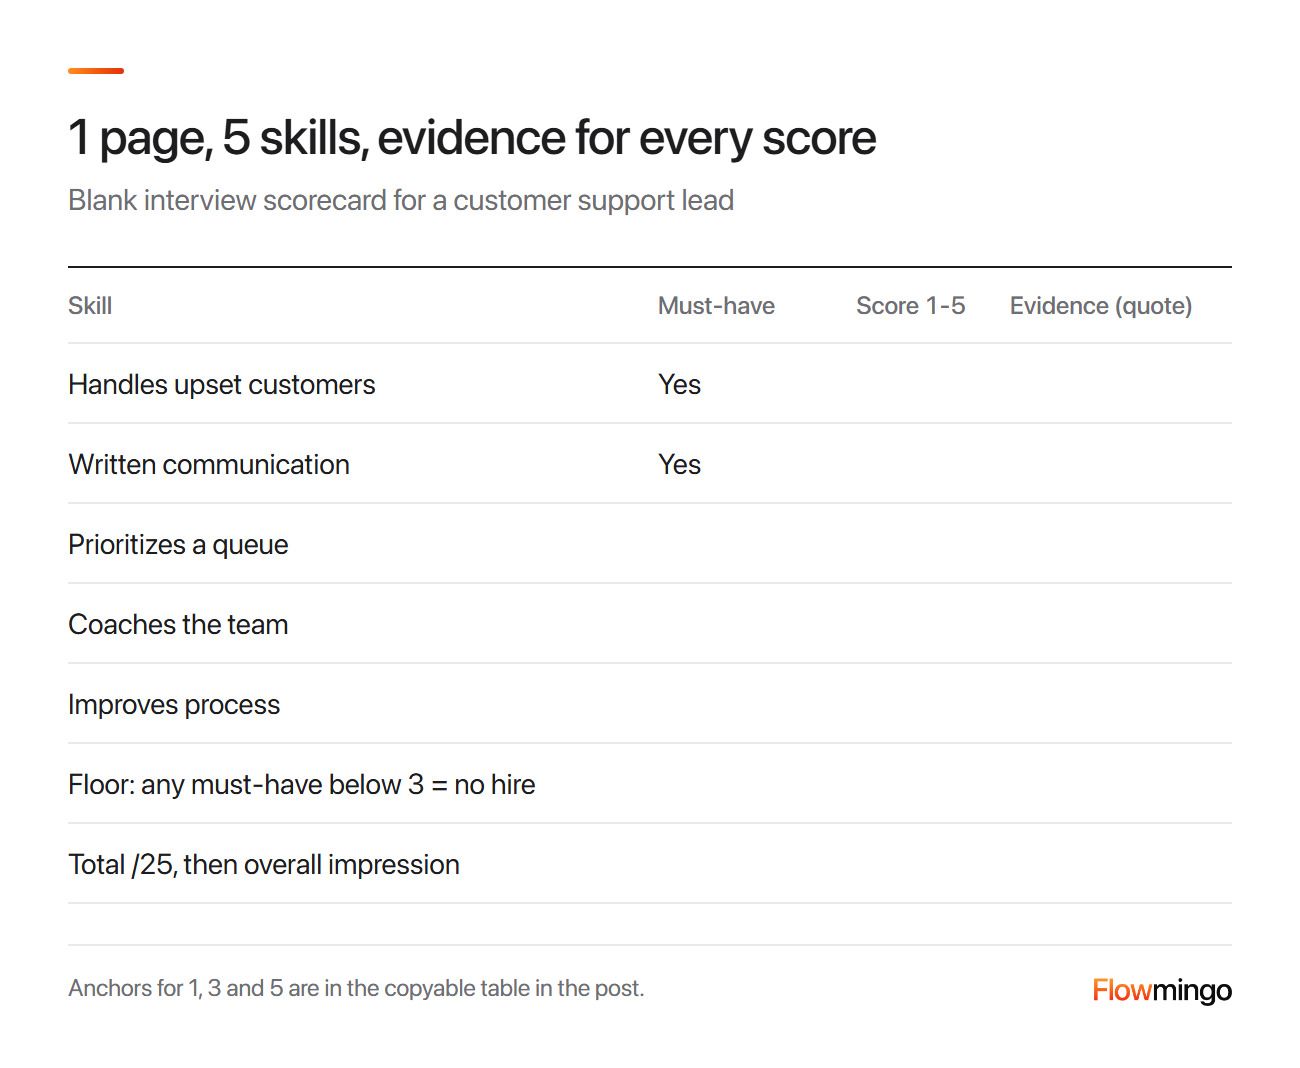
Leeg sjabloon voor een interviewscorekaart voor een teamleider klantenservice: 5 vaardigheden, 2 must-haves, een score van 1 tot 5 en per vaardigheid een bewijscitaat.
Kopieer de tabel en vervang de vaardigheden en ankers door je eigen versie.
| Vaardigheid | Ankers voor 1 / 3 / 5 | Score 1-5 | Bewijs (citaat) |
|---|---|---|---|
| Kop | Kandidaat, functie, interviewer, datum | ||
| Gaat goed om met ontevreden klanten (must-have) | Geeft de klant de schuld / past het beleid toe / pakt de oorzaak aan | ||
| Schrijfvaardigheid (must-have) | Onduidelijk / duidelijk maar lang / kort en duidelijk | ||
| Prioriteert een wachtrij | Geen methode / op urgentie / op impact | ||
| Coacht het team | Geen voorbeeld / geeft tips / stelt een plan op | ||
| Verbeterde processen | Geen voorbeeld / stelt een oplossing voor / levert een oplossing op | ||
| Ondergrens must-haves | Elke must-have onder 3 betekent geen aanname | ||
| Niet gescoord | Emoties afgelezen van gezicht, stem of typgedrag; accent of tempo tenzij de functie dat vereist; "culture fit" | ||
| Totaal | Som van 5 scores, op 25 | ||
| Algemene indruk | 1 tot 5, als laatste ingevuld | ||
| Aanbeveling | Sterk aannemen / aannemen / niet aannemen / sterk niet aannemen; een afwijking vereist een schriftelijke reden |
2.1 Wat moet ik beslissen voordat ik het bouw?
Definieer eerst succes in de functie en kies daarna de vaardigheden die dat opleveren. Zet de interviewscorekaart vast voordat het eerste cv binnenkomt.
Die volgorde komt uit Who, van Geoff Smart en Randy Street. Schrijf 1 missieregel, dan 3 tot 8 resultaten gerangschikt naar belang, en dan 4 tot 6 vaardigheden. Een resultaat is een meetbaar gegeven, zoals omzet laten groeien van $25 miljoen naar $50 miljoen in jaar 3, niet een activiteit.
Vastzetten is belangrijk omdat mensen criteria aanpassen zonder het te merken. In de baanbrekende studies van Uhlmann en Cohen (2005) beoordeelden deelnemers een straatwijze en een hoogopgeleide sollicitant voor de functie van politiechef.
Welke sterkte de man ook had, ze vonden dat de functie die sterker nodig had, en de vrouw kreeg zo'n voordeel niet. Door de criteria vast te leggen voordat ze de sollicitanten zagen, verdween die bias. Een scorekaart die je opstelt nadat je kandidaten hebt ontmoet, kan dus stilletjes buigen naar degene die je toch al aardig vindt.
2.2 Moet culture fit op de scorekaart staan?
Niet zoals het er staat, want niemand kan het twee keer op dezelfde manier scoren. Maak er 1 of 2 waarneembare gedragingen van, zoals "vraagt om feedback op eigen werk".
Stel dat je team openheid belangrijk vindt: scoor dan "gaf een concreet voorbeeld van het vroeg melden van een fout".
3. Hoe weeg ik interview scores zodat de must-haves het zwaarst tellen?
Geef elke vaardigheid gelijk gewicht en voeg een must-have-ondergrens toe, of leg de gewichten vast vóór het eerste interview. Gelijke gewichten voorspellen nieuwe gevallen vaak net zo goed als gewichten die op eerdere data zijn afgestemd.
Dat tweede punt komt van de psycholoog Robyn Dawes, zoals Kahneman het samenvat in Thinking, Fast and Slow.
Gewichten die zijn afgestemd op je eerdere aannames leren ook de toevalligheden van die groep. Stel dat je 3 beste support-aannames toevallig allemaal sterke coaches waren: een afgestemd gewicht zou coaching bij elke toekomstige kandidaat bevoordelen.
Gelijke gewichten kunnen zo'n toevalligheid niet najagen, en daarom voorspellen ze nieuwe kandidaten vaak net zo goed. Houd de vaardigheden ook onafhankelijk, zoals Kahneman adviseert: zet niet zowel "communicatie" als "presentatievaardigheden" op de lijst, want samen tellen ze hetzelfde twee keer.
Een must-have ontleent zijn kracht aan de ondergrens, niet aan een groter gewicht. Stel dat "Gaat goed om met boze klanten" een 2 scoort en elke andere vaardigheid een 5.
De totaalscore van 22 op 25 ziet er goed uit, maar de ondergrens zegt nog steeds: niet aannemen. Dat is precies wat je wilt voor een vaardigheid waar de functie niet zonder kan.
Als je toch weegt, schrijf de gewichten dan vooraf op de interview scorekaart en pas ze op iedereen toe. Zo sluit je de makkelijkste manier af om een totaal te buigen: gewichten aanpassen nadat je iemand hebt ontmoet die je aardig vindt.
Hoe Flowmingo helpt
Het AI-interviewrapport van Flowmingo gebruikt vaste gewichten: een Must Have-criterium telt 4 keer zo zwaar als een Good to Have-criterium in de totaalscore. Elk criterium houdt zijn eigen score van 0 tot 10, zodat je zelf nog steeds een must-have-ondergrens kunt toepassen.
4. Hoe zorg ik ervoor dat een 3 voor elke interviewer hetzelfde betekent?
Schrijf vóór het eerste interview op wat een antwoord van een 1, een 3 en een 5 bevat voor elke vaardigheid. Zo'n gedragsmatig verankerde beoordelingsschaal maakt de scores van 2 interviewers vergelijkbaar.
"Gedragsmatig verankerd" betekent simpelweg dat elke score gekoppeld is aan wat de kandidaat deed, niet aan een gevoel als "best goed". Zonder ankers betekent een 3 op hetzelfde interviewscoreformulier voor de ene interviewer "prima" en voor de andere "zwak".
Verankerde interviews vertonen ook een sterker gemiddeld verband met latere prestaties. De fundamentele review van Taylor en Small van 19 studies naar interviews over eerdere gedragingen vond een verband van .35 met verankerde schalen, tegen .26 zonder. De studies verschilden ook op andere punten, dus deze vergelijking isoleert het effect van het toevoegen van ankers niet.
Hier is de interviewbeoordelingsschaal voor de must-have "Gaat om met boze klanten".
| Score | Wat het antwoord bevat |
|---|---|
| 1 | Geeft de klant de schuld; geen eigen actie en geen resultaat |
| 3 | Een echt voorbeeld: kalmeert de klant en past het beleid toe, maar controleert het resultaat nooit |
| 5 | Een echt voorbeeld: vindt de oorzaak, lost het op, volgt na en deelt de oplossing |
Elke stap hoger is iets wat je in het antwoord kunt horen. Daarom kunnen 2 luisteraars op hetzelfde cijfer uitkomen.
Kun je nog geen ankers schrijven, leen dan de 5 niveaus uit de structured interview guide van OPM, het Amerikaanse federale HR-agentschap. Elk niveau draait om hoe moeilijk de situatie was en hoeveel begeleiding de persoon nodig had.
- 1, Bewustzijn: de eenvoudigste situaties, met nauwe en uitgebreide begeleiding.
- 2, Basis: enigszins moeilijke situaties, met frequente begeleiding.
- 3, Gevorderd: moeilijke situaties, met af en toe begeleiding.
- 4, Vergevorderd: behoorlijk moeilijke situaties, met weinig of geen begeleiding.
- 5, Expert: uitzonderlijk moeilijke situaties, waarin de persoon anderen adviseert.
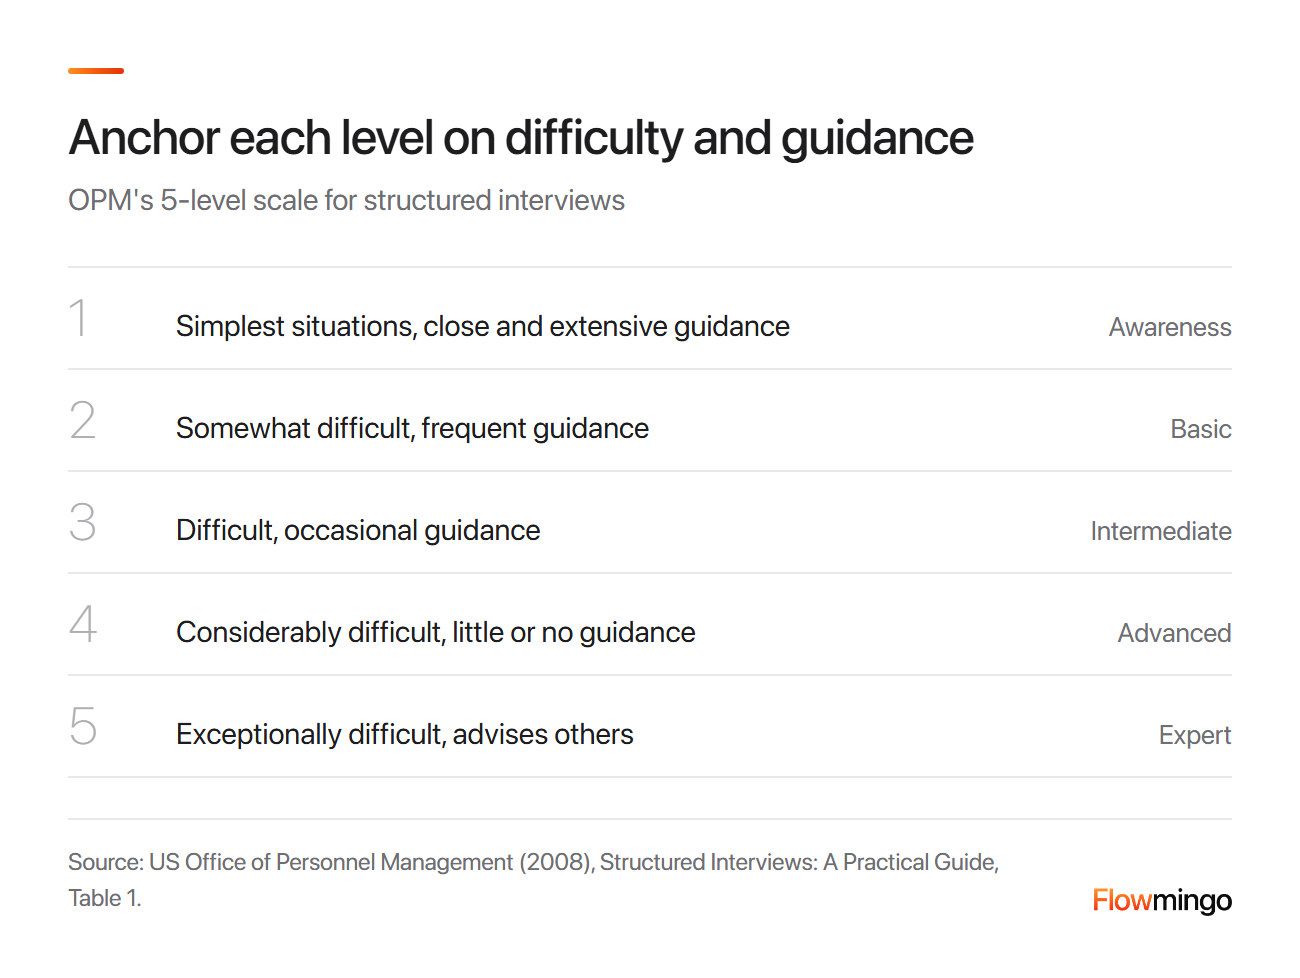
OPM's 5 beoordelingsniveaus voor gestructureerde interviews: van Bewustzijn (eenvoudigste situaties, nauwe begeleiding) tot Expert (uitzonderlijk moeilijke situaties, adviseert anderen).
5. Hoe kies ik tussen 2 sterke finalisten als mijn interviewers het oneens zijn?
Laat het totaal van de interview-scorecard beslissen, met 2 uitzonderingen: een must-have onder 3, of een 2-tegen-5-splitsing, waarover je op basis van bewijs debrieft. Stem niet opnieuw op gevoel.
Dit is het moment waarvoor scorecards bestaan, en het moment waarop je ze het snelst wilt laten vallen. Hier is een illustratief voorbeeld, geen klantdata: 3 finalisten voor de rol van support lead, elke cel gemiddeld over 3 interviewers.
| Vaardigheid | A | B | C |
|---|---|---|---|
| Gaat om met boze klanten (must-have) | 4 | 2 | 4 |
| Schriftelijke communicatie (must-have) | 4 | 4 | 3 |
| Prioriteert een wachtrij | 3 | 4 | 3 |
| Coacht het team | 3 | 4 | 4 (scores 2, 5, 5) |
| Verbeteren van processen | 4 | 4 | 3 |
| Totaal, van 25 | 18 | 18 | 17 |
| Beslissing | Aannemen | Niet aannemen: ondergrens geraakt | Debrief de splitsing |
Lees de interview-scorecard rij voor rij. A en B staan gelijk met 18 van de 25. Maar B scoorde een 2 op een must-have, dus de ondergrens wordt geraakt en B is een no hire.
C komt uit op 17, maar C's gemiddelde van 4 op "Coacht het team" verbergt een splitsing: 1 interviewer gaf een 2 en de andere 2 gaven een 5. Dat verschil wordt het enige agendapunt van de debrief.
Vraag in de praktijk beide kanten hun bewijscitaten voor te lezen. Stel dat de lage scoorder hoorde over een teamlid dat opstapte, en de anderen over een coachingplan dat werkte. De debrief bepaalt welk verhaal meer typerend is voor C, en iedereen die bewijs had gemist, past de score schriftelijk aan.
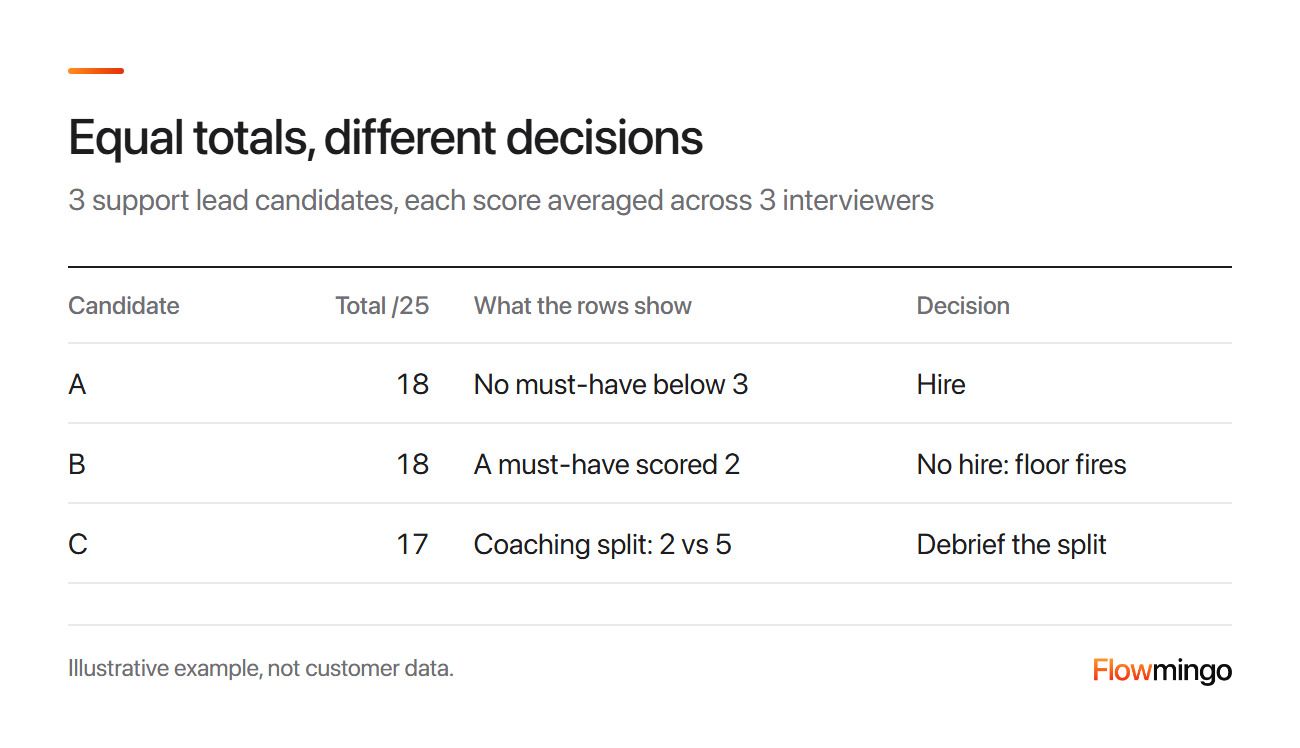
Ingevulde interview-scorecard, illustratief: A en B staan gelijk op 18 van de 25, B mist een must-have, en bij C moet een splitsing in coaching worden gedebriefd.
Zodra de scores een finalist kiezen, schrijf je de voorwaarden in de aanbieding voordat je die verstuurt: onze template voor een aanbiedingsbrief laat zien waar elke controle hoort.
5.1 Wat als mijn onderbuik iets anders zegt dan de scores?
Volg de scores, tenzij je het bewijs dat ze hebben gemist op papier kunt zetten. In de fundamentele meta-analyse van Kuncel en collega's uit 2013 voorspelde een formule die op iedereen hetzelfde werd toegepast de werkprestatie met 0,44, tegenover 0,28 voor holistisch oordeel. De auteurs noemen dat een verbetering in voorspelling van meer dan 50%, zelfs ten opzichte van experts die de functie kenden.
Holistisch oordeel betekent dat mensen dezelfde feiten in hun hoofd afwegen, inclusief consensusvergaderingen. De debrief vult dus bewijslacunes op, en stemt niet opnieuw.
5.2 Moet ik finalisten naast elkaar vergelijken?
Ja, antwoord voor antwoord. Bohnets HBR-advies is om alle antwoorden op vraag 1 te vergelijken, dan op vraag 2, zodat je elk antwoord afzet tegen de andere.
In een fundamentele labstudie uit 2016 neigden mensen aan wie één kandidaat tegelijk werd getoond naar het geslacht dat het stereotype van de taak bevoordeelde. Eerdere prestaties maakten nauwelijks uit. Bij twee kandidaten naast elkaar kozen ze 54% van de tijd de best presterende en 8% de slechter presterende.
De studie gebruikte eerdere taakscores, geen sollicitatiegesprekken, dus zie het als een sterke aanwijzing, niet als bewijs.
6. Hoe voorkom ik dat de luidste interviewer de debrief wint?
Laat elke interviewer het scoreformulier van het gesprek invullen voordat iemand iets zegt, en open de debrief met de scores.
Stel dat een senior iemand begint met "ik vond haar geweldig", dan begint de zaal die kant op te drijven. Scores die iemand alleen invult, beschermen iedereen tegen die aantrekkingskracht. Daarom maakt Noise van onafhankelijk scoren een wervingsregel.
Verzamel in de praktijk de scores in een gedeeld spreadsheet of je applicant tracking system en onthul ze allemaal tegelijk.
Een panel waarbij iedereen hetzelfde gesprek ziet, lijkt een oplossing. In de fundamentele meta-analyse van Huffcutt en collega's uit 2013 waren panelleden het onderling eens met 0,74, tegen 0,44 bij aparte gesprekken, op een schaal van 0 tot 1.
Dat cijfer vleit panels. Panelleden beoordelen allemaal dezelfde prestatie op dezelfde dag, dus als de kandidaat een uitzonderlijk goede of slechte ochtend had, zien ze dat allemaal.
Zoals Iris Bohnet het zei in een lezing bij Google: "de steekproefomvang van een panelgesprek is in feite één". Aparte gesprekken, elk afzonderlijk gescoord, geven je meer onafhankelijke blikken.
6.1 Hoeveel interviewers moeten elke kandidaat scoren?
Maximaal 4, in afzonderlijke gesprekken. In de interne data van Google, geen peer-reviewed onderzoek, voorspelden 4 gesprekken de aannamebeslissing met 86% zekerheid. Elk extra gesprek voegde minder dan 1% toe.
Extra gesprekken voegden weinig toe aan het voorspellen van Googles eigen aannamebeslissing. Gebruik dat als aanknopingspunt om elke ronde te rechtvaardigen, niet als een universeel maximum of als bewijs over latere werkprestaties.
7. Hoe krijg ik het voor elkaar dat drukke interviewers de interviewscorekaart daadwerkelijk invullen?
Maak scoren onderdeel van het gesprek. Scoor elke vaardigheid direct na de bijbehorende vragen, schrijf een quote van 1 regel als bewijs op en geef de algehele indruk als laatste.
Niemand wil na een dag interviewen nog een formulier invullen. Daarom wordt er tijdens het gesprek gescoord, niet als huiswerk voor vanavond.
Kahneman bouwde deze methode in 1955 voor het Israëlische leger, nadat vrije gesprekken bijna nutteloos bleken om succes te voorspellen. Interviewers scoorden 6 eigenschappen op een schaal van 1 tot 5 en rondden elke eigenschap af voordat ze aan de volgende begonnen, zodat een eerste indruk de rest niet kon kleuren.
Pas daarna deden ze hun ogen dicht en gaven ze een totaalscore, en dat totaal voorspelde veel nauwkeuriger dan voorheen. Zijn advies: neem de hoogste totaalscore aan, "zelfs als er nog iemand anders is die je leuker vindt".
Timing is ook belangrijk. In een veldstudie gaven 166 interviewers aan wanneer ze hun beslissing namen. Slechts 4,9% van de beslissingen viel in de eerste minuut, maar 22,5% kwam pas nadat het gesprek was afgelopen.
Een beslissing die na het vertrek van de kandidaat wordt genomen, berust op het geheugen, dus scoor gaandeweg.
Voor onze supportlead ziet dat er zo uit:
- Stel de 2 vragen over de wachtrij en scoor daarna "Prioriteert een wachtrij" voordat je verdergaat.
- Schrijf 1 quote als bewijs op, zoals "Ik sorteer bugs op hoeveel klanten ze raken."
- Houd dezelfde volgorde van vaardigheden aan voor elke kandidaat.
Schriftelijk bewijs is zeldzaam in onze data.
Flowmingo-gegevens · 86.638 door AI geïnterviewde kandidaten · 2.574 bedrijven · jul 2025 tot sep 2026
- 0,3% van de door AI geïnterviewde kandidaten kreeg een schriftelijke opmerking van het hiringteam (258 van 86.638).
Teams bewaren notities mogelijk elders; binnen Flowmingo is het AI-rapport meestal de enige schriftelijke beoordeling in het dossier.
Een schriftelijke onderbouwing is het eerste dat sneuvelt op een drukke dag. Daarom vraagt het formulier om slechts 1 citaat per vaardigheid.
8. Kan ik een AI-score op mijn interviewscorecard vertrouwen?
Gebruik hem als 1 input die een mens beoordeelt, en lees eerst de onderbouwing. AI-scoring kan scherp dalen bij vragen waarvoor hij niet is getraind.
Wij hebben belang bij dit antwoord, dus het bewijs hieronder bevat ook het deel dat AI niet vleit.
In een fundamenteel onderzoek uit 2023 scoorden 2 getrainde beoordelaars 7.017 antwoorden van sollicitanten op een ankerschaal van 1 tot 5. Een model dat op dezelfde vragen was getraind, kwam dicht bij hun scores, met 0,75 op een schaal van 0 tot 1. Bij vraagformats die het nooit had gezien, zakte het naar 0,30, een zwakke overeenkomst.
Dit betekent dat een AI-score alleen zo goed is als het vraagspecifieke rubric, dus lees de onderbouwing voordat je het getal vertrouwt. Merk ook op dat 3 van de 5 auteurs van dat onderzoek bij AI-interviewleverancier Modern Hire werkten.
Hoe Flowmingo helpt
Flowmingo's AI Interviewer scoort op criteria die jij goedkeurt. AI stelt de vragen en criteria op basis van je vacaturetekst op, en jij bewerkt beide. Je stuurt elke sollicitant het interview om op een moment naar keuze te doen.
Je krijgt de opname, het transcript en elk criterium terug, gescoord van 0 tot 10 met een schriftelijke onderbouwing. De hiringbeslissing neem jij.
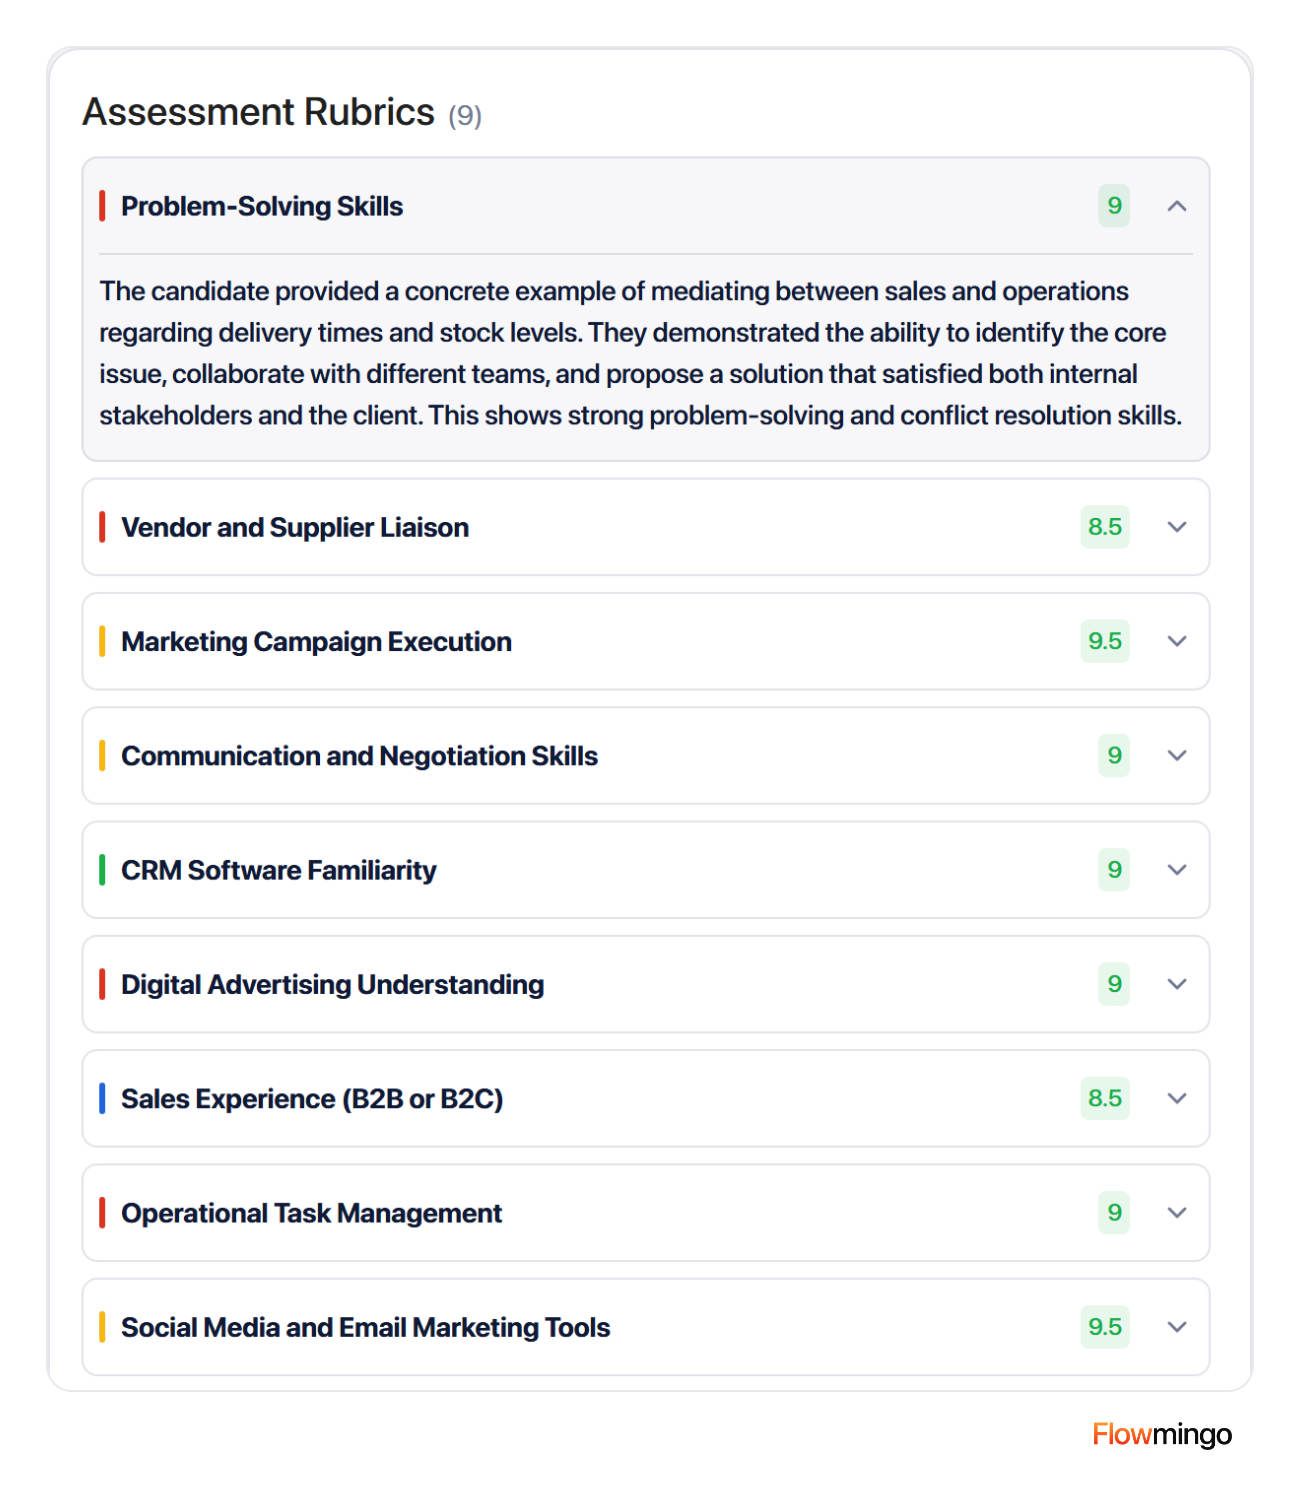
Flowmingo's openbare voorbeeldrapport: een score van 0 tot 10 en een onderbouwing per criterium, zodat je op die schaal een ondergrens kunt instellen voor must-haves.
In onze gegevens zijn het cv en het interview het ook oneens over wie de beste is.
Flowmingo-gegevens · 34.114 kandidaten · 379 bedrijven · jul 2025 tot sep 2026
- 19,2% van de 532 projecten met 1 duidelijke hoogste interviewscores gaf die kandidaat ook de hoogste cv-score.
- 54,9% van de 3.684 kandidaten die 8 of meer scoorden in het interview (2.022) zou zijn afgevallen door een cv-shortlist van de top 20%.
Beide zijn Flowmingo AI-scores, geen werkprestaties, en geïnterviewden zijn een geselecteerde groep. De gegevens laten zien dat de 2 rangordes verschillen, niet welke de juiste is.
Simpel gezegd: bij ongeveer 4 op de 5 van die projecten had de kandidaat met de hoogste interviewscores niet ook de hoogste CV-score. Beoordeel het gesprek dus op zichzelf en laat de CV-score niet doorwerken.
9. Beschermen mijn scorecards mij als een afgewezen kandidaat klaagt?
Ze helpen, mits ze functiegerelateerd bewijs scoren en je ze bewaart. Volgens een redelijke lezing van de Amerikaanse federale regels bewaar je scorecards minstens 1 jaar, en volgens de regels van Californië 4 jaar.
Een klacht kan maanden later binnenkomen, als niemand het gesprek nog herinnert. Een interview-scorecard met een citaat per vaardigheid laat zien wat je hebt beoordeeld en waarom.
De Amerikaanse regel noemt scorecards niet bij naam, maar omvat wel "other records having to do with hiring". Zodra iemand een discriminatieklacht indient, bewaar je elk relevant dossier tot de zaak is afgerond. Dat omvat ook de dossiers van andere kandidaten voor dezelfde functie, dus 1 klacht bevriest de hele set.
Deze regels gelden per september 2026. Dit is een samenvatting, geen juridisch advies.
| Regel | Waar | Wat het betekent voor je scorecard |
|---|---|---|
| 29 CFR 1602.14 | VS | Bewaar wervingsdossiers 1 jaar, langer na een klacht |
| 2 CCR 11013(c) | Californië | Bewaar dossiers 4 jaar, inclusief gegevens over geautomatiseerde beslissingen |
| ICO-richtlijnen | VK | Kandidaten kunnen interviewaantekeningen opvragen; maak een eventuele tiebreak-regel bekend |
| TAFEP | Singapore | Gebruik een evaluatieformulier en bewaar dossiers minstens 1 jaar |
| 29 CFR 1630.11 (ADA) | VS | Als een beperking de spraak beïnvloedt, beoordeel de vaardigheid, niet de spraak, tenzij spreken juist vereist is voor de functie |
| AI-verordening, artikel 5(1)(f) | EU, sinds 2 feb 2025 | Geen AI die emoties van kandidaten afleidt uit gezicht, houding of toetsaanslagen |
| AI-verordening, bijlage III en artikel 26 | EU, vanaf 2 dec 2027 | Hoog risico: menselijk toezicht, logs 6+ maanden bewaren, kandidaten informeren |
| Local Law 144 | New York City | Een AI-score die alleen wordt gebruikt, zwaarder weegt dan al het andere of mensen overrulet: jaarlijkse audit op vooroordelen en melding |
| AI Video Interview Act | Illinois | Eerst melding, uitleg en toestemming; verwijder video's binnen 30 dagen na een verzoek |
Daarom heeft de template een rij "Niet gescoord". De EU verbiedt AI die emoties van kandidaten afleidt uit gezicht, houding of toetsaanslagen, en de Amerikaanse gehandicaptenwet (ADA) beschermt kandidaten van wie de beperking de spraak beïnvloedt. In het VK kunnen kandidaten je aantekeningen opvragen, dus schrijf elke bewijsregel alsof zij die gaan lezen.
Vergelijk voor een zelfaudit de slagingspercentages per groep met de vuistregel van 4/5 uit de Uniform Guidelines. Stel dat 30% van de ene groep slaagt en 50% van een andere: 30 gedeeld door 50 is 0,6, onder 0,8, dus kijk je nader.
Een advies van het Amerikaanse ministerie van Justitie uit juni 2026 en een OPM-regel uit juli 2026 bewegen federale agentschappen weg van de Guidelines. Ze blijven echter in de federale regelgeving staan, dus zie de check als een goedkope gewoonte, niet als een juridische grens.
10. Hoe voer ik deze week een interview-scorecard in met mijn team?
Bouw hem in deze volgorde en wijzig hem alleen tussen functies. Een eerste versie hoeft niet perfect te zijn, maar moet wel voor elke kandidaat hetzelfde zijn.
- Schrijf 1 missiezin en 3 tot 8 gerangschikte uitkomsten.
- Zet ze om in 5 vaardigheden en markeer de must-haves.
- Schrijf 2 vragen over eerder gedrag en ankers voor 1, 3 en 5 per vaardigheid.
- Laat maximaal 4 interviewers afzonderlijk scoren en indienen vóór de debrief.
- Laat het totaal beslissen, maar een must-have onder 3 betekent geen aanname. Schrijf elke override op.
Begin in de praktijk met 1 openstaande functie, zodat je team de gewoonte leert op iets echts. Laat iedereen vóór het eerste interview hetzelfde voorbeeldantwoord scoren en vergelijk.
Als 2 scores meer dan 1 punt uit elkaar liggen, herschrijf je het anker tot ze het eens zijn. De getrainde beoordelaars in het onderzoek uit sectie 8 gebruikten dezelfde kloof van 1 punt om een overleg te beleggen.
Verwacht enige weerstand. De legerinterviewers van Kahneman verzetten zich er ook tegen om alleen antwoorden vast te leggen, en zijn oplossing was de beoordeling met gesloten ogen, die hun oordeel een plek op het formulier gaf. Jouw regel voor de algehele indruk doet dat voor je team.
Hoe Flowmingo helpt
Om elke sollicitant een gestructureerd interview te sturen dat ze op hun eigen moment doen, opgenomen en gescoord tegen 1 interviewscorecard, probeer Flowmingo.
11. Bronnen
Elk extern cijfer hierboven komt uit de onderstaande bronnen, in volgorde van verschijning. De eigen cijfers van Flowmingo staan in de databoxen, jul 2025 tot sep 2026.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.