3 intervistatori, 1 finalista, 3 verdetti. Senza una scheda di valutazione del colloquio, la voce più forte nel tuo debriefing sceglie chi assumere.
Non c'è un modulo di valutazione dei candidati a cui fare riferimento. Così nessuno può spiegare l'offerta al tuo CEO, o a un candidato respinto che lo chiede.
Senza un modulo condiviso, le persone impegnate si affidano all'istinto.
E le decisioni istintive sono più deboli di quanto sembrino, come mostra Noise di Kahneman e dei suoi coautori.
Supponi di sapere solo che 1 candidato ha sostenuto il colloquio meglio di un altro. La probabilità che sia davvero l'assunzione migliore è solo del 56% al 61%, appena meglio di un lancio di monetina.
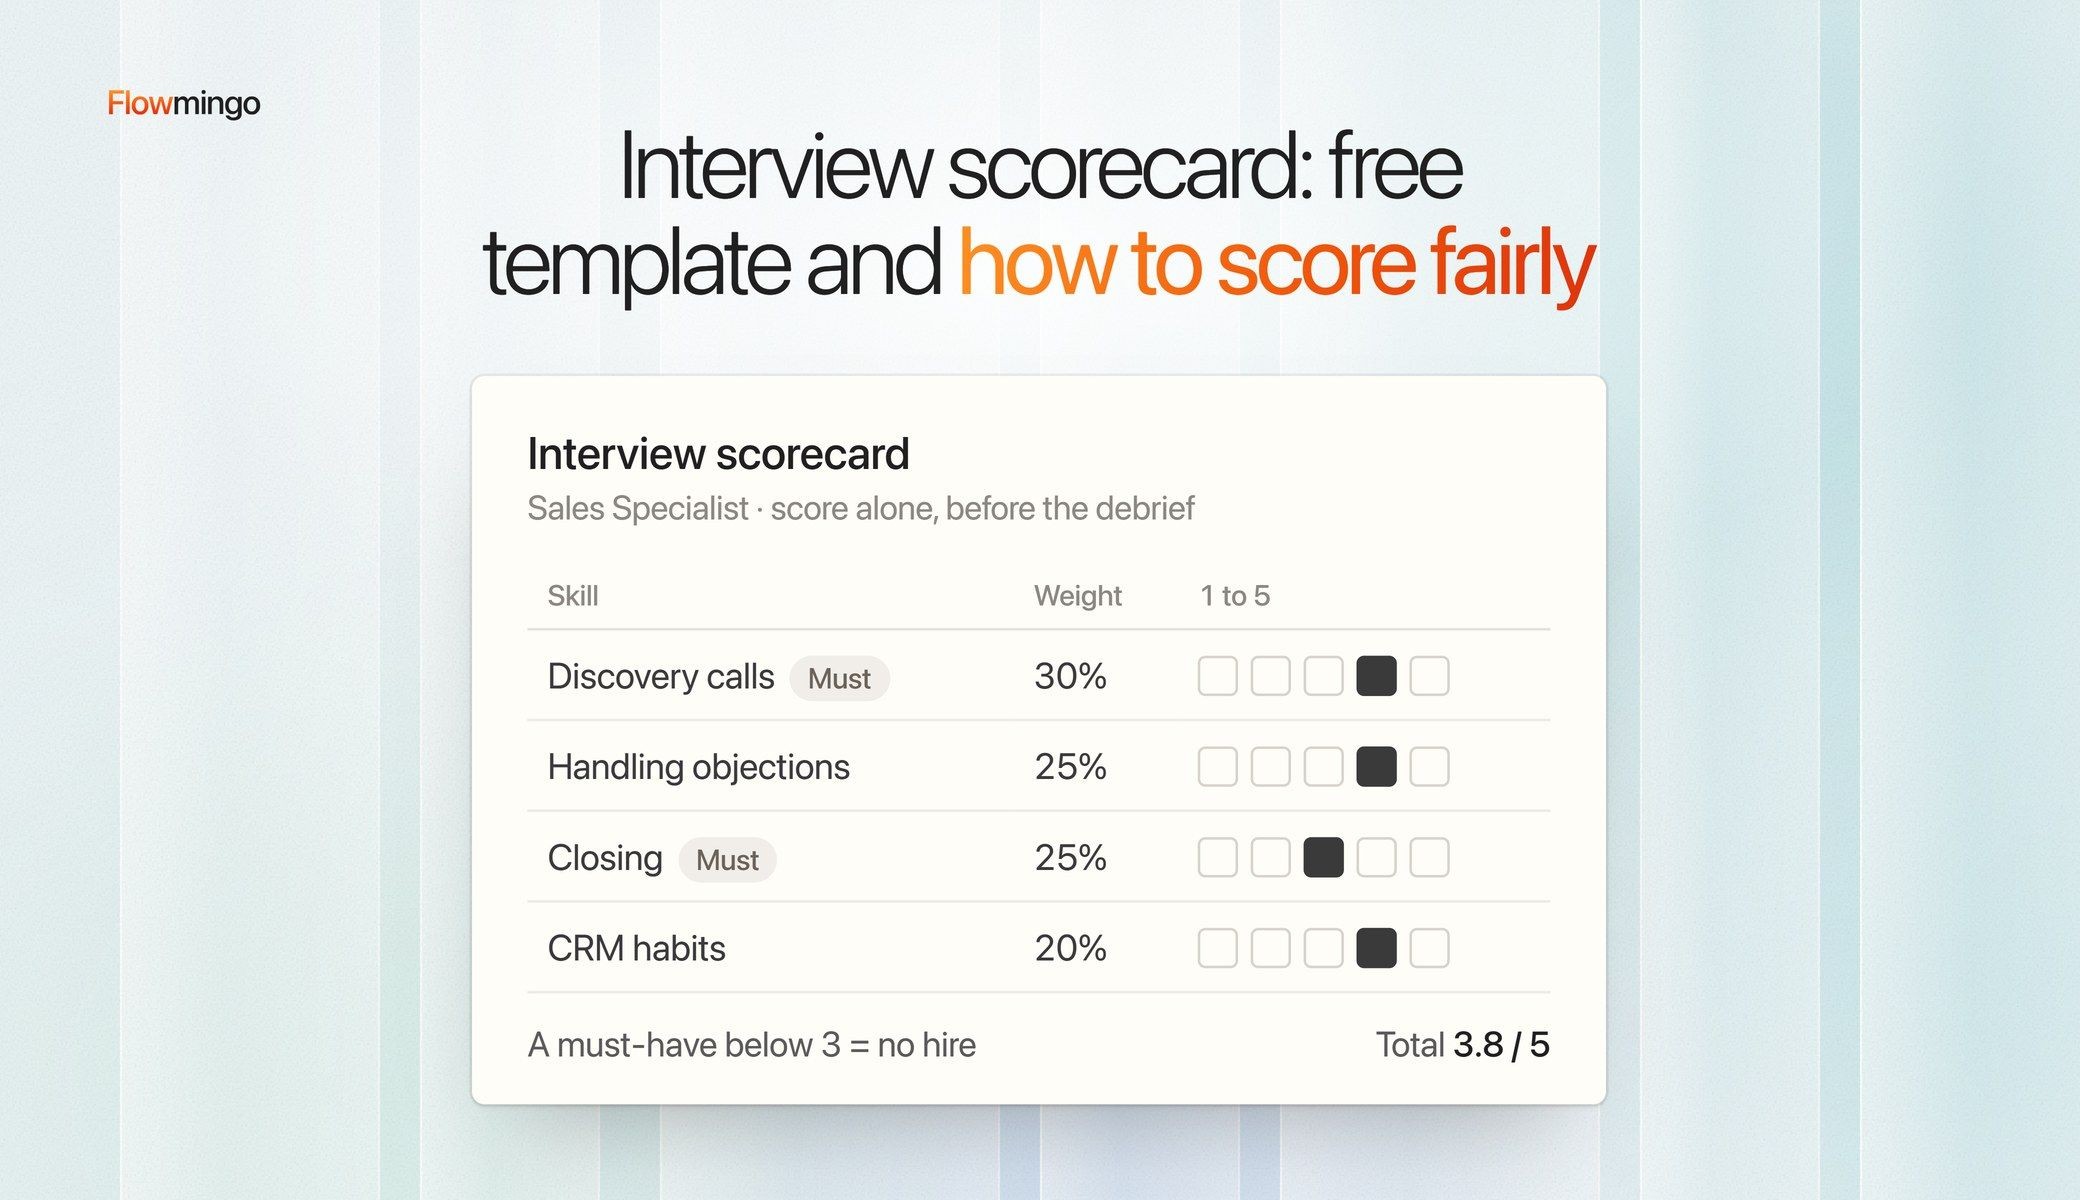
Una scheda di valutazione risolve questo problema in 3 mosse. Ogni intervistatore valuta le stesse 4-6 competenze rispetto a esempi scritti, da solo, prima del debriefing. Poi decide il totale, a meno che un requisito indispensabile non venga meno.
Punti chiave
- Una scheda di valutazione porta davvero ad assunzioni migliori? Sì, se ogni intervistatore valuta le stesse competenze rispetto a esempi scritti. I colloqui condotti in questo modo hanno previsto la performance lavorativa circa il doppio rispetto a quelli liberi in una revisione del 2022.
- Quante competenze dovrebbe valutare? Da 4 a 6, ciascuna su una scala da 1 a 5 con una risposta di esempio scritta per ogni livello. Qualsiasi requisito indispensabile sotto 3 significa nessuna assunzione.
- Come scelgo tra 2 finalisti in pareggio? Controlla prima i requisiti indispensabili, poi discuti in debriefing qualsiasi divisione 2 contro 5 sulle prove. Non rivotare sull'istinto: una formula fissa ha battuto il giudizio degli esperti in una revisione del 2013.
- Quanti intervistatori mi servono? Fino a 4, ciascuno che valuta da solo. Nei dati di Google, ogni colloquio dopo il 4° aggiungeva meno dell'1% di accuratezza.
- Posso fidarmi del punteggio dell'IA? Usalo come 1 input e leggi le sue motivazioni. In uno studio del 2023, un valutatore IA seguiva da vicino i valutatori umani addestrati su domande familiari e male su quelle nuove.
1. Una scheda di valutazione del colloquio mi aiuta davvero a scegliere assunzioni migliori?
Sì, quando ogni intervistatore valuta le stesse competenze rispetto a esempi scritti. Le interviste strutturate, in cui poni le domande e valuti tutti allo stesso modo, predicono la performance lavorativa a 0,42, più del doppio dello 0,19 di quelle non strutturate.
Questi dati provengono dalla rianalisi fondamentale del 2022 di Sackett e colleghi su decenni di ricerca sul reclutamento.
I numeri sono correlazioni, da 0 (nessun legame con la performance lavorativa successiva) a 1 (un legame perfetto). Quindi 0,19 non significa che le interviste non strutturate scelgono bene il 20% delle volte. Significa che il loro legame con la performance successiva è debole.
Il grafico qui sotto classifica 6 metodi comuni. I test di conoscenza del lavoro a 0,40 e i biodata con chiave di scoring, un questionario di background valutato, a 0,38 seguono subito dopo.
Seguono i test su campione di lavoro a 0,33 e i test di abilità cognitiva a 0,31. Le interviste non strutturate, la chiacchierata libera con cui molti di noi sono cresciuti, sono ultime.
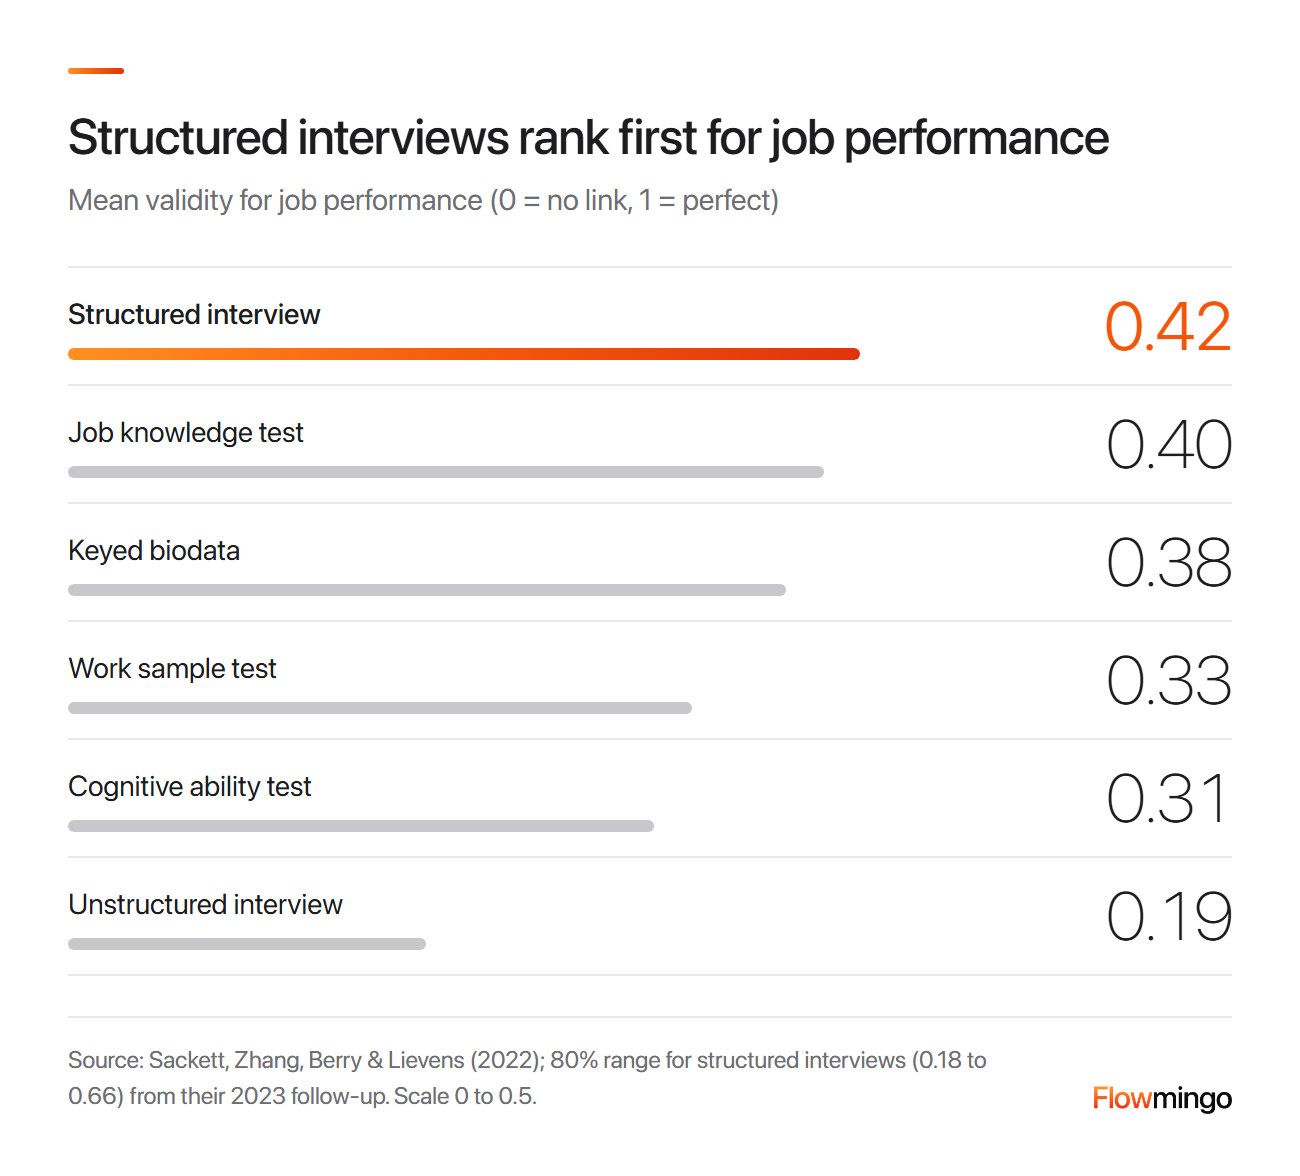
Metodi di reclutamento classificati per legame con la performance lavorativa: le interviste strutturate guidano a 0,42, le interviste non strutturate chiudono a 0,19 (rianalisi fondamentale di Sackett et al.).
Ma 0,42 è una media. Il seguito degli autori colloca la maggior parte delle interviste strutturate tra 0,18, non meglio di una chiacchierata libera, e 0,66, meglio di qualsiasi cosa nel grafico.
Il design è 1 di 3 motivi che gli autori indicano per questa variabilità. Ciò significa che una scorecard di intervista con competenze vaghe rischia di finire vicino al fondo. Queste sono medie su molti datori di lavoro, non una promessa sul tuo prossimo assunto.
2. Cosa dovrebbe includere il mio template di scorecard di intervista?
Un template di scorecard di intervista, o modulo di valutazione del candidato, include 5 competenze, ancore scritte, uno spazio per le evidenze e una soglia di requisiti indispensabili, tutto su 1 pagina. Si conclude con un'impressione generale e una raccomandazione.
Le ancore fanno sì che il 4 di 1 intervistatore significhi la stessa cosa di quello di un altro, e lo spazio per le evidenze risponde al "perché" quando il tuo CEO lo chiede.
Il requisito minimo impedisce a un punteggio totale alto di nascondere un requisito fondamentale debole. L'impressione generale viene per ultima, perché un'intuizione scritta per prima condiziona ogni punteggio sulle competenze che segue.
Ecco quel modulo per un responsabile del supporto clienti, con 2 requisiti minimi. Ognuna delle 5 competenze riceve un punteggio da 1 a 5, quindi il totale è su 25.
Fai 2 domande sui comportamenti passati per ogni competenza, perché un vero esempio passato ti dà qualcosa di concreto da confrontare con gli ancori. Per esempio: "Raccontami l'ultima volta che un cliente arrabbiato ha chiesto di parlare con un superiore."
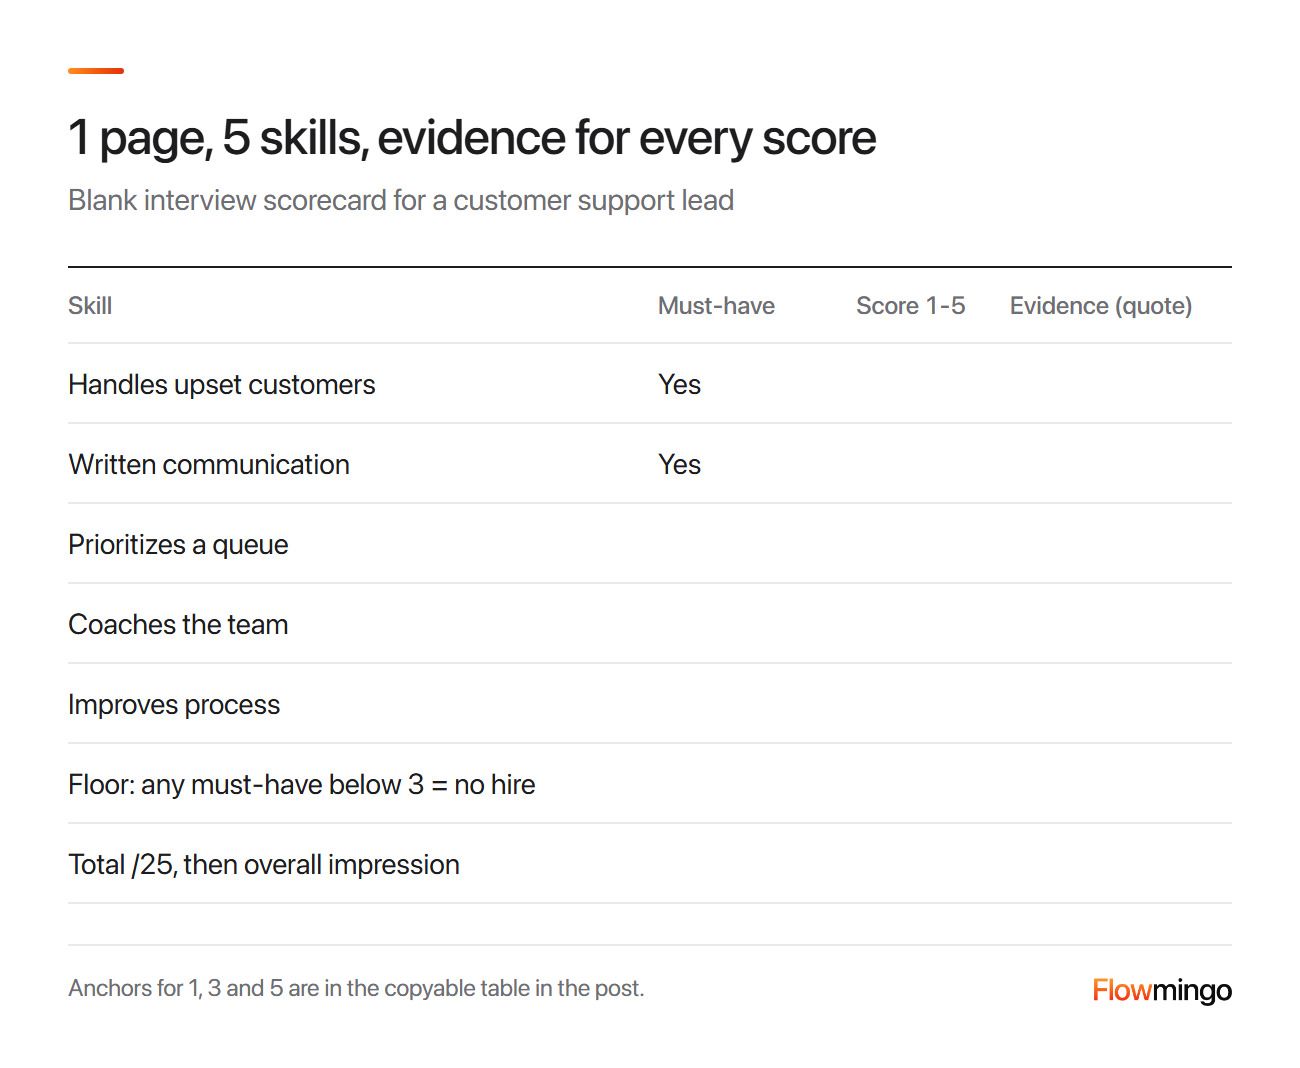
Modello di scheda di valutazione del colloquio vuota per un responsabile del supporto clienti: 5 competenze, 2 requisiti minimi, un punteggio da 1 a 5 e una citazione come prova per ciascuna.
Copia la tabella, poi sostituisci con le tue competenze e i tuoi ancori.
| Competenza | Ancoraggi per 1 / 3 / 5 | Punteggio 1-5 | Prova (citazione) |
|---|---|---|---|
| Intestazione | Candidato, ruolo, intervistatore, data | ||
| Gestisce clienti arrabbiati (requisito minimo) | Dà la colpa al cliente / applica la policy / risolve la causa | ||
| Comunicazione scritta (requisito minimo) | Poco chiara / chiara ma lunga / breve e chiara | ||
| Dà priorità a una coda | Nessun metodo / per urgenza / per impatto | ||
| Fa crescere il team | Nessun esempio / dà consigli / definisce un piano | ||
| Migliora i processi | Nessun esempio / propone una soluzione / la mette in pratica | ||
| Requisito minimo obbligatorio | Qualsiasi requisito minimo sotto 3 significa nessuna assunzione | ||
| Non valutato | Emozioni lette dal viso, dalla voce o dalla digitazione; accento o ritmo se non richiesti dal ruolo; "affinità culturale" | ||
| Totale | Somma dei 5 punteggi, su 25 | ||
| Impressione generale | Da 1 a 5, compilata per ultima | ||
| Raccomandazione | Assunzione decisa / assunzione / nessuna assunzione / nessuna assunzione netta; un'eccezione richiede una motivazione scritta |
2.1 Cosa devo decidere prima di costruirla?
Definisci prima il successo nel ruolo, poi scegli le competenze che lo producono. Blocca la scheda di valutazione del colloquio prima che arrivi il primo CV.
Quest'ordine viene da Who, di Geoff Smart e Randy Street. Scrivi 1 riga di missione, poi da 3 a 8 risultati ordinati per importanza, poi da 4 a 6 competenze. Un risultato è un esito misurabile, come far crescere il fatturato da 25 milioni a 50 milioni di dollari entro il terzo anno, non un'attività.
Bloccare la scheda conta perché le persone modificano i criteri senza accorgersene. Nei fondamentali studi di Uhlmann e Cohen (2005), i partecipanti giudicavano un candidato scafato e uno molto istruito per il ruolo di capo della polizia.
Qualunque forza avesse l'uomo, decidevano che il lavoro la richiedeva di più, e la donna non riceveva lo stesso vantaggio. Impegnarsi sui criteri prima di vedere i candidati eliminava quel pregiudizio. Quindi una scheda di valutazione scritta dopo aver incontrato i candidati può piegarsi silenziosamente verso quello che già ti piace.
2.2 La cultura fit dovrebbe essere nella scorecard?
Non come è scritta, perché nessuno può valutarla allo stesso modo due volte. Trasformala in 1 o 2 comportamenti osservabili, come "chiede feedback sul proprio lavoro".
Supponi che il tuo team valorizzi la franchezza: valuta invece "ha fornito un esempio specifico di una segnalazione precoce di un errore".
3. Come peso i punteggi dei colloqui in modo che i requisiti indispensabili contino di più?
Assegna a ogni competenza lo stesso peso e aggiungi una soglia minima per i requisiti indispensabili, oppure fissa i pesi prima del primo colloquio. Pesi uguali spesso prevedono i nuovi casi bene quanto i pesi adattati ai dati passati.
Questo secondo punto viene dallo psicologo Robyn Dawes, come riassume Kahneman in Pensieri lenti e veloci.
I pesi calibrati sulle tue assunzioni passate apprendono anche gli incidenti di quel gruppo. Supponi che i tuoi 3 migliori assunti nel supporto fossero tutti dei bravi coach: un peso calibrato favorirebbe il coaching in ogni futuro candidato.
I pesi uguali non possono inseguire un incidente del genere, ed è per questo che spesso prevedono i nuovi candidati altrettanto bene. Mantieni anche le competenze indipendenti, come consiglia Kahneman: non elencare sia "comunicazione" sia "capacità di presentazione", perché insieme contano due volte la stessa cosa.
Un requisito indispensabile trae la sua forza dalla soglia minima, non da un peso maggiore. Supponi che "Gestisce clienti arrabbiati" ottenga 2 e ogni altra competenza ottenga 5.
Il totale di 22 su 25 sembra ottimo, ma la soglia minima dice comunque di non assumere. È quello che vuoi per una competenza di cui il lavoro non può fare a meno.
Se usi i pesi, scrivili sulla scorecard del colloquio in anticipo e applicali a tutti. Questo chiude il modo più facile per alterare un totale: cambiare i pesi dopo aver conosciuto qualcuno che ti piace.
Come aiuta Flowmingo
Il report del colloquio AI di Flowmingo usa pesi fissi: un criterio Must Have conta 4 volte un Good to Have nel punteggio complessivo. Ogni criterio mantiene il proprio punteggio da 0 a 10, così puoi comunque applicare da solo una soglia minima per i requisiti indispensabili.
4. Come posso fare in modo che un 3 significhi la stessa cosa per ogni intervistatore?
Scrivi cosa contiene una risposta da 1, da 3 e da 5 per ogni competenza, prima del primo colloquio. Questa scala di valutazione ancorata a comportamenti rende comparabili i punteggi di 2 intervistatori.
"Ancorata a comportamenti" significa semplicemente che ogni punteggio è legato a ciò che il candidato ha fatto, non a una sensazione come "abbastanza buono". Senza ancore, un 3 sulla stessa scheda di valutazione del colloquio significa "va bene" per 1 intervistatore e "debole" per un altro.
I colloqui ancorati mostrano anche legami medi più forti con la performance successiva. La revisione fondamentale di Taylor e Small su 19 studi sui colloqui basati su comportamenti passati ha rilevato un legame di .35 con scale ancorate, contro .26 senza. Gli studi differivano anche per altri aspetti, quindi questo confronto non isola l'effetto dell'aggiunta delle ancore.
Ecco la scala di valutazione del colloquio per la competenza indispensabile "Gestisce i clienti arrabbiati".
| Punteggio | Cosa contiene la risposta |
|---|---|
| 1 | Dà la colpa al cliente; nessuna azione propria e nessun esito |
| 3 | Un esempio reale: calma il cliente e applica la policy, ma non verifica mai il risultato |
| 5 | Un esempio reale: individua la causa, la risolve, fa follow-up e condivide la soluzione |
Ogni passo in su è qualcosa che puoi sentire nella risposta. Ecco perché 2 ascoltatori possono arrivare allo stesso numero.
Se non riesci ancora a scrivere le ancore, prendi in prestito i 5 livelli dalla guida al colloquio strutturato dell'OPM, l'agenzia federale statunitense per le risorse umane. Ciascuno ruota attorno a quanto era difficile la situazione e a quanta guida ha avuto bisogno la persona.
- 1, Consapevolezza: le situazioni più semplici, con una guida stretta ed estesa.
- 2, Base: situazioni alquanto difficili, con una guida frequente.
- 3, Intermedio: situazioni difficili, con una guida occasionale.
- 4, Avanzato: situazioni considerevolmente difficili, con poca o nessuna guida.
- 5, Esperto: situazioni eccezionalmente difficili, in cui la persona consiglia gli altri.
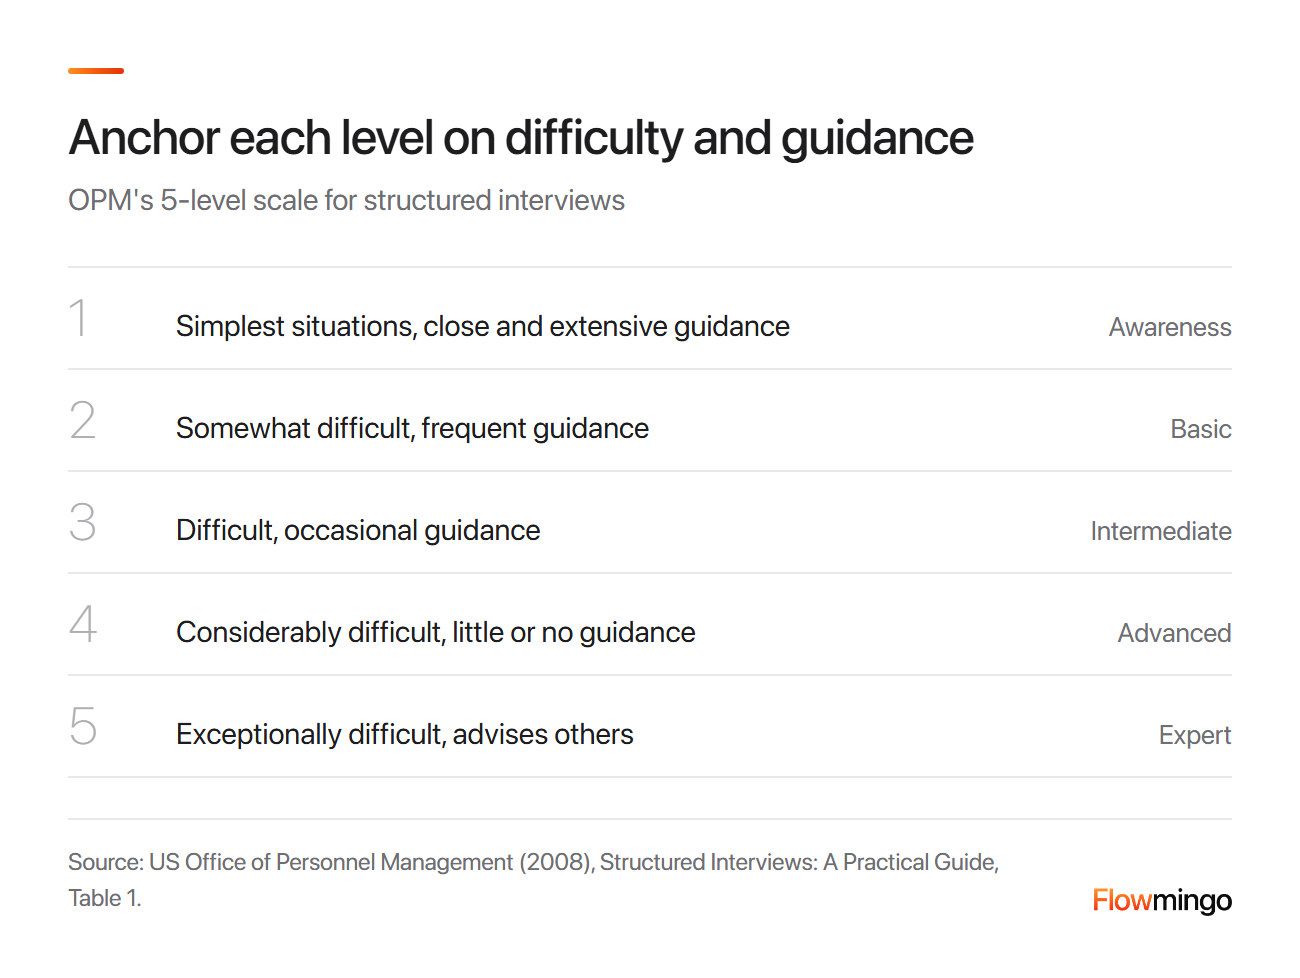
I 5 livelli di valutazione dell'OPM per i colloqui strutturati: da Consapevolezza (situazioni più semplici, guida stretta) a Esperto (situazioni eccezionalmente difficili, consiglia gli altri).
5. Come scelgo tra 2 finalisti forti quando i miei intervistatori non sono d'accordo?
Lascia decidere il totale della scorecard del colloquio, con 2 eccezioni: un requisito indispensabile sotto il 3, oppure una divergenza 2 contro 5, su cui vi confrontate basandovi sulle evidenze. Non rivotate basandovi sulle sensazioni.
Questo è il momento per cui esistono le scorecard, e il momento in cui è più tentante abbandonarle. Ecco un esempio illustrativo, non dati di clienti: 3 finalisti per un ruolo di support lead, ogni cella con la media di 3 intervistatori.
| Competenza | A | B | C |
|---|---|---|---|
| Gestisce clienti arrabbiati (indispensabile) | 4 | 2 | 4 |
| Comunicazione scritta (indispensabile) | 4 | 4 | 3 |
| Dà priorità a una coda | 3 | 4 | 3 |
| Fa crescere il team | 3 | 4 | 4 (punteggi 2, 5, 5) |
| Migliora i processi | 4 | 4 | 3 |
| Totale, su 25 | 18 | 18 | 17 |
| Decisione | Assumere | Non assumere: scatta la soglia minima | Confronto sulla divergenza |
Leggi la scorecard del colloquio riga per riga. A e B sono pari a 18 su 25. Ma B ha ottenuto 2 su un requisito indispensabile, quindi scatta la soglia minima e B non va assunto.
C totalizza 17, ma la media di 4 di C su "Fa crescere il team" nasconde una divergenza: 1 intervistatore ha dato 2, e gli altri 2 hanno dato 5. Quel divario diventa l'unico punto all'ordine del giorno del confronto.
In pratica, chiedi a ciascuna parte di leggere ad alta voce le citazioni delle proprie evidenze. Supponi che chi ha dato il punteggio basso abbia sentito parlare di un membro del team che se n'è andato, e gli altri abbiano sentito parlare di un piano di coaching che ha funzionato. Il confronto decide quale storia è più tipica di C, e chiunque abbia tralasciato delle evidenze modifica il punteggio per iscritto.
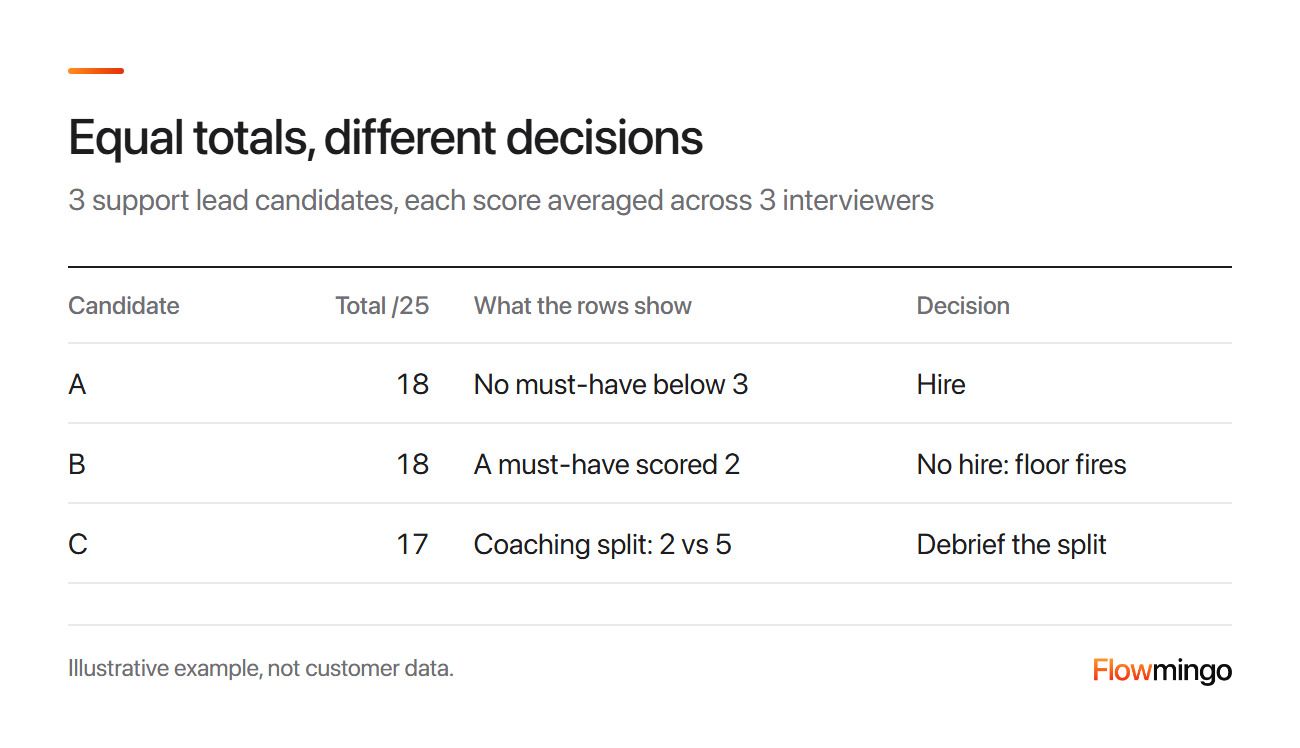
Scorecard del colloquio compilata, a scopo illustrativo: A e B sono pari a 18 su 25, B manca un requisito indispensabile, e C ha una divergenza sul coaching da confrontare.
Una volta che i punteggi individuano un finalista, scrivi le condizioni nell'offerta prima di inviarla: il nostro modello di lettera di offerta di lavoro mostra dove va inserita ogni verifica.
5.1 E se il mio istinto dice una cosa e i punteggi un'altra?
Segui i punteggi, a meno che tu non riesca a mettere per iscritto le evidenze che hanno tralasciato. Nella fondamentale meta-analisi del 2013 di Kuncel e colleghi, una formula applicata allo stesso modo a tutti prevedeva la performance lavorativa a 0,44, contro 0,28 del giudizio olistico. Gli autori parlano di un miglioramento della previsione di oltre il 50%, persino rispetto a esperti che conoscevano il lavoro.
Il giudizio olistico significa che le persone soppesano mentalmente gli stessi fatti, comprese le riunioni di consenso. Quindi il confronto colma le lacune nelle evidenze, e non rivota.
5.2 Dovrei confrontare i finalisti fianco a fianco?
Sì, risposta per risposta. Il consiglio su HBR di Bohnet è di confrontare tutte le risposte alla domanda 1, poi alla domanda 2, così giudichi ogni risposta rispetto alle altre.
In uno studio di laboratorio fondamentale del 2016, le persone a cui veniva mostrato 1 candidato alla volta propendevano per il genere favorito dallo stereotipo del compito. Le prestazioni passate contavano poco. Mostrati 2 fianco a fianco, sceglievano il più performante il 54% delle volte e il meno performante l'8%.
Lo studio usava punteggi di compiti passati, non colloqui, quindi trattalo come un forte indizio più che come una prova.
6. Come impedisco che l'intervistatore più loquace vinca il debriefing?
Fai inviare a ogni intervistatore la propria scheda di valutazione prima che qualcuno parli, poi apri il debriefing con i punteggi.
Supponi che una persona senior apra dicendo "l'ho adorata", e la stanza inizia a orientarsi verso quella visione. I punteggi scritti da soli proteggono tutti da quella spinta, ed è per questo che Noise rende la valutazione indipendente una regola di assunzione.
In pratica, raccogli i punteggi in un foglio condiviso o nel tuo applicant tracking system, e rivelali tutti insieme.
Un panel, in cui tutti guardano lo stesso colloquio, sembra una soluzione. Nella meta-analisi fondamentale del 2013 di Huffcutt e colleghi, i valutatori del panel concordavano a 0,74, contro 0,44 per i colloqui separati, su una scala da 0 a 1.
Quel numero fa apparire i panel migliori di quanto siano. I membri del panel valutano tutti la stessa prestazione nello stesso giorno, quindi se il candidato ha avuto una mattinata insolitamente buona o cattiva, la vedono tutti.
Come ha detto Iris Bohnet in un intervento a Google, "la dimensione del campione di un colloquio panel è praticamente una". I colloqui separati, ciascuno valutato da solo, ti danno più sguardi indipendenti.
6.1 Quanti intervistatori dovrebbero valutare ogni candidato?
Fino a 4, in colloqui separati. Nei dati interni di Google, non uno studio peer-reviewed, 4 colloqui prevedevano la decisione di assunzione con una confidenza dell'86%. Ogni colloquio aggiuntivo apportava meno dell'1%.
I colloqui extra aggiungevano poco alla previsione della decisione di assunzione di Google stessa. Usalo come spunto per giustificare ogni round, non come un massimo universale né come prova sulla performance lavorativa successiva.
7. Come faccio a far compilare davvero la scorecard del colloquio agli intervistatori impegnati?
Rendi la valutazione parte del colloquio. Valuta ogni competenza subito dopo le relative domande, scrivi una citazione di 1 riga come prova e lascia l'impressione generale per ultima.
Nessuno vuole un altro form dopo una giornata di colloqui. Ecco perché la valutazione avviene durante il colloquio, non come compito a casa per stasera.
Kahneman ideò questo metodo per l'esercito israeliano nel 1955, dopo che i colloqui liberi si dimostrarono quasi inutili nel prevedere il successo. Gli intervistatori valutavano 6 tratti su una scala da 1 a 5, completando ciascuno prima di passare al successivo, così che una prima impressione non potesse influenzare il resto.
Solo dopo chiudevano gli occhi e davano una valutazione complessiva, e il totale prevedeva in modo molto più accurato di prima. Il suo consiglio: assumi chi ha il totale più alto, "anche se ce n'è un altro che ti piace di più".
Anche il momento conta. In uno studio sul campo, 166 intervistatori hanno riferito quando si erano formati il giudizio. Solo il 4,9% delle decisioni è arrivato nel primo minuto, ma il 22,5% è arrivato dopo la fine del colloquio.
Una decisione presa dopo che il candidato se n'è andato si basa sulla memoria, quindi valuta man mano.
Per il nostro support lead, funziona così:
- Fai le 2 domande sulla coda, poi valuta "Prioritizza una coda" prima di passare avanti.
- Scrivi 1 citazione come prova, ad esempio "Ordino i bug in base a quanti clienti coinvolgono."
- Mantieni lo stesso ordine di competenze per ogni candidato.
Le prove scritte sono rare nei nostri dati.
Dati Flowmingo · 86.638 candidati intervistati con l'AI · 2.574 aziende · da lug 2025 a set 2026
- 0,3% dei candidati intervistati con l'AI ha ricevuto un commento scritto dal team di selezione (258 su 86.638).
I team potrebbero tenere le note altrove; all'interno di Flowmingo, il report dell'AI è di solito l'unica valutazione scritta agli atti.
Una motivazione scritta è la prima cosa che si salta in una giornata piena. Per questo il modulo chiede solo 1 citazione per competenza.
8. Posso fidarmi di un punteggio AI sulla mia scheda di valutazione del colloquio?
Usalo come 1 input che una persona rivede, e leggi prima le sue motivazioni. Il punteggio AI può crollare bruscamente sulle domande per cui non è stato addestrato.
Abbiamo un interesse in questa risposta, quindi le prove qui sotto includono anche la parte che non fa l'elogio dell'AI.
In uno studio fondamentale del 2023, 2 valutatori addestrati hanno assegnato un punteggio a 7.017 risposte di candidati su una scala ancorata da 1 a 5. Un modello addestrato sulle stesse domande ha eguagliato da vicino i loro punteggi, a 0,75 su una scala da 0 a 1. Su formati di domande che non aveva mai visto, è sceso a 0,30, una corrispondenza debole.
Questo significa che un punteggio AI vale solo quanto la sua rubrica specifica per le domande, quindi leggi le sue motivazioni prima di fidarti del numero. Nota anche che 3 dei 5 autori di quello studio lavoravano per il fornitore di interviste AI Modern Hire.
Come aiuta Flowmingo
L'AI Interviewer di Flowmingo assegna un punteggio in base a criteri che approvi tu. L'AI redige le domande e i criteri dalla tua descrizione del ruolo, e tu modifichi entrambi. Invii a ogni candidato il colloquio da sostenere quando preferisce.
Ricevi la registrazione, la trascrizione e ogni criterio valutato da 0 a 10 con una giustificazione scritta. La decisione di assunzione spetta a te.
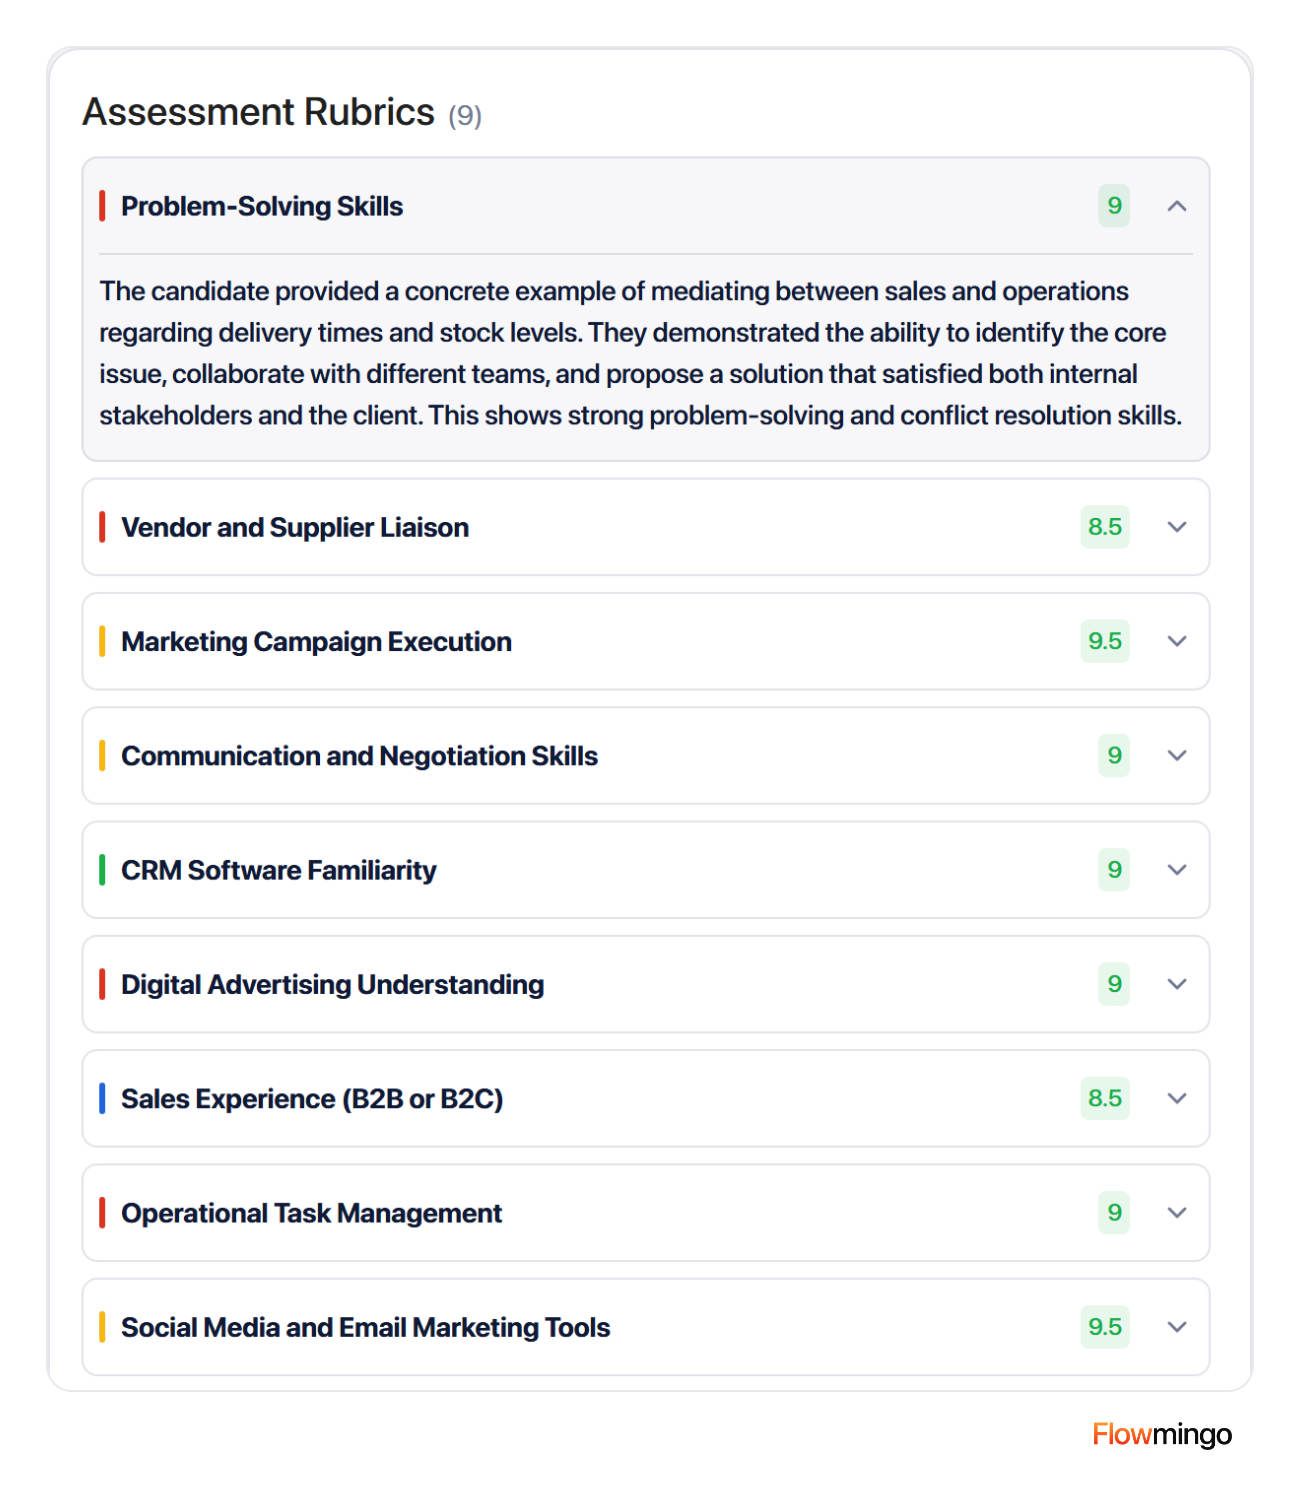
Report di esempio pubblico di Flowmingo: un punteggio da 0 a 10 e una motivazione per ogni criterio, così puoi fissare su quella scala qualsiasi soglia minima indispensabile.
Nei nostri dati, anche il CV e il colloquio non concordano su chi sia il migliore.
Dati Flowmingo · 34.114 candidati · 379 aziende · da lug 2025 a set 2026
- 19,2% dei 532 progetti con 1 chiaro punteggio di colloquio più alto ha assegnato a quel candidato anche il punteggio CV più alto.
- 54,9% dei 3.684 candidati che hanno ottenuto 8 o più al colloquio (2.022) sarebbe stato scartato da una shortlist del 20% con i CV migliori.
Entrambi sono punteggi AI di Flowmingo, non la performance sul lavoro, e gli intervistati sono un gruppo selezionato. I dati mostrano che le 2 classifiche differiscono, non quale sia quella giusta.
In parole povere, in circa 4 progetti su 5 il candidato con il punteggio più alto al colloquio non era anche quello con il punteggio più alto del CV. Quindi valuta il colloquio per sé, invece di lasciare che il punteggio del CV si riverberi su di esso.
9. Le mie schede di valutazione mi proteggeranno se un candidato respinto presenta un reclamo?
Aiutano, se valutano elementi legati al lavoro e le conservi. Secondo una lettura ragionevole, le norme federali statunitensi implicano conservare le schede di valutazione per almeno 1 anno, e quelle della California per 4 anni.
Un reclamo può arrivare mesi dopo, quando nessuno ricorda più il colloquio. Una scheda di valutazione del colloquio con una citazione per ogni competenza mostra cosa hai valutato e perché.
La norma statunitense non nomina le schede di valutazione, ma copre "other records having to do with hiring". Una volta che qualcuno presenta una denuncia per discriminazione, conservi ogni documento rilevante fino alla fine del caso. Questo include i documenti degli altri candidati per lo stesso ruolo, quindi 1 denuncia blocca l'intero insieme.
Queste norme valgono a settembre 2026. Questo è un riassunto, non un parere legale.
| Norma | Dove | Cosa significa per la tua scheda di valutazione |
|---|---|---|
| 29 CFR 1602.14 | USA | Conserva i documenti di assunzione per 1 anno, più a lungo dopo una denuncia |
| 2 CCR 11013(c) | California | Conserva i documenti per 4 anni, inclusi i dati delle decisioni automatizzate |
| Linee guida ICO | Regno Unito | I candidati possono richiedere le note del colloquio; comunica qualsiasi regola di spareggio |
| TAFEP | Singapore | Usa un modulo di valutazione e conserva i documenti per almeno 1 anno |
| 29 CFR 1630.11 (ADA) | USA | Se una disabilità influisce sul parlato, valuta la competenza, non il parlato, a meno che parlare sia ciò che il lavoro richiede |
| AI Act, articolo 5(1)(f) | UE, dal 2 febbraio 2025 | Nessuna IA che inferisca le emozioni dei candidati da volti, postura o battiture |
| AI Act, allegato III e articolo 26 | UE, dal 2 dicembre 2027 | Alto rischio: supervisione umana, log conservati per 6+ mesi, candidati informati |
| Local Law 144 | New York City | Un punteggio IA usato da solo, ponderato più di ogni altra cosa o usato per prevalere sulle persone: audit annuale per i bias e informativa |
| AI Video Interview Act | Illinois | Prima informativa, spiegazione e consenso; elimina i video entro 30 giorni da una richiesta |
Ecco perché il modello ha una riga "Non valutato". L'UE vieta l'IA che legge le emozioni dei candidati da volti, postura o battiture, e la legge statunitense sulla disabilità (ADA) protegge i candidati la cui disabilità influisce sul parlato. Nel Regno Unito i candidati possono chiedere le tue note, quindi scrivi ogni riga di evidenza come se dovessero leggerla.
Per l'autovalutazione, confronta i tassi di superamento per gruppo con la regola pratica dei 4/5 nelle Uniform Guidelines. Supponiamo che il 30% di un gruppo superi la selezione e il 50% di un altro: 30 diviso 50 fa 0,6, sotto 0,8, quindi guarda più da vicino.
Un parere del Dipartimento di Giustizia del giugno 2026 e una norma OPM del luglio 2026 allontanano le agenzie federali dalle Guidelines. Tuttavia restano nei regolamenti federali, quindi considera il controllo come un'abitudine a basso costo, non come una linea legale.
10. Come faccio a introdurre una scheda di valutazione del colloquio con il mio team questa settimana?
Costruiscila in questo ordine e modificala solo tra un ruolo e l'altro. Una prima versione non deve essere perfetta, ma deve essere la stessa per ogni candidato.
- Scrivi 1 riga di missione e da 3 a 8 risultati in ordine di priorità.
- Trasformali in 5 competenze e contrassegna quelle indispensabili.
- Scrivi 2 domande sui comportamenti passati e gli ancoraggi per 1, 3 e 5 per ogni competenza.
- Fai valutare fino a 4 intervistatori in autonomia, che inviano il punteggio prima del debriefing.
- Lascia decidere il totale, ma qualsiasi requisito indispensabile sotto 3 significa niente assunzione. Annota ogni deroga.
In pratica, inizia con 1 ruolo aperto, così il tuo team impara l'abitudine su qualcosa di reale. Prima della prima intervista, fai valutare a tutti la stessa risposta di esempio e confrontate i risultati.
Se 2 punteggi distano più di 1 punto, riscrivi l'ancoraggio finché non concordano. I valutatori addestrati dello studio della sezione 8 usavano lo stesso scarto di 1 punto per indire una riunione.
Aspettati qualche resistenza. Anche gli intervistatori dell'esercito di Kahneman si opponevano semplicemente a registrare le risposte, e la sua soluzione fu la valutazione a occhi chiusi, che dava al loro giudizio un posto nel modulo. La tua riga di impressione generale fa lo stesso per il tuo team.
Come aiuta Flowmingo
Per inviare a ogni candidato un colloquio strutturato da svolgere quando preferisce, registrato e valutato secondo 1 scheda di valutazione del colloquio, prova Flowmingo.
11. Fonti
Ogni dato esterno citato sopra proviene dalle fonti elencate di seguito, in ordine di comparsa. I dati di Flowmingo si trovano nei riquadri, da lug 2025 a set 2026.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.