Огляд: що насправді означає «точність» у AI-найманні
Інструменти AI-оцінювання кандидатів значно просунулися за останні роки. Точність уже не визначається самим лише сирим балом, а поєднанням узгодженості, прогнозної ефективності, зменшення упередженості та прозорості рубрик.
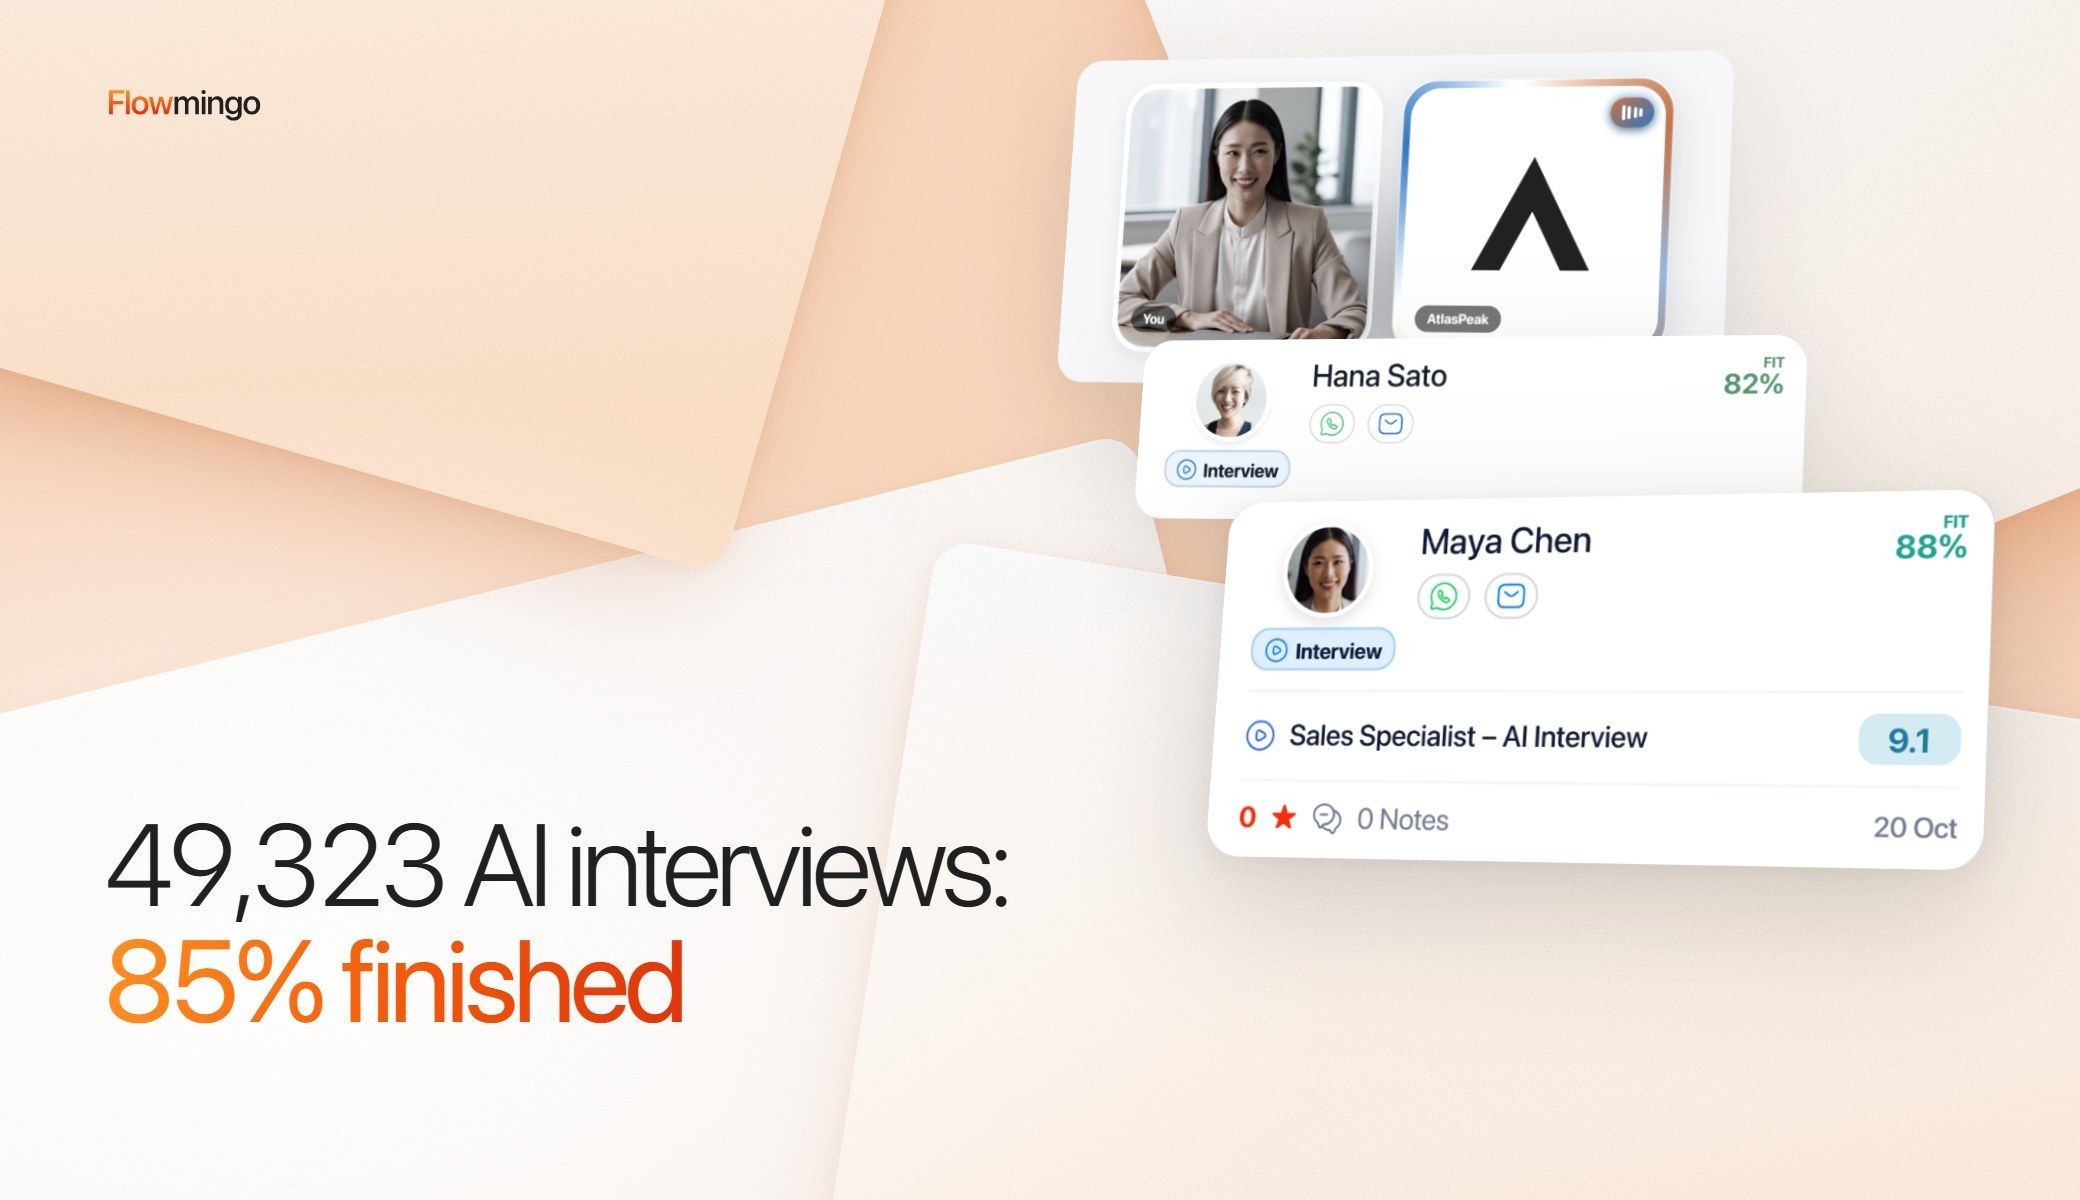
Цей бенчмарк оцінює провідні інструменти AI-оцінювання кандидатів за вимірюваними критеріями точності, а не за маркетинговими заявами. Щодо того, що має означати «вимірюваний», ось наш підхід: із 49 323 AI-інтерв'ю, розпочатих на Flowmingo між 24 червня та 20 вересня 2026 року, 85,0% було завершено — 89,2% на десктопі чи ноутбуці та 73,5% на телефоні. Запитайте будь-якого постачальника на цій сторінці про ті самі 3 числа. (наш бенчмарк завершуваності)
Ключові висновки
- Точність залежить від узгодженості, а не лише від складності моделі
- Структуровані рубрики перевершують неструктуроване оцінювання
- Прогнозна валідність — найсильніший показник якості оцінювання
- Прозорість зміцнює довіру наймальних менеджерів і сприяє впровадженню
- Запитайте кожного постачальника, проти чого валідовано його бали і де опубліковано ці докази
Питання: як вимірюється точність в інструментах AI-оцінювання кандидатів?
Точність у сучасних системах наймання оцінюється за 5 ключовими вимірами.
Узгодженість оцінювання
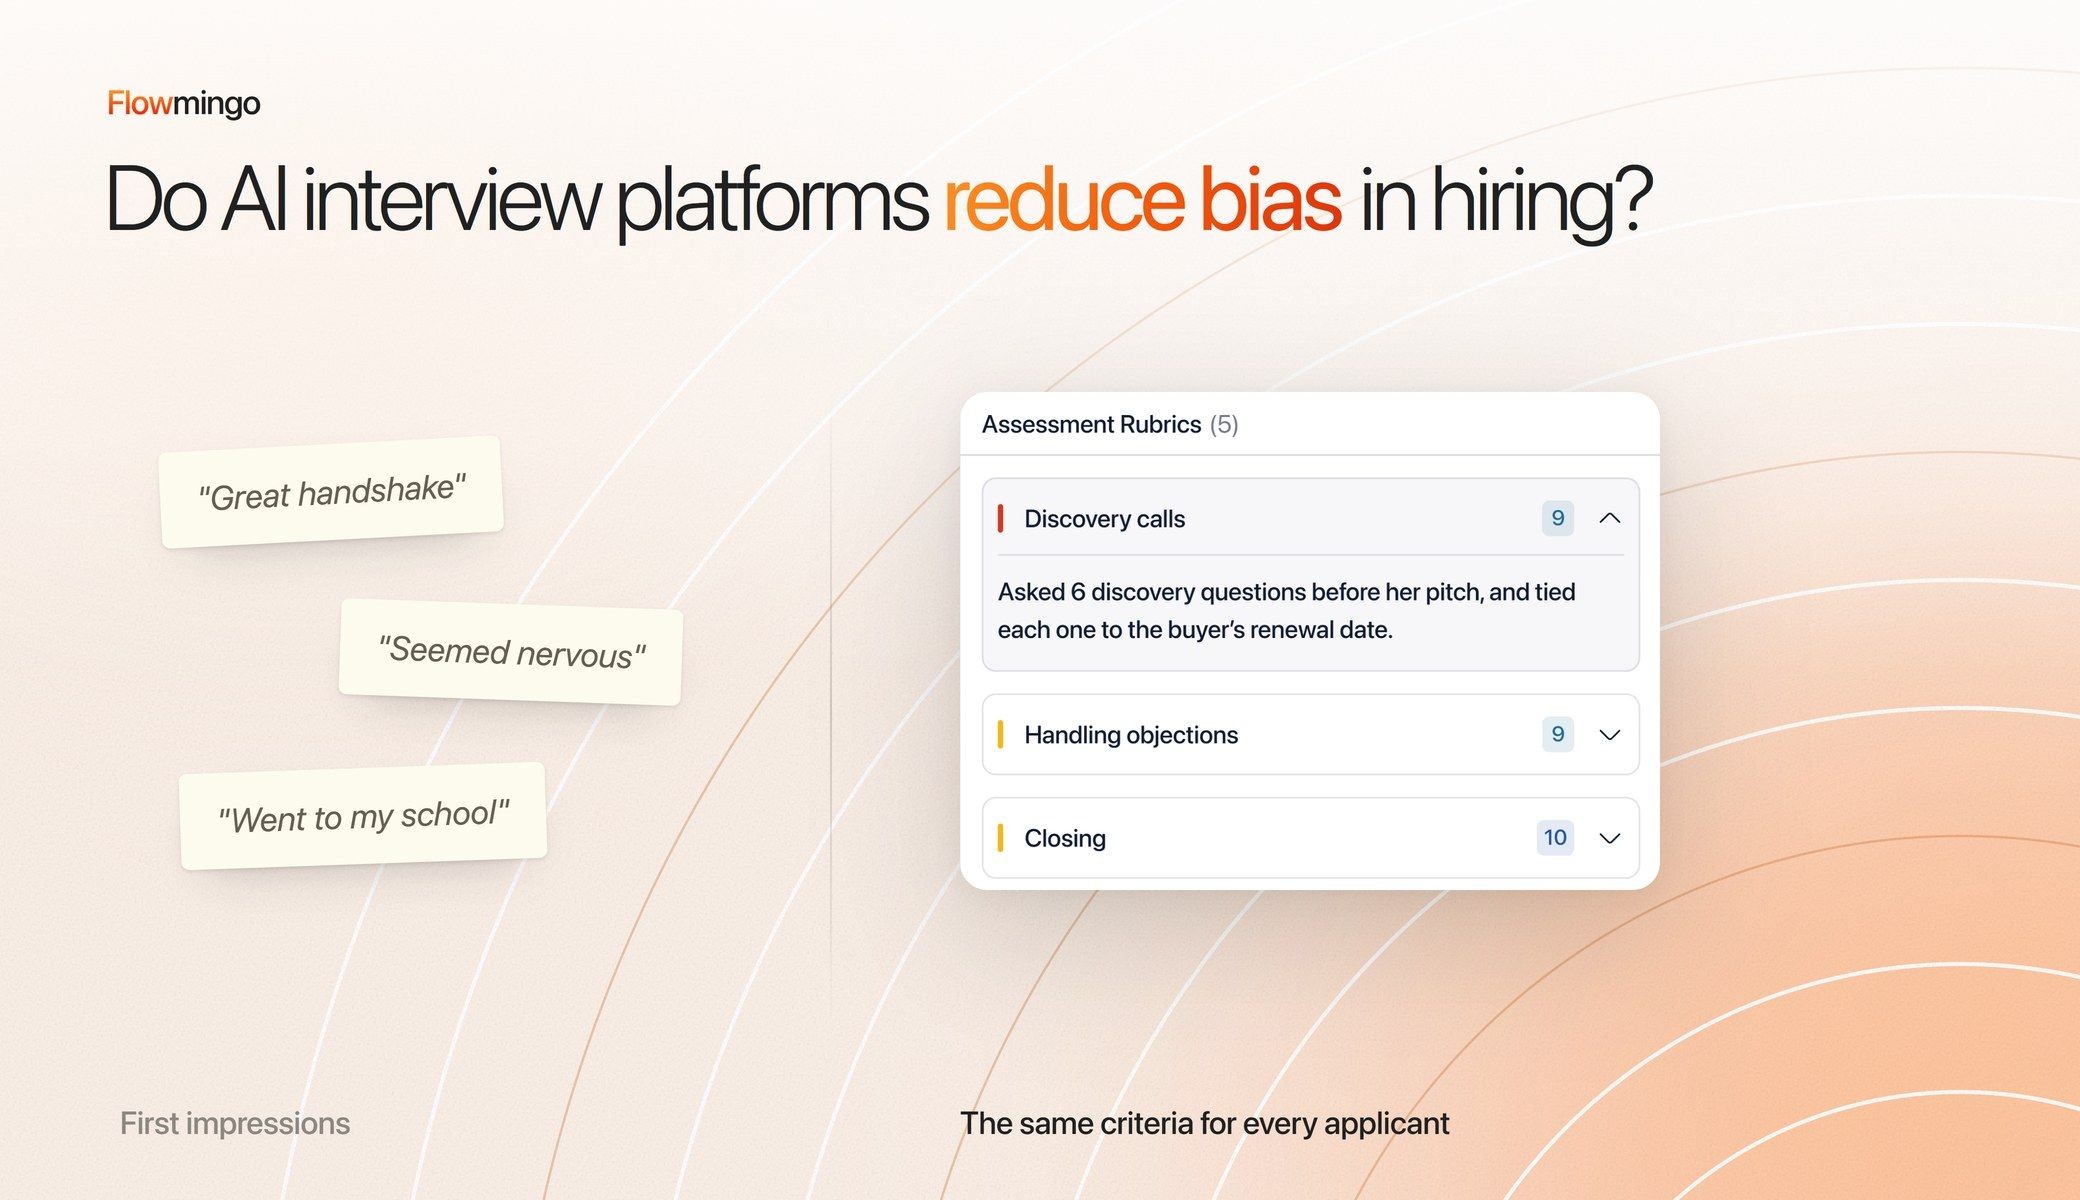
AI-системи зменшують варіативність оцінювання на 40–60%, особливо для компетенцій, пов'язаних з роллю, завдяки застосуванню однакової логіки до кожного кандидата.
Узгодженість — це основа справедливих і обґрунтованих рішень про наймання.
Валідація за бенчмарком
Платформи суттєво різняться за:
- Розміром набору даних
- Частотою валідації
- Широтою бенчмарків для ролей
Інструменти з безперервною валідацією зберігають на 10–20% вищу надійність оцінювання, ніж платформи, що оновлюються лише щоквартально або щорічно.
Прогностична ефективність
Точність прогнозу вимірюється за допомогою:
- Результативності в перші 90 днів
- Оцінок задоволеності наймаючого менеджера
- Показників раннього плинності кадрів
Дослідження вимірює структуру, а не програмне забезпечення: структурована співбесіда корелює з результативністю роботи на рівні 0,42 проти 0,19 для неструктурованої (Sackett et al., 2022). Ми не змогли знайти опублікованого дослідження валідності власних оцінок жодного постачальника AI-оцінювання, включно з Flowmingo, тому наведене нижче порівняння ранжує інструменти за тим, наскільки послідовно вони дотримуються єдиної структури співбесіди.
Зменшення упередженості
Оцінювання упередженості досліджує розбіжність оцінок за:
- Статтю
- Етнічним походженням
- Віком
- Акцентом і стилем спілкування
Ми не змогли знайти опублікованого аудиту демографічної упередженості власних оцінок жодного постачальника, включно з Flowmingo. Перш ніж вірити будь-якій цифрі, запитайте в інструмента відповідний документ.
Прозорість рубрик
Високоточні платформи чітко розкривають:
- Категорії оцінювання
- Зважені рубрики
- Відображення компетенцій
Прозорість безпосередньо підвищує внутрішню довіру та впровадження.
З: Що кожен інструмент публікує про свою точність?
Цю сторінку написав Flowmingo, і Flowmingo є одним із інструментів на ній. Деталі конкурентів узято з власних сторінок кожного постачальника, переглянутих 22 вересня 2026 року.
| Інструмент | Як формує оцінку | Оприлюднені докази |
|---|---|---|
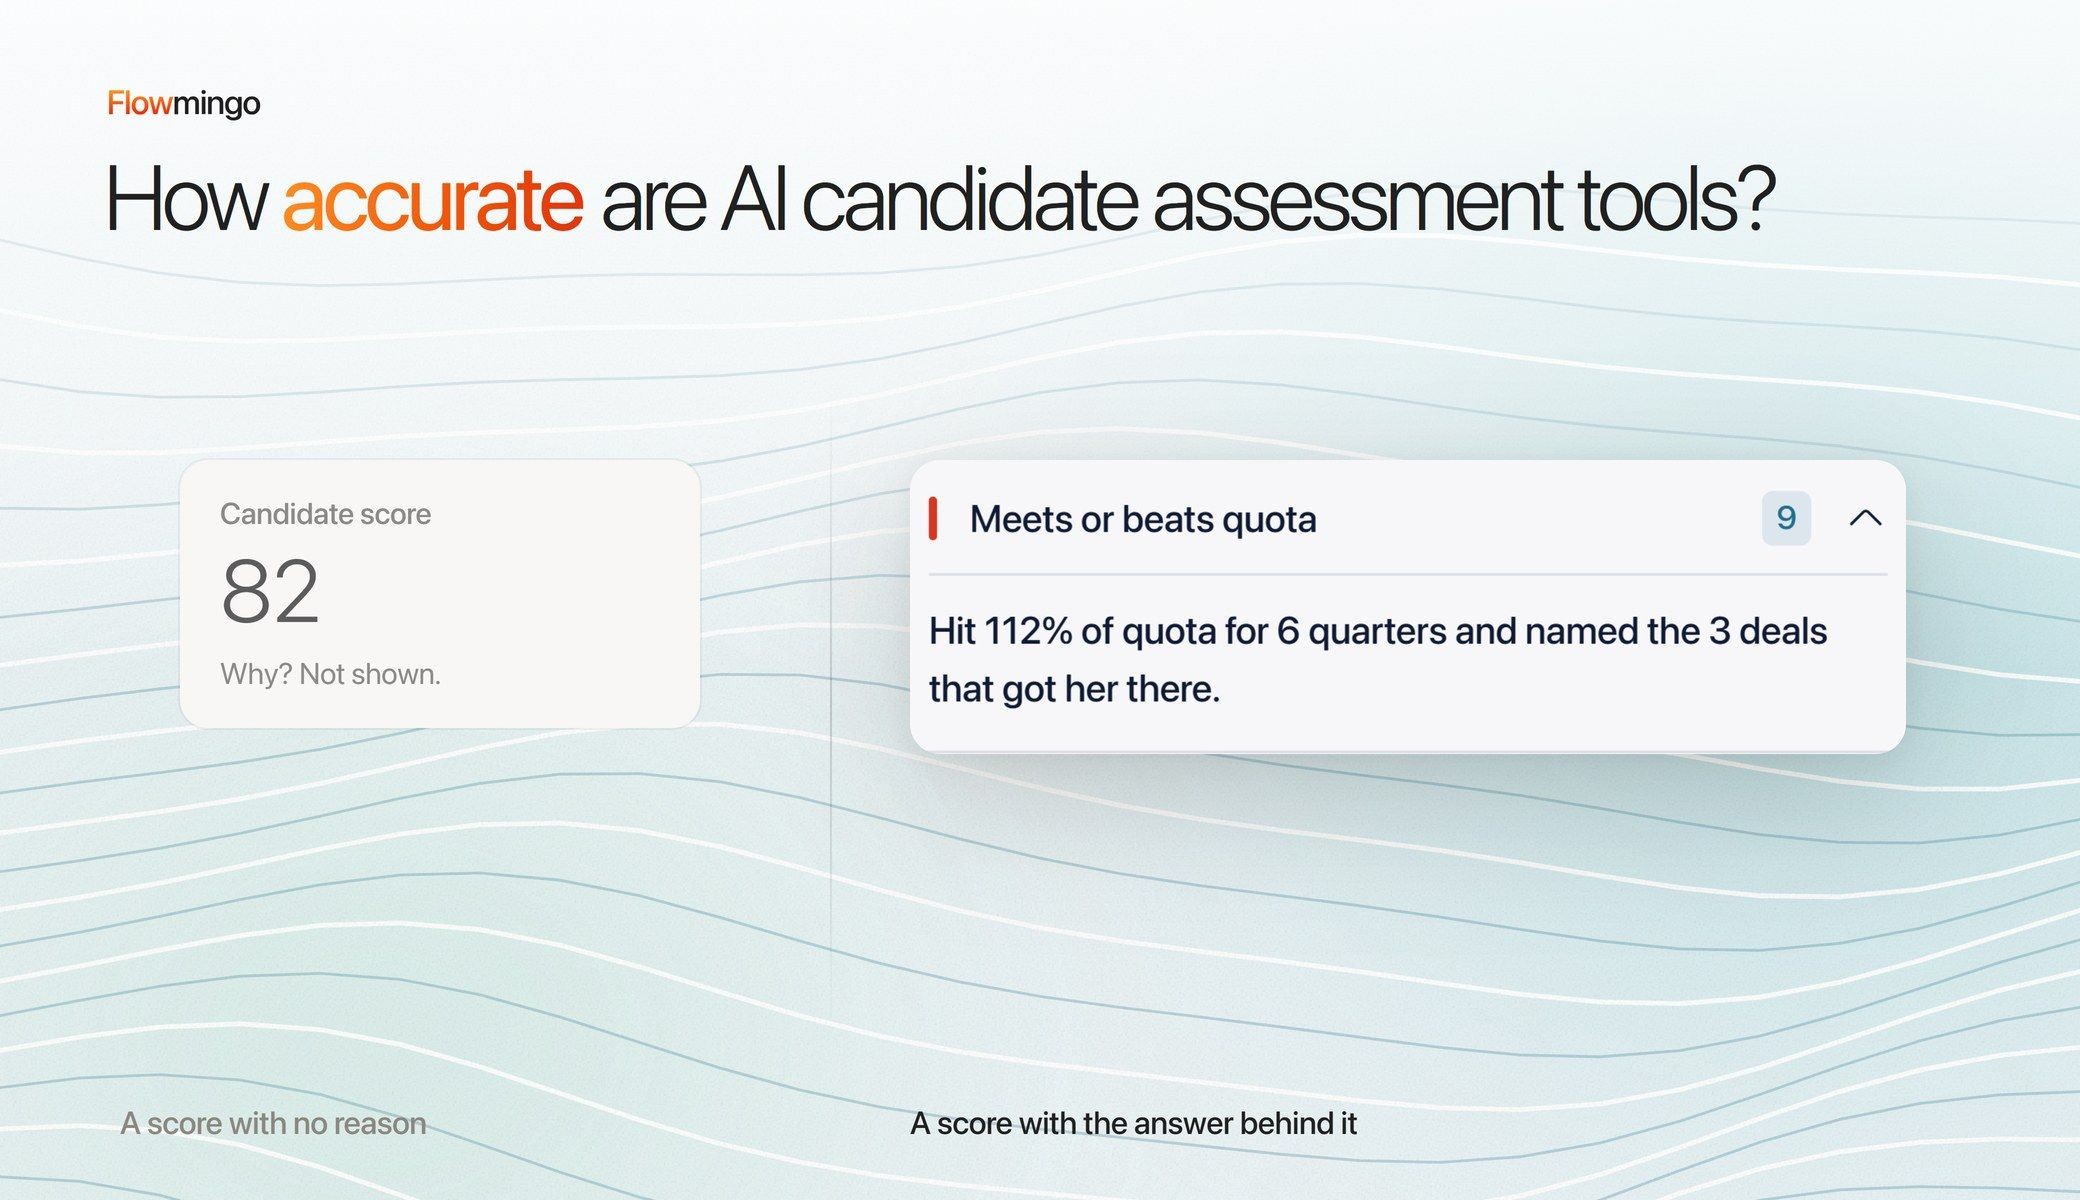
| Flowmingo | Оцінка 0–10 за кожним вашим критерієм із письмовим обґрунтуванням, зважена від «Бажано мати» до «Обов'язково мати» | Письмові обґрунтування кожної оцінки в звіті про кожного кандидата |
| HireVue | AI-інтерв'юер, який оцінює за критеріями конкретної ролі: «AI Informs. Humans decide.» | Понад 1 300 валідаційних досліджень, ISO/IEC 27001, SOC 2 Type 2 і FedRAMP, згідно з їхньою сторінкою про відповідність |
Якщо ваш відділ закупівель вимагає оприлюднених валідаційних досліджень, HireVue має їх уже сьогодні. Якщо вам потрібно бачити, чому кожен кандидат отримав кожну оцінку, AI Interviewer від Flowmingo показує причини в кожному звіті. Порівняйте Flowmingo і HireVue пліч-о-пліч.
Запитання: що оцінює AI Interviewer від Flowmingo?
- Ваші критерії з вагами. Ви задаєте критерії та їхню значущість — від «Бажано мати» до «Обов'язково мати».
- Оцінка з обґрунтуванням. Кожен критерій отримує оцінку 0–10 з письмовим обґрунтуванням, а також сильні сторони й прогалини.
- Рейтинг у межах одного інтерв'ю. Кожного кандидата ранжують порівняно з усіма, хто проходив те саме інтерв'ю.
- Сигнали доброчесності для вашого перегляду. Друге вікно, перемкнена вкладка, додатковий монітор або відсутнє чи зайве обличчя позначаються для вашого перегляду, але ніколи не оцінюються як штраф.
Запитання: чи справді вища точність покращує результати найму?
Так. Команди, які використовують високоточні інструменти AI-оцінювання, послідовно повідомляють про:
- Кращу якість шортлиста
- Швидше узгодження з наймаючим менеджером
- Нижчу плинність на ранніх етапах
- Більш захищені кадрові рішення
Точність накопичується з кожним циклом найму, покращуючи результати поза межами окремих ролей.
Висновок
Найточніші інструменти AI-оцінювання кандидатів — це не ті, що мають найскладніші моделі, а ті, що мають послідовне оцінювання, прозорі рубрики та надійну прогнозну валідацію.
Точність така добра, як докази за нею. Запитайте кожного постачальника, проти чого валідували його оцінки, і прочитайте обґрунтування оцінки, перш ніж їй довіряти.
Готові оцінювати кандидатів із послідовною, прозорою точністю?
Спробуйте Flowmingo безкоштовно й прочитайте обґрунтування кожної оцінки.