3 Interviewer, 1 Finalist, 3 Urteile. Ohne eine Interview-Scorecard entscheidet die lauteste Stimme in Ihrem Debriefing, wer eingestellt wird.
Es gibt keinen Kandidatenbewertungsbogen, auf den man zurückgreifen kann. Also kann niemand das Stellenangebot Ihrem CEO erklären oder einem abgelehnten Kandidaten, der nachfragt.
Ohne ein gemeinsames Formular verlassen sich beschäftigte Menschen auf ihr Bauchgefühl.
Und Bauchentscheidungen sind schwächer, als sie sich anfühlen, wie Noise von Kahneman und seinen Mitautoren zeigt.
Angenommen, Sie wissen nur, dass 1 Kandidat im Interview besser abschnitt als ein anderer. Die Wahrscheinlichkeit, dass er wirklich die bessere Besetzung ist, liegt nur bei 56 % bis 61 %, kaum besser als ein Münzwurf.
Eine Scorecard behebt das mit 3 Schritten. Jeder Interviewer bewertet dieselben 4 bis 6 Kompetenzen anhand schriftlicher Beispiele, allein, vor dem Debriefing. Dann entscheidet die Gesamtpunktzahl, es sei denn, ein Muss-Kriterium ist nicht erfüllt.
Die wichtigsten Erkenntnisse
- Führt eine Scorecard wirklich zu besseren Neueinstellungen? Ja, wenn jeder Interviewer dieselben Kompetenzen anhand schriftlicher Beispiele bewertet. Interviews, die so geführt wurden, sagten die berufliche Leistung in einer Übersichtsarbeit von 2022 etwa doppelt so gut voraus wie frei geführte Interviews.
- Wie viele Kompetenzen sollte sie bewerten? 4 bis 6, jeweils auf einer Skala von 1 bis 5 mit einer schriftlichen Beispielantwort pro Stufe. Jedes Muss-Kriterium unter 3 bedeutet: keine Neueinstellung.
- Wie wähle ich zwischen 2 gleichauf liegenden Finalisten? Prüfen Sie zuerst die Muss-Kriterien und besprechen Sie dann jede 2-gegen-5-Spaltung anhand der Belege. Stimmen Sie nicht nach Gefühl erneut ab: Eine feste Formel übertraf in einer Übersichtsarbeit von 2013 die Expertenbeurteilung.
- Wie viele Interviewer brauche ich? Bis zu 4, jeder bewertet allein. In Googles eigenen Daten fügte jedes Interview nach dem 4. weniger als 1 % Genauigkeit hinzu.
- Kann ich dem KI-Score vertrauen? Nutzen Sie ihn als 1 Eingabe und lesen Sie seine Begründungen. In einer Studie von 2023 stimmte ein KI-Bewerter bei vertrauten Fragen eng mit geschulten menschlichen Bewertern überein, bei neuen Fragen dagegen kaum.
1. Hilft mir eine Interview-Scorecard tatsächlich, bessere Mitarbeiter einzustellen?
Ja, wenn jeder Interviewer dieselben Fähigkeiten anhand schriftlicher Beispiele bewertet. Strukturierte Interviews, bei denen Sie alle gleich fragen und auf dieselbe Weise bewerten, sagten die berufliche Leistung mit 0.42 voraus – mehr als das Doppelte der 0.19 von unstrukturierten.
Diese Zahlen stammen aus der grundlegenden Neuanalyse von Sackett und Kollegen aus dem Jahr 2022 zu Jahrzehnten der Einstellungsforschung: doi.org/10.1037/apl0000994.
Die Zahlen sind Korrelationen, von 0 (kein Zusammenhang mit späterer beruflicher Leistung) bis 1 (ein perfekter Zusammenhang). 0.19 bedeutet also nicht, dass unstrukturierte Interviews in 20 % der Fälle die richtige Wahl treffen. Es bedeutet, dass ihr Zusammenhang mit späterer Leistung schwach ist.
Das folgende Diagramm ordnet 6 gängige Methoden. Job-Kenntnistests mit 0.40 und kodierte Biodaten, ein bewerteter Fragebogen zum Werdegang, mit 0.38 liegen dicht dahinter.
Arbeitsproben folgen mit 0.33 und kognitive Fähigkeitstests mit 0.31. Unstrukturierte Interviews, das freie Gespräch, mit dem die meisten von uns aufgewachsen sind, stehen am Ende.
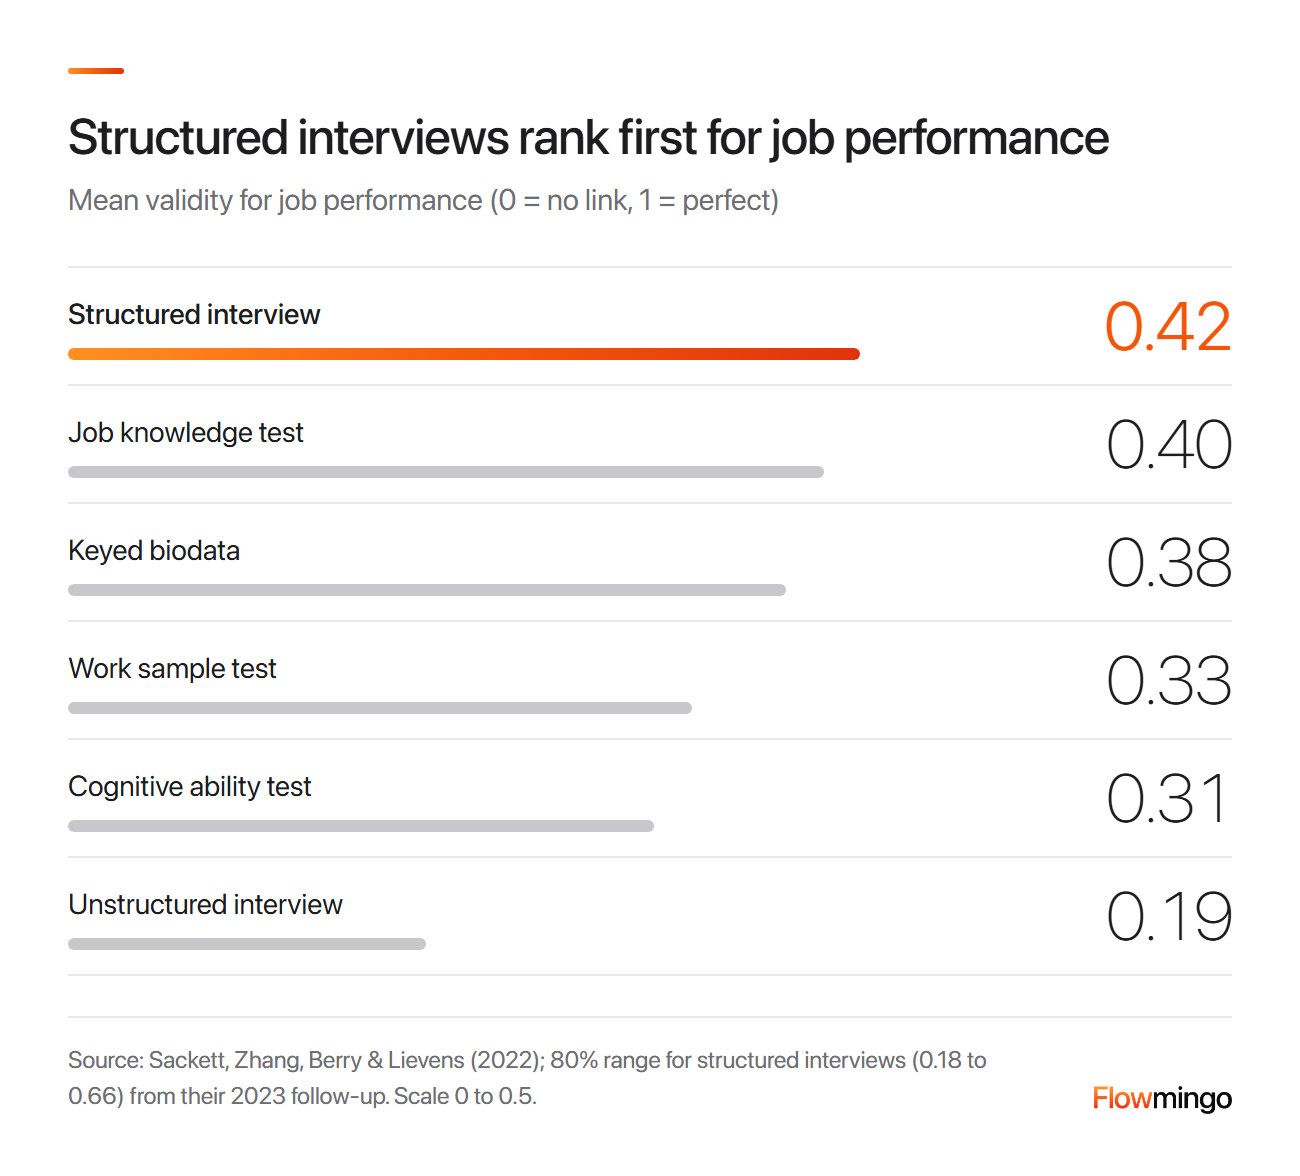
Einstellungsmethoden nach ihrem Zusammenhang mit beruflicher Leistung geordnet: Strukturierte Interviews führen mit 0.42, unstrukturierte Interviews liegen mit 0.19 zurück (grundlegende Neuanalyse von Sackett et al.).
Doch 0.42 ist ein Durchschnitt. Die Folgestudie der Autoren verortet die meisten strukturierten Interviews zwischen 0.18, nicht besser als ein freies Gespräch, und 0.66, besser als alles im Diagramm.
Das Design ist einer von 3 Gründen, die die Autoren für diese Streuung nennen. Das bedeutet: Eine Interview-Scorecard mit vagen Kompetenzen riskiert, nahe am unteren Ende zu landen. Dies sind Durchschnitte über viele Arbeitgeber, kein Versprechen für Ihre nächste Einstellung.
2. Was sollte meine Interview-Scorecard-Vorlage enthalten?
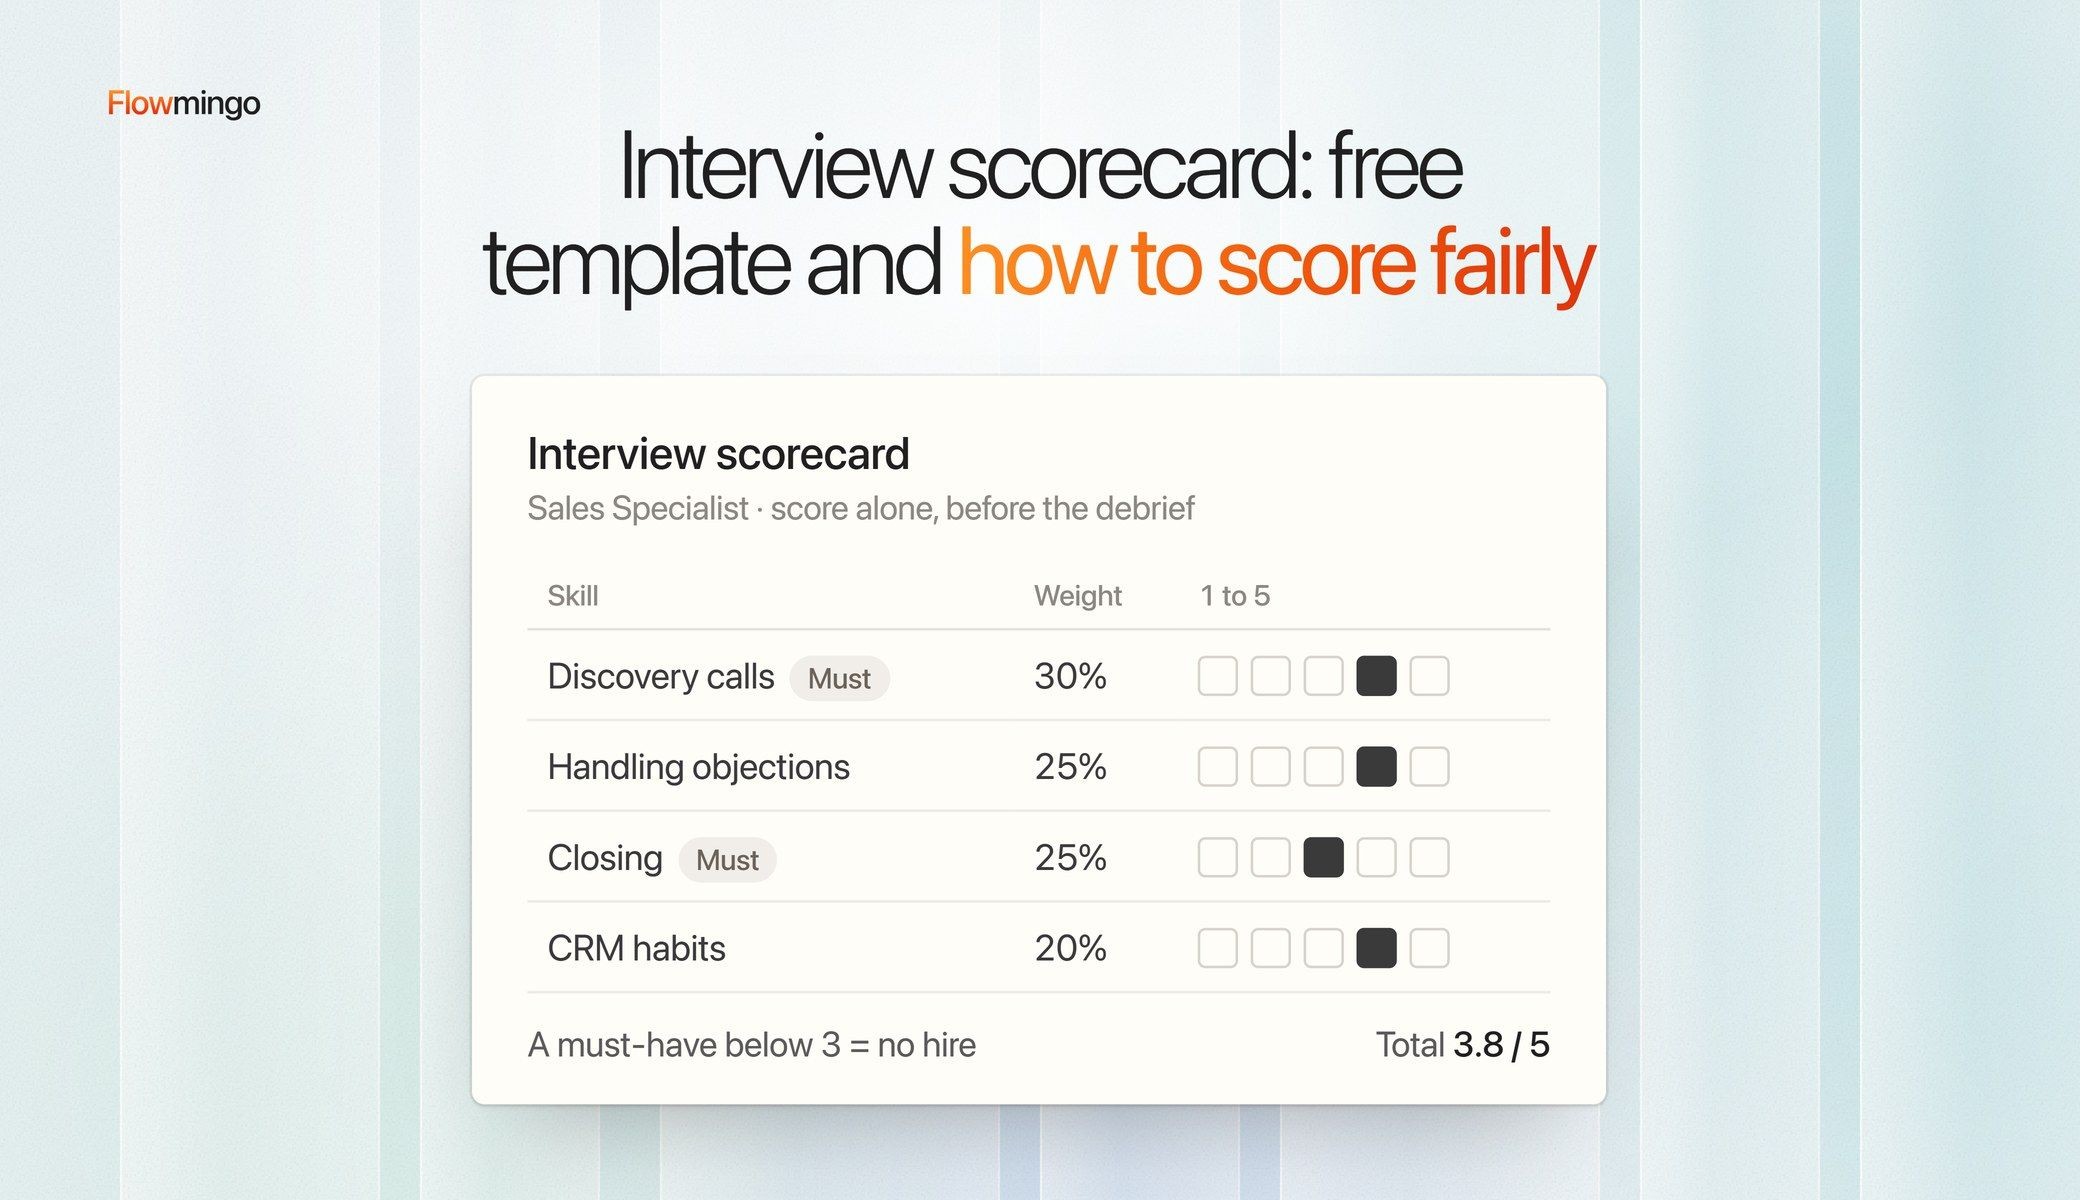
Eine Interview-Scorecard-Vorlage oder ein Bewertungsformular für Bewerber enthält 5 Fähigkeiten, schriftliche Ankerpunkte, ein Belegfeld und eine Mindestgrenze für Muss-Kriterien, alles auf 1 Seite. Sie endet mit einem Gesamteindruck und einer Empfehlung.
Die Ankerpunkte sorgen dafür, dass eine 4 bei einem Interviewer dasselbe bedeutet wie bei einem anderen, und das Belegfeld beantwortet die Frage nach dem Warum, wenn Ihr CEO nachfragt.
Die Untergrenze verhindert, dass eine starke Gesamtsumme ein schwaches Must-have verdeckt. Der Gesamteindruck kommt zuletzt, denn ein zuerst notiertes Bauchgefühl färbt jede danach vergebene Bewertung einer Kompetenz.
Hier ist dieses Formular für eine Leitung im Kundensupport mit 2 Must-haves. Jede der 5 Kompetenzen wird mit 1 bis 5 bewertet, die Gesamtsumme geht also bis 25.
Stellen Sie pro Kompetenz 2 Fragen zum vergangenen Verhalten, denn ein echtes Beispiel aus der Vergangenheit gibt Ihnen etwas Konkretes, woran Sie sich an den Ankern messen können. Zum Beispiel: „Erzählen Sie mir von dem letzten Mal, als ein verärgerter Kunde an Sie eskaliert hat.“
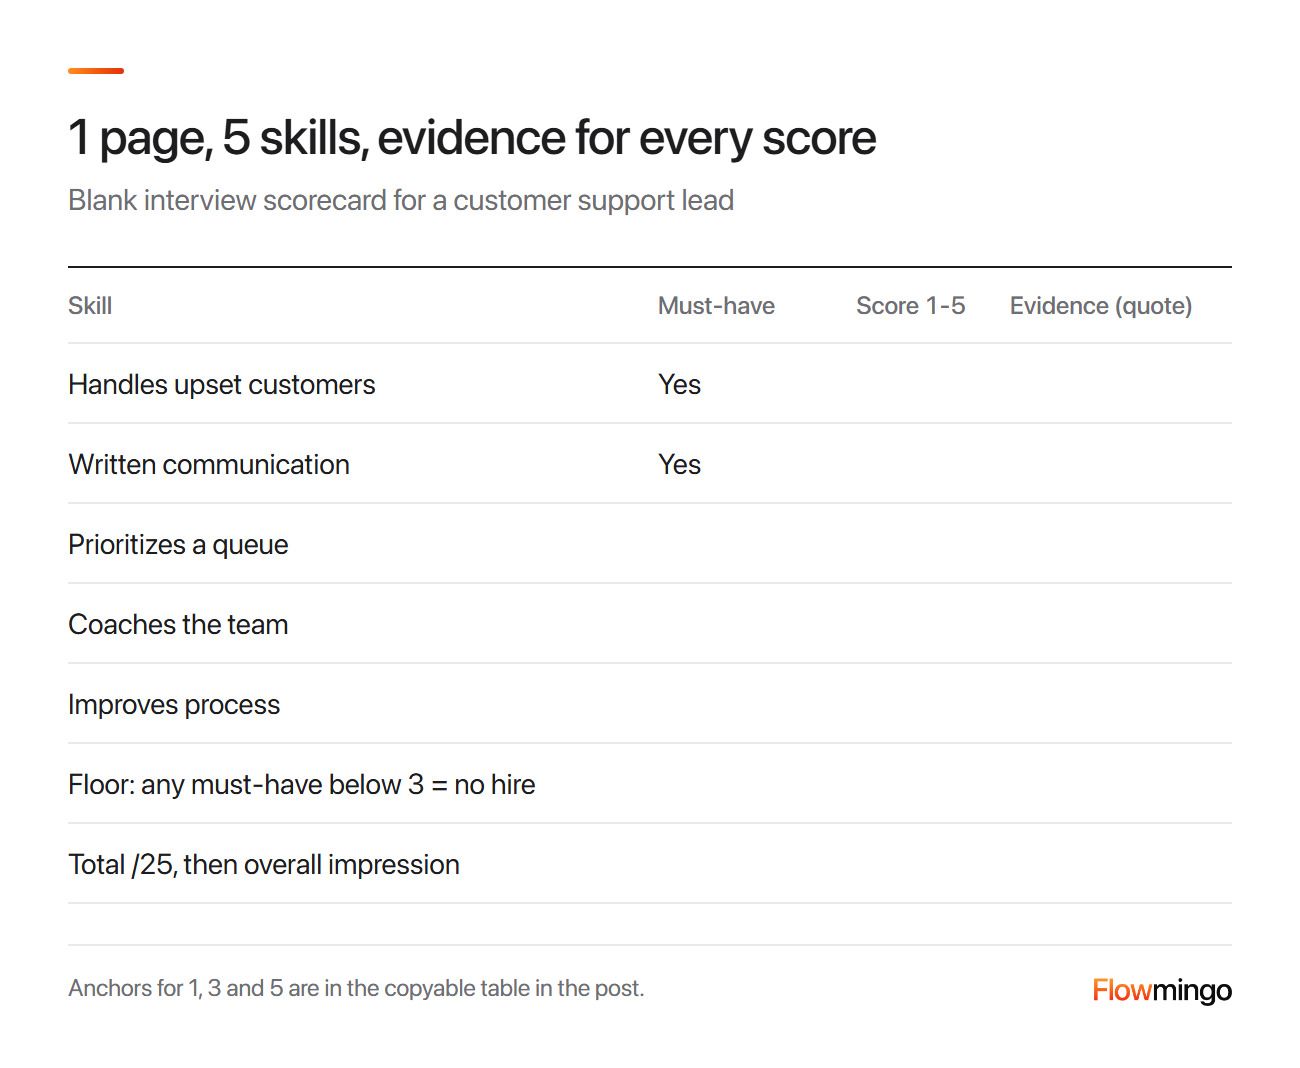
Leere Interview-Scorecard-Vorlage für eine Leitung im Kundensupport: 5 Kompetenzen, 2 Must-haves, eine Bewertung von 1 bis 5 und jeweils ein Belegzitat.
Kopieren Sie die Tabelle und ersetzen Sie dann die Kompetenzen und Anker durch Ihre eigenen.
| Kompetenz | Anker für 1 / 3 / 5 | Bewertung 1-5 | Beleg (Zitat) |
|---|---|---|---|
| Kopfzeile | Kandidat, Rolle, Interviewer, Datum | ||
| Geht mit verärgerten Kunden um (Must-have) | Gibt dem Kunden die Schuld / wendet die Richtlinie an / behebt die Ursache | ||
| Schriftliche Kommunikation (Must-have) | Unklar / klar, aber lang / kurz und klar | ||
| Priorisiert eine Warteschlange | Keine Methode / nach Dringlichkeit / nach Auswirkung | ||
| Coacht das Team | Kein Beispiel / gibt Tipps / legt einen Plan fest | ||
| Verbessert Prozesse | Kein Beispiel / schlägt eine Lösung vor / setzt einen Fix um | ||
| Must-have-Untergrenze | Jedes Must-have unter 3 bedeutet keine Einstellung | ||
| Nicht bewertet | Emotionen, abgelesen an Gesicht, Stimme oder Tippverhalten; Akzent oder Tempo, außer die Stelle erfordert es; Kulturpassung | ||
| Gesamtsumme | Summe der 5 Bewertungen, von 25 | ||
| Gesamteindruck | 1 bis 5, zuletzt ausgefüllt | ||
| Empfehlung | Eindeutig einstellen / einstellen / nicht einstellen / eindeutig nicht einstellen; eine Abweichung erfordert eine schriftliche Begründung |
2.1 Was sollte ich entscheiden, bevor ich sie aufbaue?
Definieren Sie zuerst den Erfolg in der Rolle und wählen Sie dann die Kompetenzen aus, die ihn bewirken. Fixieren Sie die Interview-Scorecard, bevor der erste Lebenslauf eintrifft.
Diese Reihenfolge stammt aus Who, von Geoff Smart und Randy Street. Schreiben Sie 1 Mission in einer Zeile, dann 3 bis 8 nach Wichtigkeit geordnete Ergebnisse und dann 4 bis 6 Kompetenzen. Ein Ergebnis ist ein messbares Resultat, etwa den Umsatz bis zum 3. Jahr von $25 Millionen auf $50 Millionen zu steigern, und keine Aktivität.
Das Fixieren ist wichtig, weil Menschen Kriterien unbemerkt verbiegen. In den grundlegenden Studien von Uhlmann und Cohen (2005) beurteilten die Teilnehmenden einen straßenerprobten und einen hochgebildeten Bewerber für das Amt des Polizeichefs.
Welche Stärke der Mann auch besaß, sie entschieden, dass die Stelle sie stärker benötigte, und die Frau erhielt keinen vergleichbaren Vorteil. Die Festlegung auf die Kriterien, bevor die Bewerbenden gesehen wurden, beseitigte diese Verzerrung. Eine Scorecard, die erst nach dem Treffen mit den Kandidaten geschrieben wird, kann sich also unbemerkt zu der Person hin verbiegen, die man bereits mag.
2.2 Sollte Culture Fit auf dem Bewertungsbogen stehen?
Nicht in dieser Form, denn niemand kann es zweimal auf dieselbe Weise bewerten. Machen Sie daraus 1 oder 2 beobachtbare Verhaltensweisen, etwa „bittet um Feedback zur eigenen Arbeit“.
Wenn Ihr Team Offenheit schätzt: Bewerten Sie stattdessen „hat ein konkretes Beispiel dafür genannt, einen Fehler frühzeitig gemeldet zu haben“.
3. Wie gewichte ich Interview-Bewertungen, damit die Must-haves am stärksten zählen?
Geben Sie jeder Fähigkeit das gleiche Gewicht und fügen Sie eine Mindestgrenze für Must-haves hinzu, oder legen Sie die Gewichte vor dem ersten Interview fest. Gleiche Gewichte liefern bei neuen Fällen oft genauso gute Vorhersagen wie an vergangene Daten angepasste Gewichte.
Der zweite Punkt stammt von dem Psychologen Robyn Dawes, wie Kahneman ihn in Schnelles Denken, langsames Denken zusammenfasst.
An Ihre früheren Einstellungen angepasste Gewichte lernen auch die Zufälle dieser Gruppe. Angenommen, Ihre 3 besten im Support eingestellten Mitarbeiter waren zufällig alle starke Coaches: Ein darauf abgestimmtes Gewicht würde Coaching bei jedem künftigen Kandidaten bevorzugen.
Gleiche Gewichte können einem solchen Zufall nicht hinterherjagen, weshalb sie bei neuen Kandidaten oft genauso gute Vorhersagen liefern. Halten Sie die Fähigkeiten ebenfalls unabhängig, wie Kahneman rät: Führen Sie nicht sowohl „Kommunikation“ als auch „Präsentationsfähigkeiten“ auf, denn zusammen zählen sie dasselbe doppelt.
Ein Must-have erhält seine Durchschlagskraft durch die Mindestgrenze, nicht durch ein größeres Gewicht. Angenommen, „Geht mit verärgerten Kunden um“ erhält 2 Punkte und jede andere Fähigkeit 5 Punkte.
Die Gesamtsumme von 22 von 25 sieht großartig aus, doch die Mindestgrenze verlangt dennoch, nicht einzustellen. Genau das wollen Sie bei einer Fähigkeit, ohne die die Stelle nicht auskommt.
Wenn Sie gewichten, schreiben Sie die Gewichte vorab auf den Interview-Bewertungsbogen und wenden Sie sie auf alle an. Das schließt den einfachsten Weg aus, eine Gesamtsumme zu manipulieren: die Gewichte zu ändern, nachdem Sie jemanden getroffen haben, der Ihnen gefällt.
Wie Flowmingo hilft
Der KI-Interviewbericht von Flowmingo verwendet feste Gewichte: Ein Must-have-Kriterium zählt in der Gesamtbewertung 4-mal so viel wie ein Good-to-Have-Kriterium. Jedes Kriterium behält seine eigene Bewertung von 0 bis 10, sodass Sie weiterhin selbst eine Mindestgrenze für Must-haves anwenden können.
4. Wie erreiche ich, dass eine 3 für jeden Interviewer dasselbe bedeutet?
Legen Sie vor dem ersten Interview fest, was eine Antwort mit 1, 3 und 5 für jede Kompetenz enthält. Diese verhaltensverankerte Bewertungsskala macht die Bewertungen von 2 Interviewern vergleichbar.
„Verhaltensverankert“ bedeutet nur, dass jede Bewertung daran gebunden ist, was der Kandidat getan hat, und nicht an ein Gefühl wie „ziemlich gut“. Ohne Anker bedeutet eine 3 auf demselben Interview-Bewertungsbogen für 1 Interviewer „in Ordnung“ und für einen anderen „schwach“.
Verankerte Interviews zeigen außerdem stärkere durchschnittliche Zusammenhänge mit späterer Leistung. Die grundlegende Übersicht von Taylor und Small über 19 Studien zu Interviews über vergangenes Verhalten ergab einen Zusammenhang von .35 bei verankerten Skalen, gegenüber .26 ohne. Die Studien unterschieden sich auch in anderer Hinsicht, daher isoliert dieser Vergleich nicht den Effekt des Hinzufügens von Ankern.
Hier ist die Interview-Bewertungsskala für die unverzichtbare Kompetenz „Geht mit verärgerten Kunden um“.
| Punktzahl | Was die Antwort enthält |
|---|---|
| 1 | Gibt dem Kunden die Schuld; keine eigene Handlung und kein Ergebnis |
| 3 | Ein echtes Beispiel: beruhigt den Kunden und wendet die Richtlinie an, prüft aber nie das Ergebnis |
| 5 | Ein echtes Beispiel: findet die Ursache, behebt sie, hakt nach und teilt die Lösung |
Jede Stufe nach oben ist etwas, das man in der Antwort hören kann. Deshalb können 2 Zuhörer bei derselben Zahl landen.
Wenn Sie noch keine Anker formulieren können, übernehmen Sie die 5 Stufen aus dem Leitfaden für strukturierte Interviews von OPM, der US-Bundesbehörde für Personalwesen. Jede Stufe richtet sich danach, wie schwierig die Situation war und wie viel Anleitung die Person brauchte.
- 1, Bewusstsein: die einfachsten Situationen, mit enger und umfassender Anleitung.
- 2, Grundlegend: etwas schwierige Situationen, mit häufiger Anleitung.
- 3, Mittelstufe: schwierige Situationen, mit gelegentlicher Anleitung.
- 4, Fortgeschritten: deutlich schwierige Situationen, mit wenig oder keiner Anleitung.
- 5, Experte: außergewöhnlich schwierige Situationen, in denen die Person andere berät.
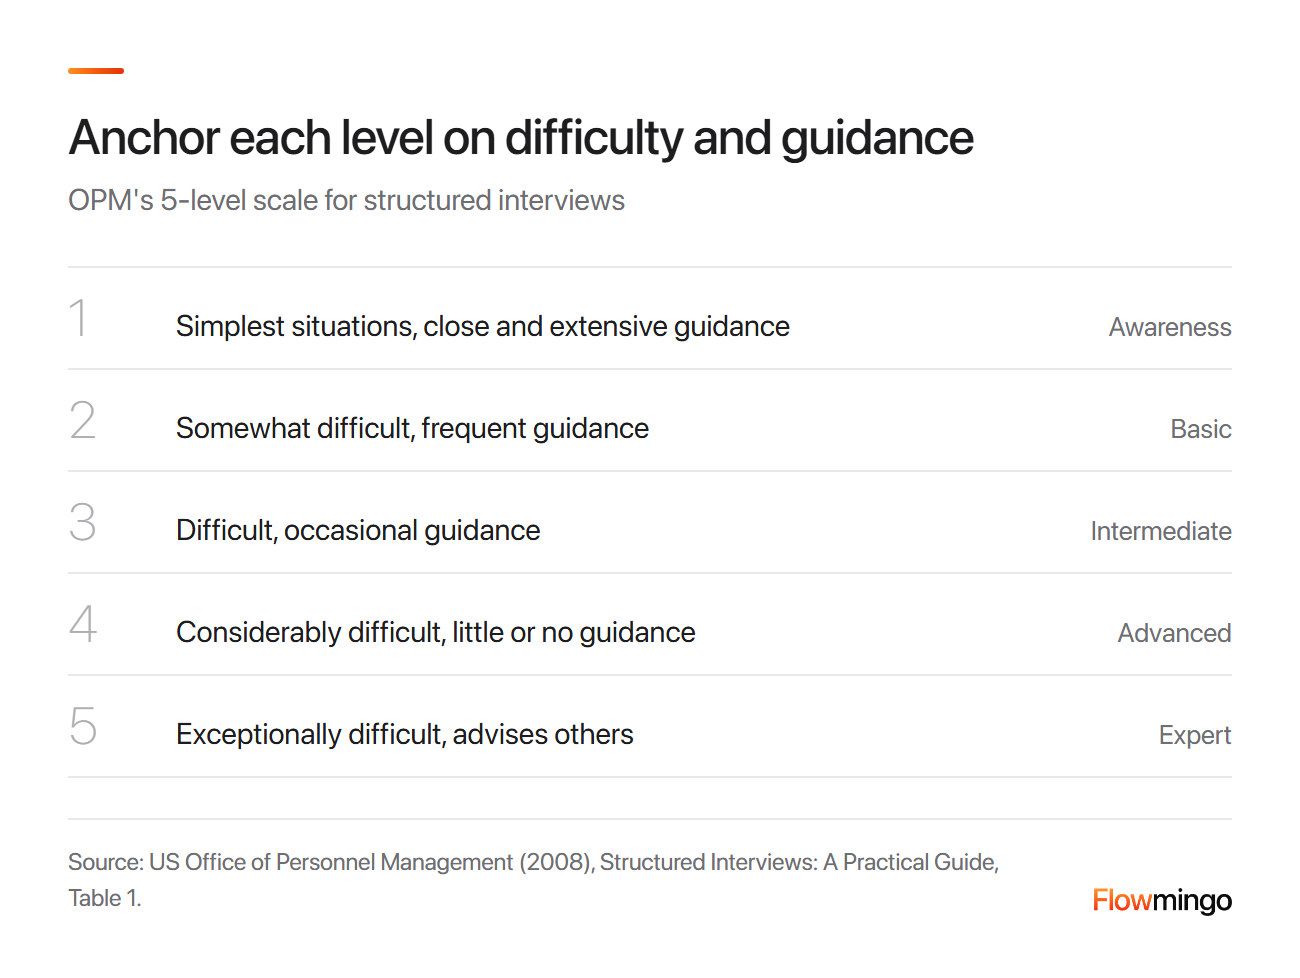
Die 5 Bewertungsstufen von OPM für strukturierte Interviews: von Bewusstsein (einfachste Situationen, enge Anleitung) bis Experte (außergewöhnlich schwierige Situationen, berät andere).
5. Wie wähle ich zwischen 2 starken Finalisten, wenn meine Interviewer uneinig sind?
Lass die Summe der Interview-Scorecard entscheiden, mit 2 Ausnahmen: ein Muss-Kriterium unter 3 oder eine 2-gegen-5-Spaltung, die du anhand der Belege im Debrief klärst. Stimme nicht aus dem Bauch heraus erneut ab.
Dies ist der Moment, für den Scorecards gemacht sind – und der Moment, in dem es am verführerischsten ist, sie wegzulassen. Hier ein veranschaulichendes Beispiel, keine Kundendaten: 3 Finalistinnen und Finalisten für eine Support-Leitung, jede Zelle über 3 Interviewer hinweg gemittelt.
| Fähigkeit | A | B | C |
|---|---|---|---|
| Umgang mit verärgerten Kunden (Muss-Kriterium) | 4 | 2 | 4 |
| Schriftliche Kommunikation (Muss-Kriterium) | 4 | 4 | 3 |
| Priorisiert eine Warteschlange | 3 | 4 | 3 |
| Coacht das Team | 3 | 4 | 4 (Bewertungen 2, 5, 5) |
| Verbessert Prozesse | 4 | 4 | 3 |
| Gesamt, von 25 | 18 | 18 | 17 |
| Entscheidung | Einstellen | Nicht einstellen: Mindestgrenze greift | Spaltung im Debrief klären |
Lies die Interview-Scorecard Zeile für Zeile. A und B liegen mit 18 von 25 gleichauf. B hat jedoch bei einem Muss-Kriterium eine 2 erzielt, also greift die Mindestgrenze und B wird nicht eingestellt.
C kommt auf 17, doch der Durchschnitt von 4 bei „Coacht das Team“ verdeckt eine Spaltung: 1 Interviewer gab eine 2, die anderen 2 gaben eine 5. Diese Diskrepanz wird der einzige Tagesordnungspunkt des Debriefs.
In der Praxis bittest du beide Seiten, ihre Belegzitate vorzulesen. Angenommen, die Person mit der niedrigen Bewertung hörte von einem Teammitglied, das gekündigt hat, und die anderen hörten von einem Coaching-Plan, der funktioniert hat. Der Debrief entscheidet, welche Geschichte typischer für C ist, und wer Belege übersehen hat, ändert die Bewertung schriftlich.
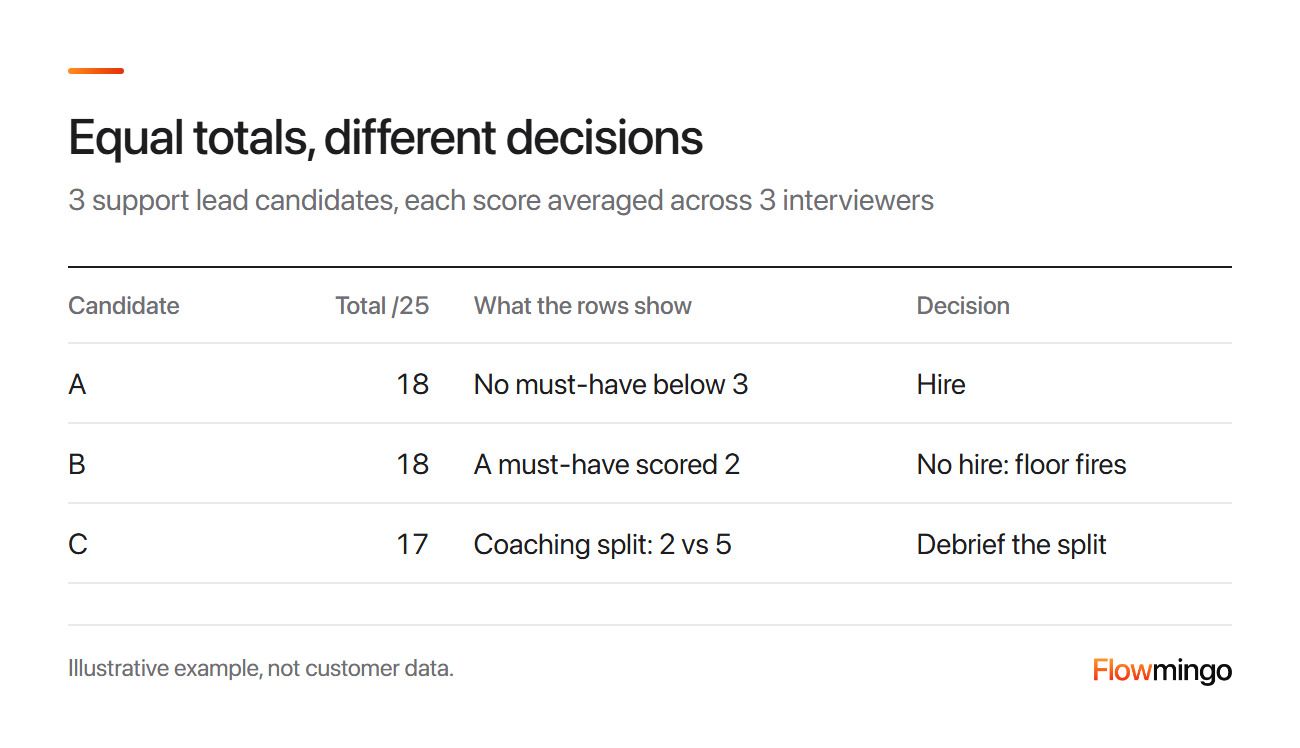
Ausgefüllte Interview-Scorecard, veranschaulichend: A und B liegen mit 18 von 25 gleichauf, B verfehlt ein Muss-Kriterium, und bei C gibt es eine Coaching-Spaltung, die im Debrief geklärt werden muss.
Sobald die Bewertungen eine Finalistin oder einen Finalisten auswählen, schreibst du die Bedingungen ins Angebot, bevor du es versendest: Unsere Vorlage für das Arbeitsangebot zeigt, wo welche Prüfung hingehört.
5.1 Was, wenn mein Bauchgefühl etwas anderes sagt als die Bewertungen?
Halte dich an die Bewertungen, es sei denn, du kannst die Belege aufschreiben, die ihnen entgangen sind. In der grundlegenden Metaanalyse von Kuncel und Kollegen aus dem Jahr 2013 sagte eine Formel, die bei allen gleich angewendet wurde, die berufliche Leistung mit 0,44 voraus – gegenüber 0,28 bei ganzheitlicher Beurteilung. Die Autoren nennen das eine Verbesserung der Vorhersage um mehr als 50 %, selbst gegenüber Expertinnen und Experten, die den Job kannten.
Ganzheitliche Beurteilung bedeutet, dass Menschen dieselben Fakten im Kopf gegeneinander abwägen – auch in Konsensmeetings. Der Debrief schließt also Beleglücken und stimmt nicht erneut ab.
5.2 Sollte ich Finalisten direkt nebeneinander vergleichen?
Ja, Antwort für Antwort. Bohnets HBR-Rat lautet, alle Antworten auf Frage 1 zu vergleichen, dann die auf Frage 2, sodass Sie jede Antwort im Vergleich zu den anderen beurteilen.
In einer grundlegenden Laborstudie aus dem Jahr 2016 neigten Personen, denen jeweils 1 Kandidat gezeigt wurde, zu dem Geschlecht, das das Stereotyp der Aufgabe begünstigte. Die frühere Leistung spielte kaum eine Rolle. Wurden ihnen 2 Seite an Seite gezeigt, wählten sie in 54 % der Fälle die leistungsstärkere Person und in 8 % die leistungsschwächere.
Die Studie stützte sich auf frühere Aufgabenbewertungen, nicht auf Interviews, daher sollten Sie sie als starken Hinweis und nicht als Beweis verstehen.
6. Wie verhindere ich, dass der lauteste Interviewer die Nachbesprechung dominiert?
Lassen Sie jeden Interviewer seinen Interview-Bewertungsbogen einreichen, bevor jemand spricht, und eröffnen Sie die Nachbesprechung dann mit den Bewertungen.
Sagt eine ranghöhere Person als Erstes „Ich fand sie großartig“, beginnt die Runde, zu dieser Sichtweise abzudriften. Allein geschriebene Bewertungen schützen alle vor dieser Sogwirkung, weshalb Noise unabhängige Bewertung zur Einstellungsregel macht.
Erfassen Sie die Bewertungen in der Praxis in einer gemeinsam genutzten Tabelle oder Ihrem Applicant-Tracking-System und zeigen Sie sie alle auf einmal an.
Ein Panel, bei dem alle dasselbe Interview sehen, wirkt wie eine Lösung. In der grundlegenden Metaanalyse von Huffcutt und Kollegen aus dem Jahr 2013 lag die Übereinstimmung der Panel-Bewerter auf einer Skala von 0 bis 1 bei 0,74, gegenüber 0,44 bei getrennten Interviews.
Diese Zahl schmeichelt Panels. Panelmitglieder bewerten alle dieselbe Leistung am selben Tag, sodass sie es alle merken, wenn der Kandidat einen ungewöhnlich guten oder schlechten Morgen hatte.
Wie Iris Bohnet in einem Vortrag bei Google sagte: „Die Stichprobengröße eines Panel-Interviews ist im Grunde eins“. Getrennte Interviews, jeweils einzeln bewertet, liefern Ihnen mehr unabhängige Eindrücke.
6.1 Wie viele Interviewer sollten jeden Kandidaten bewerten?
Bis zu 4, in getrennten Interviews. In Googles internen Daten – keine peer-reviewte Studie – sagten 4 Interviews die Einstellungsentscheidung mit 86% Konfidenz voraus. Jedes weitere trug weniger als 1% zur Vorhersage bei.
Zusätzliche Interviews trugen wenig zur Vorhersage von Googles eigener Einstellungsentscheidung bei. Nutzen Sie das als Anlass, jede Runde zu begründen – nicht als allgemeingültiges Maximum oder als Beleg für die spätere Arbeitsleistung.
7. Wie bringe ich vielbeschäftigte Interviewer dazu, den Interview-Bewertungsbogen tatsächlich auszufüllen?
Machen Sie das Bewerten zum Teil des Interviews. Bewerten Sie jede Kompetenz direkt nach den zugehörigen Fragen, notieren Sie ein einzeiliges Zitat als Beleg und geben Sie den Gesamteindruck zuletzt ab.
Niemand will nach einem Tag voller Interviews noch ein weiteres Formular ausfüllen. Deshalb wird direkt im Interview bewertet und nicht als Hausaufgabe für den Abend.
Kahneman entwickelte diese Methode 1955 für die israelische Armee, nachdem sich frei geführte Interviews als nahezu nutzlos für die Vorhersage des Erfolgs erwiesen hatten. Interviewer bewerteten 6 Eigenschaften auf einer Skala von 1 bis 5 und schlossen jede Bewertung ab, bevor sie die nächste begannen, sodass ein erster Eindruck die übrigen nicht beeinflussen konnte.
Erst dann schlossen sie die Augen und gaben eine Gesamtbewertung ab, und die Gesamtsumme sagte deutlich genauer voraus als zuvor. Sein Rat: Stellen Sie die Person mit der höchsten Gesamtsumme ein, „auch wenn Ihnen jemand anderes besser gefällt“.
Auch das Timing spielt eine Rolle. In einer Feldstudie berichteten 166 Interviewer, wann sie sich entschieden hatten. Nur 4.9% der Entscheidungen fielen in der ersten Minute, aber 22.5% fielen nach dem Ende des Interviews.
Eine Entscheidung, die erst nach dem Gehen des Kandidaten getroffen wird, beruht auf Erinnerung – bewerten Sie daher laufend.
Für unsere Support-Leitung sieht das so aus:
- Stellen Sie die 2 Fragen zur Warteschlange und bewerten Sie dann „Priorisiert eine Warteschlange“, bevor Sie fortfahren.
- Notieren Sie 1 Zitat als Beleg, zum Beispiel „Ich sortiere Bugs danach, wie viele Kunden sie betreffen.“
- Behalten Sie für jeden Kandidaten dieselbe Reihenfolge der Kompetenzen bei.
Schriftliche Belege sind in unseren Daten selten.
Flowmingo-Daten · 86,638 mit KI interviewte Kandidaten · 2,574 Unternehmen · Juli 2025 bis Sep. 2026
- 0.3% der mit KI interviewten Kandidaten erhielten einen schriftlichen Kommentar vom Hiring-Team (258 von 86,638).
Teams führen Notizen möglicherweise an anderer Stelle; innerhalb von Flowmingo ist der KI-Bericht in der Regel die einzige schriftliche Bewertung in den Unterlagen.
Eine schriftliche Begründung ist das Erste, was an einem hektischen Tag übersprungen wird. Deshalb verlangt das Formular nur 1 Zitat pro Kompetenz.
8. Kann ich einer KI-Bewertung auf meiner Interview-Scorecard vertrauen?
Nutzen Sie sie als 1 Eingabe, die eine Person prüft, und lesen Sie zuerst die Begründungen. Die KI-Bewertung kann bei Fragen, für die sie nicht trainiert wurde, stark abfallen.
Wir haben ein Eigeninteresse an dieser Antwort, deshalb umfasst die folgende Evidenz auch den Teil, der KI nicht schmeichelt.
In einer grundlegenden Studie aus dem Jahr 2023 bewerteten 2 geschulte Beurteiler 7,017 Antworten von Bewerbern auf einer verankerten Skala von 1 bis 5. Ein Modell, das auf denselben Fragen trainiert wurde, erreichte eine enge Übereinstimmung mit ihren Bewertungen, mit 0.75 auf einer Skala von 0 bis 1. Bei Frageformaten, die es nie gesehen hatte, fiel es auf 0.30 ab, eine schwache Übereinstimmung.
Das bedeutet, eine KI-Bewertung ist nur so gut wie ihr fragespezifisches Bewertungsraster, lesen Sie also ihre Begründungen, bevor Sie der Zahl vertrauen. Beachten Sie außerdem, dass 3 der 5 Autoren dieser Studie beim KI-Interview-Anbieter Modern Hire arbeiteten.
Wie Flowmingo hilft
Flowmingo's AI Interviewer bewertet anhand von Kriterien, die Sie freigeben. Die KI entwirft die Fragen und Kriterien aus Ihrer Stellenbeschreibung, und Sie bearbeiten beides. Sie senden jedem Bewerber das Interview, das er zu einem selbst gewählten Zeitpunkt absolviert.
Sie erhalten die Aufnahme, das Transkript und jedes Kriterium mit einer Bewertung von 0 bis 10 samt schriftlicher Begründung zurück. Die Einstellungsentscheidung treffen Sie.
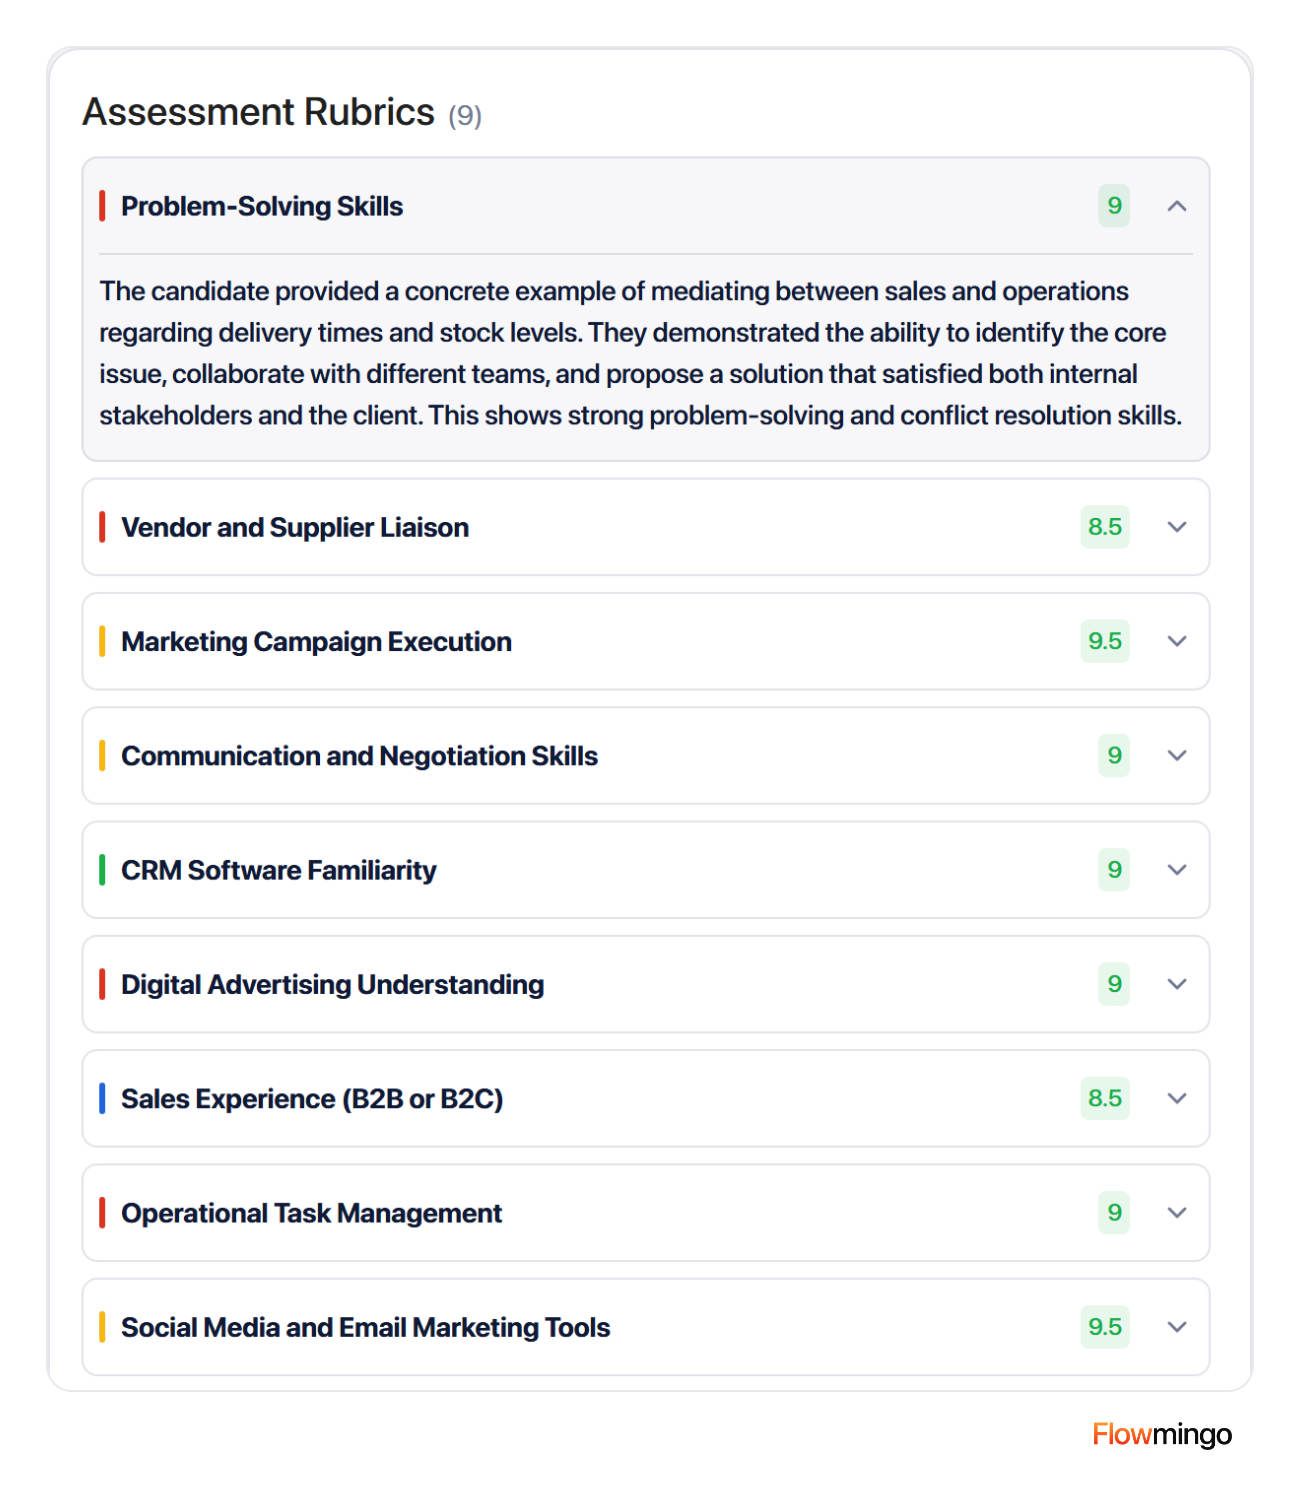
Flowmingos öffentlicher Beispielbericht: eine Bewertung von 0 bis 10 und eine Begründung pro Kriterium, legen Sie also etwaige Muss-Schwellenwerte auf dieser Skala fest.
In unseren Daten sind sich Lebenslauf und Interview auch darüber uneinig, wer am besten ist.
Flowmingo-Daten · 34,114 Kandidaten · 379 Unternehmen · Juli 2025 bis Sep. 2026
- 19.2% der 532 Projekte mit 1 klaren Spitzenbewertung im Interview gaben diesem Kandidaten auch die höchste Bewertung im Lebenslauf.
- 54.9% der 3,684 Kandidaten, die im Interview 8 oder mehr erreichten (2,022), wären durch eine Top-20%-Shortlist nach Lebenslauf aussortiert worden.
Beides sind Flowmingo-KI-Bewertungen, keine Arbeitsleistung, und die Interviewten sind eine ausgewählte Gruppe. Die Daten zeigen, dass die 2 Ranglisten voneinander abweichen, nicht, welche richtig ist.
Einfach gesagt: In etwa 4 von 5 dieser Projekte hatte die Person mit der besten Interviewbewertung nicht auch die beste Lebenslaufbewertung. Bewerten Sie das Interview daher für sich, statt die Lebenslaufbewertung zu übernehmen.
9. Schützen mich meine Bewertungsbögen, wenn sich ein abgelehnter Kandidat beschwert?
Sie helfen, wenn sie berufsbezogene Belege bewerten und Sie sie aufbewahren. Bei vernünftiger Auslegung bedeuten die US-Bundesvorschriften, dass Bewertungsbögen mindestens 1 Jahr aufzubewahren sind, und die kalifornischen Vorschriften 4 Jahre.
Eine Beschwerde kann Monate später eintreffen, wenn sich niemand mehr an das Interview erinnert. Ein Interview-Bewertungsbogen mit einem Zitat pro Kompetenz zeigt, was Sie bewertet haben und warum.
Die US-Vorschrift nennt Bewertungsbögen nicht ausdrücklich, erfasst aber „andere Unterlagen im Zusammenhang mit der Einstellung“. Sobald jemand eine Diskriminierungsbeschwerde einreicht, bewahren Sie jede relevante Unterlage auf, bis das Verfahren endet. Das schließt die Unterlagen anderer Kandidaten für dieselbe Stelle ein, sodass eine einzige Beschwerde den gesamten Bestand einfriert.
Diese Regeln gelten mit Stand September 2026. Dies ist eine Zusammenfassung, keine Rechtsberatung.
| Regel | Wo | Was sie für Ihren Bewertungsbogen bedeutet |
|---|---|---|
| 29 CFR 1602.14 | USA | Einstellungsunterlagen 1 Jahr aufbewahren, nach einer Beschwerde länger |
| 2 CCR 11013(c) | Kalifornien | Unterlagen 4 Jahre aufbewahren, einschließlich Daten automatisierter Entscheidungen |
| ICO-Leitlinie | Vereinigtes Königreich | Kandidaten können Interviewnotizen anfordern; legen Sie jede Regel zur Entscheidung bei Gleichstand offen |
| TAFEP | Singapur | Ein Bewertungsformular verwenden und Unterlagen mindestens 1 Jahr aufbewahren |
| 29 CFR 1630.11 (ADA) | USA | Wenn eine Behinderung das Sprechen beeinträchtigt, bewerten Sie die Kompetenz, nicht das Sprechen, es sei denn, Sprechen ist für die Stelle erforderlich |
| AI Act, Artikel 5(1)(f) | EU, seit 2. Februar 2025 | Keine KI, die aus Gesichtern, Körperhaltung oder Tastatureingaben auf Emotionen von Kandidaten schließt |
| AI Act, Anhang III und Artikel 26 | EU, ab 2. Dezember 2027 | Hochrisiko: menschliche Aufsicht, Protokolle mindestens 6 Monate aufbewahren, Kandidaten informieren |
| Local Law 144 | New York City | Ein KI-Score, der allein verwendet, höher gewichtet als alles andere oder dazu verwendet wird, Menschen zu überstimmen: jährliche Prüfung auf Voreingenommenheit und Benachrichtigung |
| AI Video Interview Act | Illinois | Zuerst Mitteilung, Erklärung und Einwilligung; Videos innerhalb von 30 Tagen nach einer Anfrage löschen |
Deshalb enthält die Vorlage eine Zeile „Nicht bewertet“. Die EU verbietet KI, die aus Gesichtern, Körperhaltung oder Tastatureingaben Emotionen von Kandidaten abliest, und das US-Behindertengesetz (ADA) schützt Kandidaten, deren Behinderung das Sprechen beeinträchtigt. Im Vereinigten Königreich können Kandidaten Ihre Notizen anfordern; formulieren Sie daher jede Belegzeile so, als würden sie sie lesen.
Vergleichen Sie für eine Selbstprüfung die Bestehensquoten nach Gruppe anhand der 4/5-Faustregel in den Uniform Guidelines. Angenommen, 30 % einer Gruppe bestehen und 50 % einer anderen: 30 geteilt durch 50 ergibt 0,6, unter 0,8, also schauen Sie genauer hin.
Eine Stellungnahme des Justizministeriums vom Juni 2026 und eine OPM-Regel vom Juli 2026 entfernen Bundesbehörden von den Guidelines. Sie stehen jedoch weiterhin in den Bundesvorschriften, betrachten Sie die Prüfung daher als kostengünstige Routine, nicht als rechtliche Grenze.
10. Wie führe ich diese Woche einen Interview-Bewertungsbogen mit meinem Team ein?
Bauen Sie ihn in dieser Reihenfolge auf und ändern Sie ihn nur zwischen Stellen. Eine erste Version muss nicht perfekt sein, aber sie muss für jeden Kandidaten gleich sein.
- Formuliere 1 Satz zur Mission und 3 bis 8 nach Rangfolge geordnete Ergebnisse.
- Übersetze sie in 5 Kompetenzen und markiere die Muss-Kriterien.
- Formuliere 2 Fragen zum vergangenen Verhalten und Anker für 1, 3 und 5 pro Kompetenz.
- Lass bis zu 4 Interviewer unabhängig bewerten und vor dem Debriefing abgeben.
- Lass die Gesamtpunktzahl entscheiden, aber jedes Muss-Kriterium unter 3 bedeutet keine Einstellung. Halte jede Ausnahme schriftlich fest.
Beginne in der Praxis mit 1 offenen Stelle, damit dein Team die Routine an etwas Realem lernt. Lass vor dem ersten Interview alle dieselbe Beispielantwort bewerten und die Bewertungen vergleichen.
Wenn 2 Bewertungen mehr als 1 Punkt auseinanderliegen, formuliere den Anker neu, bis sie übereinstimmen. Die geschulten Beurteiler in der Studie in Abschnitt 8 nutzten dieselbe 1-Punkt-Differenz, um eine Besprechung anzusetzen.
Rechne mit etwas Widerstand. Auch Kahnemans Interviewer bei der Armee wehrten sich dagegen, nur Antworten festzuhalten, und seine Lösung war die Bewertung mit geschlossenen Augen, die ihrem Urteil einen Platz auf dem Formular gab. Deine Zeile für den Gesamteindruck leistet das für dein Team.
So hilft Flowmingo
Wenn du jedem Bewerber ein strukturiertes Interview schicken möchtest, das er in eigener Zeit absolviert, aufgezeichnet und anhand von 1 Interview-Scorecard bewertet wird, probiere Flowmingo.
11. Quellen
Jede oben genannte externe Zahl stammt aus den unten aufgeführten Quellen, in der Reihenfolge ihres Erscheinens. Flowmingos eigene Zahlen stehen in den Datenboxen, Juli 2025 bis September 2026.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.