C’est vendredi, et votre outil de feedback d’entretien candidat contient 1 grille d’évaluation, alors que 4 personnes ont rencontré votre finaliste. Elle indique « bonne adéquation culturelle ».
Vous n’avez pas besoin d’un autre formulaire. Vous avez besoin de preuves.
Vos évaluateurs ne sont pas paresseux. La plupart des outils de feedback d’entretien demandent une opinion à la fin d’une journée chargée, et le débrief récompense celui qui parle en premier.
Des notes vagues coûtent plus que du temps. Dans une étude fondatrice sur la prédiction des notes, les prédictions faites après un entretien libre correspondaient aux notes réelles deux fois moins étroitement que celles faites sans entretien. Les grilles d’évaluation tardives font aussi patienter le finaliste, et 61 % des demandeurs d’emploi (Greenhouse, 2024) déclarent qu’un employeur ne leur a plus donné signe de vie après un entretien.
La correction se fait en 3 étapes. Premièrement, chaque évaluateur note chaque critère avec 1 citation juste après l’entretien, et soumet sa grille dans les 24 heures. Deuxièmement, chaque score est saisi avant le débrief.
Troisièmement, une règle fixe combine les scores, et vous ne discutez que des écarts.
Points clés
- Par quel outil de feedback d’entretien candidat commencer ? Celui qui corrige votre défaillance. Chacun des 5 types corrige une défaillance différente, et un débrief bruyant a besoin d’un processus.
- Qu’est-ce qui rend un feedback d’entretien exploitable ? Une note sur chacun des 4 à 6 critères convenus, 1 citation par note, et la recommandation en dernier.
- La notation structurée des entretiens prédit-elle la performance au travail ? Oui. Une vaste réanalyse l’a classée 1re, devant les tests d’aptitude.
- Le panel doit-il décider ensemble lors du débrief ? Pas en premier. Une règle fixe a prédit la performance plus de 50 % mieux qu’un jugement global.
- L’IA peut-elle rédiger ou noter un feedback d’entretien ? L’IA peut mettre en forme la formulation, pas ajouter de preuves. Ne faites confiance à un rapport d’entretien généré par IA que s’il passe les 5 contrôles de la section 7.
1. Quel outil de feedback d’entretien candidat corrige les retours tardifs et vagues de mes évaluateurs ?
Associez l’outil au problème : une sollicitation juste après l’entretien corrige le feedback tardif, et des notes par critère accompagnées d’une citation corrigent le feedback vague. Collectez chaque note avant le débrief, afin que la voix la plus forte ne puisse pas l’emporter.
Un feedback tardif est un problème de mémoire, car plus l’attente est longue, moins les gens s’en souviennent. 1 responsable TA a écrit sur Reddit que le feedback pour un poste d’ingénieur senior avait pris 3 jours, en réponses d’une ligne.
Puis une automatisation a demandé un feedback structuré juste après chaque entretien, et 4 des 4 intervieweurs ont envoyé le leur en moins de 2 minutes. C’est le rapport d’une équipe, mais il montre pourquoi un outil de feedback devrait solliciter tout de suite.
Le candidat ressent aussi le délai. Dans le rapport 2024 State of Job Hunting de Greenhouse (2 500 salariés), 61% des demandeurs d’emploi ont déclaré qu’un employeur les avait ghostés après un entretien.
Ce guide corrige 4 défaillances dans le feedback sur un candidat :
- Tardif : la fiche d’évaluation arrive des jours plus tard (cette section et la section 10).
- Vague : « bonne adéquation culturelle » sans rien pour l’étayer (section 2).
- Oublié : personne ne se souvient de ce que le candidat a dit (section 5).
- Voix la plus forte : le débrief suit la personne la plus senior (section 9).
Données Flowmingo · 49 459 entretiens IA terminés avec un horodatage de rapport · 925 entreprises · du 1er juillet au 15 octobre 2026
- 16 secondes était le délai médian entre la fin d’un entretien IA et son rapport évalué.
- 27 secondes ou moins était l’attente pour 90% des rapports d’entretien IA sur cette période.
- 98.5% de ces rapports d’entretien IA étaient prêts dans les 5 minutes suivant la fin de l’entretien du candidat.
Il s’agit du moment où le service d’évaluation de Flowmingo a horodaté son rapport IA, et non du moment où un recruteur l’a lu. Ce n’est pas un compte rendu rédigé par un intervieweur humain.
Dans le graphique ci-dessous, 25% des rapports étaient prêts en 14 secondes, la moitié des rapports (la médiane) en 16 et 75% en 21.
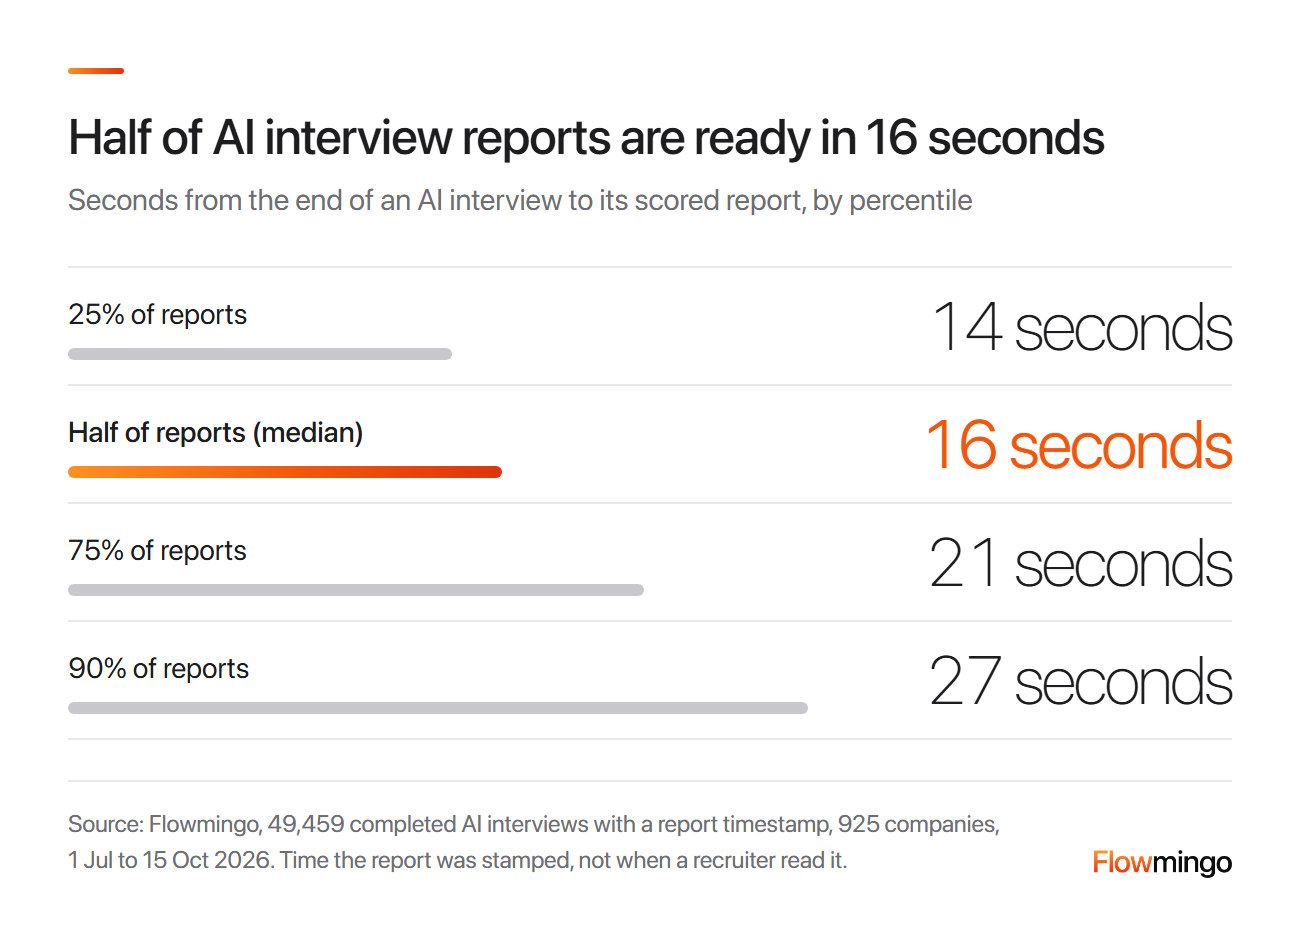
Graphique de vitesse des rapports : le rapport d’entretien IA médian était prêt 16 secondes après la fin de l’entretien du candidat (49 459 entretiens horodatés, du 1er juillet au 15 octobre 2026).
2. Mes intervieweurs écrivent « bonne adéquation culturelle » et s’arrêtent là. Comment obtenir un feedback que je peux comparer ?
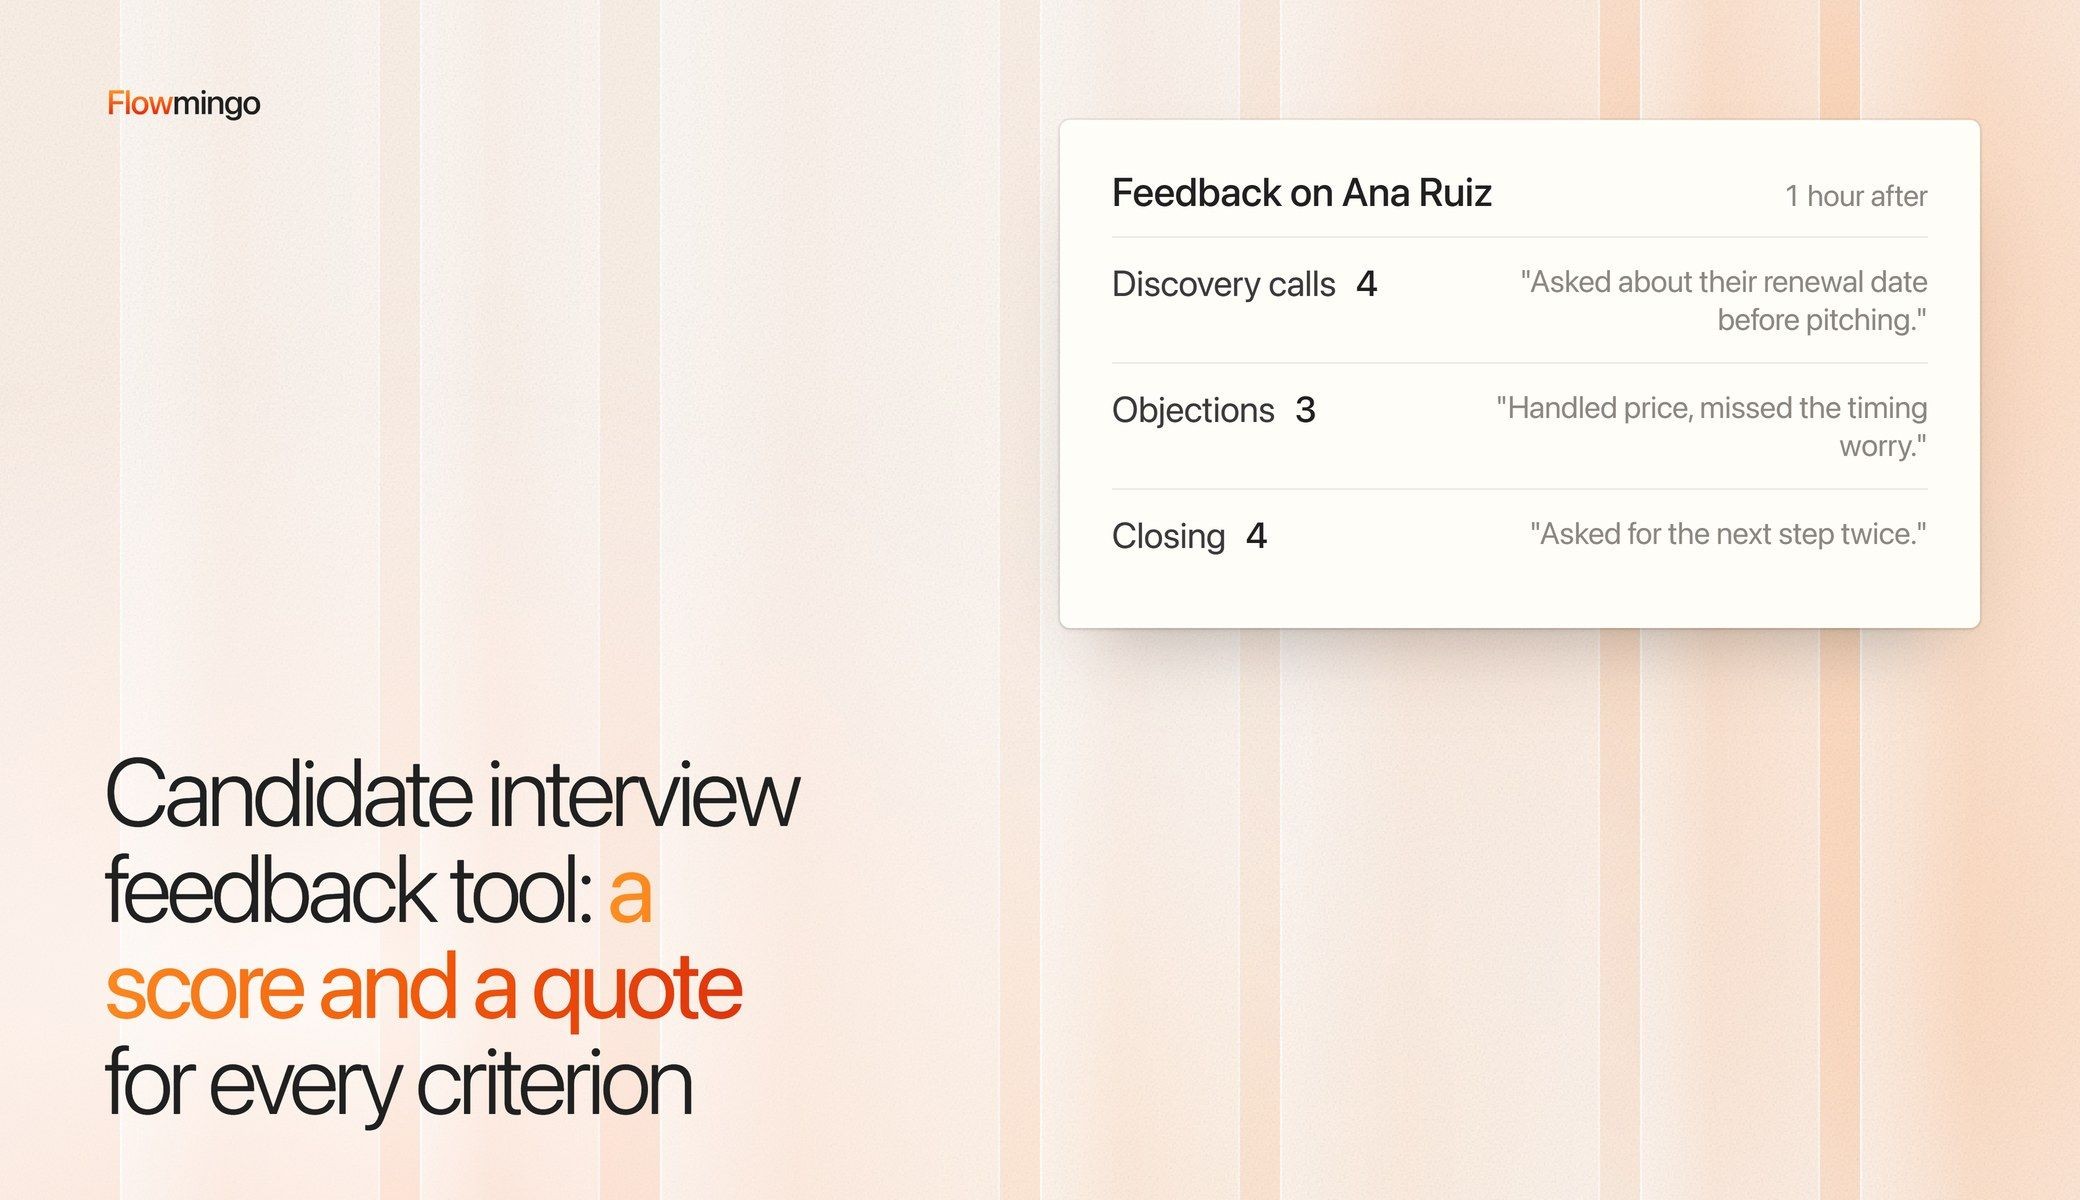
Demandez à chaque intervieweur une note sur les mêmes 4 à 6 critères, avec 1 citation du candidat derrière chacun. « Bonne adéquation culturelle » sans citation n’est qu’une impression, et les impressions en texte libre peuvent dégrader une décision.
Dans l'étude fondatrice de Dana, Dawes et Peterson publiée en 2013, des personnes prédisaient les notes d'étudiants, certaines après un entretien non structuré. Ces prédictions correspondaient aux notes réelles à .31, contre .61 sans entretien, sur une échelle où 0 signifie aucun lien et 1 un lien parfait.
Les notes antérieures seules obtenaient .65, donc la conversation ajoutait du bruit. L'étude prédisait des notes, pas des emplois, et pourtant 96 personnes sur 169 (57 %) classaient encore un entretien avec des réponses aléatoires au-dessus de l'absence d'entretien.
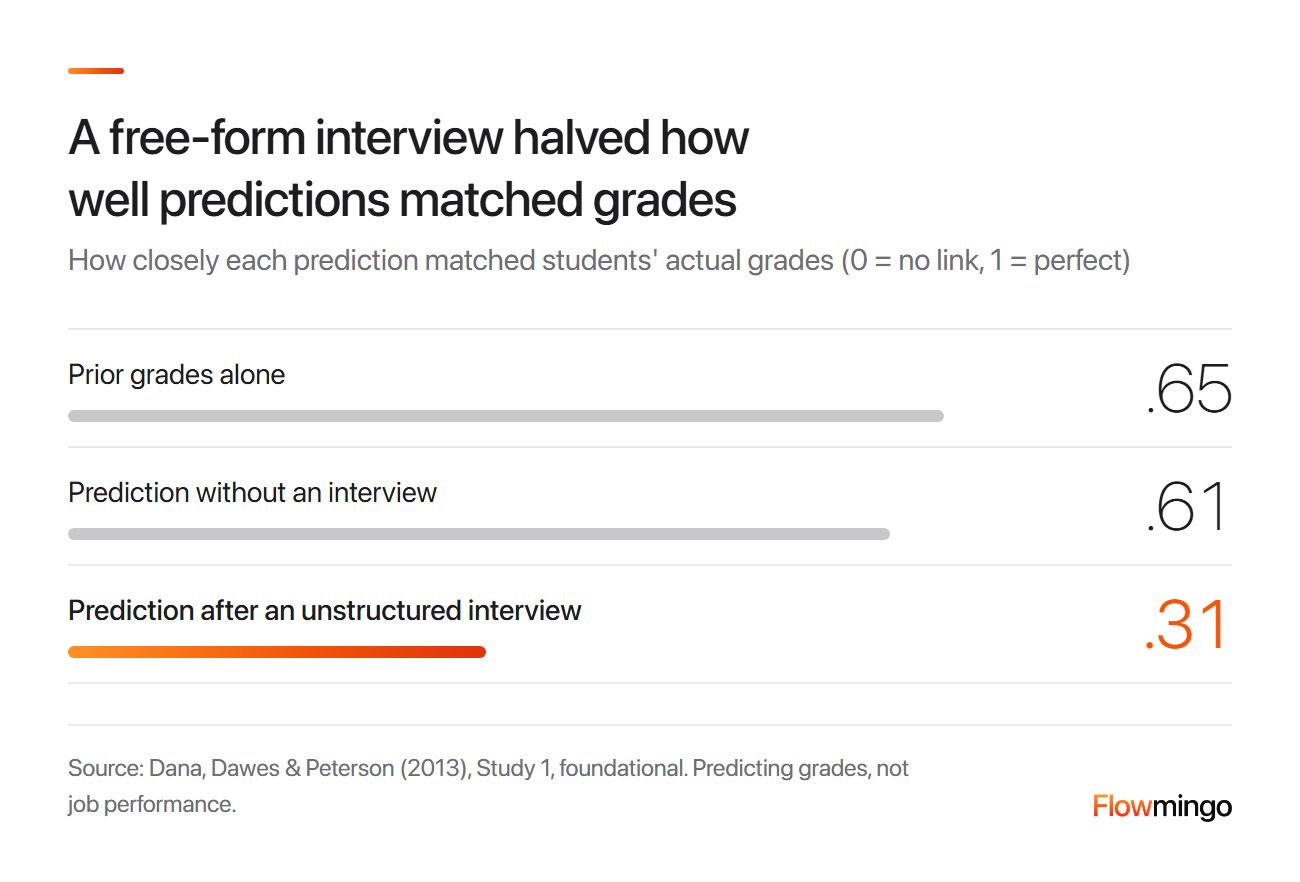
Graphique sur l'entretien non structuré : les prédictions après un entretien libre correspondaient aux notes à .31, contre .61 sans entretien et .65 pour les notes antérieures (étude fondatrice).
La solution est une règle de citation. 1 comité d'embauche qui recevait sans cesse « Je l'ai bien aimé » a commencé à exiger 1 citation directe du candidat par compte rendu, et la qualité a changé (r/recruiting).
Remplacez « adéquation culturelle » par le comportement dont le poste a besoin. Par exemple, « explique une décision à un client en termes simples » est un critère que 2 personnes peuvent noter.
Une trace liée aux critères du poste est aussi votre preuve si un refus est contesté. Singapour a adopté sa Workplace Fairness Act le 8 janvier 2025 (MOM). Elle devrait entrer en vigueur d'ici fin 2027 et couvrira 11 caractéristiques, comme l'âge et la race (Hawksford).
Voici 1 Responsable de l'équipe support client, évalué par écrit deux fois. Avant : « Excellent candidat. Bonne communication. Bonne adéquation culturelle. À recruter. » Après (exemple illustratif, pas des données client) :
| Critère (importance) | Score 0-10 | Preuve dans les mots du candidat | Réserve ou point à approfondir |
|---|---|---|---|
| Rôle et étape | -- | Responsable de l'équipe support client, 2e entretien (panel) | -- |
| Gestion des escalades (Indispensable) | 8 | « Je prenais les 3 tickets de clients les plus en colère chaque matin et je rédigeais notre macro de réponse » | Comment il/elle l'enseigne |
| Encadrement d'une équipe (Très important) | 5 | A décrit un 1:1 hebdomadaire, aucun exemple d'amélioration de quelqu'un | Nommez 1 agent qu'il ou elle a fait progresser, et comment |
| Utilisation des indicateurs support (Important) | 7 | « Le temps de première réponse est passé d'environ une journée à 4 heures après que nous avons scindé la file » | Vérifiez ce que « environ une journée » signifie |
| Rédaction pour les clients (Souhaitable) | 6 | « Je limite chaque résumé d'escalade à 3 lignes » | Demandez 1 vrai résumé |
| Recommandation (rédigée en dernier) | -- | Passer au tour final | Approfondir d'abord l'encadrement |
| Soumis avant la lecture des autres | -- | Oui, 2 heures après l'entretien | -- |
Notre modèle de grille d'évaluation d'entretien repose sur une échelle de 1 à 5. Toute échelle fonctionne si chaque intervieweur utilise la même.
2.1 Comment faire un retour sur un candidat après un entretien ?
Notez chaque critère juste après l'entretien, avant que la mémoire ne s'estompe et avant de lire les notes de qui que ce soit d'autre, et soumettez au plus tard dans les 24 heures. Utilisez ces 6 champs :
- Rôle et étape de l'entretien.
- Une note sur chaque critère convenu, selon l'échelle de votre grille d'évaluation.
- 1 citation ou action observée justifiant chaque note.
- Les réserves, formulées comme ce que l'intervieweur suivant devrait approfondir.
- La recommandation globale, rédigée après les notes.
- Soumise avant la lecture des retours des autres : oui ou non.
3. La notation d'entretien structuré permet-elle vraiment de prédire qui réussira dans le poste ?
Oui. Dans une réanalyse fondatrice de 2022, les entretiens structurés étaient le prédicteur le mieux classé de la performance professionnelle, à .42 contre .31 pour les tests d'aptitude cognitive.
Ce sont des corrélations issues de Sackett, Zhang, Berry et Lievens, où 0 signifie aucun lien avec la performance professionnelle ultérieure et 1 un lien parfait.
Ainsi, .42 n'est pas un taux de réussite de 42 %. C'est le lien le plus fort parmi les méthodes examinées, comme l'explique le résumé de la SIOP.
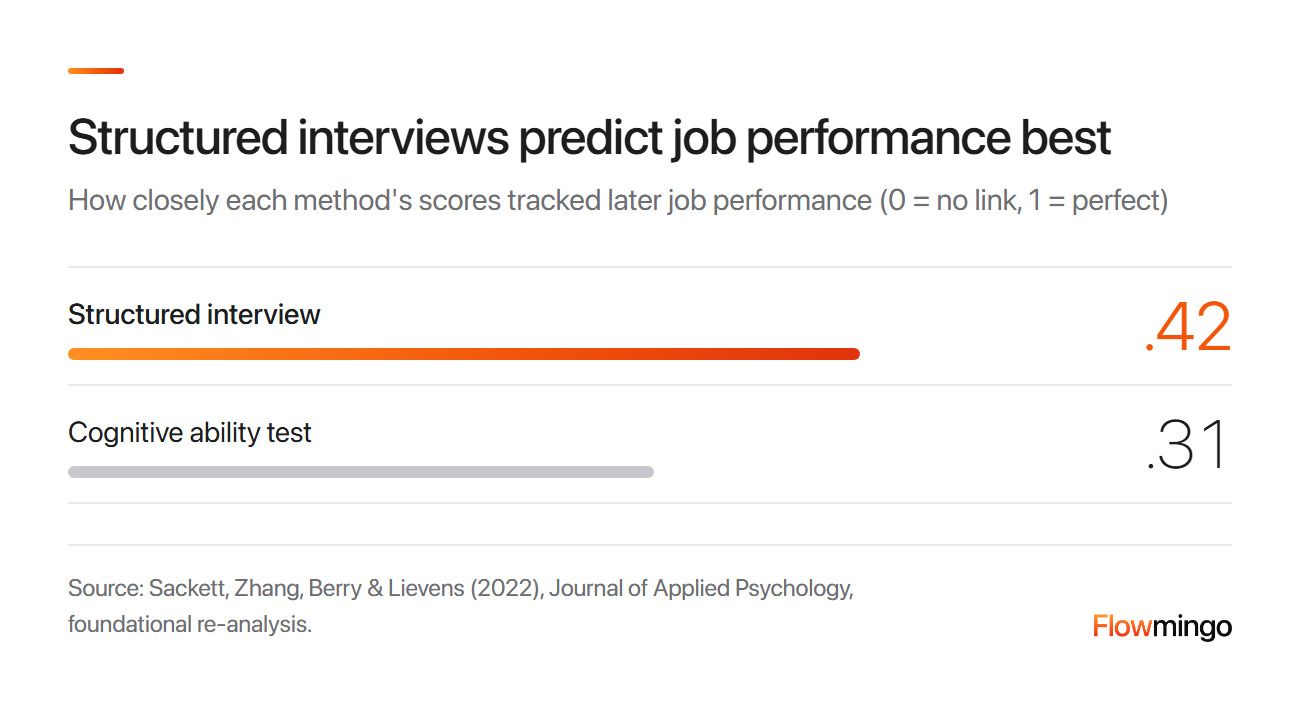
Graphique des prédicteurs : l'entretien structuré se classait premier à .42, devant le test d'aptitude cognitive à .31 (réanalyse fondatrice de 2022, Sackett et ses collègues).
Une objection pertinente formulée sur Hacker News est que les grilles d'évaluation donnent des chiffres à des opinions. L'idée est d'appliquer 1 même référentiel à chaque candidat, chaque critère étant noté séparément.
Dans la méta-analyse fondatrice de 2013 de Kuncel et ses collègues, combiner les évaluations selon une règle fixe prédisait la performance professionnelle plus de 50 % mieux qu'un jugement global.
Le jugement holistique consiste à former une vue d'ensemble à partir de tout, même lorsqu'il est porté par des experts. La règle l'emporte parce qu'elle pondère les mêmes éléments de preuve de la même manière pour tous.
Voici une moyenne pondérée convenue avant les entretiens, avec des chiffres illustratifs : 4 critères pondérés à 4, 3, 2 et 1, comme dans la section 7.
Le finaliste A obtient 5 sur le critère indispensable et 8, 7 et 7 sur les autres, soit 6.5. Le finaliste B obtient 8, puis 6, 7 et 6, soit 7.0.
L'instinct du panel a désigné A, qui l'emportait sur 2 des 3 autres critères. La règle retient B, vous ne discutez donc que du Must Have, où l'écart entre eux est de 3 points.
Notre guide d'entretien structuré couvre les questions. Dans tout outil de feedback d'entretien candidat, pas de score par critère signifie pas d'entretien structuré.
4. Outil de prise de notes, scorecard, rédacteur IA, intervieweur IA ou enquête : de quel outil de feedback d'entretien candidat ai-je besoin ?
Chacun des 5 types corrige une défaillance différente de la section 1. Les scorecards corrigent le feedback vague, les outils de prise de notes corrigent les détails oubliés, et les rapports d'intervieweur IA corrigent le feedback tardif et vague dès le premier tour.
Les générateurs de texte ne corrigent que la formulation, et les enquêtes règlent un autre problème. Un débriefing houleux nécessite un processus (section 9), pas un outil.
Un recruteur comparant BrightHire, Metaview et Otter a trouvé que les sites des fournisseurs étaient « tous évasifs sur l'IA » (r/recruiting).
| Type d'outil | Défaillance corrigée | Ce qui reste en panne | Exemples |
|---|---|---|---|
| Scorecard ATS | Vague, avec 1 seul format à 1 seul endroit | Formulaires tardifs ou vides, aucune preuve | Greenhouse, Ashby (dans la liste de Metaview), formulaire Slack de Polly |
| Outil de prise de notes IA | Détails oubliés | Jugement et notation | Metaview, BrightHire |
| Générateur de texte de feedback | Aucune des 4 : seule la formulation est confuse | Preuves manquantes | TalentEconomy, Easy-Peasy |
| Intervieweur IA avec rapport noté | Tardif et vague, avec des preuves dès le premier tour | L'entretien final humain | HireVue (top 10) |
| Enquête candidat | Aucune : l'expérience candidat est un problème différent (section 8) | Jugement de l'intervieweur | Survale, Typeform |
Les scorecards ATS regroupent le feedback à 1 seul endroit, mais rien ne relance les personnes qui les ignorent. Un utilisateur de Greenhouse cherchait un rapport des candidats dont les scorecards n'avaient jamais été soumises (r/recruiting). Vérifiez donc qu'un outil montre qui n'a pas soumis.
Les outils de prise de notes IA enregistrent l'entretien et rédigent des notes, et la page de comparaison de Metaview classe Metaview premier sur 7. Si les intervieweurs notent mais ne citent rien, une transcription leur fournit la citation.
Les générateurs de texte de feedback transforment des notes collées en texte propre. Le générateur de TalentEconomy promet des résultats « en quelques secondes » et ne cite aucune recherche ; alimentez-le donc avec des notes sans citation et vérifiez qu'il n'ajoute rien.
Les intervieweurs IA, comme l'intervieweur IA de HireVue, mènent un premier entretien structuré et renvoient un score par critère accompagné des raisons et d'une transcription. Personne ne rédige le compte rendu du premier tour, alors vérifiez que vous pouvez voir les propos derrière chaque score.
Les enquêtes candidat mesurent ce que les candidats ont ressenti à propos de votre processus (section 8), pas la qualité du jugement. Avant d'acheter un logiciel de feedback d'entretien, nommez la défaillance que vous observez le plus souvent, car c'est elle qui détermine la ligne.
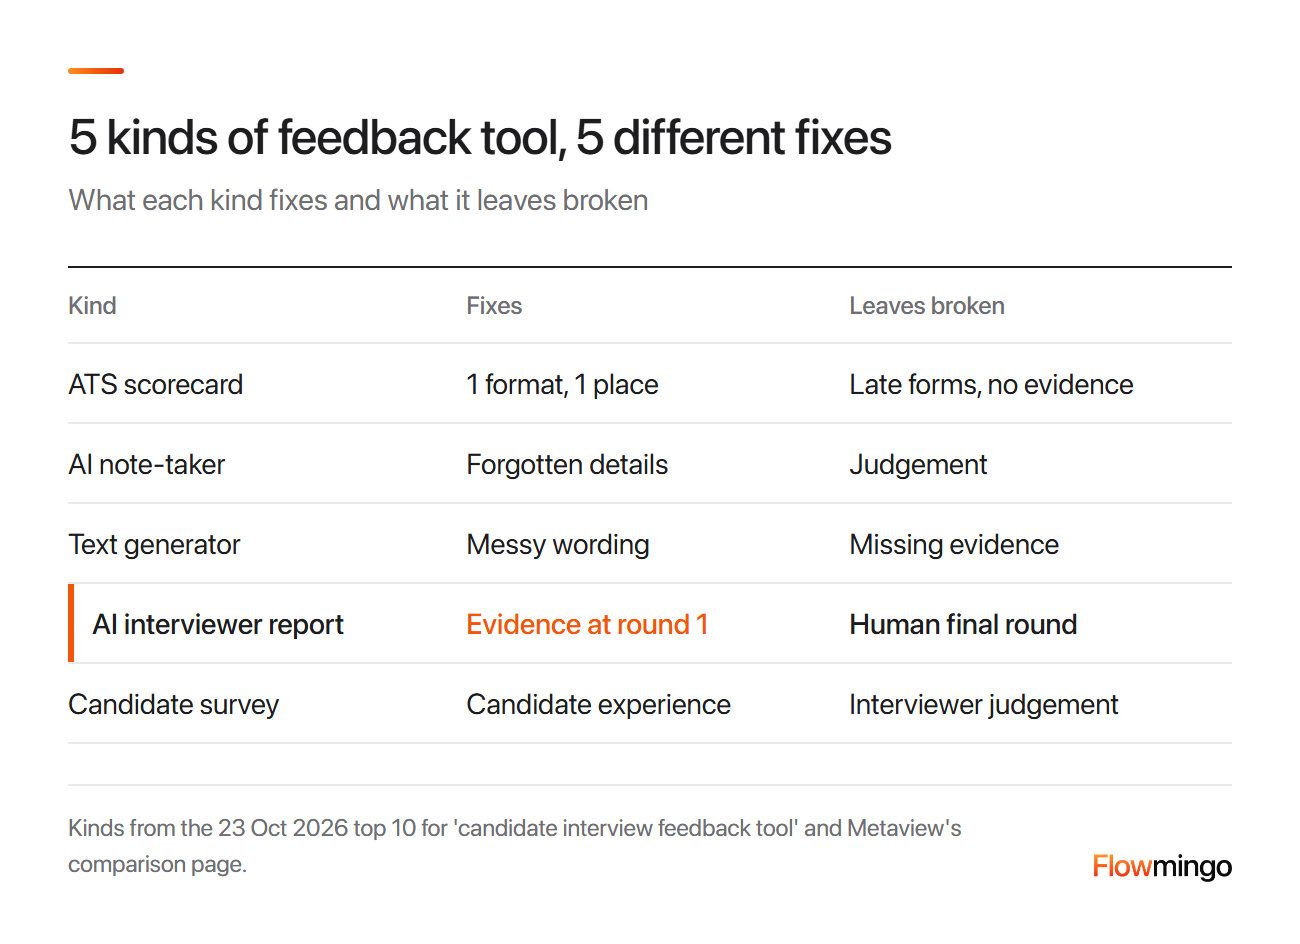
Carte des outils : la grille d'évaluation ATS corrige 1 format, 1 endroit, le preneur de notes IA corrige les détails oubliés, et le générateur de texte corrige les formulations brouillonnes. Le rapport d'entretien IA corrige les preuves au round 1, et l'enquête candidat corrige l'expérience candidat.
5. Un preneur de notes IA comme Metaview vaut-il le coup, ou ma grille d'évaluation ATS suffit-elle ?
Un preneur de notes corrige l'oubli, pas le jugement. Ajoutez-en un si les intervieweurs notent déjà dans l'ATS mais perdent des détails, car une transcription ne poussera personne à remplir une grille d'évaluation oubliée.
Dans une expérience fondatrice de 2002, Middendorf et Macan ont constaté que la prise de notes améliorait la fidélité avec laquelle les intervieweurs se rappelaient un entretien, pas la justesse de leur jugement. Relire leurs notes aidait effectivement le jugement, mais seulement pour les personnes qui avaient pris des notes conventionnelles.
Cette étude portait sur des notes manuscrites ; l'appliquer aux transcriptions IA relève donc de notre déduction. Le rappel n'aide que si quelqu'un note ensuite selon des critères.
Ainsi, la grille d'évaluation ATS détient les critères et l'échelle, et un preneur de notes devrait y écrire. 1 recruteur a écrit : « Metaview ne s'intègre pas à notre ATS, mais Quil oui » (r/recruiting).
Le tableau comparatif de Metaview, consulté le 23 oct. 2026, indique Metaview comme gratuit avec un e-mail professionnel et HireLogic à partir de 69 $ par utilisateur et par mois. Vérifiez ce que stocke une offre gratuite, et pendant combien de temps.
L'enregistrement implique aussi le consentement et une règle de conservation. L'audit de l'ICO britannique sur les outils de recrutement IA, annoncé en novembre 2024, a constaté que certains conservaient indéfiniment les données des candidats et a formulé près de 300 recommandations.
Pour le tester, demandez à chaque intervieweur d'évaluer 3 entretiens de mémoire, puis à nouveau avec la transcription. Si des citations apparaissent, le preneur de notes justifie sa place.
Comment Flowmingo aide
Flowmingo évalue son propre entretien IA. Il n'enregistre, ne transcrit ni n'évalue vos entretiens en direct ou en panel, donc un preneur de notes et Flowmingo remplissent des rôles différents.
6. L'IA peut-elle rédiger le feedback de mes intervieweurs à leur place, et est-ce une bonne idée ?
L'IA peut améliorer la formulation, mais elle ne peut pas ajouter des preuves que l'intervieweur n'a jamais consignées. N'utilisez un générateur qu'une fois les scores et les citations établis, jamais à leur place.
La FAQ de TalentEconomy indique elle-même que l'outil n'ajoute pas d'informations que vous n'avez pas fournies. Le générateur d'Easy-Peasy nécessite 2 entrées : un intitulé de poste et vos notes.
Le modèle de feedback de Polly est un formulaire, pas un générateur : il rassemble le feedback du panel en 1 seul endroit. Il demande 1 note globale sans points d'ancrage et se termine par « Embaucher ou ne pas embaucher ? ». Supprimez son élément « aimerait travailler aux côtés de ce candidat tous les jours ».
Le risque est qu'un texte poli, issu de notes vagues, se lise comme une preuve, alors qu'il ne change rien à ce que l'intervieweur a vu.
L'écriture par IA aide à 2 endroits. Elle peut transformer une grille d'évaluation terminée en synthèse pour un manager qui n'a pas assisté à l'entretien, et rédiger des questions à partir de la ligne « points à creuser ».
Par exemple, « aucun exemple de coaching » peut devenir 2 questions de dernier tour : quel agent la personne a amélioré, et comment ses chiffres ont changé.
Coller des notes sur un candidat dans un outil de chat public envoie aussi des données personnelles à un tiers.
7. Puis-je faire confiance au rapport noté d'un intervieweur IA et voir pourquoi il a attribué cette note à une personne ?
Faites-lui confiance dans la mesure où vous pouvez le vérifier. Chaque score doit nommer le critère, donner une raison écrite et vous mener aux propres mots du candidat, et c'est une personne qui doit prendre la décision.
Les premières preuves indépendantes proviennent d'un document de travail de Rubin et Grissom de 2026, pas encore évalué par les pairs. On y trouve 6 modèles de langage qui ont noté les réponses de futurs directeurs d'école à une évaluation de recrutement, y compris une question d'entretien structurée.
Il s'agit de recrutement dans l'éducation, et aucun des modèles n'était celui de Flowmingo.
3 des 6 concordaient souvent avec la moyenne humaine de plus près que les évaluateurs formés ne concordaient entre eux. La notation par IA selon une grille peut donc être cohérente, davantage sur des critères concrets que subjectifs, ce qui signifie que votre levier, ce sont les critères.
Les candidats se méfient de la personne qui décide. Dans une enquête Pew de référence menée auprès de 11 004 adultes américains en décembre 2022, 71 % s’opposaient à ce que l’IA prenne la décision finale d’embauche.
Pourtant, 47 % pensaient que l’IA traiterait les candidats de façon plus équitable, et 15 % de façon moins équitable. Alors, gardez une personne pour décider et expliquez aux candidats comment vous utilisez l’IA. Appliquez ces 5 vérifications à tout rapport d’intervieweur IA :
- Une note par critère, et pas seulement un score global.
- Une justification écrite pour chaque note.
- Des citations qui sont des phrases exactes de la transcription.
- Des pondérations visibles, pour que vous puissiez recalculer le score global.
- Une personne peut passer outre, et personne n’est rejeté automatiquement.
Comment Flowmingo aide
L’entretien IA de Flowmingo pose à chaque candidat les mêmes questions, rédigées à partir de votre fiche de poste. Il note chacun de vos critères de 0 à 10, avec des justifications écrites, des points forts, des lacunes et une recommandation.
L’enregistrement et la transcription étayent chaque note, afin que votre équipe puisse la vérifier et la corriger. Notre méthode de notation présente les pondérations, de Must Have x4 à Good To Have x1.
Une citation mise en avant doit être une phrase exacte de la transcription. Must Have n’entraîne pas de rejet automatique, et les entretiens IA conviennent aux postes à fort volume, du niveau débutant à intermédiaire, et non au dernier tour d’un recrutement senior.
Le rapport d’exemple public de Flowmingo, ci-dessous, montre la note et la justification de chaque critère. Les citations exactes figurent dans la vue de la transcription, non affichée.
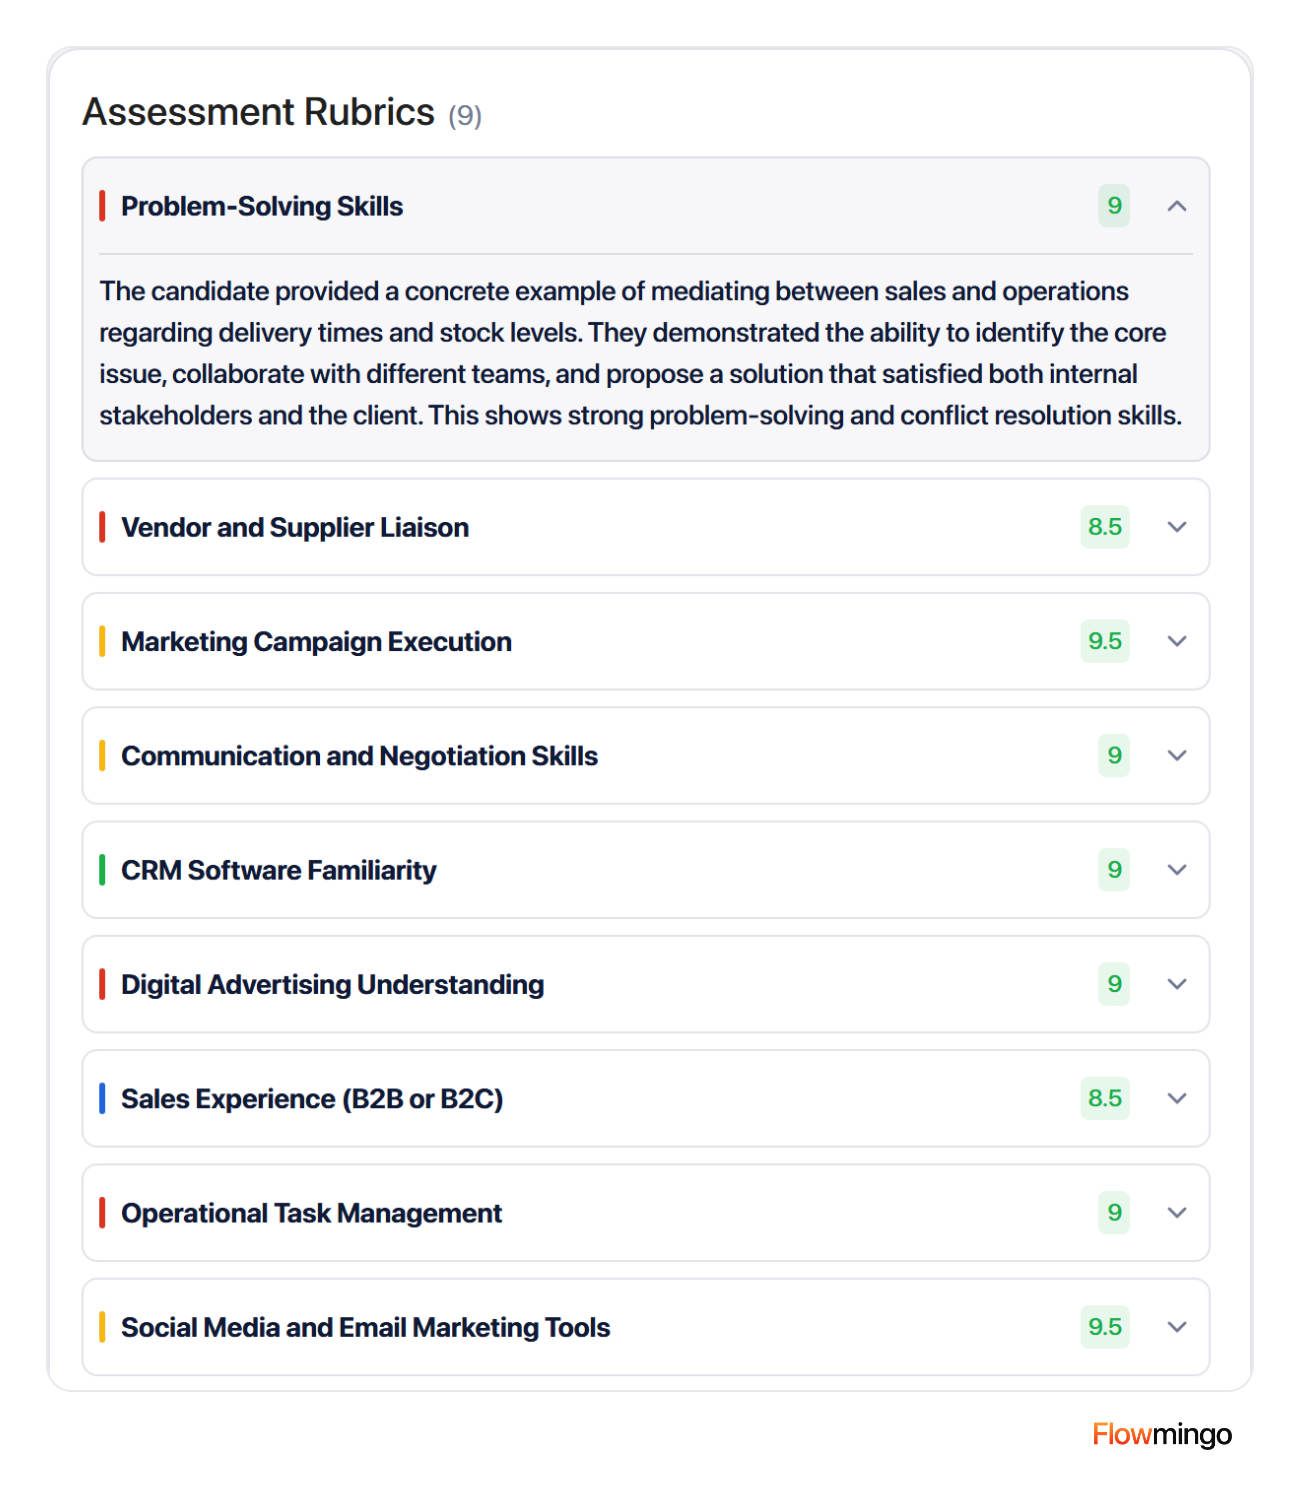
Rapport d’exemple : chaque critère reçoit une note de 0 à 10 et une justification écrite tirée des réponses du candidat (rapport de démonstration public, et non des données client). Les citations exactes figurent dans la vue de la transcription, non affichée ici.
Données Flowmingo · 49 475 entretiens IA terminés · 925 entreprises · du 1er juil. au 15 oct. 2026
- 99,96 % de ces entretiens IA ont donné lieu à un score global ainsi qu’à des points forts, des lacunes et des recommandations écrits.
- Chaque rapport d’entretien IA évaluait une médiane de 9 critères, la moitié centrale se situant entre 8 et 10.
- 99,95 % des 515 787 évaluations de critères comportaient une justification écrite d’au moins 40 caractères.
Les rapports IA portent sur des entretiens IA, pas sur des retours ou des décisions humaines. Les chiffres relatifs aux critères couvrent les 49 463 entretiens (924 entreprises) ayant des résultats par critère. La présence d’une justification ne mesure pas sa qualité. Les critères sont rédigés par l’IA à partir de la fiche de poste et les recruteurs peuvent les modifier ; 9 correspond donc à ce que contiennent les rapports, et non à ce que les recruteurs ont choisi. Les notes sont des scores IA, pas des performances professionnelles, et ces chiffres ne montrent pas si un recruteur a lu le rapport.
8. Ai-je besoin d’une enquête sur l’expérience candidat, ou cela résout-il un autre problème ?
Une enquête candidat résout un autre problème. Elle vous indique comment les candidats ont vécu votre processus, et non si vos intervieweurs ont bien évalué ; achetez-en une lorsque les candidats ne répondent plus ou abandonnent.
Dans le rapport de référence de Talent Board publié en décembre 2024, 24 % des candidats nord-américains attendaient encore 2 mois ou plus après avoir postulé (Talent Board et ERE).
Une analyse comparative antérieure de 2023 portant sur 240 000 candidats a révélé que 36 % des candidats américains restaient sans réponse 1 à 2 mois après avoir postulé (SHRM, avril 2024). Elle porte sur 1 seul pays et un délai d’attente plus court.
Survale déclenche de courtes enquêtes au moment de la candidature, de l’entretien, de l’offre et de l’embauche. La page de Typeform consacrée aux retours des candidats cite 2 points faibles : un faible taux de réponse et des réponses biaisées selon que le candidat a obtenu une offre ou non.
Aucune des deux ne vous dit si un intervieweur a évalué de manière équitable, car le candidat ne voit jamais la grille d’évaluation.
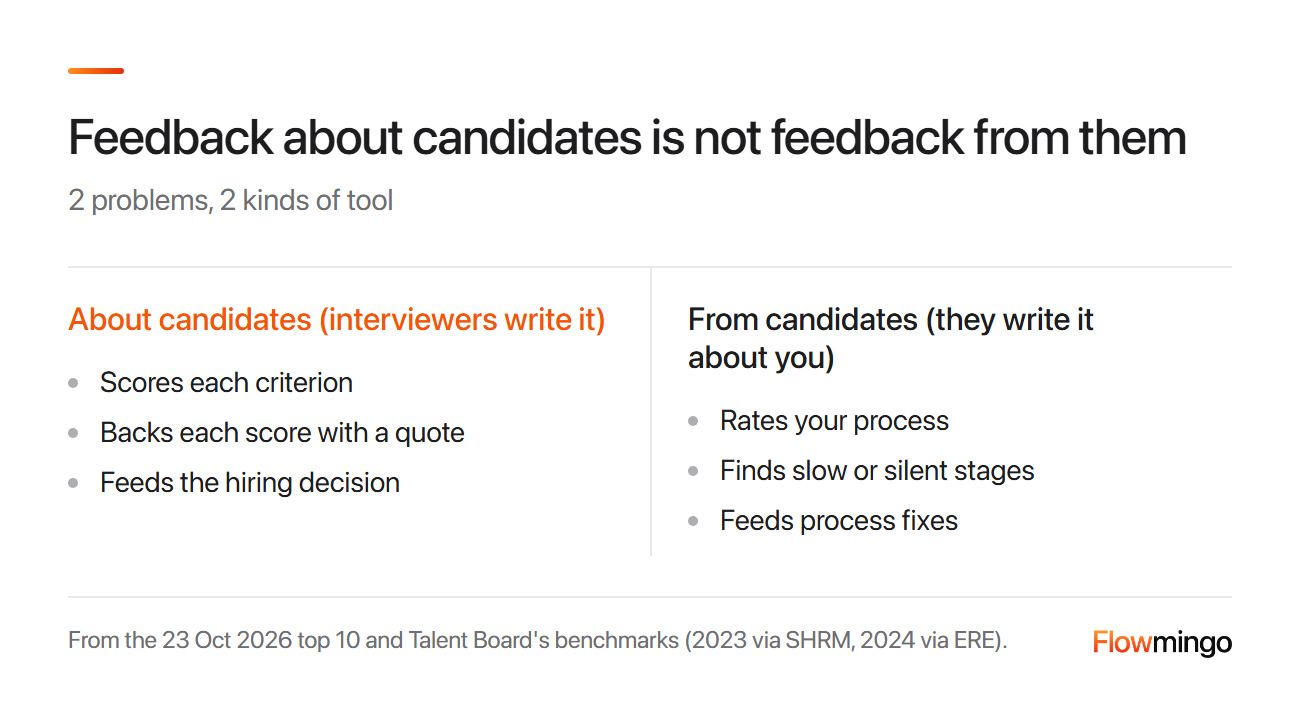
Comparaison des retours : les retours sur les candidats notent chaque critère, étayent chaque note par une citation et alimentent la décision d’embauche. Les retours des candidats évaluent votre processus, repèrent les étapes lentes ou silencieuses et nourrissent les améliorations du processus.
Les 2 se rejoignent en 1 endroit. Identifiez l’étape où les candidats attendent le plus longtemps, puis vérifiez dans votre outil de retours d’entretien sur les candidats les grilles d’évaluation en retard à cette étape. Ajoutez cette question à votre enquête :
- « Combien de temps avez-vous attendu pour avoir une réponse après votre entretien ? »
Si la réponse dépasse une semaine, le correctif se situe probablement dans votre délai de 24 heures pour remettre les grilles d’évaluation, pas dans l’enquête.
9. Dans nos débriefings, c’est la voix la plus forte qui l’emporte. Les notes doivent-elles arriver avant la réunion ?
Oui. Demandez à chaque intervieweur de soumettre ses notes et citations avant la réunion, puis discutez d’un critère à la fois, en commençant par les éléments de preuve qu’une seule personne a entendus.
1 équipe affirme que les décisions reviennent à « celui qui a parlé le plus fort dans la salle » (r/recruiting).
Parler en premier ne fonctionne pas, car les groupes discutent de ce que tout le monde sait déjà. Dans la méta-analyse fondatrice de 2012 de Lu, Yuan et McLeod, portant sur 65 études en laboratoire et 3 189 groupes, les faits partagés ont occupé bien plus de temps de parole.
Lorsque les faits clés étaient répartis, chaque membre en détenant une partie, les groupes avaient 8 fois moins de chances de trouver la bonne réponse que les groupes qui voyaient tout. Il s’agissait de groupes en laboratoire qui résolvaient des problèmes prédéfinis, et non de comités d’embauche.
Lors d'un débrief, le fait qu'un seul intervieweur ait entendu se perd. Dans la simulation de caucus fondatrice de 1985 de Stasser et Titus, la discussion avait tendance à maintenir les points de vue déformés, pas à les corriger.
Alors partez de la moyenne pondérée de la section 3, convenue avant les entretiens, et ne discutez que des points où les scores divergent.
La méthode suit le protocole d'évaluations médiatrices de Kahneman, Lovallo et Sibony, une idée fondatrice de 2019 également exposée dans Noise. On juge chaque évaluation isolément avant d'en discuter.
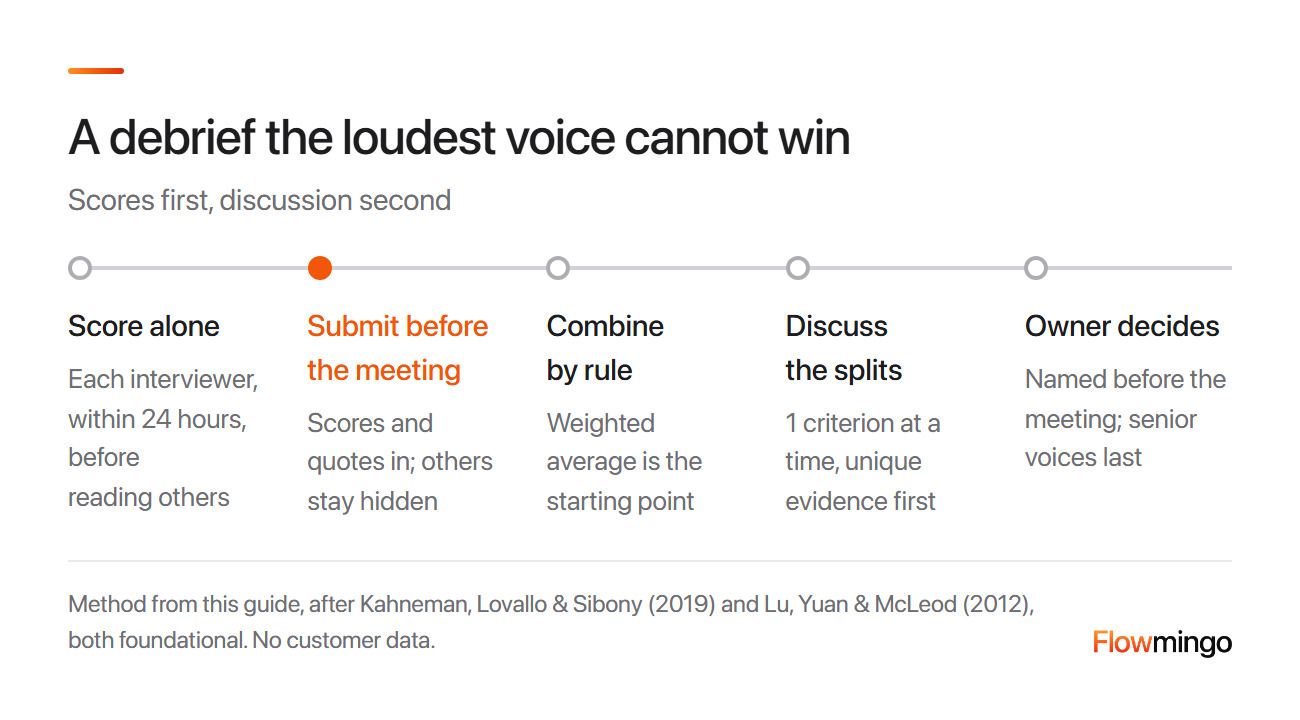
Déroulé du débrief : noter seul, soumettre avant la réunion pendant que les autres restent masqués, et combiner selon la règle. Puis discuter les divergences 1 critère à la fois, et le responsable décide.
Les éléments de preuve uniques passent en premier, et le responsable est nommé avant la réunion, les voix des plus expérimentés intervenant en dernier.
Notre guide sur les biais d'entretien couvre les autres pièges.
10. Que doit inclure un outil de feedback d'entretien candidat avant que je n'en choisisse un ?
Testez 9 points pendant un essai d'1 semaine avant d'acheter. Chaque ligne indique ce qu'il faut rechercher, pourquoi et comment le tester :
| À rechercher | Pourquoi | Le tester en 1 semaine |
|---|---|---|
| Une note par critère, pas 1 note globale | La combinaison fondée sur des règles a battu le jugement holistique (Kuncel, section 3) | Notez 2 candidats précédents dans l'outil |
| Des preuves jointes à chaque note | Les entretiens libres ont affaibli les prédictions de note (.31 contre .61, Dana, étude fondatrice) | Retrouvez les propos derrière chaque note |
| Une relance post-entretien et une liste de scorecards manquantes | 1 équipe est passée de 3 jours à 2 minutes (section 1), et 1 utilisateur de Greenhouse a cherché ce rapport (r/recruiting) | Lancez 1 boucle et voyez qui est relancé |
| Les autres notes masquées jusqu'à votre soumission | Les groupes manquent les faits répartis entre les membres (Lu, section 9) | Soumettez en tant que 2 intervieweurs de test |
| Des pondérations visibles | Le score global doit être vérifiable | Recalculez 1 score global à la main |
| Export ou API vers votre ATS | Les notes dans un outil annexe sont ignorées | Poussez 1 rapport dans votre ATS |
| Consentement, conservation et suppression | L'Illinois exige la suppression dans les 30 jours, et l'ICO a constaté que des données étaient conservées indéfiniment | Demandez comment fonctionne la suppression |
| Un audit indépendant des biais, et une personne qui décide | NYC Local Law 144, l'EU AI Act et Mobley v. Workday | Demandez le résumé de l'audit |
| Un tarif adapté à votre volume, et une formule gratuite | Les FAQ de TalentEconomy, Easy-Peasy et Metaview répondent toutes à la question de la gratuité | Chiffrez 12 mois selon votre nombre d'entretiens |
Établissez le prix selon votre volume, car des frais par siège augmentent avec chaque intervieweur.
Rien de tout ceci ne constitue un avis juridique. La NYC Local Law 144, appliquée depuis juillet 2023 et fondatrice, couvre les postes à NYC lorsqu'un outil aide substantiellement ou remplace la décision d'embauche.
La loi exige ensuite un audit indépendant des biais dans l'année précédant l'utilisation, un résumé d'audit public et une notification aux candidats 10 jours ouvrés à l'avance.
La loi de l'Illinois sur les entretiens vidéo par IA exige le consentement avant qu'une IA n'analyse un entretien vidéo, ainsi que la suppression dans les 30 jours suivant une demande. La loi sur l'IA de l'UE classe comme à haut risque les IA qui évaluent les candidats.
Elle doit s'appliquer à partir du 2 décembre 2027 (auparavant le 2 août 2026). Cette date provient du règlement (UE) 2026/1744, le Digital Omnibus sur l'IA, en vigueur depuis le 27 juillet 2026.
Dans Mobley c. Workday, un tribunal américain a autorisé la poursuite d'une action collective à l'échelle nationale sur une allégation de discrimination fondée sur l'âge (Holland & Knight).
Si votre prochaine étape est la pile de CV, voir la présélection des candidats.
Comment Flowmingo aide
Flowmingo est une plateforme de recrutement IA gratuite, et son entretien IA, que les candidats passent quand ils le souhaitent, rédige le retour du premier tour à votre place.
Les offres payantes ajoutent le stockage vidéo, la personnalisation de la marque et les téléchargements, et non davantage de présélection.
Il n'existe pas aujourd'hui de synchronisation native avec Greenhouse, Lever ou Workday, mais une API REST, des webhooks et MCP sont gratuits sur toutes les offres. Votre équipe prend toutes les décisions. Essayez-la comme outil de retour d'entretien candidat pour le premier tour sur Flowmingo.
11. Sources
Toutes les études, lois et pages d'éditeurs citées dans ce guide sont listées ci-dessous ; les citations de la communauté renvoient à leurs fils de discussion dans le texte. Les chiffres de Flowmingo proviennent des données de sa propre plateforme.
- Dana, J., Dawes, R., & Peterson, N. (2013). Belief in the unstructured interview: The persistence of an illusion. Judgment and Decision Making, 8(5), 512-520.
- Easy-Peasy.AI. (n.d.). Interview feedback generator. Retrieved October 23, 2026.
- EU Artificial Intelligence Act. (n.d.). Annex III: High-risk AI systems referred to in Article 6(2). Retrieved October 23, 2026.
- European Parliament and Council. (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the European Union.
- Greenhouse. (2024, December 10). Greenhouse 2024 state of job hunting report. Greenhouse.
- Hawksford. (n.d.). Singapore Workplace Fairness Act: A guide for multinationals. Retrieved October 23, 2026.
- HireVue. (n.d.). AI interviewer. Retrieved October 23, 2026.
- Holistic AI. (n.d.). Illinois Artificial Intelligence Video Interview Act. Retrieved October 23, 2026.
- Holland & Knight. (2025, May 27). Federal court allows collective action lawsuit over alleged AI hiring bias. Holland & Knight LLP.
- Information Commissioner's Office. (2024, November 6). ICO intervention into AI recruitment tools leads to better data protection for job seekers. ICO.
- Kahneman, D., Lovallo, D., & Sibony, O. (2019, March 4). A structured approach to strategic decisions. MIT Sloan Management Review.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment. Little, Brown Spark.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology, 98(6), 1060-1072.
- Lu, L., Yuan, Y. C., & McLeod, P. L. (2012). Twenty-five years of hidden profiles in group decision making: A meta-analysis. Personality and Social Psychology Review, 16(1), 54-75.
- Maurer, R. (2024, April 9). Candidate experience: Talent Board research (CandE). SHRM.
- Metaview. (n.d.). 7 top interview quality tools for better hiring decisions. Retrieved October 23, 2026.
- Middendorf, C. H., & Macan, T. H. (2002). Note-taking in the employment interview: Effects on recall and judgments. Journal of Applied Psychology, 87(2), 293-303.
- Ministry of Manpower, Singapore. (2025, January 8). Passing of Workplace Fairness Bill marks next step in building fair and harmonious workplaces. MOM.
- New York City Department of Consumer and Worker Protection. (n.d.). Automated employment decision tools (AEDT). Retrieved October 23, 2026.
- Pew Research Center. (2023, April 20). AI in hiring and evaluating workers: What Americans think. Pew Research Center.
- Polly. (n.d.). Interview feedback template. Retrieved October 23, 2026.
- Rubin, J. M., & Grissom, J. A. (2026). Leveraging large language models to assess short text responses (EdWorkingPaper No. 26-1385). Annenberg Institute at Brown University.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology, 107(11), 2040-2068.
- SIOP. (n.d.). Is cognitive ability the best predictor of job performance? New research says it's time to think again. The Industrial-Organizational Psychologist.
- Stasser, G., & Titus, W. (1985). Pooling of unshared information in group decision making: Biased information sampling during discussion. Journal of Personality and Social Psychology, 48(6), 1467-1478.
- Survale. (n.d.). Candidate experience surveys. Retrieved October 23, 2026.
- Talent Board & ERE Media. (2024, December). What sets CandE award winners apart: 2024 CandE benchmark research. ERE Media.
- TalentEconomy.ai. (n.d.). Interview feedback generator. Retrieved October 23, 2026.
- Typeform. (n.d.). Candidate feedback. Retrieved October 23, 2026.
- Flowmingo. (n.d.). How we score. Retrieved October 23, 2026.
- Flowmingo. (n.d.). FAQ. Retrieved October 23, 2026.
- Flowmingo. (n.d.). Pricing. Retrieved October 23, 2026.