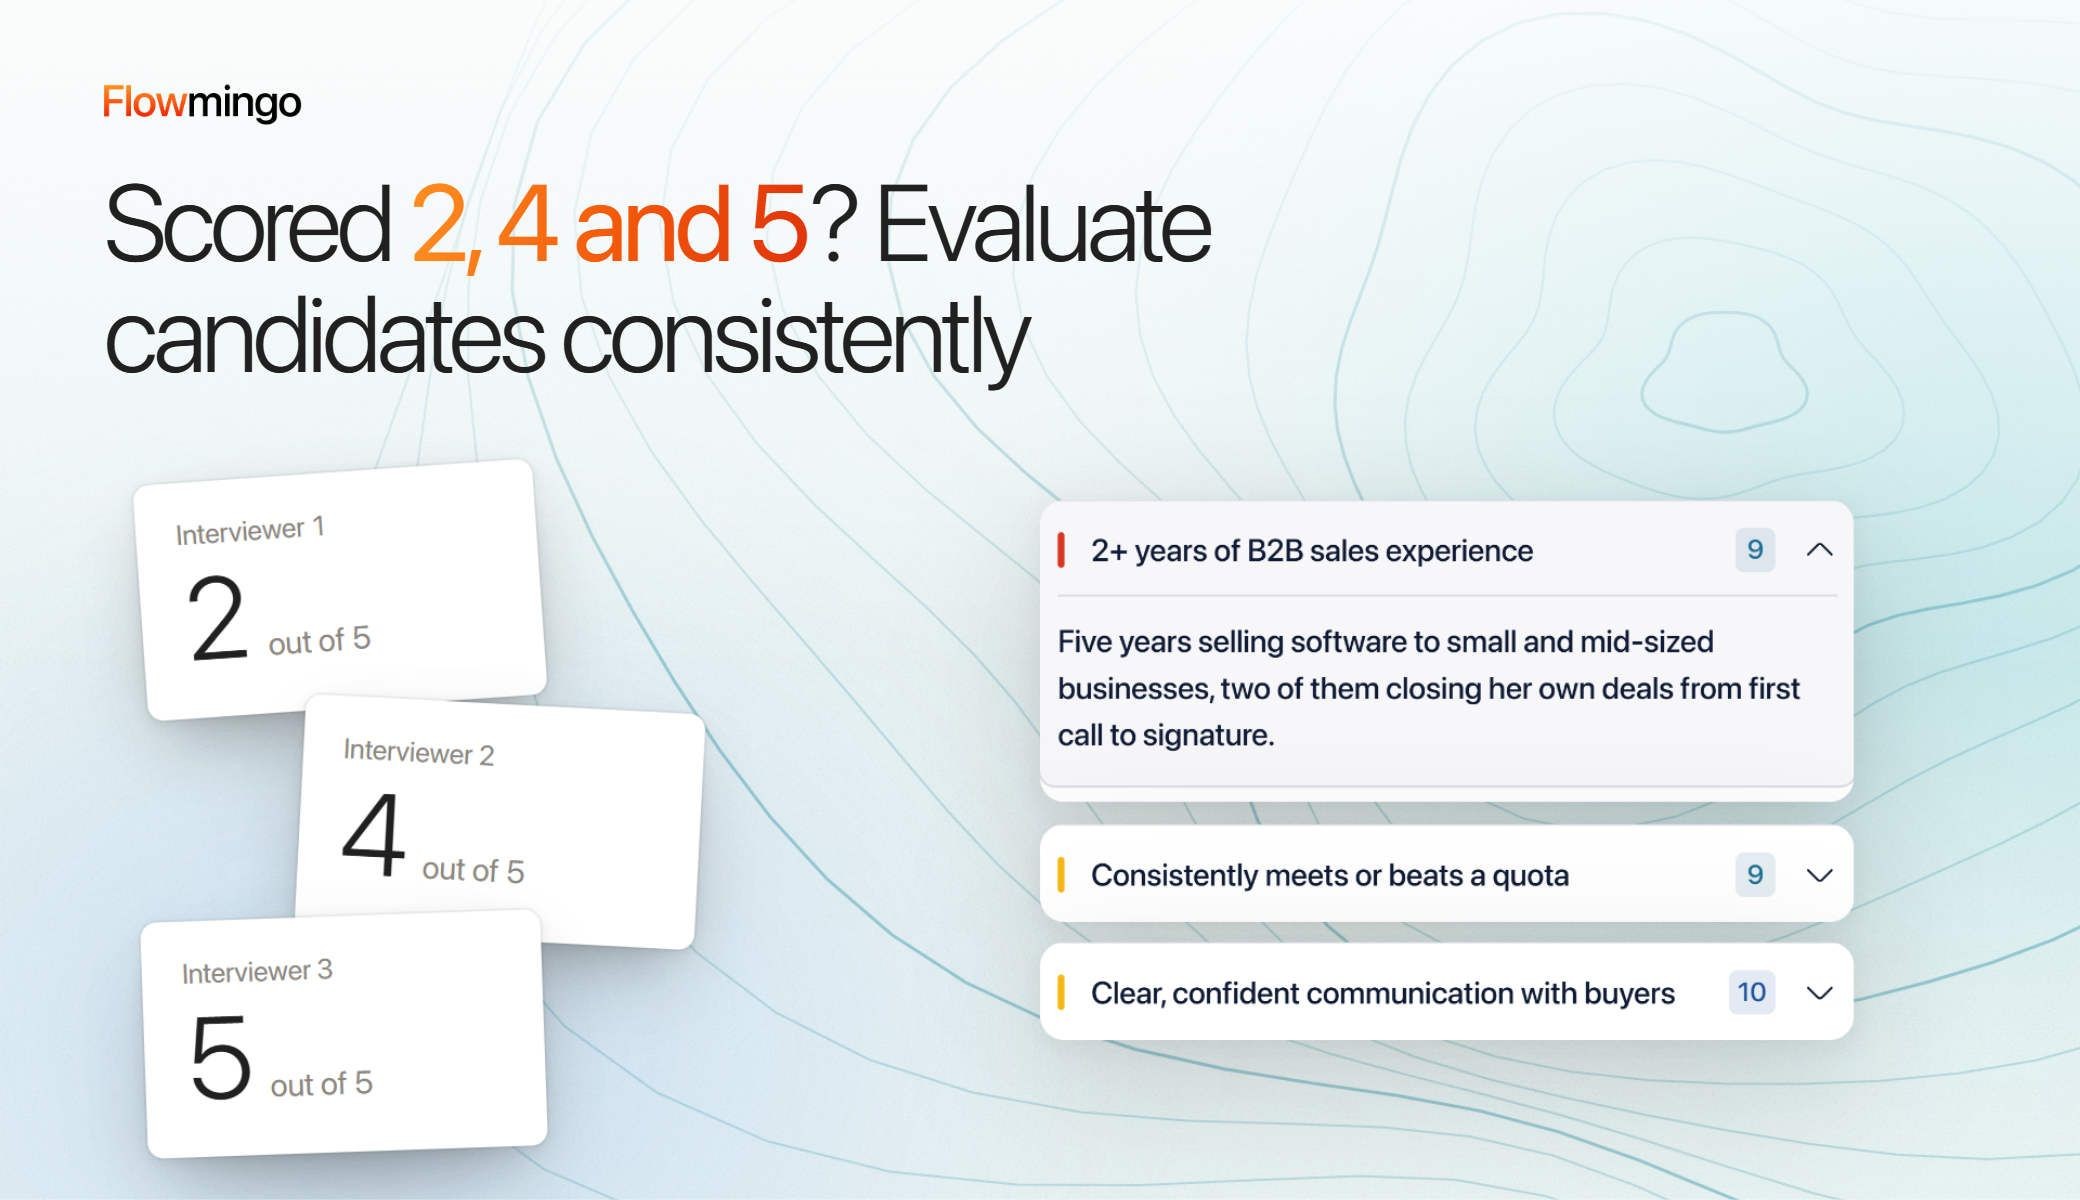
Ваши 3 интервьюера встретились с одной и той же кандидаткой и поставили ей 2, 4 и 5 из 5. Вам нужно оценивать кандидатов последовательно, а разброс в 3 балла по одному кандидату говорит о том, что процесс ещё не налажен.
Такой разброс нормален, это не провал команды. Отдельные интервьюеры согласуются лишь на 0.44 по шкале от 0 до 1, тогда как панель — на 0.74. Поэтому согласованная оценка кандидатов — это то, что нужно проверять, а не предполагать.
Пропустите проверку — и одна небрежная оценка может отдать оффер более слабому финалисту. В разделе 8 так и происходит: 3.67 против 3.53, пока проверка обоснованности не поднимает более сильного до 3.80.
Это руководство добавляет недостающий шаг: проверку с помощью одного вычитания того, что ваши интервьюеры согласуются, прежде чем кто-либо выведет среднее. Наш шаблон оценочной карты интервью описывает форму, а руководство по нашему инструменту обратной связи о собеседовании с кандидатом — как получать пригодные к использованию заметки.
Ключевые выводы
- Мои интервьюеры поставили одному кандидату 2, 4 и 5. Это нормально? Да. Отдельные интервьюеры согласуются гораздо меньше, чем панель, поэтому разрыв в 3 балла — обычное дело. Проверьте его, прежде чем усреднять.
- Что заставляет интервьюеров оценивать одинаково? 4 или 5 критериев из вакансии, письменный ответ на каждую оценку и предварительная 45-минутная калибровка.
- Что показывается до того, как кто-либо заговорит на разборе? Таблица разброса: зафиксированные оценки каждого интервьюера, от каждого по одной цитате. Дальше обсуждаются только разрывы от 2 и более.
- Как проверить согласованность без статистики? Вычтите самую низкую оценку из самой высокой по каждому критерию и возвращайте разрыв от 2 и более (по шкале от 1 до 5) к обоснованию.
- Могут ли веса изменить того, кто получит оффер? Да. В рабочем примере кандидат A выигрывает 3.80 против 3.67 при взвешивании, но проигрывает 3.58 против 4.00 при простом среднем.
1. Мои 3 интервьюера поставили одному кандидату 2, 4 и 5. Как оценивать кандидатов согласованно?
Относитесь к 2, 4 и 5 как к сигналу к проверке, прежде чем усреднять их. Чтобы оценивать кандидатов согласованно, зафиксируйте 6 вещей: критерии, якоря, калибровку, цитаты, оценку по отдельности и проверку разброса.
Сам разброс нормален. Основополагающий метаанализ Хаффкатта с коллегами 2013 года объединил 125 оценок надёжности на основе данных 32 428 человек. Отдельные интервью, проведённые разными людьми, согласовывались лишь на 0.44 по шкале от 0 до 1, тогда как панели — на 0.74.
Это происходит потому, что каждый интервьюер оценивает, исходя из личного представления о том, как выглядит хороший ответ, которое никто не зафиксировал. US OPM утверждает, что структурированность повышает согласованность, ограничивая «объём допустимой свободы действий интервьюера» (OPM).
Так что общие критерии и якоря стоят затраченных усилий. Структурированные интервью заняли первое место среди методов отбора, рассмотренных в основополагающем повторном анализе Сакетта с коллегами 2022 года, даже после более строгих корректировок.
В разделах со 2 по 7 шесть составляющих разбираются по порядку, а в разделе 8 они все применяются к 1 учебной роли, а не к клиентским данным. Там сверка каждой оценки с её цитатой превращает двойку первого интервьюера в четвёрку, так что 2, 4 и 5 становятся 4, 4 и 5.
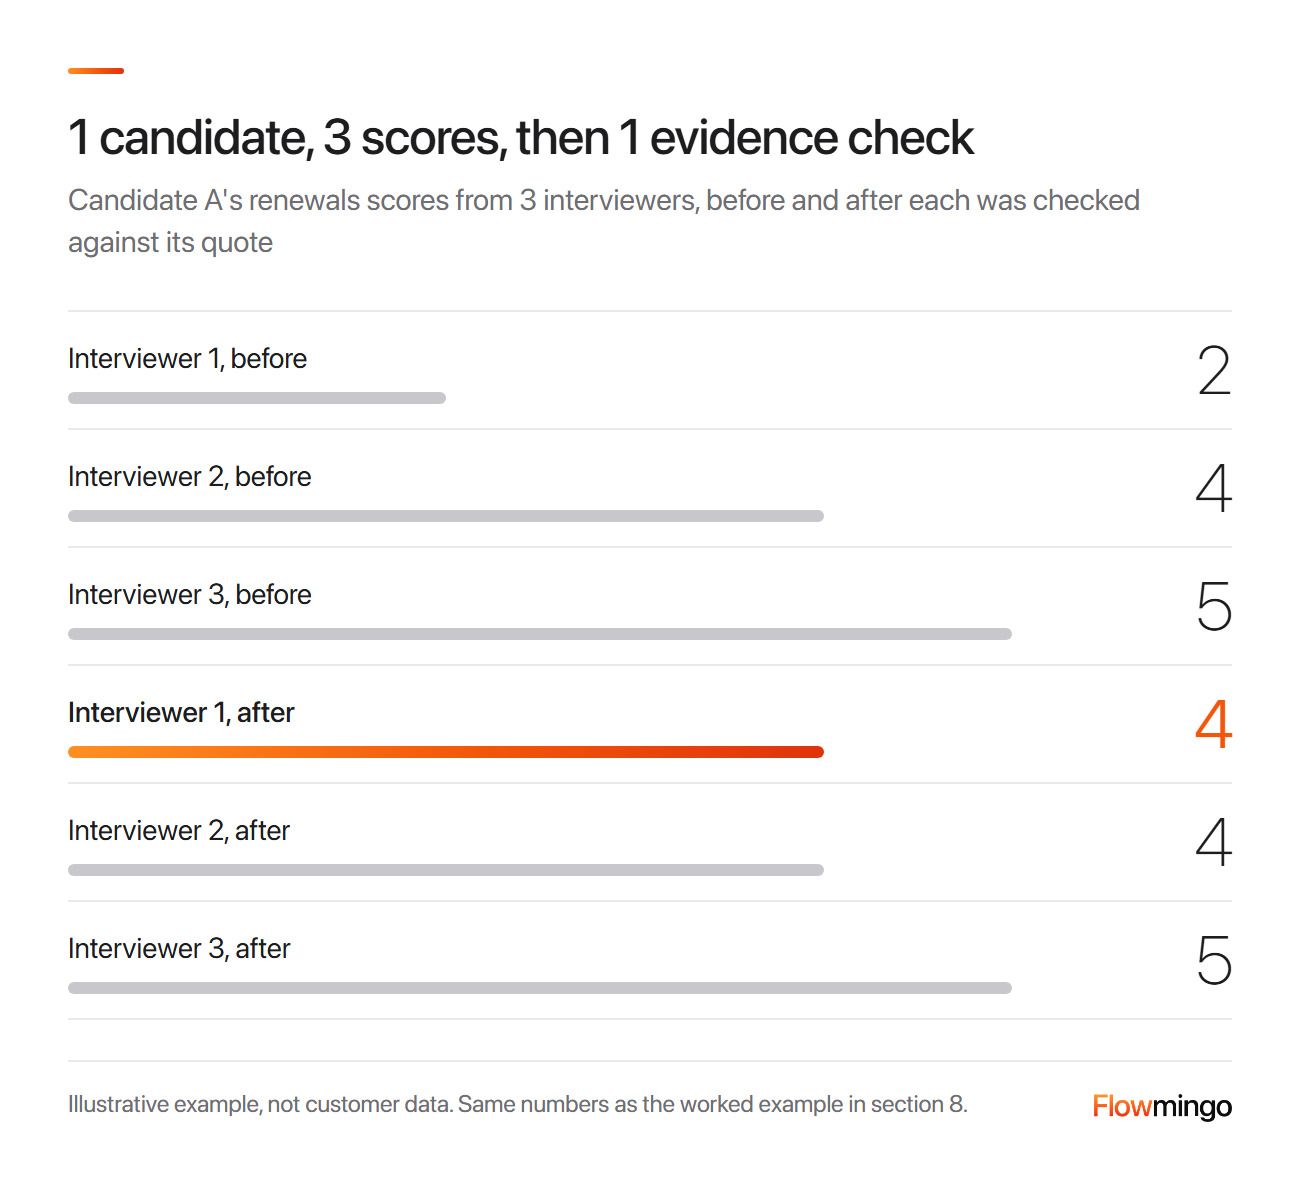
До и после проверки обоснованности: интервьюеры 1, 2 и 3 поставили 2, 4 и 5, затем 4, 4 и 5 (иллюстративный пример).
2. Как превратить описание вакансии в 4 или 5 критериев, которые все оценивают одинаково?
Выберите 4 или 5 результатов, которые должность должна дать за первые 6 месяцев, и сформулируйте каждый так, чтобы кандидат мог его продемонстрировать. Расставьте веса до первого собеседования и используйте их на каждом этапе.
Критерии не работают, когда описывают личность, а не результат: никто не может «услышать» «коммерческое мышление». «Держит продления на плановом уровне» указывает на работу, которую кандидат может описать.
Если нанимающий менеджер говорит, что «поймёт, когда увидит», спросите, что лучший сотрудник на этой должности сделал к третьему месяцу такого, чего не сделал средний. Этот ответ и станет критерием в вашей системе оценки кандидатов.
У любой структуризации есть пределы. В основополагающем мета-анализе 1994 года по 114 оценкам валидности Хафкатт и Артур обнаружили, что после определённого момента дополнительная структура практически ничего не добавляет.
Вот пример роли менеджера по работе с клиентами (Customer Success Manager) — от веса 4 для обязательного критерия до веса 1 для желательного.
| Критерий | Вес | Из описания вакансии | Где проверяется |
|---|---|---|---|
| Держит продления на плановом уровне | Обязательный (4) | Отвечает за продления по B2B-аккаунтам | Резюме, собеседование |
| Успокаивает недовольного клиента | Очень важный (3) | Первая линия при эскалациях | Собеседование |
| Проводит онбординг нового клиента | Важный (2) | Отвечает за онбординг новых аккаунтов | Собеседование, рабочее задание |
| Поддерживает CRM в актуальном состоянии | Желательный (1) | Фиксирует каждый контакт с аккаунтом | Скрининговый вопрос, собеседование |
Последний столбец фиксирует, где проверяется каждый критерий, поэтому ни один этап не оценивает что-то новое. Любой обязательный критерий с оценкой ниже 3 означает отказ — таков минимальный порог из нашего шаблона оценочной карты. Если интервьюеров несколько, применяйте это правило к средней оценке по критерию.
Чем помогает Flowmingo
Вставьте вашу вакансию — и AI Interviewer составит вопросы и взвешенные критерии. Вы можете отредактировать вопросы до того, как приглашать кандидатов. Обязательный критерий весит в 4 раза больше желательного, и Flowmingo никогда не отклоняет кандидатов автоматически (Как мы оцениваем). Проверка резюме использует те же критерии, что и собеседование (FAQ).
3. Как на практике должны выглядеть оценки 1, 3 и 5 по каждому критерию?
Опишите, что должно быть в ответе, который получает 1, 3 и 5: что кандидат сделал и что показал, а не как он себя преподносил. Добавьте по одной примерной строке на каждый балл, чтобы все интервьюеры слушали одно и то же.
Анкоры работают, потому что переносят оценку со вкусовщины на факты. «Отличная энергия» описывает чувство, а «назвал действие и результат» — ответ.
OPM США утверждает, что наиболее структурированные интервью используют «эталоны мастерства» (OPM). В фундаментальном обзоре 2014 года Левашиной и коллег (review) шкалы оценок названы одной из 8 ключевых тем исследования.
Сначала напишите оценки 1, 3 и 5, затем 2 и 4. Вот иллюстративный обязательный критерий для вопроса: «Расскажите о продлении, которое вы чуть не потеряли».
| Оценка | Что содержит ответ | Пример ответа |
|---|---|---|
| 5 | Как 4, плюс то, что кандидат изменил после этого | «После потери 2 клиентов я начал проводить обзоры за 90 дней до продления» |
| 4 | Пример, действие и результат с числом | «Я продлил 38 из 40 аккаунтов, а 2 потерял из-за сокращения бюджета» |
| 3 | Действие и результат, но без числа | «Я организовал звонок с покупателем, и договор продлили» |
| 2 | Действие без результата | «Я бы связался заранее» |
| 1 | Нет примера, только общие утверждения | «Продления — это про отношения» |
| Не показано | Критерий вообще не затронут | Запишите «не показано» и задайте вопрос снова |
Оценка 2 называет действие, а оценка 3 добавляет результат, поэтому два слушателя приходят к одной и той же цифре. HR-руководство Вашингтонского университета (HR guide) просит оценщиков заранее договориться, что отличает оценку 2 от оценки 3, — и именно это фиксирует данный якорь.
По шкале от 1 до 5 тройка — это реальная оценка, поэтому усредняйте только ответы интервьюеров, которые слышали доказательства. Если никто не слышал, задайте вопрос снова до дебрифа.
4. Как провести калибровочную сессию, чтобы мои интервьюеры оценивали кандидатов согласованно?
Запланируйте 45 минут перед первым интервью и попросите всех независимо оценить одни и те же 2 примерных ответа. Затем покажите оценки и перепишите любой якорь, который дал расхождение в 2 или более балла.
Исследователи называют это обучением по формированию единой системы отсчёта. В основополагающем метаанализе 2012 года (meta-analysis), включавшем более чем в 4 раза больше исследований, чем более ранний обзор, Рох и коллеги обнаружили, что оно делает оценки точнее. Наша программа — это наша собственная версия, а не протокол из статьи.
Наше руководство по структурированному интервью использует для калибровки один ответ, а более длинная сессия в нашем руководстве по предвзятости на интервью использует 3. В этой версии используется 2 — минимальное количество, которое показывает, повторяется ли расхождение.
Читайте якоря 5 минут, просмотрите 2 примера ответов 10 минут и в течение 10 минут оценивайте самостоятельно, приводя по одной цитате на каждый. Затем 10 минут показывайте оценки и проверяйте разброс, а затем 10 минут исправляйте якоря.
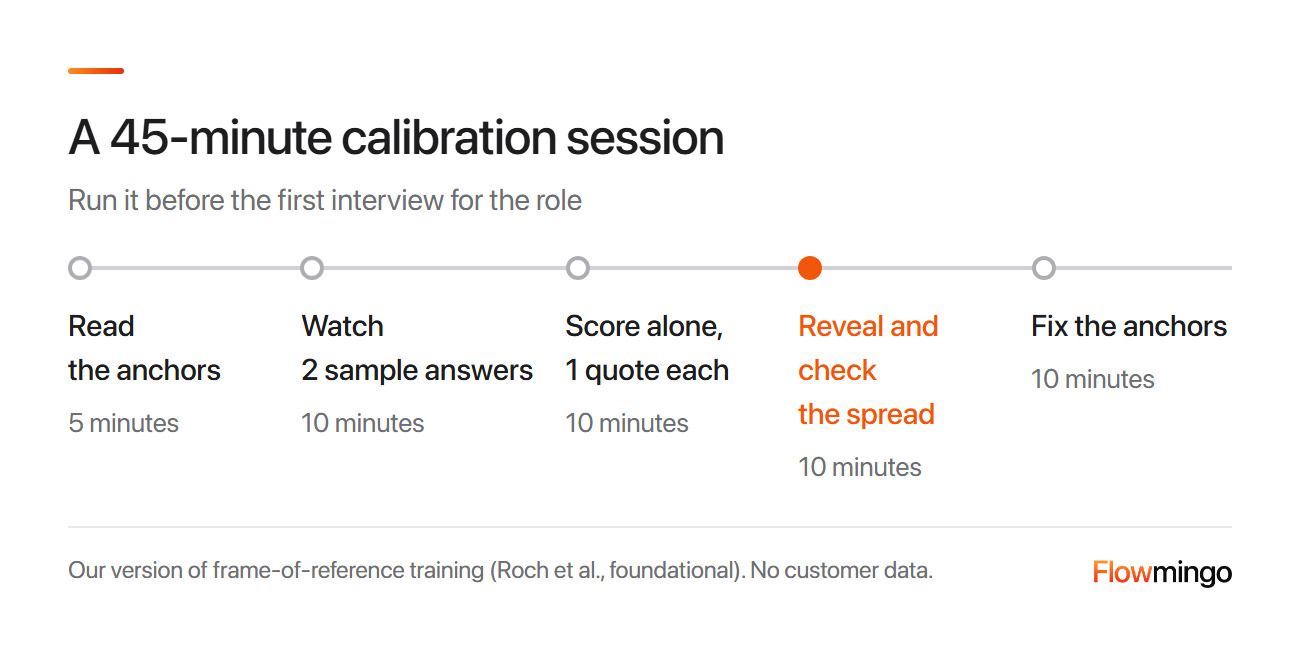
Калибровочная сессия: 5 шагов, 45 минут, с раскрытием оценок и проверкой разброса на шаге 4.
Шаг 4 важнее всего, потому что все слышали одни и те же слова. Поэтому оценка 2 против 4 на одной и той же записи — вина эталона, и вы исправляете формулировку, а не кандидата.
Используйте записанный ответ ранее нанятого сотрудника, который согласился на это, или напишите 2. Перезапускайте сессию, когда присоединяется интервьюер, меняется роль или более чем у 1 из 4 оценок разброс составляет 2 и более.
Нанимая в одиночку, калибруйтесь по себе: оцените 2 записи, затем переоцените их вслепую через неделю. Расхождение в 2 и более означает, что эталон нужно доработать.
5. Как заставить интервьюеров писать обратную связь с доказательствами вместо «хороших впечатлений»?
Сделайте 1 цитату или конкретный пример ценой каждой оценки: нет цитаты — нет оценки. Любой может проверить четвёрку рядом с «Я продлил 38 из 40 своих аккаунтов», и никто не может проверить «хорошие впечатления».
Занятые интервьюеры пишут то, что помнят, а это обычно ощущение. Пост на r/humanresources говорит, что интервьюеры пишут эссе или «хорошие впечатления» вместо оценок.
В 3 основополагающих исследованиях 2013 года studies Дана, Доус и Петерсон обнаружили, что люди формируют впечатления с той же уверенностью на основе случайных ответов, что и на основе реальных. Участниками были студенты, предсказывавшие оценки, поэтому связь с наймом — это аналогия.
Поэтому просите заметку из 3 строк по каждому критерию: оценка, слова кандидата и что было нужно для следующей оценки. Например, в заметке Интервьюера 2 о Кандидате А стоит оценка 4, цитата «Я продлил 38 из 40 своих аккаунтов» и дополнение «без изменений после 2 проигрышей».
Собирайте заметки в течение 24 часов, пока ответы свежи в памяти. Руководство по персоналу Йельского университета guide просит проводить оценки в течение 1 дня.
Пишите каждую заметку так, как будто её прочитает кандидат, потому что в Великобритании он может запросить её (раздел 9). Наши шаблоны писем об отказе кандидату превращают заметки в 1 честное сильное качество и 1 пробел.
Как помогает Flowmingo
В отчёте об AI-интервью Flowmingo каждая оценка по критерию сопровождается письменными обоснованиями, сильными сторонами и пробелами, а также записью и полной расшифровкой (FAQ). Выделенный фрагмент должен быть точной фразой из расшифровки, а пересказ не считается цитатой (Как мы оцениваем).
6. Должны ли мои интервьюеры выставлять оценки самостоятельно перед разбором или сначала всё обсудить?
Сначала всегда оценивайте по отдельности. Каждый интервьюер отправляет оценки и цитаты, не видя чужих, затем разбор обсуждает только расхождения, а формула объединяет остальное.
Высказывание первым позволяет одному мнению задать планку. Основополагающая книга 2021 года Noise, авторы Канеман, Сибони и Санстейн, называет независимость одним из 3 принципов структурированного суждения (цитируется в читательских выдержках). OPM США требует, чтобы члены панели оценивали «ответы кандидатов индивидуально» до группового обсуждения (OPM).
В основополагающем мета-анализе Конвея с коллегами 1995 года несколько оценок помогали только тогда, когда их объединяло фиксированное правило, и не было доказательств пользы от обсуждения.
В основополагающем мета-анализе Кунсела с коллегами 2013 года фиксированная формула предсказывала эффективность работы более чем на 50% лучше, чем люди, взвешивающие всё в уме. Это сохранялось даже для экспертов, знающих должности, а данные объединяли многие виды отборочной информации.
Проводите разбор в таком порядке: каждый читает свою цитату, оценка меняется только относительно якоря, и самый старший участник говорит последним.
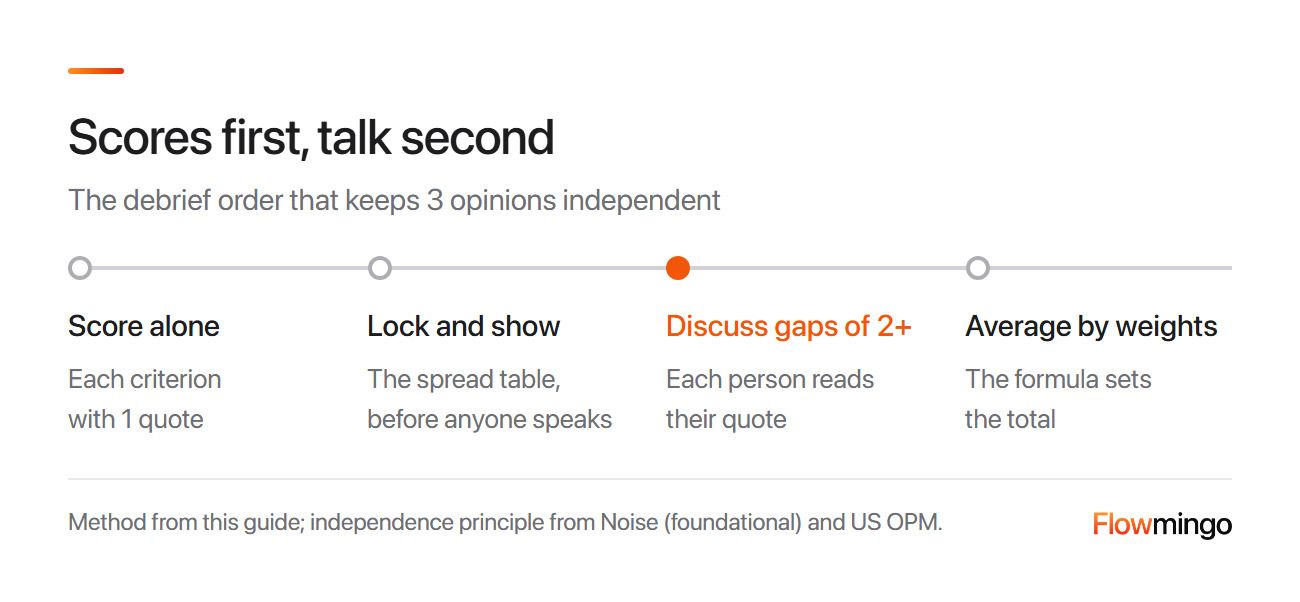
Порядок разбора: сначала самостоятельная оценка, зафиксируйте и покажите таблицу расхождений, обсудите расхождения от 2+, затем усредните по весам.
6.1 Должна ли моя панель проводить собеседования вместе или раздельно, и сколько интервьюеров мне нужно?
Подходит любой вариант, если каждый оценивает самостоятельно. В мета-анализе Хаффкатта (раздел 1) панели согласовывались гораздо лучше, вероятно, отчасти потому, что все участники панели видят одну и ту же работу, — по нашему прочтению.
Раздельные собеседования дают больше независимых взглядов. Сингапурский справочник TAFEP рекомендует по возможности более одного интервьюера и разнообразную панель, чтобы помочь минимизировать предвзятость.
Поэтому используйте до 4 интервьюеров в отдельных раундах, один из них — специалист. Каждый задаёт один и тот же основной вопрос по каждому критерию и оценивает каждый критерий, а специалист также глубже исследует одно обязательное требование.
Никогда не разделяйте критерии: одна оценка на критерий не даёт проверке расхождений ничего для сравнения. Пятый добавляет разногласий больше, чем доказательств, — наше эмпирическое правило.
7. Как проверить, действительно ли мои интервьюеры согласуются между собой, без степени по статистике?
Вычтите самую низкую оценку из самой высокой по каждому кандидату и критерию. По шкале от 1 до 5 разрыв в 2 балла и более возвращает нас к фактическим данным.
Проверка 1: разброс. Сигнальная разница в 2 балла — наше эмпирическое правило. OPM предписывает комиссиям сначала выставлять оценки независимо, а затем устранять «существенные расхождения в оценках»; для нас существенное расхождение — это 2 балла.
На рисунке оценки кандидата A по продлениям — 2, 4 и 5 — дают разброс 3 балла, тогда как по остальным трём критериям оценки сходятся в пределах 1 балла.
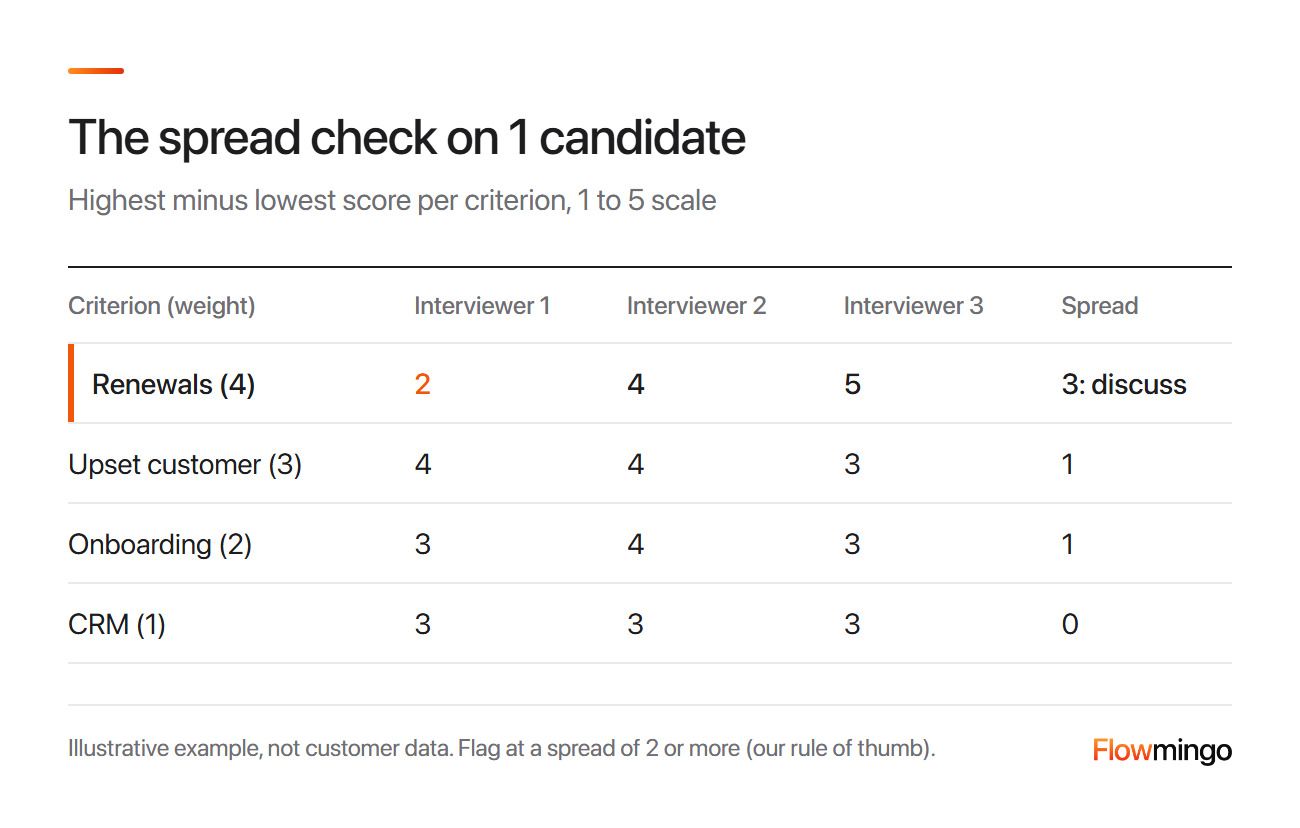
Проверка разброса, иллюстрация: продления дают разброс 3 балла и возвращаются к фактическим данным, тогда как остальные три критерия сходятся в пределах 1 балла.
Проверка 2: смещение интервьюера. На выборке из 10+ кандидатов вычтите средний балл команды из среднего балла каждого интервьюера. На рисунке средние интервьюеров 1, 2 и 3 равны 3.1, 3.6 и 4.4, а среднее по команде — 3.7.
Их смещения — -0.6, -0.1 и +0.7. Смещение больше 0.5 в любую сторону, по нашему эмпирическому правилу, требует калибровки один на один, а не порицания, поэтому интервьюеры 1 и 3 получают по одной такой калибровке.
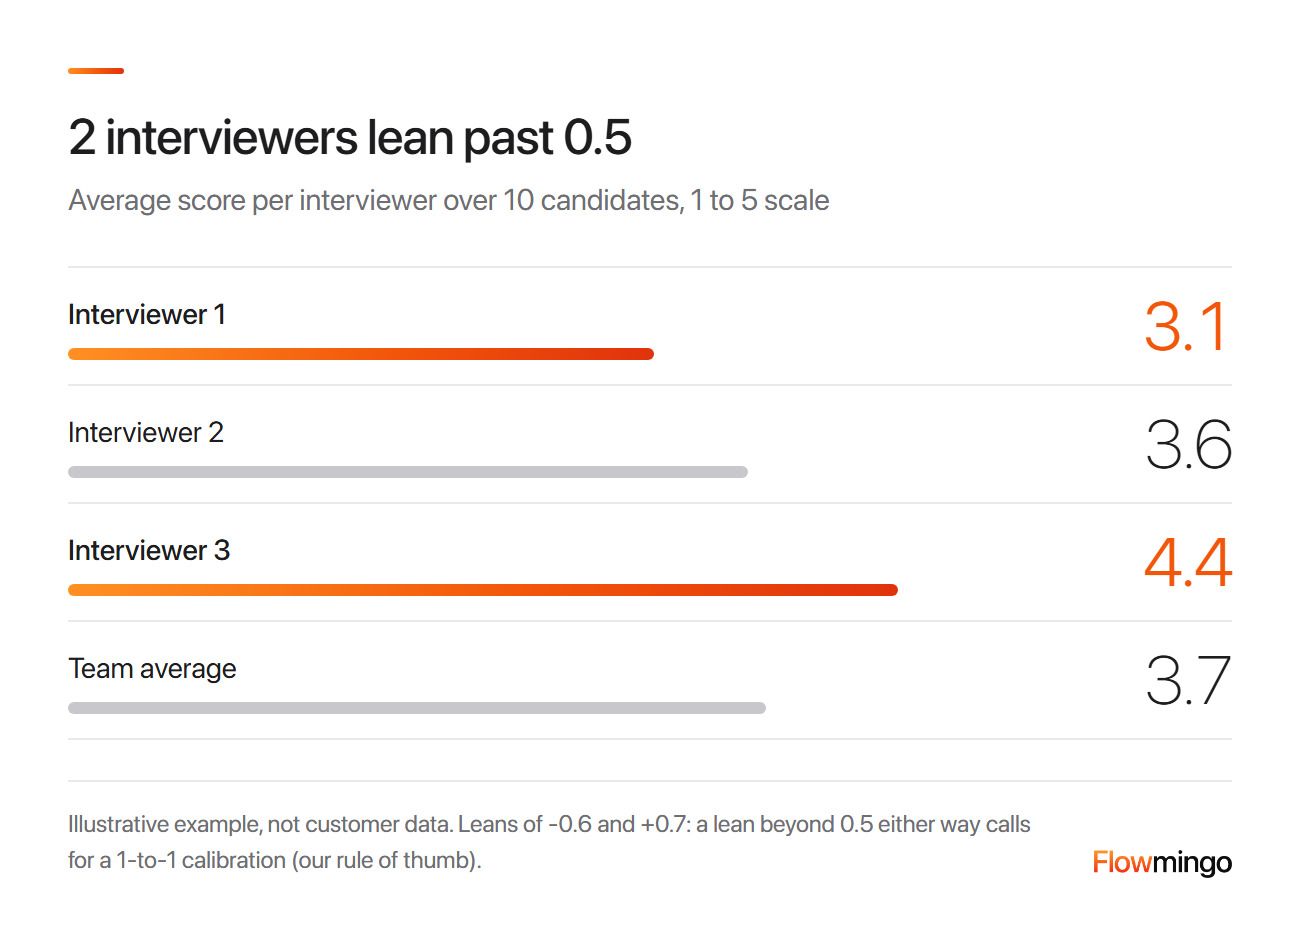
Смещение интервьюера, иллюстрация: средние интервьюеров 1 и 3 — 3.1 и 4.4 при среднем по команде 3.7, смещения -0.6 и +0.7.
Проверка 3: доля помеченных оценок. Если в раунде более одной из четырёх оценок попадает в помеченный разрыв, проводим повторную калибровку — это наше эмпирическое правило.
Например, 3 интервьюера, оценивающих 5 кандидатов по 4 критериям, дают 60 оценок, и 18 оценок попадают в помеченные разрывы — это 30%. Это указывает на нечёткие якоря, поэтому исправляйте якоря, а не людей.
Процент прохождения по группам — это отдельная проверка, в разделе 9 и в нашем руководстве по предвзятости на собеседованиях.
8. Можно ли увидеть проработанный пример того, как последовательно оценивать кандидатов, от вакансии до решения?
Да: одна иллюстративная роль менеджера по успеху клиентов, не реальные данные клиентов, с 4 взвешенными критериями, 3 интервьюерами и 2 финалистами. До проверки одна непроверенная оценка 2 отдаёт должность B: 3.67 против взвешенных 3.53 у A.
Проверка разброса отмечает баллы A за продления: 2, 4 и 5. Интервьюер 1 поставил 2, потому что A «казался неуверенным», но в той же заметке приводится цитата: «Я продлил 38 из своих 40 аккаунтов».
Это соответствует опорной оценке 4, поэтому оценка меняется на 4. Интервьюер 3 оставляет 5, потому что A добавил в этом раунде: «После потери 2 аккаунтов я начал проводить обзоры за 90 дней до продления». Интервьюер 2 этого не слышал, поэтому итоговые 4, 4 и 5 имеют разброс 1.
| Критерий (вес) | A: интервьюеры 1, 2, 3 | Среднее A | B: интервьюеры 1, 2, 3 | Среднее B |
|---|---|---|---|---|
| Продления (4) | 4, 4, 5 (было 2, 4, 5) | 4.33 (было 3.67) | 3, 3, 3 | 3.00 |
| Недовольный клиент (3) | 4, 4, 3 | 3.67 | 3, 4, 4 | 3.67 |
| Онбординг (2) | 3, 4, 3 | 3.33 | 4, 5, 4 | 4.33 |
| CRM (1) | 3, 3, 3 | 3.00 | 5, 5, 5 | 5.00 |
| Взвешенный итог | 3.80 (было 3.53) | 3.67 | ||
| Простое среднее | 3.58 (было 3.42) | 4.00 |
Сумма для A: (4.33 x 4 + 3.67 x 3 + 3.33 x 2 + 3.00 x 1) / 10 = 3.80.
Без весов 2 второстепенных критерия B принесли бы ему победу: 4.00 против 3.58.
Оба проходят обязательный минимальный порог 3, B — ровно, поэтому A получает предложение благодаря более высокому итогу. Именно так вы последовательно оцениваете кандидатов: данные подпитывают формулу, а формула решает.
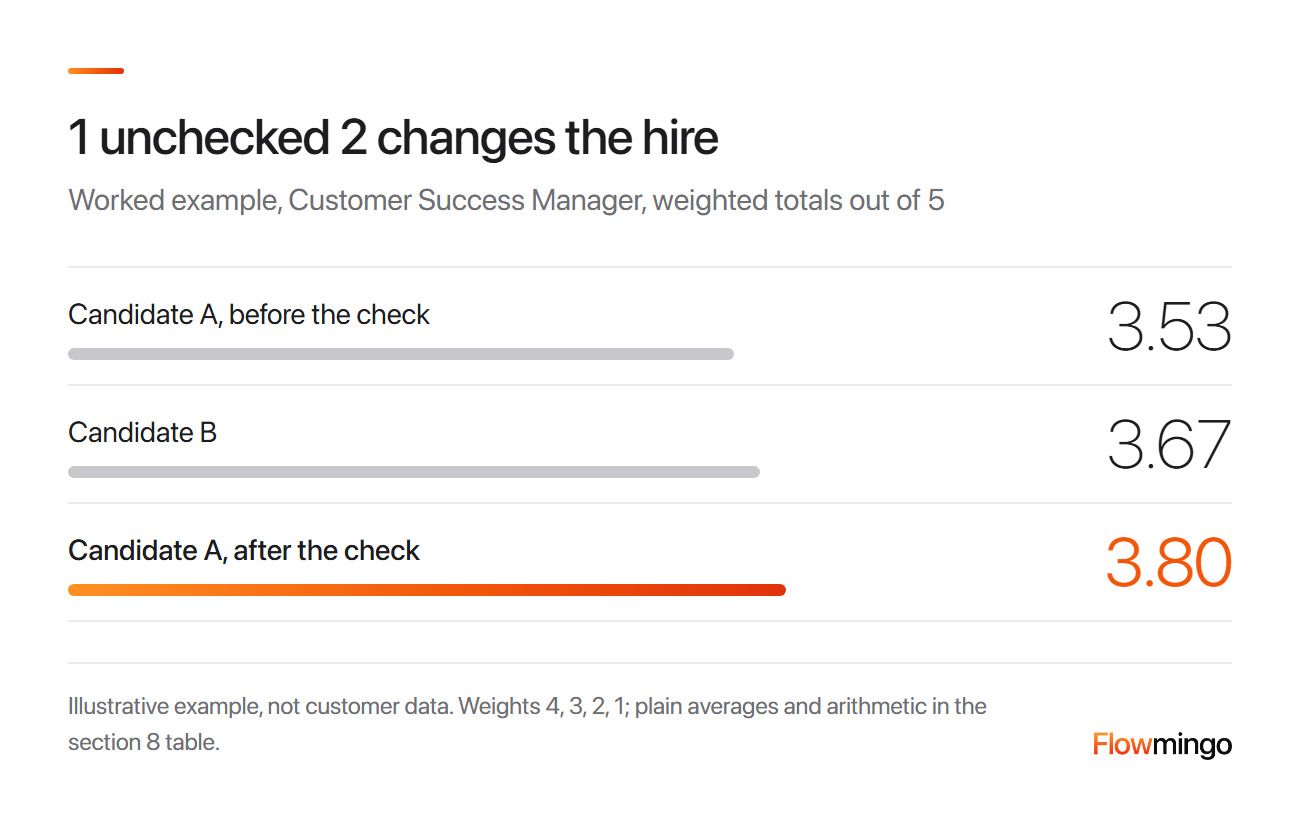
Взвешенные итоги, для иллюстрации: кандидат A переходит от 3.53 до проверки к 3.80 после неё, обходя кандидата B с 3.67. Без весов B лидировал бы со счётом 4.00 против 3.58.
8.1 Как выбрать между 2 финалистами, если их баллы близки?
Считайте взвешенные итоги по шкале от 1 до 5, отличающиеся менее чем на 0,1, равными — это наше эмпирическое правило. A и B разделяют 0,13, так что это не ничья, но при реальной ничьей преимущество получается в таком порядке:
- Средняя оценка по обязательным критериям: у A 4,33 против 3,00 у B.
- Закройте самый широкий из ещё открытых разбросов, затем сравните снова.
- Короткое рабочее задание по самому слабому обязательному критерию.
Никогда не разрешайте ничью по наитию или из-за «культурного соответствия», как объясняется в нашем руководстве о предвзятости на собеседованиях, и записывайте причину.
9. Что нужно сохранить, чтобы решение о найме устояло, если отклонённый кандидат его оспорит?
Сохраняйте критерии и веса, оценки каждого интервьюера с цитатами, проверку разброса и обоснование решения. Храните их не менее 12 месяцев после решения, а дольше — если претензия ещё открыта.
Это общая информация, а не юридическая консультация.
В США федеральные органы рассматривали долю прошедших ниже 4/5 (80%) от доли в лучшей группе как свидетельство неблагоприятного воздействия (29 CFR 1607.4). Так, 20 из 100 прошедших против 30 из 100 дают 67% — по этому эмпирическому правилу стоит присмотреться внимательнее.
По состоянию на 2 ноября 2026 года это правило из основополагающих Единых рекомендаций 1978 года всё ещё действует в eCFR. Заключение Минюста от 9 июня 2026 года и правило OPM от июля 2026 года уводят федеральные органы от этого правила.
В повестке EEOC запланирована их отмена в ноябре 2026 года, но Раздел VII и частные иски остаются. Поэтому сохраняйте доли прошедших по группам — там, где это законно, — как собственный мониторинг.
Отдельно 29 CFR 1602.14 требует от подпадающих под действие работодателей хранить кадровые записи в течение 1 года с момента создания записи или принятия решения — в зависимости от того, что наступит позже. После подачи жалобы храните их до окончания разбирательства.
В Великобритании Закон о равенстве запрещает дискриминацию при решении «кому предложить работу» (s39). Если факты указывают на дискриминацию, суд обязан признать её, если работодатель не докажет обратное (s136).
EHRC рекомендует хранить записи собеседований 12 месяцев, поскольку они могут показать, что вы не дискриминировали. По требованиям, возникшим с 1 октября 2026 года, большинство исков должно быть подано в течение 6 месяцев минус 1 день (Acas).
В проекте руководства ICO guidance говорится, что кандидаты могут запросить заметки с собеседования. Поэтому фиксируйте только то, что нужно для найма, и храните записи дольше срока подачи претензий только по явной деловой причине.
В Сингапуре справочник TAFEP требует критериев, основанных на заслугах, чек-листа с оценкой по каждому критерию и хранения записей не менее 1 года. Принятый в январе 2025 года Закон Сингапура о справедливости на рабочем месте (MOM) запретит решения о найме на основе 5 групп характеристик с конца 2027 года — целевой срок MOM (MOM).
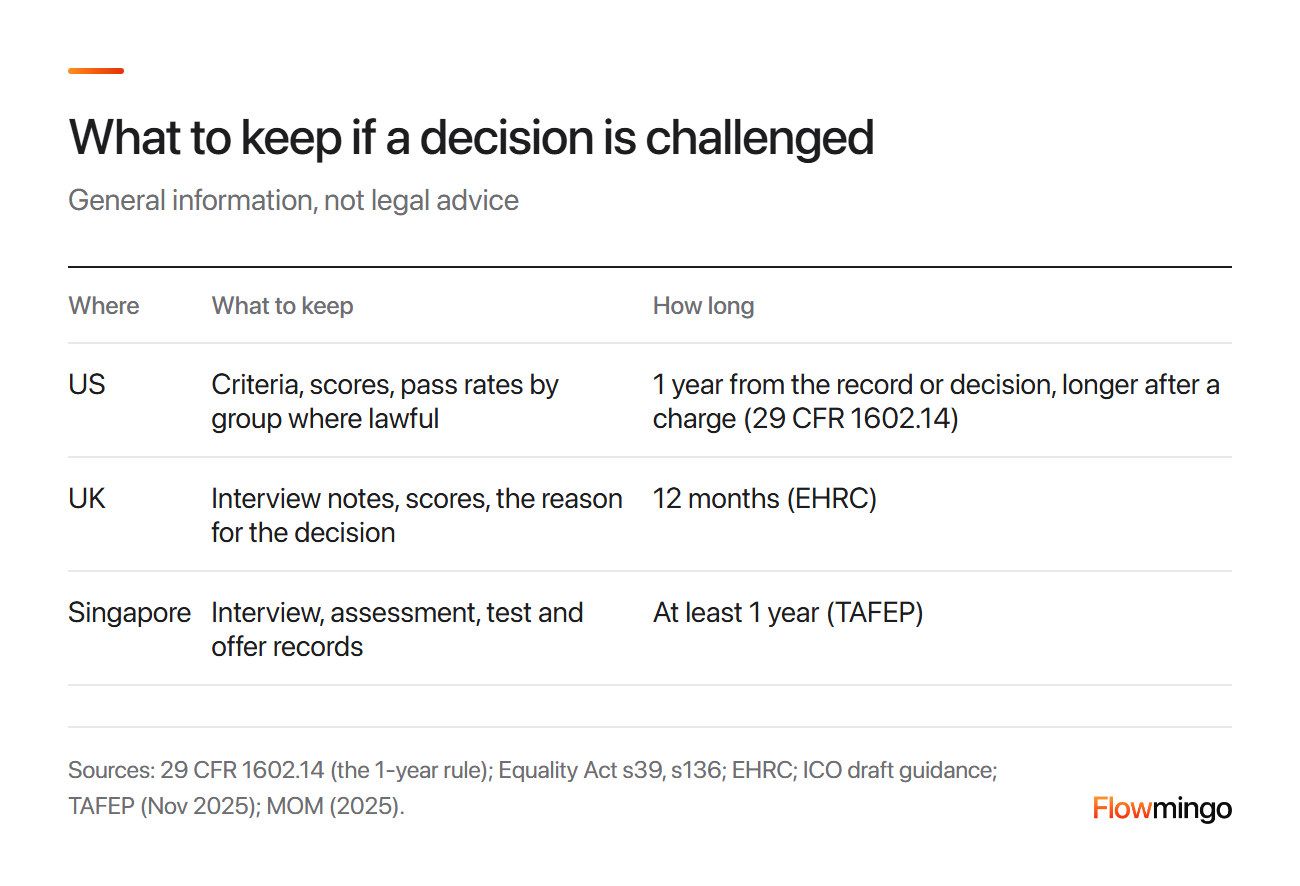
Записи по странам: храните заметки, оценки и причину — 12 месяцев в Великобритании (EHRC) и не менее 1 года в США и Сингапуре.
Пишите каждую заметку так, будто её увидит суд или кандидат. «Пролонгации 2: кандидат сказал, что „свяжется заранее“, но не назвал результат, поэтому не 3» — проходит. «Не подходит» — не проходит, потому что не указывает ни на что, что нужно для работы.
9.1 Законно ли задавать кандидатам разные вопросы?
Ни одно из этих правил США, Великобритании или Сингапура не требует дословно одинаковых вопросов, но разные вопросы сравнивать сложнее.
Согласно Разделу VII, вопрос, заданный только представителям одного пола, расы или другой защищённой группы, сам по себе является доказательством дискриминации. EEOC называет вопросы о семье «явно дискриминационными», если их задают только женщинам, и подозрительными, если их задают всем (EEOC). Единые руководящие принципы, по-прежнему действующие в eCFR (раздел 9), считают даже неформальное собеседование процедурой отбора (29 CFR 1607.16).
На практике задавайте всем один и тот же основной вопрос, например вопрос о продлении из раздела 3. Уточняющие вопросы могут различаться, если ответ неполный, при условии, что они остаются в рамках критерия.
Если вам пришлось изменить вопрос, например для адаптации под инвалидность, зафиксируйте, что изменилось и почему.
10. Может ли оценка ИИ-собеседования помочь мне последовательно оценивать кандидатов, и как её проверить?
Она помогает, хотя мы не измеряли, насколько, потому что все кандидаты на должность отвечают на одни и те же вопросы по одним и тем же письменным критериям. Относитесь к ней как к четвёртому интервьюеру, а не как к судье.
ИИ-собеседование устраняет 2 источника отклонений: разных интервьюеров и разные дни. Оно не делает предвзятость невозможной, и его уточняющие вопросы всё ещё различаются, поэтому проверяйте его с помощью нашей выборочной проверки на 10 кандидатах.
| Шаг | Что делать | Критерий прохождения |
|---|---|---|
| 1 | 2 человека оценивают 10 недавних кандидатов на 1 роль, не видя оценок ИИ | -- |
| 2 | Проверка разброса: сначала человек против человека, затем человек против ИИ | Менее 2 по шкале от 1 до 5 или менее 3 при сравнении со шкалой ИИ от 0 до 10 после удвоения оценки человека |
| 3 | Откройте цитату, стоящую за каждым расхождением | Точные слова кандидата |
| 4 | Исправьте формулировку критерия или его вес | Расхождения уменьшаются в следующем раунде |
Если ИИ и ваши интервьюеры продолжают расходиться по одному критерию, исправьте его формулировку один раз, а не переопределяйте оценки по одной.
Данные Flowmingo · 44,665 кандидатов с оценкой ИИ-собеседования, в 700 наборах собеседований с 10+ оценёнными кандидатами, в 317 компаниях; собеседования завершены с 9 июля по 31 октября 2026 года (текущая система оценки)
- Около 2.8 балла из 10 занимают средние 80% кандидатов в типичном наборе, так что оценки по-прежнему разделяют людей.
- 6.1 из 10 — средняя оценка медианного набора, но 1 набор из 10 имеет среднюю 4.8 или меньше, а 1 из 10 — 7.1 или больше.
- Около 1.2 балла разделяют наборы компании с самым высоким и самым низким средним на уровне медианы, среди 127 компаний.
- 6,391 из этих кандидатов в 277 компаниях получили от 7.0 до 7.4, и типичный из них набрал больше, чем 70% остальных в своём наборе.
- 1 из 10 из них набрал больше, чем не более 46% остальных в своём наборе. Для ещё одного 1 из 10 этот показатель составил около 89% или больше.
Это оценки ИИ-собеседований Flowmingo, а не результативность на работе. Наборы различаются по роли, критериям и пулу кандидатов, поэтому разные средние не указывают на непоследовательную оценку. Разброс не является доказательством правильного порядка, и некоторые собеседования завершились досрочно.
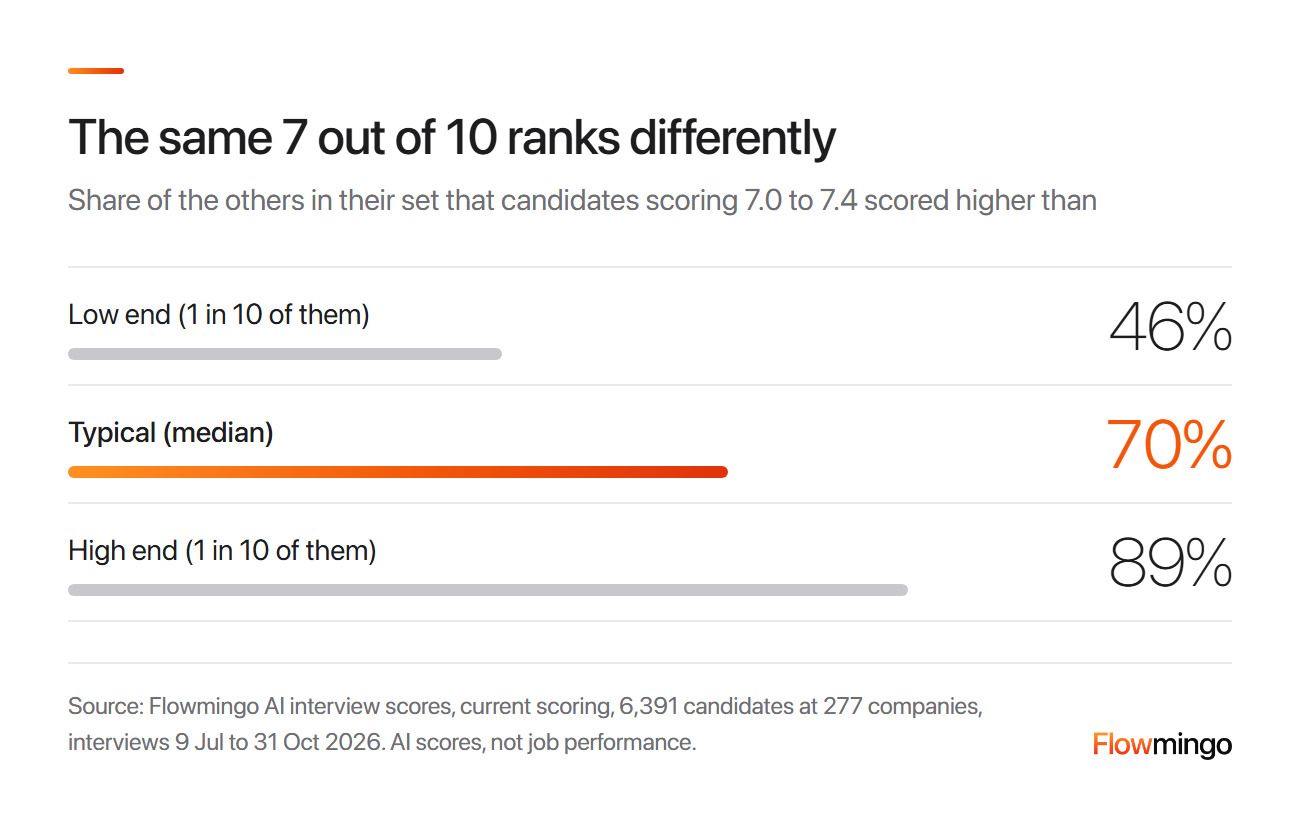
Одинаковый балл, разный ранг: кандидаты с оценкой от 7.0 до 7.4 в медианном наборе набрали больше, чем 70% остальных в своём наборе. На нижнем и верхнем краях — по 1 из 10 — это было 46% и 89%.
Представьте 3 кандидатов с одинаковым баллом 7.2. Он расположен заметно выше середины типичного набора, примерно в середине сильного и близко к вершине слабого. Поэтому ранжируйте кандидатов внутри их собственного набора и никогда не используйте один фиксированный порог для разных ролей.
Основополагающий Закон ЕС об ИИ 2024 года также относит ИИ, используемый для оценки кандидатов, к высокорисковым (Приложение III), так что проверять его таким образом разумно.
Для каждой роли проверка разброса делает средний балл безопаснее в использовании, потому что она возвращает расходящиеся оценки к их цитатам.
Как Flowmingo помогает
В AI Interviewer каждый кандидат на роль получает один и тот же набор вопросов. Каждое требование получает оценку от 0 до 10, взвешенную по вашим настройкам (Как мы оцениваем). Ваша команда может переопределить любую оценку (FAQ). Проведите бесплатную проверку на 10 кандидатах в Flowmingo и оценивайте кандидатов последовательно.
11. Источники
Все исследования, законы и руководства, указанные выше, перечислены в алфавитном порядке по авторам. Цифры Flowmingo получены из данных собственной платформы Flowmingo.
- Acas (2026, обновлено 1 октября). Сроки давности обращения в трудовой трибунал. Acas.
- Conway, J. M., Jako, R. A., & Goodman, D. F. (1995). Мета-анализ надежности отборочных интервью: согласованность оценок разных интервьюеров и внутренняя согласованность. Journal of Applied Psychology, 80(5), 565-579.
- Dana, J., Dawes, R., & Peterson, N. (2013). Вера в неструктурированное интервью: стойкость иллюзии. Judgment and Decision Making, 8(5), 512-520.
- Equal Employment Opportunity Commission и др. (1978). Единые рекомендации по процедурам отбора персонала, 29 CFR Part 1607. eCFR, проверено 2 ноября 2026 г.
- Equal Employment Opportunity Commission (б. д., дата обращения: 2 ноября 2026). Вопросы при приеме на работу и семейное положение или количество детей. EEOC.
- Equal Employment Opportunity Commission (2026). Отмена Единых рекомендаций по процедурам отбора персонала, RIN 3046-AB43. Unified Agenda, через Wayback Machine (копия от 19 октября 2026 г.).
- Equality and Human Rights Commission (б. д.). Что закон о равенстве означает для вас как работодателя: когда вы нанимаете кого-либо на работу. EHRC.
- Европейский союз (2024). Закон об искусственном интеллекте, Приложение III: ИИ-системы высокого риска. AI Act Explorer.
- Huffcutt, A. I., & Arthur, W., Jr. (1994). Пересмотр работы Хантера и Хантера (1984): валидность интервью для должностей начального уровня. Journal of Applied Psychology, 79(2), 184-190.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Надежность собеседования при приеме на работу: новые мета-аналитические оценки по структуре и формату. International Journal of Selection and Assessment, 21(3), 264-276.
- Information Commissioner's Office (б. д., дата обращения: 2026). Составление короткого списка, тестирование и собеседования с кандидатами и Хранение записей о найме [Проект руководства, на рассмотрении]. ICO.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021; в мягкой обложке 2022). Шум: несовершенство человеческих суждений. Little, Brown Spark. Отрывок о трех принципах цитируется в читательских заметках, Goodreads.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Механическое и клиническое комбинирование данных при решениях об отборе и зачислении: мета-анализ. Journal of Applied Psychology, 98(6), 1060-1072.
- Legal Information Institute (дата обращения: 2 ноября 2026). 42 USC 2000e-2, незаконная практика найма. Cornell Law School.
- Legal Information Institute (дата обращения: 2 ноября 2026). 29 CFR 1602.14, хранение создаваемых или хранимых записей, 29 CFR 1607.4, информация о воздействии и 29 CFR 1607.16, определения. Cornell Law School.
- Levashina, J., Hartwell, C. J., Morgeson, F. P., & Campion, M. A. (2014). Структурированное собеседование при приеме на работу: нарративный и количественный обзор исследовательской литературы. Personnel Psychology, 67(1), 241-293.
- Министерство кадров Сингапура (8 января 2025). Принятие законопроекта о справедливости на рабочем месте — следующий шаг к созданию справедливых и гармоничных рабочих мест. MOM.
- Министерство кадров Сингапура (4 ноября 2025). Законопроект о справедливости на рабочем месте (разрешение споров) [Пресс-релиз]. MOM.
- r/humanresources (26 июля 2026). Интервьюеры никогда не заполняют оценочные формы. Что в итоге исправило ситуацию в вашей команде? [Сообщение на онлайн-форуме]. Reddit.
- Roch, S. G., Woehr, D. J., Mishra, V., & Kieszczynska, U. (2012). Обучение оценщиков: обновленный мета-аналитический обзор обучения по методу системы отсчета. Journal of Occupational and Organizational Psychology, 85(2), 370-395.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Пересмотр мета-аналитических оценок валидности при отборе персонала: устранение систематической перекорректировки на ограничение диапазона. Journal of Applied Psychology, 107(11), 2040-2068.
- Tripartite Alliance for Fair and Progressive Employment Practices (ноябрь 2025). Руководство по справедливому найму и отбору. TAFEP.
- Парламент Соединенного Королевства (2010). Закон о равенстве 2010 года, раздел 39 и раздел 136. legislation.gov.uk, через Wayback Machine.
- Министерство юстиции США, Управление юридического советника (9 июня 2026). Конституционность ответственности за непропорциональное воздействие по разделу VII. DOJ.
- Управление кадровой службы США (31 июля 2026). Удаление ссылок на Единые рекомендации по процедурам отбора персонала из федеральных кадровых нормативных актов. Federal Register, 91 FR 48234.
- Управление кадровой службы США (б. д.). Структурированные собеседования. OPM.
- Вашингтонский университет (б. д.). Советы и рекомендации по оценке кандидатов. UW Human Resources.
- Йельский университет (б. д.). Как эффективно оценивать кандидатов и принимать окончательное решение о выборе (FL-HR-069). Yale Human Resources.