3 інтерв'юери, 1 фіналіст, 3 вердикти. Без оцінювального листа для інтерв'ю найгучніший голос під час обговорення обирає кандидата.
Немає до чого повернутися — жодної форми оцінювання кандидата. Тож ніхто не може пояснити офер вашому CEO або відхиленому кандидату, який запитує.
Без спільної форми зайняті люди покладаються на інтуїцію.
А інтуїтивні рішення слабші, ніж здається, як показує Noise Канемана та його співавторів.
Припустімо, ви знаєте лише те, що один кандидат пройшов інтерв'ю краще за іншого. Імовірність, що він справді кращий найм, становить лише 56–61% — ледь краще за підкидання монети.
Оцінювальний лист вирішує це в 3 кроки. Кожен інтерв'юер самостійно оцінює ті самі 4–6 навичок за письмовими прикладами ще до обговорення. Далі вирішує загальна сума, якщо не провалено обов'язковий мінімум.
Ключові висновки
- Чи справді оцінювальний лист веде до кращого найму? Так, якщо кожен інтерв'юер оцінює ті самі навички за письмовими прикладами. Інтерв'ю, проведені так, передбачали ефективність роботи приблизно вдвічі краще, ніж вільні формати, згідно з оглядом 2022 року.
- Скільки навичок він має оцінювати? 4–6, кожну за шкалою від 1 до 5 з письмовим прикладом відповіді для кожного рівня. Будь-який обов'язковий мінімум нижче 3 означає відмову в наймі.
- Як вибрати між 2 фіналістами з однаковими балами? Спершу перевірте обов'язкові мінімуми, потім обговоріть розбіжність 2 проти 5 на основі доказів. Не голосуйте повторно на відчуттях: фіксована формула перевершила експертне судження в огляді 2013 року.
- Скільки інтерв'юерів мені потрібно? До 4, кожен оцінює самостійно. За власними даними Google кожне інтерв'ю після 4-го додавало менше 1% точності.
- Чи можна довіряти оцінці ШІ? Використовуйте її як 1 із вхідних даних і читайте її обґрунтування. У дослідженні 2023 року оцінювач на базі ШІ близько відповідав оцінкам навчених людей на знайомих запитаннях і погано — на нових.
1. Чи справді оцінювальний лист для інтерв'ю допомагає мені обирати кращих кандидатів?
Так, якщо кожен інтерв'юер оцінює ті самі навички за письмовими прикладами. Структуровані інтерв'ю, де ви ставите запитання й оцінюєте всіх однаково, прогнозували продуктивність на роботі на рівні 0,42 — більш ніж удвічі більше за 0,19 у неструктурованих.
Ці цифри походять із фундаментального повторного аналізу 2022 року Сакетта та колег десятиліть досліджень найму.
Ці числа є кореляціями: від 0 (немає зв'язку з подальшою продуктивністю на роботі) до 1 (ідеальний зв'язок). Тож 0,19 не означає, що неструктуровані інтерв'ю обирають правильну людину у 20% випадків. Це означає, що їхній зв'язок із подальшою продуктивністю слабкий.
На графіку нижче ранжовано 6 поширених методів. Тести професійних знань із показником 0,40 і ключові біодані — оцінюваний анкетний опитувальник про досвід — із показником 0,38 ідуть одразу за ними.
Далі йдуть тести на робочих зразках із показником 0,33 і тести когнітивних здібностей із показником 0,31. Неструктуровані інтерв'ю — вільна розмова, з якою виросла більшість із нас, — опиняються останніми.
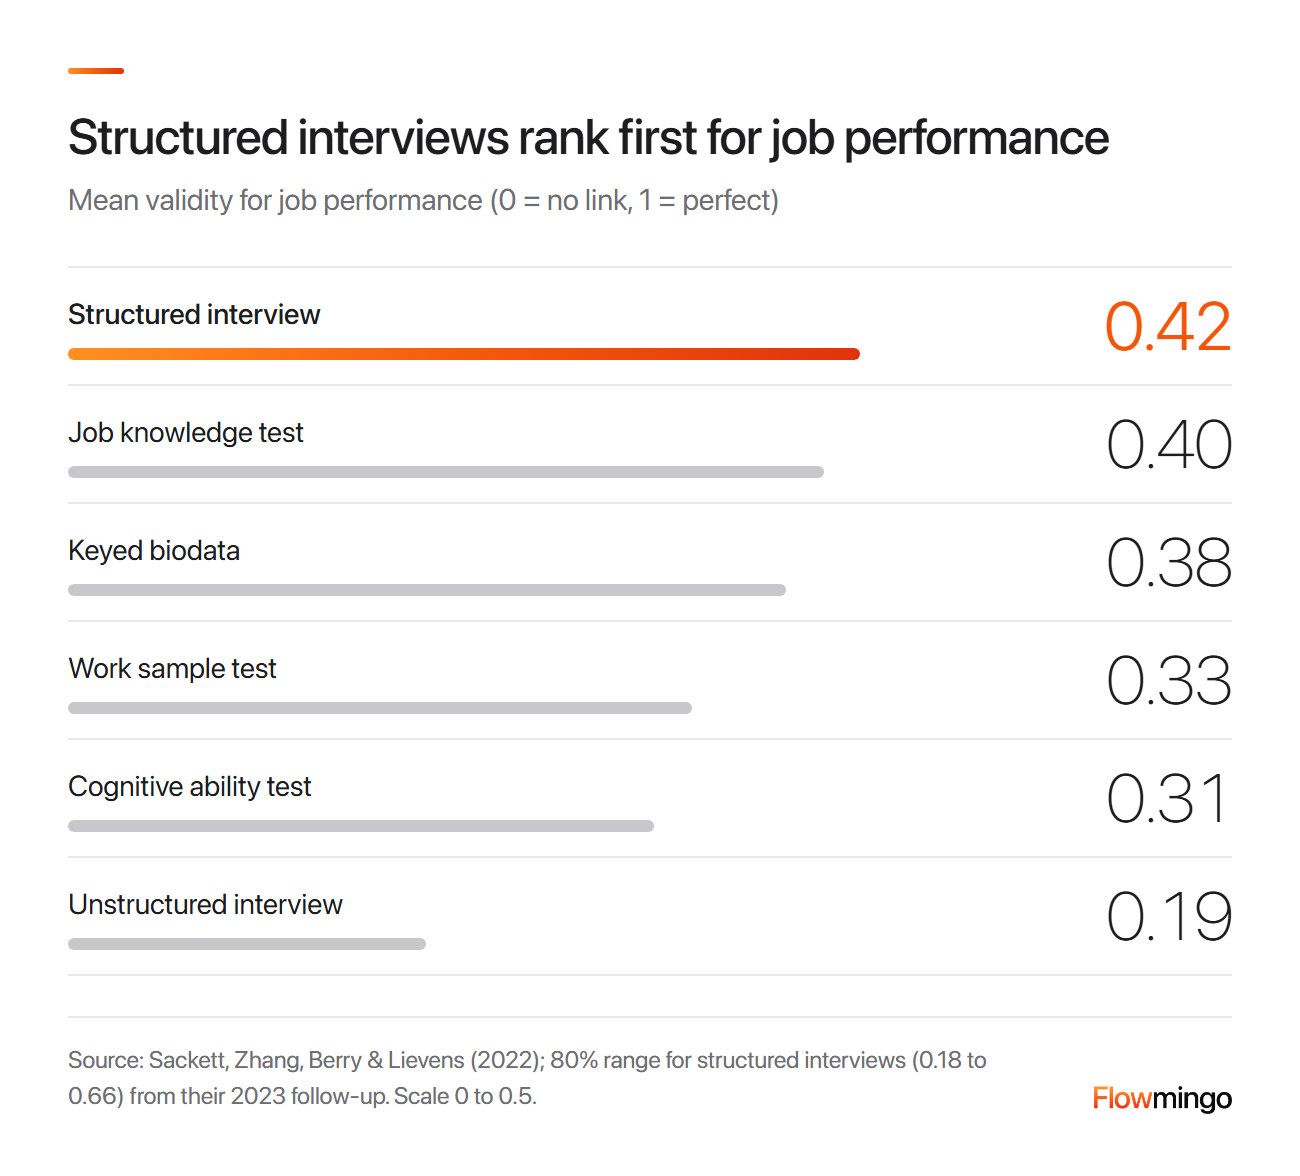
Методи найму, ранжовані за зв'язком із продуктивністю на роботі: структуровані інтерв'ю лідирують із показником 0,42, неструктуровані інтерв'ю пасуть задніх із показником 0,19 (фундаментальний повторний аналіз Sackett et al.).
Але 0,42 — це середнє значення. Подальше дослідження авторів показує, що більшість структурованих інтерв'ю мають показник від 0,18 — не краще за вільну розмову — до 0,66, що краще за будь-що на графіку.
Дизайн — це 1 із 3 причин такого розкиду, які наводять автори. Це означає, що інтерв'ю-рубрика з розпливчастими навичками ризикує опинитися близько до нижньої межі. Це середні показники за багатьма роботодавцями, а не гарантія щодо вашого наступного найму.
2. Що має містити мій шаблон інтерв'ю-рубрики?
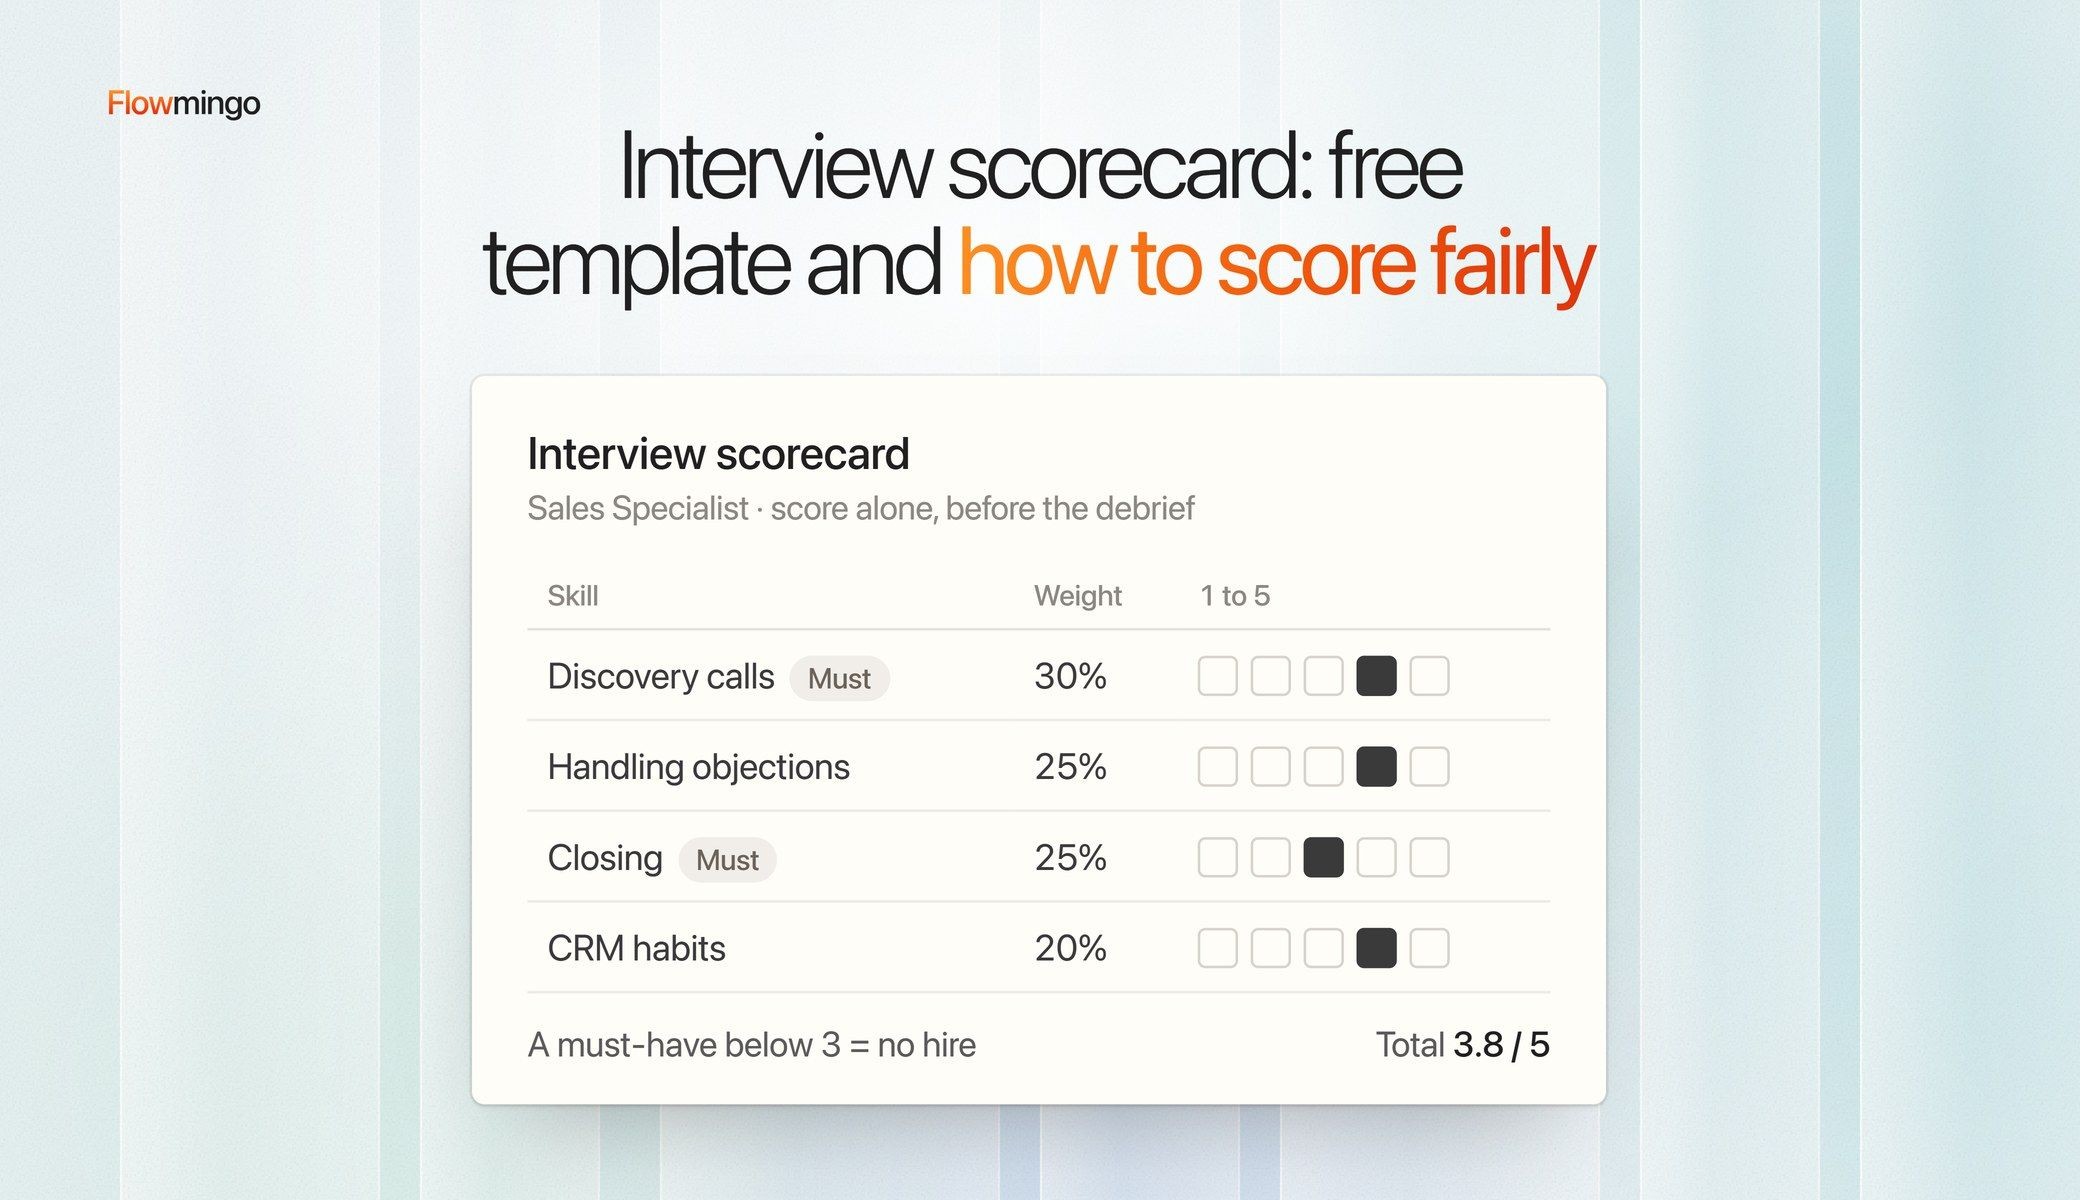
Шаблон інтерв'ю-рубрики, або форма оцінювання кандидата, містить 5 навичок, письмові орієнтири, поле для доказів і мінімальний обов'язковий поріг — усе на 1 сторінці. Він завершується загальним враженням і рекомендацією.
Орієнтири роблять так, що четвірка від 1 інтерв'юера означає те саме, що й від іншого, а поле для доказів відповідає на запитання «чому», коли його ставить ваш CEO.
Мінімальний поріг не дає сильній загальній оцінці приховати слабку обов'язкову навичку. Загальне враження ставиться останнім, бо відчуття, записане першим, забарвлює кожну оцінку навички після нього.
Ось така форма для керівника служби підтримки клієнтів із 2 обов'язковими навичками. Кожна з 5 навичок оцінюється від 1 до 5, тож максимум — 25 балів.
Ставте по 2 запитання про минулу поведінку на кожну навичку, бо реальний приклад із минулого дає вам конкретику, з якою можна звіритися з орієнтирами. Наприклад: «Розкажіть про останній випадок, коли незадоволений клієнт звертався до вас із ескалацією».
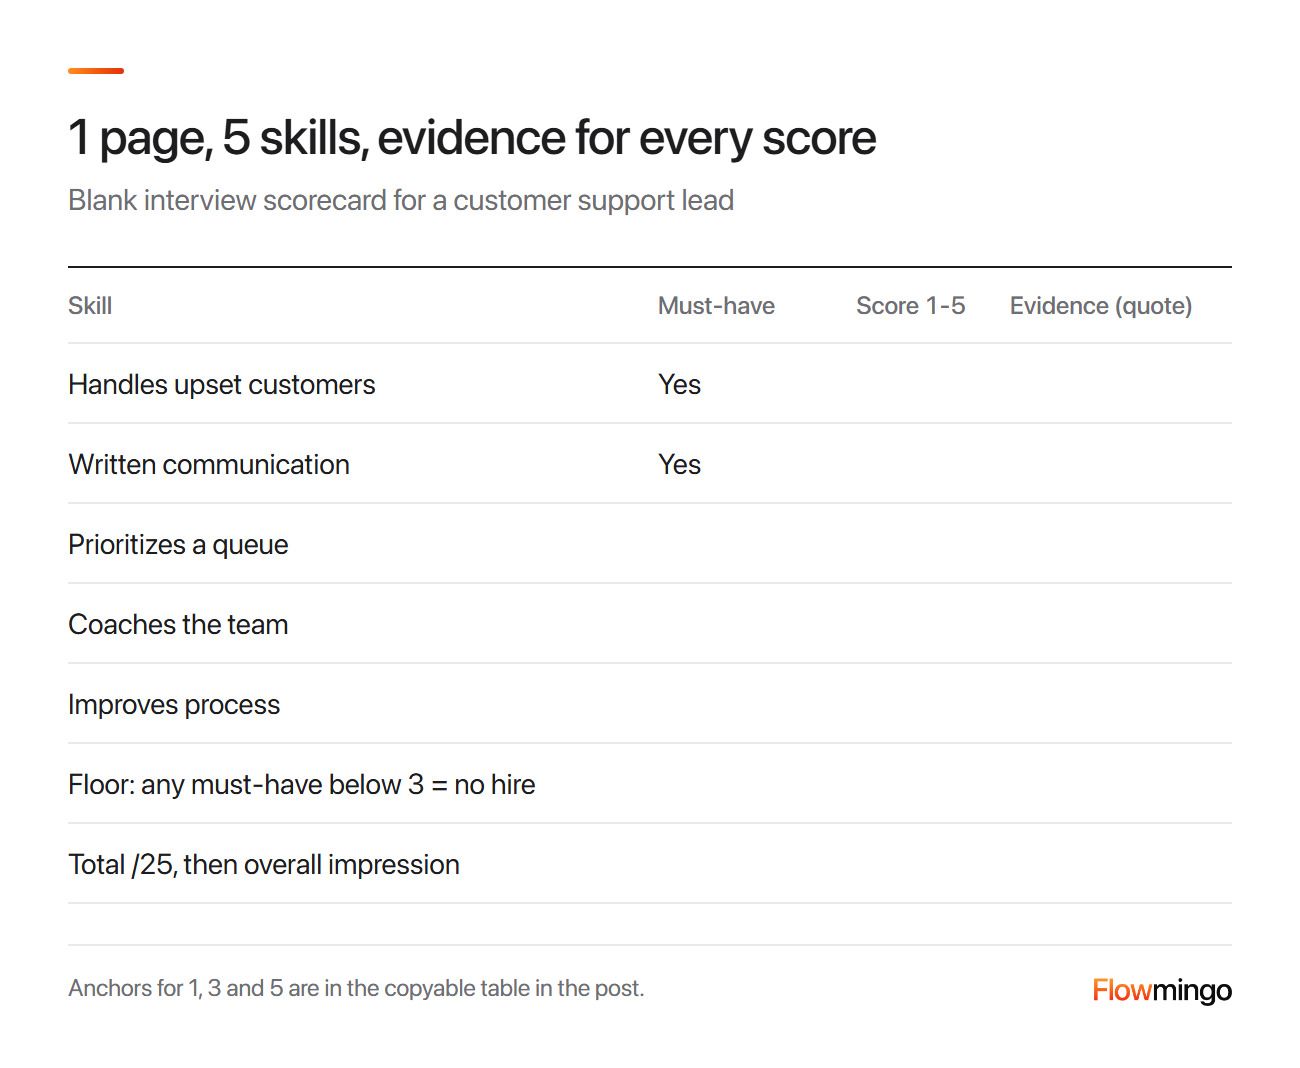
Порожній шаблон оцінювального листа співбесіди для керівника служби підтримки клієнтів: 5 навичок, 2 обов'язкові навички, оцінка від 1 до 5 і цитата-доказ для кожної.
Скопіюйте таблицю, а потім підставте власні навички та орієнтири.
| Навичка | Орієнтири для 1 / 3 / 5 | Оцінка 1-5 | Доказ (цитата) |
|---|---|---|---|
| Шапка | Кандидат, посада, інтерв'юер, дата | ||
| Працює з незадоволеними клієнтами (обов'язкова) | Звинувачує клієнта / діє за правилами / усуває причину | ||
| Письмова комунікація (обов'язкова) | Нечітко / чітко, але довго / коротко і чітко | ||
| Розставляє пріоритети в черзі | Без методу / за терміновістю / за впливом | ||
| Наставляє команду | Немає прикладу / дає поради / складає план | ||
| Покращує процес | Немає прикладу / пропонує виправлення / впроваджує виправлення | ||
| Мінімальний поріг | Будь-яка обов'язкова навичка нижче 3 означає відмову | ||
| Не оцінюється | Емоції, прочитані з обличчя, голосу чи набору тексту; акцент чи темп, якщо цього не потребує посада; «відповідність культурі» | ||
| Загальна сума | Сума 5 оцінок, максимум 25 | ||
| Загальне враження | Від 1 до 5, заповнюється останнім | ||
| Рекомендація | Однозначно найняти / найняти / не найняти / однозначно не найняти; для відхилення від правила потрібна письмова причина |
2.1 Що варто визначити, перш ніж її створювати?
Спершу визначте, що означає успіх на посаді, а потім оберіть навички, які до нього ведуть. Зафіксуйте оцінювальний лист співбесіди до того, як надійде перше резюме.
Ця послідовність походить із книжки Who Джеффа Смарта й Ренді Стріта. Напишіть 1 рядок місії, потім від 3 до 8 результатів за важливістю, а далі від 4 до 6 навичок. Результат — це вимірюваний підсумок, як-от зростання доходу з 25 млн до 50 млн доларів до 3-го року, а не діяльність.
Фіксація важлива, бо люди непомітно для себе змінюють критерії. У фундаментальних дослідженнях Uhlmann and Cohen (2005) учасники оцінювали кандидата на посаду начальника поліції — вуличного практика і високоосвічену людину.
Яка б сила не була в чоловіка, вони вирішували, що для посади вона потрібніша, а жінка такого підсилення не отримувала. Прихильність до критеріїв до того, як побачити кандидатів, усувала це упередження. Тож оцінювальний лист, написаний після зустрічі з кандидатами, може непомітно схилитися до того, хто вам уже подобається.
2.2 Чи має відповідність культурі бути в оціночній картці?
Не в тому вигляді, як вона написана, бо ніхто не зможе оцінити її однаково двічі. Перетворіть її на 1-2 спостережувані поведінки, наприклад «просить зворотний зв'язок щодо власної роботи».
Скажімо, ваша команда цінує відкритість: оцінюйте «навів конкретний приклад, як вчасно повідомив про помилку».
3. Як зважувати оцінки з інтерв'ю, щоб обов'язкові навички важили найбільше?
Надайте кожній навичці рівну вагу й додайте мінімальний поріг для обов'язкових, або зафіксуйте ваги до першого інтерв'ю. Рівні ваги часто передбачають нові випадки так само добре, як ваги, підігнані під минулі дані.
Друге твердження належить психологу Робіну Дозу, як підсумовує Канеман у Thinking, Fast and Slow.
Ваги, налаштовані під ваших минулих найманців, також засвоюють випадковості цієї групи. Скажімо, ваші 3 найкращі найманці в підтримку всі випадково виявилися сильними наставниками: налаштована вага віддавала б перевагу наставництву в кожному майбутньому кандидаті.
Рівні ваги не можуть гнатися за такою випадковістю, тому вони часто передбачають нових кандидатів так само добре. Тримайте навички й незалежними, як радить Канеман: не перелічуйте одночасно «комунікацію» і «навички презентації», бо разом вони рахують одне й те саме двічі.
Обов'язкова навичка бере силу з порогу, а не з більшої ваги. Скажімо, «Впорається з розлюченими клієнтами» отримує 2 бали, а кожна інша навичка — 5.
Сума 22 з 25 виглядає чудово, але поріг усе одно каже: не наймати. Саме цього ви й хочете для навички, без якої робота неможлива.
Якщо ви все ж зважуєте, запишіть ваги в оціночній картці інтерв'ю заздалегідь і застосовуйте їх до всіх. Це закриває найлегший спосіб викривити підсумок: змінити ваги після того, як познайомилися з людиною, яка вам сподобалася.
Як допомагає Flowmingo
Звіт AI-інтерв'ю Flowmingo використовує фіксовані ваги: критерій Must Have рахується в 4 рази більше за Good to Have у загальній оцінці. Кожен критерій зберігає власну оцінку від 0 до 10, тож ви все ще можете самостійно застосувати поріг для обов'язкових навичок.
4. Як зробити так, щоб оцінка 3 означала одне й те саме для кожного інтерв'юера?
Ще до першого інтерв'ю опишіть, що містить відповідь на 1, на 3 і на 5 балів для кожного навику. Така шкала з поведінковими орієнтирами робить оцінки 2 інтерв'юерів порівнюваними.
«Поведінкові орієнтири» означають лише те, що кожна оцінка прив'язана до того, що зробив кандидат, а не до відчуття на кшталт «досить добре». Без орієнтирів 3 в одній і тій самій формі оцінювання інтерв'ю означає «нормально» для одного інтерв'юера і «слабко» для іншого.
Інтерв'ю з орієнтирами також показують сильніший середній зв'язок із подальшою роботою. Taylor and Small's фундаментальний огляд 19 досліджень інтерв'ю про минулу поведінку виявив зв'язок .35 зі шкалами з орієнтирами проти .26 без них. Дослідження різнилися й в інших аспектах, тож це порівняння не ізолює ефект додавання орієнтирів.
Ось шкала оцінювання інтерв'ю для обов'язкового критерію «Вміє працювати з розлюченими клієнтами».
| Бал | Що містить відповідь |
|---|---|
| 1 | Звинувачує клієнта; жодних власних дій і жодного результату |
| 3 | Реальний приклад: заспокоює клієнта і застосовує політику, але не перевіряє результат |
| 5 | Реальний приклад: знаходить причину, усуває її, робить повторний зв'язок і ділиться рішенням |
Кожен наступний рівень — це те, що можна почути у відповіді. Саме тому 2 слухачі можуть дійти того самого числа.
Якщо ви ще не можете написати орієнтири, позичте 5 рівнів із посібника зі структурованого інтерв'ю від OPM, федерального кадрового агентства США. Кожен рівень залежить від того, наскільки складною була ситуація і скільки підказок потребувала людина.
- 1, Обізнаність: найпростіші ситуації, з тісним і докладним супроводом.
- 2, Базовий: дещо складні ситуації, з частим супроводом.
- 3, Середній: складні ситуації, з періодичним супроводом.
- 4, Просунутий: значно складні ситуації, з невеликим супроводом або без нього.
- 5, Експерт: винятково складні ситуації, де людина радить іншим.
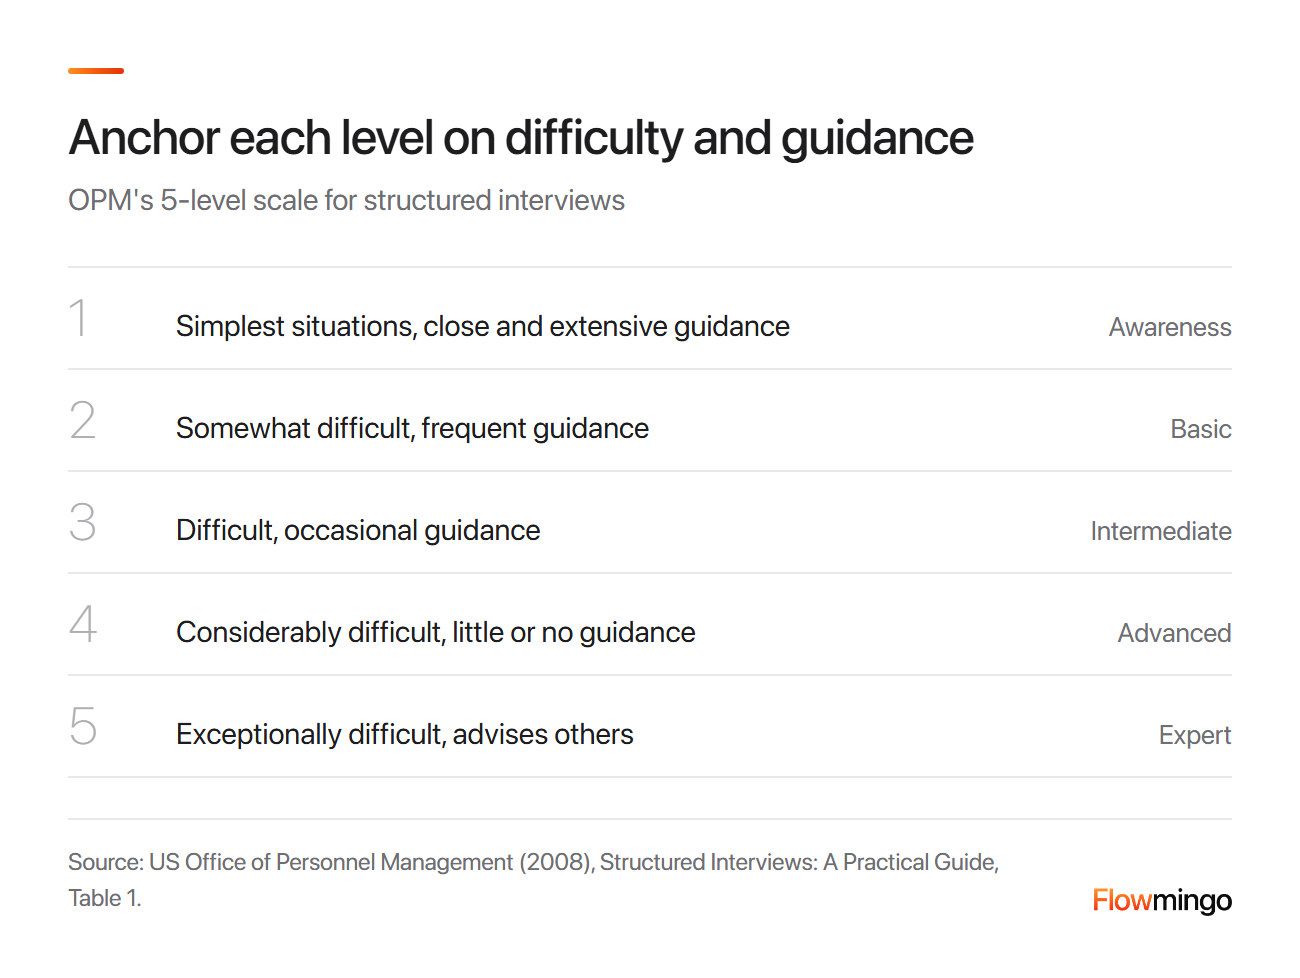
5 рівнів оцінювання OPM для структурованих інтерв'ю: від Обізнаності (найпростіші ситуації, тісний супровід) до Експерта (винятково складні ситуації, радить іншим).
5. Як обрати між 2 сильними фіналістами, коли мої інтерв'юери не згодні?
Нехай рішення ухвалює підсумковий бал за інтерв'ю, з двома винятками: обов'язкова навичка з балом нижче 3 або розкол 2 проти 5, який ви розбираєте на основі доказів. Не переголосовуйте на основі відчуттів.
Саме для цього моменту існують оціночні листи, і саме в цей момент найбільше хочеться від них відмовитися. Ось ілюстративний приклад, а не дані клієнтів: 3 фіналісти на посаду керівника підтримки, кожна клітинка усереднена за 3 інтерв'юерами.
| Навичка | A | B | C |
|---|---|---|---|
| Працює з незадоволеними клієнтами (обов'язкова) | 4 | 2 | 4 |
| Письмова комунікація (обов'язкова) | 4 | 4 | 3 |
| Розставляє пріоритети в черзі | 3 | 4 | 3 |
| Наставляє команду | 3 | 4 | 4 (бали 2, 5, 5) |
| Покращує процеси | 4 | 4 | 3 |
| Разом, з 25 | 18 | 18 | 17 |
| Рішення | Найняти | Не наймати: спрацював нижній поріг | Розібрати розкол |
Читайте оціночний лист інтерв'ю рядок за рядком. A і B мають однакові 18 з 25. Але B отримав 2 з обов'язкової навички, тож спрацьовує нижній поріг, і B не наймають.
C має загалом 17, але середній бал 4 за «Наставляє команду» приховує розкол: 1 інтерв'юер поставив 2, а інші 2 поставили 5. Ця розбіжність стає єдиним пунктом порядку денного на розборі.
На практиці попросіть кожну сторону зачитати свої цитати-докази. Скажімо, той, хто поставив низький бал, чув про члена команди, який звільнився, а інші чули про план наставництва, який спрацював. Розбір вирішує, яка історія більш типова для C, і кожен, хто пропустив докази, змінює бал письмово.
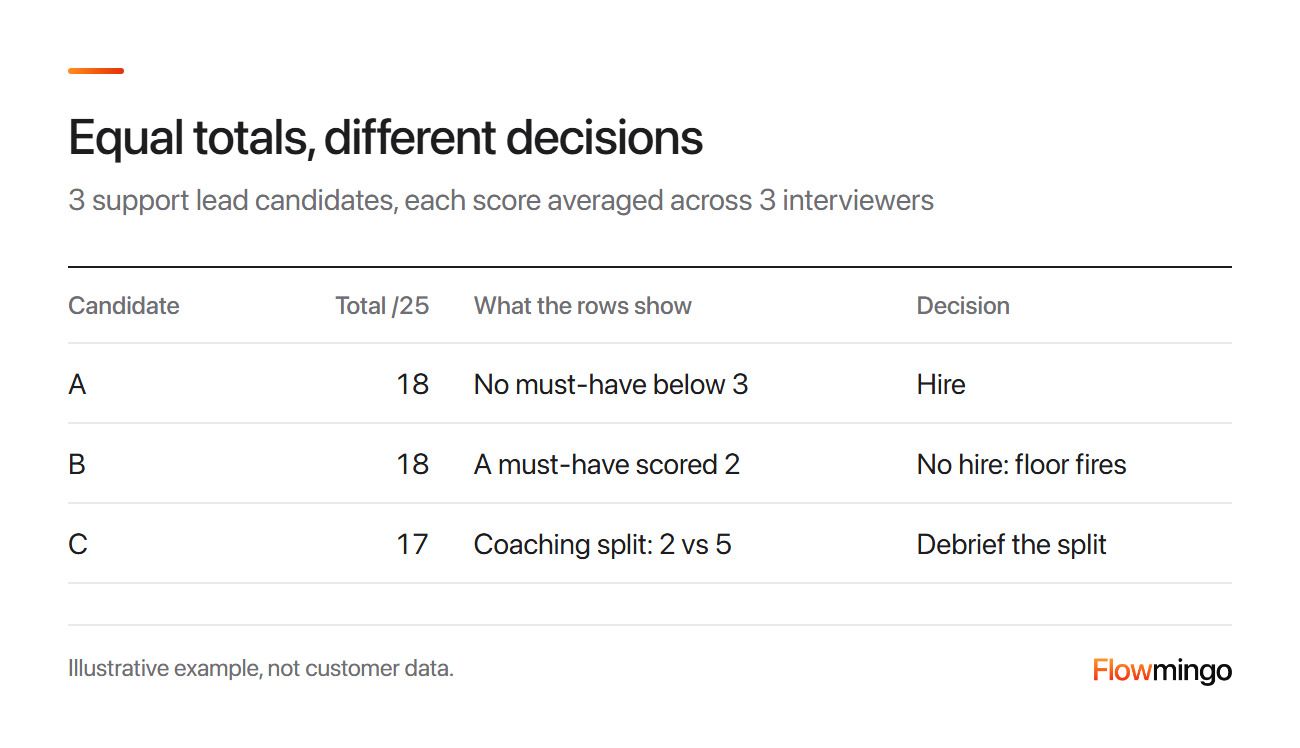
Заповнений оціночний лист інтерв'ю, ілюстративний: A і B мають однакові 18 з 25, B не дотягує до обов'язкової навички, а в C є розкол щодо наставництва для розбору.
Щойно бали визначають фіналіста, впишіть умови в оферту, перш ніж її надіслати: наш шаблон листа з пропозицією роботи показує, де розміщується кожна перевірка.
5.1 Що робити, якщо інтуїція каже одне, а бали — інше?
Дотримуйтеся балів, якщо тільки не можете записати докази, які вони пропустили. У фундаментальному мета-аналізі Канцеля та колег 2013 року формула, застосована однаково до всіх, передбачала продуктивність на роботі з показником 0,44 проти 0,28 для цілісного судження. Автори називають це покращенням прогнозу більш ніж на 50%, навіть порівняно з експертами, які знали роботу.
Цілісне судження означає, що люди зважують ті самі факти у своїх головах, зокрема на консенсусних зустрічах. Тож розбір заповнює прогалини в доказах, а не переголосовує.
5.2 Чи варто порівнювати фіналістів пліч-о-пліч?
Так, відповідь за відповіддю. Порада Бонет з HBR — порівнювати всі відповіді на перше запитання, потім на друге, щоб оцінювати кожну відповідь на тлі інших.
У фундаментальному лабораторному дослідженні 2016 року люди, яким показували по 1 кандидату за раз, схилялися до статі, яку підтримував стереотип завдання. Минулі результати майже не мали значення. Коли показували 2 кандидатів пліч-о-пліч, вони обирали сильнішого у 54% випадків, а слабшого — у 8%.
У дослідженні використовували минулі оцінки за завдання, а не співбесіди, тож сприймайте це як сильний натяк, а не доказ.
6. Як не дати найгучнішому інтерв'юеру перемогти на обговоренні?
Нехай кожен інтерв'юер подасть свою оцінювальну картку співбесіди до того, як хтось почне говорити, а потім почніть обговорення з оцінок.
Уявіть, що старша людина починає зі слів «мені вона сподобалася», і кімната починає схилятися до цієї думки. Оцінки, записані наодинці, захищають усіх від цього тиску — саме тому Noise робить незалежне оцінювання правилом найму.
На практиці збирайте оцінки у спільній таблиці чи вашій системі відстеження кандидатів (ATS) і показуйте їх усі одразу.
Панельне інтерв'ю, де всі дивляться ту саму співбесіду, здається виправленням. У фундаментальному метааналізі Гафкатта та колег 2013 року згода між оцінювачами панелі становила 0,74 проти 0,44 для окремих співбесід за шкалою від 0 до 1.
Ця цифра лестить панелям. Усі члени панелі оцінюють той самий виступ того самого дня, тож якщо кандидат мав надзвичайно вдалий чи невдалий ранок, це бачать усі.
Як сказала Айріс Бонет у виступі в Google, «розмір вибірки панельного інтерв'ю — фактично один». Окремі співбесіди, кожну з яких оцінюють наодинці, дають вам більше незалежних поглядів.
6.1 Скільки інтерв'юерів мають оцінювати кожного кандидата?
До 4, в окремих співбесідах. У внутрішніх даних Google, а не в рецензованому дослідженні, 4 співбесіди передбачали рішення про найм із упевненістю 86%. Кожна додаткова додавала менш ніж 1%.
Додаткові співбесіди мало що додавали до прогнозування власного рішення Google про найм. Використовуйте це як привід обґрунтувати кожен етап, а не як універсальний максимум чи доказ щодо подальшої роботи.
7. Як змусити зайнятих інтерв'юерів справді заповнювати оцінну форму співбесіди?
Зробіть оцінювання частиною співбесіди. Оцінюйте кожну навичку одразу після відповідних запитань, записуйте цитату в 1 рядок як доказ, а загальне враження давайте останнім.
Ніхто не хоче ще однієї форми після цілого дня співбесід. Тому оцінювання відбувається під час співбесіди, а не як домашнє завдання на вечір.
Канеман створив цей метод для ізраїльської армії у 1955 році, після того як вільні співбесіди виявилися майже марними для прогнозування успіху. Інтерв'юери оцінювали 6 рис за шкалою від 1 до 5, завершуючи кожну, перш ніж почати наступну, щоб перше враження не забарвлювало решту.
Лише потім вони заплющували очі й давали загальну оцінку, і підсумок прогнозував значно точніше, ніж раніше. Його порада: наймайте того, хто набрав найвищий підсумок, "навіть якщо є інший, хто вам подобається більше".
Час теж має значення. У польовому дослідженні 166 інтерв'юерів повідомили, коли вони ухвалили рішення. Лише 4,9% рішень припали на першу хвилину, але 22,5% — після завершення співбесіди.
Рішення, ухвалене після того, як кандидат пішов, спирається на пам'ять, тож оцінюйте в процесі.
Для нашого керівника підтримки це виглядає так:
- Поставте 2 запитання про чергу, потім оцініть "Пріоритизує чергу", перш ніж рухатися далі.
- Запишіть 1 цитату як доказ, наприклад "Я сортую баги за тим, скількох клієнтів вони зачіпають."
- Дотримуйтеся того самого порядку навичок для кожного кандидата.
Письмові докази рідко трапляються в наших даних.
Дані Flowmingo · 86 638 кандидатів, з якими провели AI-інтерв'ю · 2 574 компанії · липень 2025 – вересень 2026
- 0,3% кандидатів, з якими провели AI-інтерв'ю, отримали письмовий коментар від команди найму (258 із 86 638).
Команди можуть вести нотатки деінде; у Flowmingo AI-звіт зазвичай є єдиною письмовою оцінкою в справі.
Письмове обґрунтування — перше, що пропускають у завантажений день. Тому форма просить лише 1 цитату на навичку.
8. Чи можна довіряти AI-оцінці в моїй оцінювальній картці інтерв'ю?
Сприймайте її як 1 із вхідних даних, які переглядає людина, і спершу читайте її обґрунтування. AI-оцінювання може різко падати на запитаннях, для яких його не навчали.
Ми маємо інтерес у цій відповіді, тож наведені нижче докази включають і ту частину, яка не лестить AI.
У фундаментальному дослідженні 2023 року 2 навчені оцінювачі оцінили 7 017 відповідей кандидатів за 5-бальною шкалою з прив'язкою до 1. Модель, навчена на тих самих запитаннях, близько збіглася з їхніми оцінками — 0,75 за шкалою від 0 до 1. На форматах запитань, яких вона ніколи не бачила, показник упав до 0,30 — слабкий збіг.
Це означає, що оцінка ШІ настійки хороша, наскільки добра її рубрика для конкретного питання, тож читайте її обґрунтування, перш ніж довіряти числу. Також зауважте, що 3 з 5 авторів того дослідження працювали у постачальнику ШІ-інтерв'ю Modern Hire.
Як допомагає Flowmingo
ШІ-інтерв'юер Flowmingo оцінює за критеріями, які ви затверджуєте. ШІ складає чернетку питань і критеріїв з вашого опису вакансії, а ви редагуєте і те, і те. Ви надсилаєте кожному кандидату інтерв'ю, яке він проходить у зручний для себе час.
Ви отримуєте запис, транскрипт і оцінку кожного критерію від 0 до 10 з письмовим обґрунтуванням. Рішення про найм ухвалюєте ви.
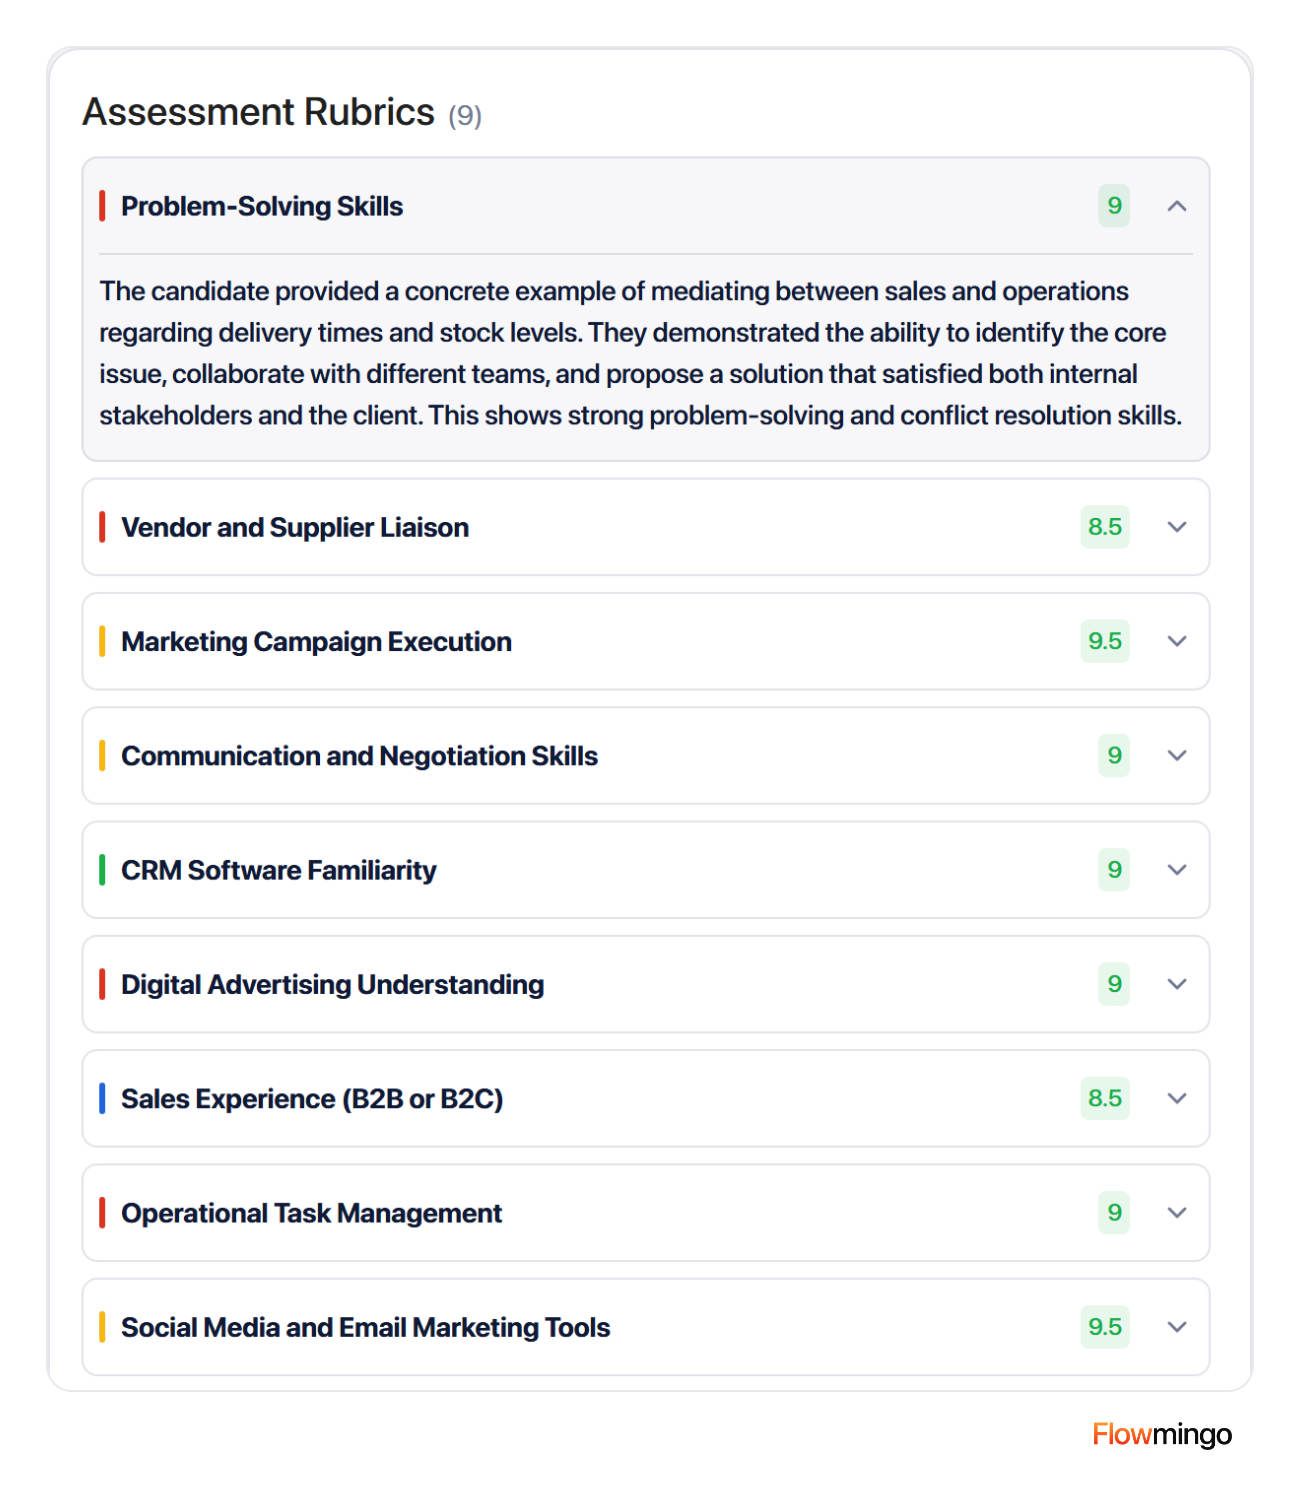
Публічний зразок звіту Flowmingo: оцінка від 0 до 10 і обґрунтування для кожного критерію, тож задавайте будь-який обов'язковий поріг на цій шкалі.
У наших даних резюме та інтерв'ю також розходяться в тому, хто найкращий.
Дані Flowmingo · 34 114 кандидатів · 379 компаній · липень 2025 – вересень 2026
- 19,2% із 532 проєктів з 1 чітко найвищою оцінкою за інтерв'ю також дали цьому кандидату найвищу оцінку за резюме.
- 54,9% із 3 684 кандидатів, які набрали 8 або більше на інтерв'ю (2 022), були б відсіяні шортлистом за топ-20% резюме.
Обидві оцінки — це оцінки ШІ Flowmingo, а не результати роботи, і опитані є вибірковою групою. Дані показують, що ці два рейтинги різняться, а не який із них правильний.
Простіше кажучи, приблизно у 4 з кожних 5 таких проєктів кандидат із найвищим балом за співбесіду не мав найвищого балу за резюме. Тож оцінюйте співбесіду окремо, а не переносіть на неї бал за резюме.
9. Чи захистять мене мої оцінювальні аркуші, якщо відхилений кандидат поскаржиться?
Вони допомагають, якщо в них оцінюють свідчення, пов'язані з роботою, і ви їх зберігаєте. За розумного прочитання федеральні правила США вимагають зберігати оцінювальні аркуші щонайменше 1 рік, а правила Каліфорнії — 4 роки.
Скарга може надійти через місяці, коли вже ніхто не пам'ятає співбесіди. Оцінювальний аркуш співбесіди з цитатою щодо кожної навички показує, що ви оцінювали і чому.
Правило США не називає оцінювальні аркуші, але охоплює "інші записи, пов'язані з найманням". Щойно хтось подає скаргу про дискримінацію, ви зберігаєте кожен дотичний запис до завершення справи. Це включає записи інших кандидатів на ту саму посаду, тож одна скарга заморожує весь набір.
Ці правила чинні станом на вересень 2026 року. Це стислий виклад, а не юридична консультація.
| Правило | Де | Що це означає для вашого оцінювального аркуша |
|---|---|---|
| 29 CFR 1602.14 | США | Зберігайте записи про наймання 1 рік, довше після скарги |
| 2 CCR 11013(c) | Каліфорнія | Зберігайте записи 4 роки, включно з даними автоматизованих рішень |
| ICO guidance | Велика Британія | Кандидати можуть запитати нотатки зі співбесіди; розкривайте будь-яке правило вирішального голосу |
| TAFEP | Сінгапур | Використовуйте форму оцінювання й зберігайте записи щонайменше 1 рік |
| 29 CFR 1630.11 (ADA) | США | Якщо інвалідність впливає на мовлення, оцінюйте навичку, а не мовлення, якщо тільки мовлення не є вимогою посади |
| AI Act, Article 5(1)(f) | ЄС, з 2 лютого 2025 | Жодного ШІ, що виводить емоції кандидатів з облич, постави чи натискань клавіш |
| AI Act, Annex III and Article 26 | ЄС, з 2 грудня 2027 | Високий ризик: людський нагляд, журнали зберігаються 6+ місяців, кандидатів повідомляють |
| Local Law 144 | Нью-Йорк | Бал ШІ, використаний окремо, з вагою вищою за все інше або для скасування рішень людей: щорічний аудит на упередженість і повідомлення |
| AI Video Interview Act | Іллінойс | Спершу повідомлення, пояснення й згода; видаляйте відео протягом 30 днів після запиту |
Ось чому в шаблоні є рядок "Не оцінюється". ЄС забороняє ШІ, що зчитує емоції кандидатів з облич, постави чи натискань клавіш, а американський закон про інвалідність (ADA) захищає кандидатів, чия інвалідність впливає на мовлення. У Великій Британії кандидати можуть попросити ваші нотатки, тож пишіть кожен рядок свідчення так, ніби вони його прочитають.
Щоб провести самоперевірку, порівняйте частки проходження за групами за правилом 4/5 з Uniform Guidelines. Скажімо, 30% однієї групи проходять, а 50% іншої: 30 поділити на 50 — це 0,6, менше за 0,8, тож придивіться уважніше.
Висновок Міністерства юстиції від червня 2026 року і правило OPM від липня 2026 року відводять федеральні агенції від Guidelines. Утім, вони залишаються у федеральних нормах, тож ставтеся до цієї перевірки як до дешевої звички, а не юридичної межі.
10. Як запровадити оцінювальний аркуш співбесіди в команді цього тижня?
Створюйте його в такому порядку й змінюйте лише між посадами. Перша версія не мусить бути ідеальною, але вона має бути однаковою для кожного кандидата.
- Напишіть 1 рядок місії та від 3 до 8 ранжованих результатів.
- Перетворіть їх на 5 навичок і позначте обов'язкові.
- Напишіть 2 запитання про минулу поведінку та орієнтири для 1, 3 і 5 за кожною навичкою.
- Нехай до 4 інтерв'юерів оцінюють самостійно й подають оцінки до обговорення.
- Нехай вирішує загальна оцінка, але будь-яка обов'язкова навичка нижче 3 означає відмову. Записуйте кожне відхилення від правила.
На практиці почніть з 1 відкритої вакансії, щоб команда виробила звичку на чомусь реальному. Перед першим інтерв'ю нехай усі оцінять ту саму зразкову відповідь і порівняють результати.
Якщо 2 оцінки різняться більше ніж на 1 бал, перепишіть орієнтир, доки вони не зійдуться. Навчені оцінювачі з дослідження в розділі 8 використовували той самий розрив в 1 бал як привід скликати нараду.
Очікуйте певного опору. Інтерв'юери Канемана в армії теж чинили опір самому лише записуванню відповідей, і його рішенням стала оцінка із заплющеними очима, яка дала їхньому судженню місце у формі. Ваш рядок загального враження робить те саме для вашої команди.
Як допомагає Flowmingo
Щоб надіслати кожному кандидату структуроване інтерв'ю для проходження у зручний час, записане й оцінене за 1 оцінювальною карткою інтерв'ю, спробуйте Flowmingo.
11. Джерела
Кожна зовнішня цифра вище походить із джерел нижче, у порядку появи. Власні цифри Flowmingo наведені в блоках даних, з липня 2025 року до вересня 2026 року.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2022). Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range. Journal of Applied Psychology.
- Sackett, P. R., Zhang, C., Berry, C. M., & Lievens, F. (2023). Revisiting the design of selection systems in light of new findings regarding the validity of widely used predictors. Industrial and Organizational Psychology.
- Kahneman, D., Sibony, O., & Sunstein, C. R. (2021). Noise: A flaw in human judgment, ch. 24, as quoted by NPR Planet Money. Little, Brown Spark.
- Smart, G., & Street, R. (2008). Who: The A method for hiring. Ballantine Books.
- Uhlmann, E. L., & Cohen, G. L. (2005). Constructed criteria: Redefining merit to justify discrimination. Psychological Science.
- Taylor, P. J., & Small, B. (2002). Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions. Journal of Occupational and Organizational Psychology.
- US Office of Personnel Management (2008). Structured interviews: A practical guide. OPM.
- Kahneman, D. (2011). Thinking, fast and slow, ch. 21, "Intuitions vs. formulas". Farrar, Straus and Giroux.
- Frieder, R. E., Van Iddekinge, C. H., & Raymark, P. H. (2016). How quickly do interviewers reach decisions? Journal of Occupational and Organizational Psychology. Percentages as reported by BPS Research Digest.
- Shaper, S. (2017). How many interviews does it take to hire a Googler?. Google re:Work, archived.
- Huffcutt, A. I., Culbertson, S. S., & Weyhrauch, W. S. (2013). Employment interview reliability: New meta-analytic estimates by structure and format. International Journal of Selection and Assessment.
- Bohnet, I. (2016). What works: Gender equality by design. Talks at Google.
- Bohnet, I. (2016). How to take the bias out of interviews. Harvard Business Review.
- Bohnet, I., van Geen, A., & Bazerman, M. H. (2016). When performance trumps gender bias: Joint vs. separate evaluation. Management Science.
- Kuncel, N. R., Klieger, D. M., Connelly, B. S., & Ones, D. S. (2013). Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis. Journal of Applied Psychology.
- Koenig, N., Tonidandel, S., Thompson, I., Albritton, B., Koohifar, F., et al. (2023). Improving measurement and prediction in personnel selection through the application of machine learning. Personnel Psychology.
- European Commission (2025). Guidelines on prohibited artificial intelligence practices, C(2025) 5052 final. European Commission.
- European Parliament and Council (2026). Regulation (EU) 2026/1744, the Digital Omnibus on AI. Official Journal of the EU.
- NYC Department of Consumer and Worker Protection (2023). Automated employment decision tools: rules and FAQ. NYC DCWP.
- Illinois General Assembly (n.d.). Artificial Intelligence Video Interview Act, 820 ILCS 42. Illinois General Assembly.
- US Equal Employment Opportunity Commission (1991, as amended 2011). 29 CFR 1630.11, Administration of tests. eCFR.
- US Equal Employment Opportunity Commission (1972, as amended 2024). 29 CFR 1602.14, Preservation of records made or kept. eCFR.
- California Civil Rights Council (2025). Employment regulations regarding automated-decision systems. California Civil Rights Department.
- Information Commissioner's Office (n.d., under review). Shortlisting, testing, and interviewing candidates. ICO.
- TAFEP (n.d., accessed 2026-09-24). How to conduct fair job interviews. Tripartite Alliance for Fair and Progressive Employment Practices.
- EEOC, Civil Service Commission, Department of Labor & Department of Justice (1978). Uniform Guidelines on Employee Selection Procedures, 29 CFR Part 1607. eCFR.
- US Department of Justice, Office of Legal Counsel (2026). Constitutionality of disparate-impact liability under Title VII. DOJ.
- US Office of Personnel Management (2026). Removal of references to the Uniform Guidelines on Employee Selection Procedures in federal personnel regulations. Federal Register.